

Nota do tradutor.: Este artigo, escrito por Galo Navarro, que ocupa o cargo de Principal Software Engineer na empresa europeia Adevinta, é uma fascinante e educativa "investigação" no campo da operação de infraestrutura. Seu título original foi ligeiramente ajustado na tradução devido a uma razão que o autor explica no início.
Nota do autor: Parece que esta publicação muito mais atenção do que o esperado. Ainda recebo comentários raivosos sobre como o título do artigo é enganoso e que alguns leitores estão desanimados. Entendo as razões para isso, então, apesar do risco de estragar toda a intriga, quero contar imediatamente sobre o que se trata este artigo. Ao fazer a transição de equipes para Kubernetes, notei uma coisa curiosa: toda vez que surge um problema (como o aumento da latência após a migração), o primeiro a ser culpado é o Kubernetes, mas depois descobre-se que o orquestrador, na verdade, não é o culpado. Este artigo narra um desses casos. Seu título repete a exclamação de um de nossos desenvolvedores (e depois você perceberá que o Kubernetes não tem nada a ver com isso). Nele, você não encontrará revelações inesperadas sobre Kubernetes, mas pode esperar algumas boas lições sobre sistemas complexos.
Há algumas semanas, minha equipe estava migrando um microserviço para a plataforma principal, que inclui CI/CD, um ambiente baseado em Kubernetes, métricas e outras utilidades. A mudança foi experimental: planejamos usá-lo como base e migrar cerca de 150 serviços nos próximos meses. Todos eles são responsáveis pelo funcionamento de algumas das maiores plataformas online da Espanha (Infojobs, Fotocasa, entre outras).
Depois que implantamos o aplicativo no Kubernetes e redirecionamos parte do tráfego para ele, nos deparamos com uma surpresa preocupante. A latência (latência) das requisições no Kubernetes era 10 vezes maior do que no EC2. No geral, era necessário encontrar uma solução para esse problema ou descontinuar a migração do microserviço (e, possivelmente, de todo o projeto).
Por que a latência no Kubernetes é tão maior do que no EC2?
Para identificar o gargalo, coletamos métricas em todo o caminho da solicitação. Nossa arquitetura é simples: o gateway de API (Zuul) faz proxy das solicitações para instâncias de microserviços no EC2 ou Kubernetes. No Kubernetes, usamos o NGINX Ingress Controller, e os backends são objetos comuns do tipo com um aplicativo JVM na plataforma Spring.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Public       |      |  |
      -------> ZUUL +--+
traffic      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Parecia que o problema estava relacionado à latência na fase inicial de operação no backend (marquei a área problemática no gráfico como «xx»). No EC2, a resposta do aplicativo levava cerca de 20 ms. No Kubernetes, a latência aumentava para 100—200 ms.
Rapidamente descartamos os suspeitos mais prováveis relacionados à mudança de runtime. A versão da JVM permaneceu a mesma. Questões de conteinerização também não eram a causa: o aplicativo já funcionava com sucesso em contêineres no EC2. Carga? Mas observamos altas latências mesmo com 1 solicitação por segundo. As pausas para coleta de lixo também podiam ser ignoradas.
Um dos nossos administradores de Kubernetes perguntou se o aplicativo tinha dependências externas, pois no passado as consultas ao DNS causavam problemas similares.
Hipótese 1: resolução de nomes DNS
Para cada solicitação, nosso aplicativo faz de uma a três chamadas a uma instância do AWS Elasticsearch em um domínio como elastic.spain.adevinta.com. Dentro dos contêineres, temos , por isso podemos verificar se a pesquisa do domínio realmente leva muito tempo.
Consultas DNS do contêiner:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Consultas similares de uma das instâncias EC2, onde o aplicativo está em execução:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Considerando que a pesquisa leva cerca de 30 ms, ficou claro que a resolução de DNS ao acessar o Elasticsearch realmente contribui para o aumento da latência.
No entanto, isso era estranho por duas razões:
- Já temos muitos aplicativos em Kubernetes que interagem com recursos da AWS, mas não sofrem com altas latências. Qualquer que seja a razão, ela se relaciona especificamente com este caso.
- Sabemos que a JVM faz o cache de DNS em memória. Em nossas imagens, o valor de TTL está definido em
$JAVA_HOME/jre/lib/security/java.securitye está configurado para 10 segundos:networkaddress.cache.ttl = 10. Em outras palavras, a JVM deve armazenar em cache todas as consultas de DNS por 10 segundos.
Para confirmar a primeira hipótese, decidimos temporariamente abandonar as chamadas DNS e verificar se o problema desapareceria. Inicialmente, decidimos reconfigurar o aplicativo para se conectar ao Elasticsearch diretamente pelo endereço IP, em vez de usar o nome de domínio. Isso exigiria alterações de código e uma nova implantação, então simplesmente mapeamos o domínio para seu endereço IP em /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comAgora o contêiner recebia o IP quase instantaneamente. Isso levou a uma certa melhoria, mas apenas chegamos um pouco mais perto do nível de latência esperado. Embora a resolução de DNS estivesse demorando muito, a verdadeira razão ainda estava nos escapando.
Diagnóstico de rede
Decidimos analisar o tráfego do contêiner usando tcpdump, para rastrear exatamente o que estava acontecendo na rede:
[root@be-851c76f696-alf8z /]# tcpdump -leni any -w capture.pcap Em seguida, enviamos algumas solicitações e baixamos sua captura (kubectl cp my-service:/capture.pcap capture.pcap) para uma análise posterior em .
Nas consultas de DNS não havia nada suspeito (a não ser por um pequeno detalhe que contarei mais tarde). Mas havia certas peculiaridades na maneira como nosso serviço lidava com cada solicitação. Abaixo está uma captura de tela da captura, mostrando a aceitação da solicitação antes do início da resposta:
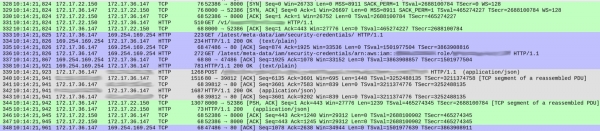
Os números dos pacotes estão na primeira coluna. Para maior clareza, destaquei em cores os diferentes fluxos TCP.
O fluxo verde, começando pelo pacote 328, mostra como o cliente (172.17.22.150) estabeleceu uma conexão TCP com o contêiner (172.17.36.147). Após o handshake inicial (328-330), o pacote 331 trouxe HTTP GET /v1/.. — uma solicitação de entrada ao nosso serviço. Todo o processo levou 1 ms.
O fluxo cinza (do pacote 339) mostra que nosso serviço enviou uma solicitação HTTP para a instância do Elasticsearch (o handshake TCP está ausente, pois usa uma conexão já existente). Isso levou 18 ms.
Por enquanto, tudo está bem, e os tempos estão aproximadamente dentro das latências esperadas (20-30 ms nas medições do cliente).
No entanto, a seção azul leva 86 ms. O que está acontecendo nela? Com o pacote 333, nosso serviço enviou uma solicitação HTTP GET para /latest/meta-data/iam/security-credentials, e logo depois, pela mesma conexão TCP, mais uma solicitação GET para /latest/meta-data/iam/security-credentials/arn:...
Descobrimos que isso se repete em cada solicitação em todo o rastreamento. A resolução de DNS realmente demora um pouco mais em nossos contêineres (a explicação desse fenômeno é bastante interessante, mas vou manter para um artigo separado). Descobrimos que a causa dos grandes atrasos são as chamadas ao serviço AWS Instance Metadata em cada solicitação.
Hipótese 2: chamadas desnecessárias ao AWS
Ambos os endpoints pertencem ao . Nosso microsserviço utiliza este serviço ao trabalhar com Elasticsearch. Ambas as chamadas fazem parte do processo básico de autorização. O endpoint que é acessado na primeira solicitação retorna a função IAM associada à instância.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
A segunda solicitação acessa o segundo endpoint por privilégios temporários para esta instância:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
O cliente pode usá-los por um curto período de tempo e deve periodicamente obter novos certificados (até sua Expiration). O modelo é simples: a AWS realiza uma rotação frequente de chaves temporárias por questões de segurança, mas os clientes podem armazená-las em cache por alguns minutos, compensando a diminuição de desempenho relacionada à obtenção de novos certificados.
O AWS Java SDK deve assumir a responsabilidade de organizar esse processo, mas, por algum motivo, isso não está acontecendo.
Ao pesquisar por problemas no GitHub, encontramos a questão . Isso nos ajudou a determinar a direção a seguir.
O AWS SDK atualiza os certificados ao ocorrer uma das seguintes condições:
- O prazo de validade deles (
Expiration) cai dentro deEXPIRATION_THRESHOLD, rigidamente definido no código como 15 minutos. - Desde a última tentativa de atualizar os certificados, mais tempo passou do que
REFRESH_THRESHOLD, hardcodeado como 60 minutos.
Para verificar o prazo de validade real dos certificados que recebemos, executamos os comandos cURL mencionados acima a partir do contêiner e da instância EC2. O tempo de validade do certificado obtido do contêiner era significativamente menor: exatamente 15 minutos.
Agora tudo ficou claro: para a primeira solicitação, nosso serviço recebia certificados temporários. Como o prazo de validade deles não ultrapassava 15 minutos, a cada nova solicitação o AWS SDK decidia atualizá-los. E isso acontecia com cada requisição.
Por que a validade dos certificados se tornou mais curta?
O serviço AWS Instance Metadata é projetado para trabalhar com instâncias EC2, e não com Kubernetes. Por outro lado, não queríamos alterar a interface da aplicação. Para isso, utilizamos — uma ferramenta que, por meio de agentes em cada nó do Kubernetes, permite que os usuários (engenheiros que implantam aplicações no cluster) atribuam funções IAM aos contêineres em pods como se fossem instâncias EC2. O KIAM intercepta chamadas para o serviço AWS Instance Metadata e as processa a partir de seu cache, previamente obtido da AWS. Do ponto de vista da aplicação, nada muda.
O KIAM fornece certificados de curto prazo para os pods. Isso faz sentido, considerando que a média de vida útil de um pod é menor do que a de uma instância EC2. Por padrão, a validade dos certificados .
Como resultado, se sobrepusermos ambos os valores padrão um ao outro, surge um problema. Cada certificado fornecido à aplicação expira em 15 minutos. Enquanto isso, o AWS Java SDK força a atualização de qualquer certificado cujo tempo restante até o vencimento seja inferior a 15 minutos.
Como resultado, o certificado temporário é forçado a ser atualizado a cada solicitação, o que resulta em várias chamadas à API da AWS e leva a um aumento significativo na latência. No AWS Java SDK, encontramos , que menciona um problema semelhante.
A solução se revelou simples. Apenas reconfiguramos o KIAM para solicitar certificados com um prazo de validade mais longo. Assim que isso aconteceu, as solicitações passaram a ser realizadas sem a participação do serviço AWS Metadata, e a latência caiu a níveis até inferiores aos da EC2.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Com base em nossa experiência com migrações, podemos afirmar que uma das fontes mais comuns de problemas não são falhas no Kubernetes ou em outros elementos da plataforma. Também não está relacionado a falhas fundamentais nos microserviços que estamos migrando. Os problemas frequentemente surgem simplesmente porque conectamos diferentes elementos.
Misturamos sistemas complexos que nunca interagiram entre si, esperando que juntos formem um único sistema maior. Infelizmente, quanto mais elementos, maior a margem para erros e maior a entropia.
No nosso caso, a alta latência não foi resultado de erros ou decisões ruins no Kubernetes, KIAM, AWS Java SDK ou no nosso microserviço. Foi o resultado da combinação de dois parâmetros independentes definidos por padrão: um no KIAM e outro no AWS Java SDK. Separadamente, ambos os parâmetros fazem sentido: tanto a política de atualização de certificados ativa no AWS Java SDK quanto a curta duração dos certificados no KIAM. Mas se combinados, os resultados se tornam imprevisíveis. Duas soluções independentes e lógicas não precisam necessariamente fazer sentido quando combinadas.
P.S. do tradutor
Para saber mais sobre a arquitetura da ferramenta KIAM para integração do AWS IAM com Kubernetes, você pode consultar dos seus criadores.
E no nosso blog, leia também:
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
