

Na internet existem muitos materiais de referência, mas às vezes os conselhos mais simples são os mais valiosos. A equipe traduzida , que a autora do artigo coletou após um ano de trabalho com Kubernetes. Os conselhos não estão organizados por importância, mas acreditamos que cada um encontrará algo útil para si.
O comando mais simples ao trabalhar com Kubernetes
Para começar, talvez a ação mais simples e útil no trabalho com Kubernetes. O próximo comando ativa a conclusão automática dos comandos kubectl no shell bash:
echo "source > ~/ .bashrc
A conclusão automática kubectl será registrada no arquivo .bashrc e será ativada automaticamente toda vez que o shell for iniciado. Isso acelera a digitação de comandos e parâmetros longos, como all-namespaces. Saiba mais na .
Limites padrão de memória e CPU no namespace
Se o aplicativo for escrito incorretamente, por exemplo, abrindo uma nova conexão com o banco de dados a cada segundo, mas nunca fechando, ocorrerá um vazamento de memória no cluster. E se nenhum limite de memória for configurado para o aplicativo durante a implantação, isso pode causar a falha do nó.
Para evitar isso, o Kubernetes permite definir limites padrão para cada namespace. Eles são especificados em um arquivo yaml para um namespace específico. Aqui está um exemplo desse arquivo:
apiVersion: v1
kind: LimitRange
metadata:
  name: mem-limit-range
spec:
  limits:
  - default:
      memory: 512Mi
    defaultRequest:
      memory: 256Mi
    type: Container
Crie um yaml como esse e aplique a qualquer namespace. Por exemplo, ao namespace limit-example. Agora, para qualquer contêiner implantado neste namespace, haverá um limite de 512Mi, a menos que um outro limite individual diferente seja explicitamente configurado para esse contêiner.
Limpeza de lixo em versões antigas do Kubernetes
O Kubelet, por padrão, começa a limpeza de lixo quando var/lib/docker ocupa 90% do espaço em disco disponível. Isso é ótimo, mas até a versão 1.7 do Kubernetes não havia limite padrão para o número de descritores de índice inode utilizados (inodes), que correspondem ao número de arquivos no sistema de arquivos.
Potencialmente, seu contêiner var/lib/docker pode usar apenas 50% do espaço em disco, mas os inodes podem acabar, o que causará problemas no funcionamento dos workers.
Nas versões antigas do kubelet, de 1.4 a 1.6, será necessário adicionar a seguinte flag:
--eviction-hard
=memory.available<100Mi,nodefs.available<10%,nodefs.inodesFree<5%
Na versão 1.7 e nas mais recentes, essa flag está definida por padrão. No entanto, as versões anteriores não monitoram o limite de inodes.
Minikube... pequeno, mas poderoso Kubernetes local
Minikube é a maneira mais simples de iniciar um cluster Kubernetes local. Ele é iniciado com um comando simples:
minikube start
Como resultado da execução deste comando, você terá um verdadeiro cluster Kubernetes funcionando em seu computador.
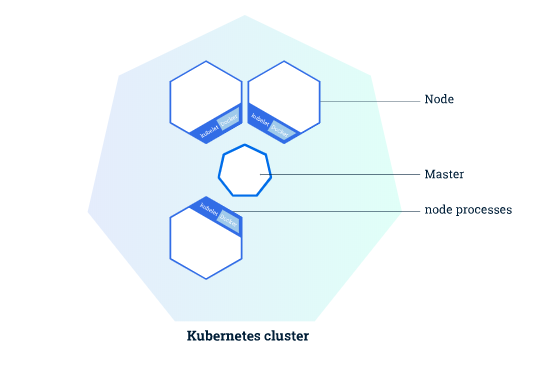
A dificuldade está em como construir a aplicação e executá-la localmente neste cluster. Se você não der instruções específicas, a imagem do Docker será construída em seu computador, e não no cluster.
Para forçar o Docker a enviar a imagem para o cluster Kubernetes local, o seguinte comando é dado à máquina Docker:
eval $(minikube docker-env)
Agora podemos construir aplicações no cluster Kubernetes local.
Não conceda acesso ao kubectl a todos indiscriminadamente
Isso parece óbvio, mas se várias equipes usam um único cluster para suas aplicações (para o qual o Kubernetes foi criado), não se deve simplesmente conceder acesso a todos. kubectlÉ melhor separar as equipes, fornecendo a cada uma delas seu próprio espaço de nomes e restringindo o acesso com políticas RBAC.
Você pode se complicar especificando permissões de acesso, leitura, criação, exclusão e outras operações para cada pod. Mas o principal é limitar o acesso a segredos, permitindo-o apenas para administradores. Assim, diferenciamos aqueles que podem administrar o cluster e aqueles que podem apenas implantar nele.
Gerencie os orçamentos dos pods
Como garantir que não haja interrupções para a aplicação no cluster Kubernetes? PodDisruptionBudget e mais uma vez PodDisruptionBudget.
Os clusters são periodicamente atualizados, e os nós são esvaziados. Nada permanece no mesmo lugar, essa é a realidade. Cada implantação com mais de uma instância deve obrigatoriamente incluir o PDB (PodDisruptionBudget). Ele é criado em um simples arquivo yaml que é aplicado ao cluster. A cobertura específica de um PDB é definida pelos seletores de rótulos.
Nota: O orçamento do PDB é considerado apenas em uma interrupção orcussiva (). Em situações como falhas de hardware, o PDB não será acionado.
Exemplo de PDB:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: app-a-pdb
spec:
  minAvailable: 2
  selector:
      matchLabels:
        app: app-a
Os dois parâmetros principais são matchLabels e minAvailable. No primeiro parâmetro, especifica-se para quais aplicações o orçamento é aplicado. Por exemplo, se eu tiver implantações com rótulos app: app-a e app: app-b, este PDB se aplicará apenas à primeira.
Parâmetro minAvailable é considerado ao esvaziar (limpar) o nó. Por exemplo, em nosso exemplo, durante o esvaziamento, todas as instâncias app: app-a, exceto duas.
Isso permite controlar quantas instâncias da aplicação devem estar em execução a cada momento.
Monitoramento da integridade da aplicação
Esse monitoramento pode ser feito de duas maneiras: através das verificações Readiness ou Liveness.
A primeira verificação (readiness) determina se o contêiner está pronto para receber tráfego.
A segunda (liveness) mostra se o contêiner está funcionando corretamente ou se precisa ser reiniciado.
As configurações correspondentes são simplesmente adicionadas ao yaml para a implantação. Lá você pode especificar timeouts, tempos de atraso e o número de tentativas. Para mais detalhes sobre elas, veja a .
Rótulos em toda parte
Rótulos são um dos conceitos fundamentais no Kubernetes. Eles permitem que objetos se relacionem livremente entre si, além de criar consultas baseadas em rótulos. No Kubernetes, você pode até acessar o cliente e observar eventos por rótulos específicos.
Com rótulos, é possível fazer praticamente qualquer coisa, mas um bom exemplo seria criar múltiplos ambientes para executar programas em um único cluster.
Suponha que você utilize o mesmo cluster para dev e qa. Isso significa que você pode ter uma aplicação app-a, funcionando simultaneamente em ambos os ambientes qa e dev. Nesse caso, podemos nos referir separadamente à instância da aplicação em um ambiente específico, especificando o parâmetro correspondente environment. Por exemplo, app: app-a e environment: dev para um ambiente, e app: app-a e environment: qa para o segundo.
Isso permite acessar ambas as instâncias da aplicação, por exemplo, para realizar testes simultaneamente.
Mantenha a ordem
Kubernetes é um sistema muito poderoso, mas qualquer sistema eventualmente pode se atolá-lo em um grande número de processos. O Kubelet executa todos os processos e verificações que você especificou, além dos seus.
Claro, um serviço solto não vai desacelerar o sistema, e o Kubernetes foi projetado para escalabilidade desde o início. Mas se, em vez de um serviço, surgirem milhões, o kubelet começa a se afogar.
Se você, por algum motivo, excluir o deployment (container, imagem, o que for), apenas tenha certeza de que está limpando completamente.
Conheça o Go
O melhor conselho reservamos para o final. Estude a linguagem de programação Go.
O Kubernetes é escrito em Go, todas as extensões são escritas em Go, e ainda há uma biblioteca cliente client-go oficialmente suportada.
Ela pode ser usada para várias coisas interessantes. Por exemplo, para personalizar o sistema Kubernetes ao seu gosto. Assim, você pode usar seus próprios programas para coletar dados, implantar aplicativos ou simplesmente limpar contêineres.
Aprender a linguagem de programação Go e dominar o client-go é, sem dúvida, o conselho mais importante que se pode dar a novos usuários do Kubernetes.
O que mais ler:
- .
- ?
- .
Fonte: habr.com
