

Se você é como a maioria das pessoas, provavelmente utiliza recursos que funcionam fora do seu cluster. É possível que você esteja usando a API Taleo para enviar mensagens de texto ou analisando imagens com a API Google Cloud Vision.
Se você está usando o mesmo endpoint para receber solicitações no lado do servidor em todos os seus ambientes e não planeja mover seus servidores para o Kubernetes, é perfeitamente aceitável ter o endpoint do serviço diretamente no seu código. No entanto, existem muitos outros cenários possíveis. Nesta série de 'Melhores Práticas do Kubernetes', você aprenderá a usar os mecanismos integrados do Kubernetes para descoberta de serviços tanto dentro quanto fora do cluster.
Um exemplo comum de serviço externo é um banco de dados que opera fora do cluster do Kubernetes. Diferentemente de serviços de banco de dados em nuvem, como Google Cloud Data Store ou Google Cloud Spanner, que usam um único endpoint para todos os tipos de acesso, a maioria dos bancos de dados tem endpoints separados para diferentes circunstâncias.
Uma prática recomendada ao usar bancos de dados tradicionais, como MySQL e MongoDB, geralmente envolve a conexão a diferentes componentes para diferentes ambientes. Você pode ter uma máquina maior para dados de produção e uma máquina menor para o ambiente de teste. Cada uma terá seu próprio endereço IP ou nome de domínio, mas você certamente não gostaria de alterar seu código ao transitar de um ambiente para outro. Portanto, em vez de codificar esses endereços de forma rígida, você pode usar a descoberta de serviços integrada do Kubernetes para serviços externos baseada em DNS, assim como faria para serviços nativos do Kubernetes.
Suponha que você esteja executando um banco de dados MongoDB no Google Compute Engine. Você ficará preso nesse mundo híbrido até que consiga migrá-lo para o cluster.
Felizmente, você pode usar serviços estáticos do Kubernetes para facilitar a sua vida. Neste exemplo, eu criei um servidor MongoDB usando o Google Cloud Launcher. Como ele foi criado na mesma rede (ou VPC do cluster Kubernetes), o acesso é feito através de um IP interno de alto desempenho.
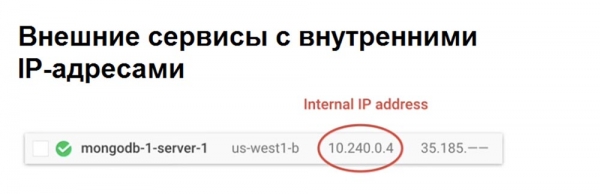
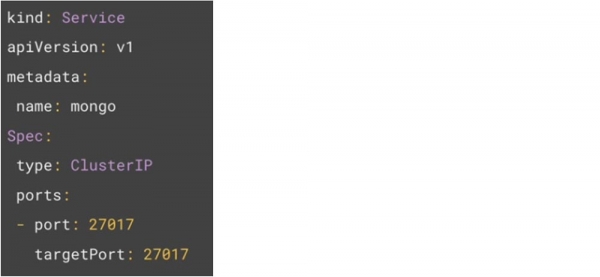
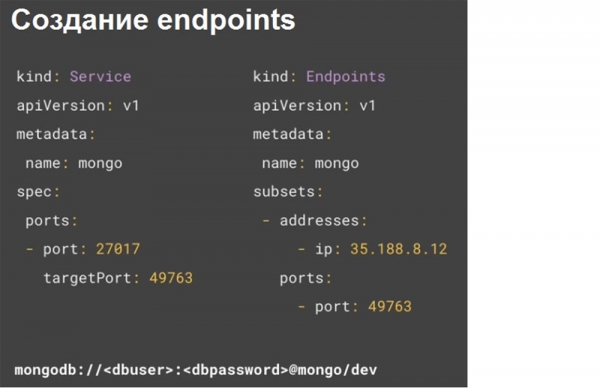
No Google Cloud, essa é a configuração padrão, então você não precisa configurar nada. Agora que temos um endereço IP, o primeiro passo é criar um serviço. Note que este serviço não possui seletores de pods. Ou seja, criamos um serviço que não saberá para onde enviar o tráfego. Isso permitirá criar manualmente um objeto de endpoint, que receberá o tráfego deste serviço.
O próximo exemplo de código mostra que os endpoints definem o endereço IP do banco de dados, utilizando o mesmo nome mongo que o serviço.
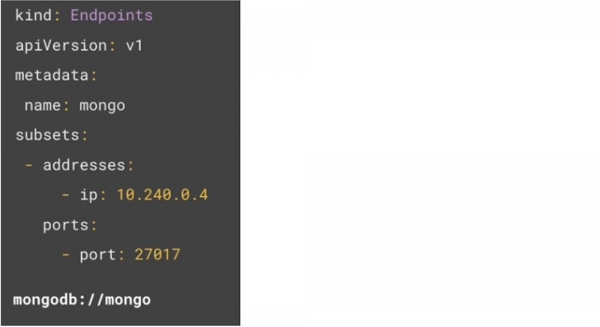
O Kubernetes utilizará todos os endereços IP para encontrar os endpoints, como se fossem pods comuns do Kubernetes, permitindo que você acesse o banco de dados com uma simples string de conexão para o nome mongodb://mongo. Não é necessário utilizar endereços IP em seu código.
Se no futuro os endereços IP mudarem, você pode simplesmente atualizar os endpoints com o novo endereço IP, e suas aplicações não precisarão ser alteradas de forma alguma.
Se você estiver usando um banco de dados hospedado em um provedor externo, provavelmente os proprietários do host fornecerão um identificador de recurso URI unificado para conexão. Portanto, se você recebeu um endereço IP, pode simplesmente usar o método anterior. Este exemplo mostra que tenho dois bancos de dados MongoDB hospedados no serviço mLab.
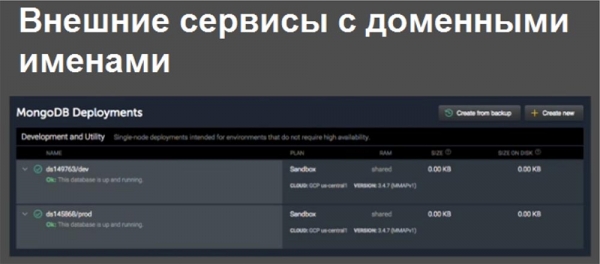
Um deles é o banco de dados de desenvolvimento, e o outro é o banco de dados de produção. As strings de conexão para esses bancos de dados são as seguintes — o mLab fornece um URI dinâmico e uma porta dinâmica. Como você pode ver, eles são diferentes.
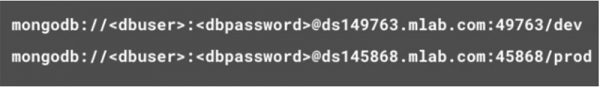
Para se abstrair disso, usamos Kubernetes e nos conectamos ao banco de dados de desenvolvimento. Você pode criar um nome de serviço externo do Kubernetes, que lhe fornecerá um serviço estático, direcionando o tráfego para um serviço externo.
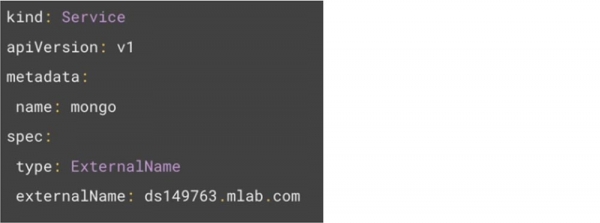
Este serviço realizará um simples redirecionamento CNAME a nível de núcleo, o que terá um impacto mínimo no desempenho. Com isso, você pode usar uma string de conexão mais simples.

Mas como o nome externo utiliza redirecionamento CNAME, ele não pode fazer o remapeamento de portas. Portanto, essa solução é aplicável apenas a portas estáticas e não pode ser usada com portas dinâmicas. No entanto, o plano gratuito mLab Free Tier fornece por padrão um número de porta dinâmico ao usuário, e você não pode alterar isso. Isso significa que para dev e prod você precisa de diferentes strings de conexão. O lado ruim é que será necessário codificar rigidamente o número da porta. Então, como fazer o remapeamento de portas funcionar?
O primeiro passo é obter o endereço IP do URI. Se você executar o comando nslookup, hostname ou ping no URI, poderá obter o endereço IP do banco de dados. Se o serviço retornar vários endereços IP, todos esses endereços podem ser usados nos pontos finais do objeto.
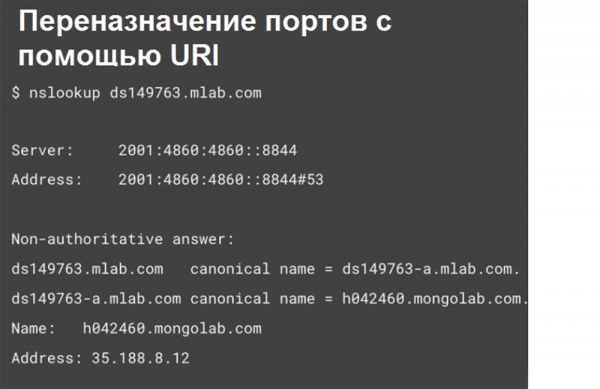
É importante lembrar que os endereços IP do URI podem mudar sem aviso prévio, portanto, é bastante arriscado usá-los em produção. Com esse endereço IP, você pode se conectar a um banco de dados remoto sem especificar a porta. Assim, o serviço Kubernetes realiza o remapeamento de portas de maneira bastante transparente.
O mapeamento, ou associação de recursos externos com internos, permite que você use esses serviços dentro do cluster de forma flexível no futuro, minimizando o esforço de refatoração. Também facilita a gestão e dá uma compreensão de quais serviços externos a sua empresa está utilizando.
A continuação virá em breve…
Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
