

À medida que você começa a criar mais serviços do Kubernetes, tarefas simples no início começam a se complicar. Por exemplo, equipes de desenvolvedores não podem criar serviços ou implantações com o mesmo nome. Se você tem milhares de pods, listar todos eles levará muito tempo, sem mencionar garantir uma boa gestão. E isso é apenas a ponta do iceberg.
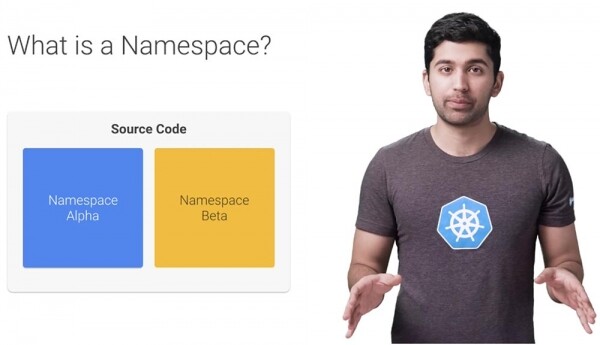
Vamos ver como o namespace facilita a gestão de recursos do Kubernetes. Então, o que é um namespace? Um namespace pode ser visto como um cluster virtual dentro do seu cluster Kubernetes. Você pode ter vários namespaces isolados entre si dentro de um único cluster Kubernetes. Eles realmente podem ajudar você e suas equipes com organização, segurança e até mesmo desempenho do sistema.
Na maioria das distribuições do Kubernetes, o cluster já vem com um namespace chamado 'default'. Na verdade, existem três namespaces com os quais o Kubernetes lida: default, kube-system e kube-public. Atualmente, o kube-public não é utilizado com muita frequência.
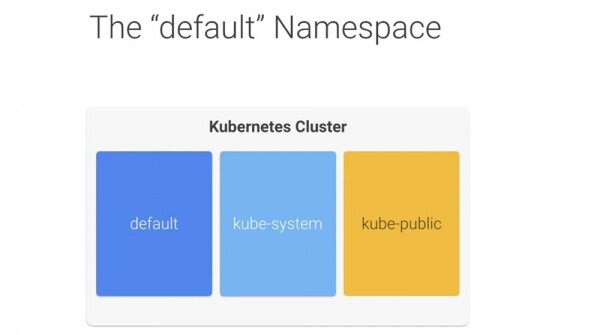
Evitar tocar no namespace kube é uma boa ideia, especialmente em um sistema gerido como o Google Kubernetes Engine. Ele utiliza o namespace 'default' como o local onde seus serviços e aplicações são criados. Não há nada de especial nele, exceto que o Kubernetes vem configurado para usá-lo 'pronto para uso', e você não pode excluí-lo. Isso é ótimo para começar e para sistemas de baixo desempenho, mas eu não recomendaria usar o namespace default em grandes sistemas de produção. Neste último caso, uma equipe de desenvolvedores pode facilmente sobrescrever o código de outra e interromper o funcionamento de outra equipe, sem perceber.
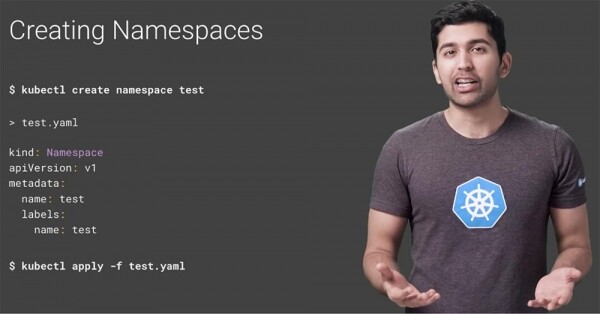
Portanto, você deve criar vários namespaces e utilizá-los para segmentar seus serviços em unidades geridas. Um namespace pode ser criado com um único comando. Se você quiser criar um namespace chamado test, use o comando $ kubectl create namespace test ou simplesmente crie um arquivo YAML e use-o como qualquer outro recurso do Kubernetes.
Você pode visualizar todos os namespaces com o comando $ kubectl get namespace.
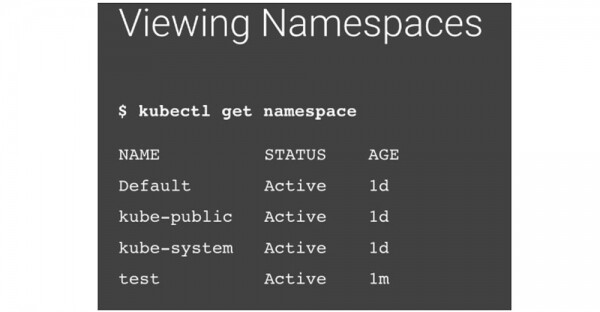
Após sua execução, você verá três namespaces incorporados e um novo namespace chamado "test". Vamos examinar um arquivo YAML simples destinado à criação de um pod. Você pode notar que não há menção a qualquer namespace.
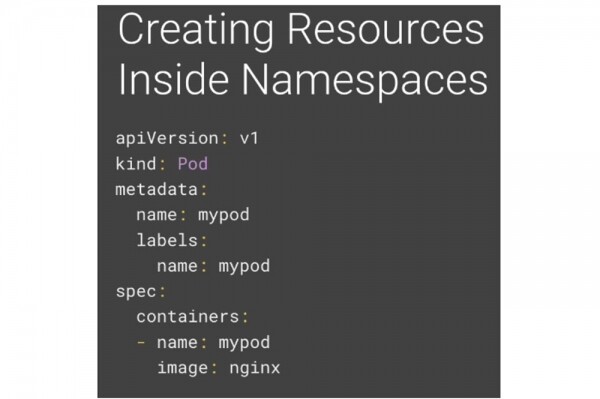
Se você usar kubectl para executar este arquivo, ele criará o módulo mypod no namespace ativo atual. Este será o namespace padrão, até que você o altere. Existem duas maneiras de informar ao Kubernetes em qual namespace você deseja criar seu recurso. A primeira maneira é usar a flag de namespace ao criar o recurso.

A segunda maneira consiste em especificar o namespace na declaração YAML.
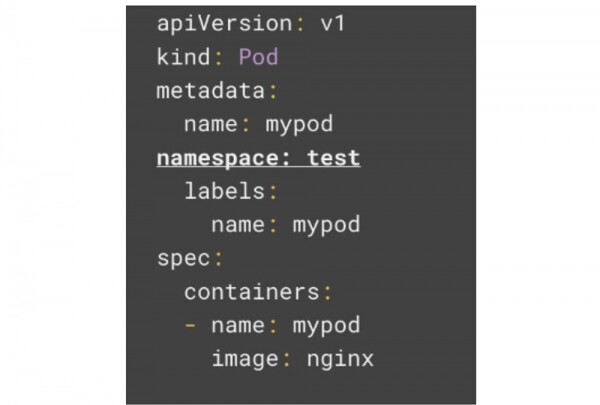
Se você especificar o namespace no YAML, o recurso sempre será criado nesse namespace. Se você tentar usar um namespace diferente ao usar a flag de namespace, o comando falhará. Agora, se você tentar encontrar seu pod, não conseguirá.
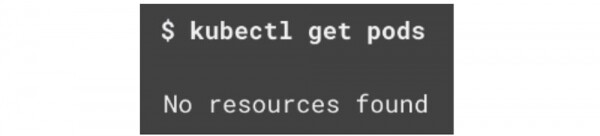
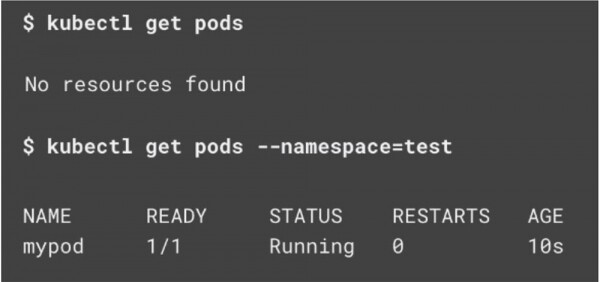
Isso acontece porque todos os comandos são executados fora do namespace ativo atual. Para encontrar seu pod, você precisará usar a flag de namespace, porém isso rapidamente se torna cansativo, especialmente se você é um desenvolvedor em um grupo que usa seu próprio namespace e não quer usar essa flag para cada comando individual. Vamos ver como isso pode ser resolvido.
Por padrão, seu namespace ativo é chamado de default. Se você não especificar o namespace no YAML do recurso, todos os comandos do Kubernetes usarão este namespace ativo default. Infelizmente, tentar gerenciar o namespace ativo com kubectl pode falhar. No entanto, existe uma ótima ferramenta chamada Kubens, que simplifica muito esse processo. Quando você executa o comando kubens, você vê todos os namespaces com o namespace ativo destacado.
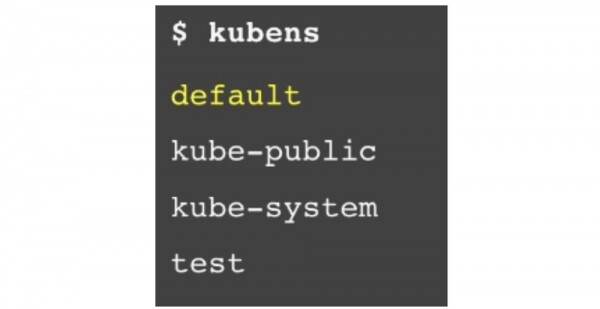
Para mudar o namespace ativo para o namespace test, você simplesmente executa o comando $ kubens test. Se você digitar novamente o comando $ kubens, verá que agora um novo namespace ativo – test – está destacado.
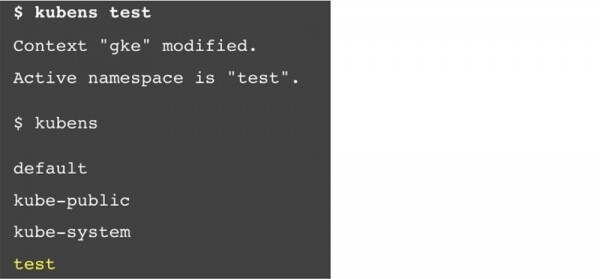
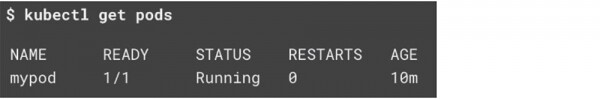
Isso significa que você não precisa de uma flag de namespace para ver o pod no namespace test.
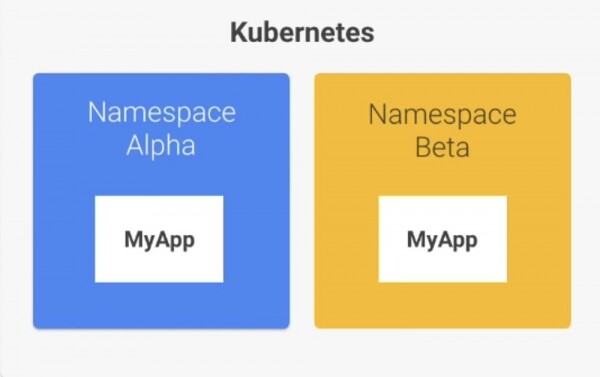
Dessa forma, os namespaces estão ocultos uns dos outros, mas não isolados. Um serviço de um namespace pode se comunicar facilmente com um serviço em outro namespace, o que muitas vezes é muito útil. A capacidade de comunicação entre diferentes namespaces significa que o serviço de seus desenvolvedores pode interagir com o serviço de outra equipe de desenvolvimento em um namespace diferente.
Normalmente, quando seu aplicativo quer acessar um serviço Kubernetes, você usa o serviço de descoberta DNS embutido e simplesmente informa ao seu aplicativo o nome do serviço. No entanto, você pode criar um serviço com o mesmo nome em vários namespaces, o que não é permitido.
Felizmente, é fácil contornar isso usando a forma expandida do endereço DNS. Os serviços no Kubernetes expõem seus endpoints usando um padrão DNS comum. Isso se parece com algo assim:

Geralmente, você só precisa do nome do serviço, e o DNS determinará automaticamente o endereço completo.

No entanto, se você precisar acessar um serviço em outro namespace, basta usar o nome do serviço mais o nome do namespace:

Por exemplo, se você quiser se conectar ao banco de dados do serviço no namespace de teste, pode usar o endereço database.test
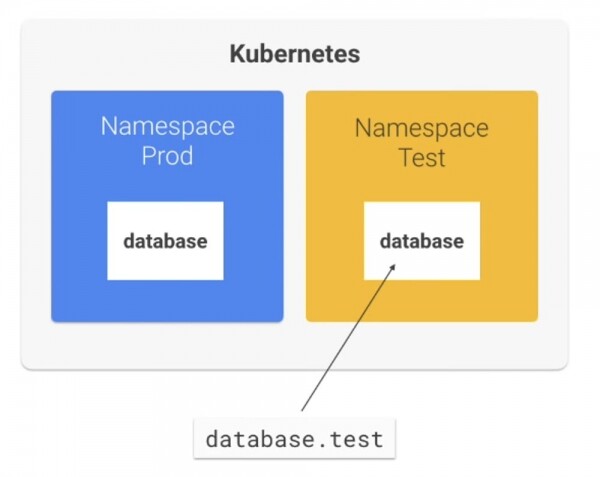
Se você deseja se conectar ao banco de dados do serviço no namespace prod, usa database.prod.
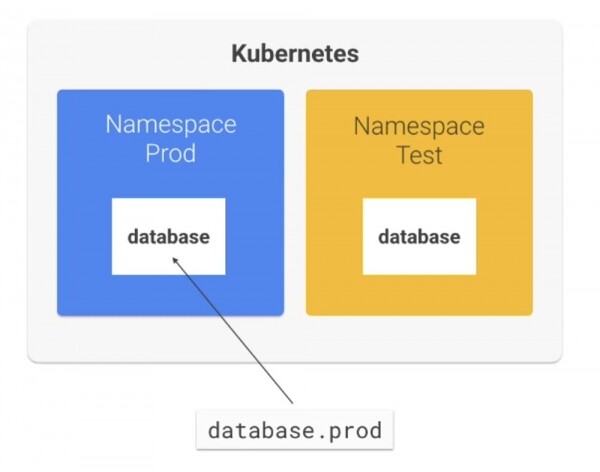
Se você realmente deseja isolar e restringir o acesso ao namespace, o Kubernetes permite fazer isso com políticas de rede Kubernetes Network Policies. Eu falarei sobre isso na próxima série.
Recebo frequentemente a pergunta de quantos namespaces criar e para quais propósitos. O que é um fragmento de dados gerenciado?
Se você criar muitos espaços de nomes, eles simplesmente ficarão no seu caminho. Se houver muito poucos, você perderá todas as vantagens de tal solução. Acredito que existem quatro etapas principais que cada empresa passa ao criar sua estrutura organizacional. Dependendo da fase de desenvolvimento em que seu projeto ou empresa se encontra, você pode adotar a estratégia apropriada para a criação de espaços de nomes.
Imagine que você faz parte de uma pequena equipe que está trabalhando no desenvolvimento de 5 a 10 microsserviços e consegue facilmente reunir todos os desenvolvedores em uma sala. Nessa situação, faz sentido executar todos os serviços prod no espaço de nomes default. Claro, para mais liberdade de ação, você pode usar 2 espaços de nomes — um separado para prod e outro para dev. É bem possível que você esteja testando seu desenvolvimento no computador local com algo como o Minikube.
Suponha que as condições mudaram e agora você tem uma equipe em rápido crescimento que está trabalhando simultaneamente em mais de 10 microsserviços. Chega um momento em que é necessário usar vários clusters ou espaços de nomes, separados para prod e dev. Você pode dividir a equipe em vários subgrupos, de modo que cada um tenha seus próprios microsserviços e cada uma dessas equipes possa escolher seu próprio espaço de nomes para facilitar o processo de gerenciamento do desenvolvimento e lançamento de software.
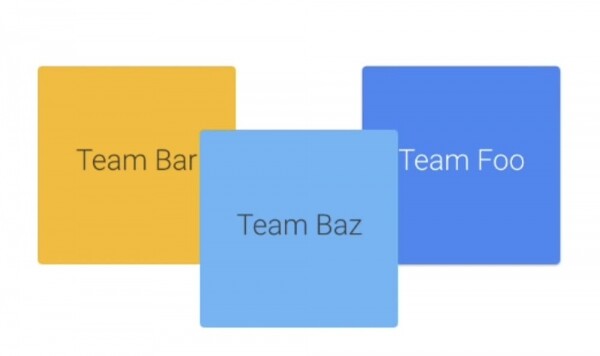
À medida que cada membro da equipe começa a entender como o sistema funciona como um todo, coordenar cada alteração com todos os outros desenvolvedores se torna cada vez mais difícil. A tentativa de rodar toda a pilha em seu computador local torna-se mais complicada a cada dia.
Em grandes empresas, os desenvolvedores muitas vezes não sabem exatamente em que parte estão trabalhando. As equipes se comunicam através de contratos de serviço ou utilizam a tecnologia Service mesh, que adiciona um nível de abstração sobre a rede, similar a ferramentas de configuração como o Istio. Tentar executar toda a pilha localmente é praticamente impossível. Recomendo fortemente utilizar no Kubernetes uma plataforma de entrega contínua (CD) como o Spinnaker. Portanto, chega o momento em que cada equipe definitivamente precisa de seu próprio espaço de nomes. Cada equipe pode até escolher vários espaços de nomes para os ambientes de desenvolvimento e produção.
Finalmente, existem grandes empresas onde um grupo de desenvolvedores nem sabe da existência de outros grupos. Tal empresa pode até contratar desenvolvedores externos que interagem através de APIs bem documentadas. Dentro de cada um desses grupos, há várias equipes e vários microsserviços. Nesse caso, é necessário utilizar todas as ferramentas mencionadas anteriormente.
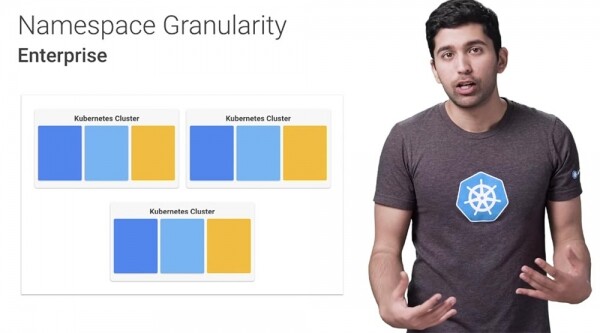
Os programadores não devem implantar serviços manualmente e não devem ter acesso a espaços de nomes que não lhes dizem respeito. Nesta fase, faz sentido ter vários clusters para reduzir o 'raio de explosão' de aplicativos mal configurados, para simplificar os processos de cobrança e gerenciamento de recursos.
Assim, o uso correto dos espaços de nomes por sua organização torna o Kubernetes mais gerenciável, controlável, seguro e flexível.
Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
