

Olá.
Decidi compartilhar minha descoberta — um fruto de reflexões, tentativas e erros.
De uma forma geral: isso não é uma descoberta, é claro — tudo isso já devia ser conhecido por quem trabalha com processamento de dados aplicado e otimização de sistemas, não necessariamente apenas em bancos de dados.
E: sim, eles sabem, escrevem artigos interessantes sobre suas pesquisas, (ATUALIZAÇÃO: nos comentários mencionaram um projeto muito interessante: )
Por outro lado: à primeira vista, não vejo uma ampla menção ou divulgação dessa abordagem na internet, entre profissionais de TI e DBA.
Então, ao ponto.
Digamos que temos a tarefa: configurar um sistema de serviço para realizar algum trabalho.
Sobre esse trabalho — sabe-se: qual é, como a qualidade desse trabalho é medida e qual é o critério indicador dessas medições.
Além disso, suponhamos que mais ou menos seja conhecido: como exatamente o trabalho é feito (ou com) esse sistema de serviço.
"Mais ou menos" — isso significa que existe a possibilidade de preparar (ou encontrar) alguma ferramenta, utilitário, serviço que possa sintetizar e fornecer ao sistema uma carga de teste bastante adequada ao que será feito em produção, em condições razoavelmente adequadas de trabalho em produção.
E, suponhamos que um conjunto de parâmetros de ajuste desse sistema de serviço é conhecido, com os quais é possível configurar esse sistema em termos de produtividade do seu trabalho.
E, qual é o problema — não há uma compreensão suficientemente completa desse sistema de serviço, tal que permita ajustar o funcionamento desse sistema, para a carga futura, nessa plataforma e obter a produtividade necessária do trabalho do sistema.
Bem, isso acontece quase sempre.
O que pode ser feito.
Bem, a primeira coisa que vem à cabeça: consultar a documentação desse sistema. Entender — quais são os intervalos permitidos para os valores dos parâmetros de ajuste. E, por exemplo, utilizando o método de descida de coordenadas, ajustar os valores dos parâmetros do sistema nos testes.
Ou seja, fornecer ao sistema uma configuração, na forma de um conjunto específico de valores de seus parâmetros de ajuste.
Fornecer a carga de teste usando essa mesma ferramenta-utilitário, gerador de carga.
E observar a grandeza — a resposta, ou a métrica de qualidade do funcionamento do sistema.
Um segundo pensamento pode ser a conclusão de que — isso realmente leva muito tempo.
Ou seja: se houver muitos parâmetros de configuração, se os intervalos possíveis de seus valores forem grandes, se cada teste de carga demorar muito tempo para ser executado, então: sim, isso pode levar um tempo inaceitavelmente longo.
E aqui, o que pode ser compreendido e lembrado.
Pode-se descobrir que, no conjunto de valores dos parâmetros de configuração do sistema de serviço, existe um vetor, como uma sequência de certos valores.
A cada vetor desse, considerando outras condições iguais (no sentido de que esse vetor não seja afetado), corresponde um valor bem definido de uma métrica — indicador de qualidade do desempenho do sistema sob carga de teste.
Ou seja.
Vamos denotar o vetor de configuração do sistema como  , onde
 ; onde
 — o número de parâmetros de configuração do sistema, quantos são esses parâmetros.
E o valor da métrica correspondente a esse  denotaremos como
 , então, temos uma função:

Assim, tudo se resume, no meu caso, a algoritmos de busca de extremos da função, quase esquecidos desde os tempos de estudante.
Ótimo, mas surge uma questão organizacional e prática: qual algoritmo usar exatamente.
- No sentido de — para não precisar codificar muito manualmente.
- E que funcione, ou seja, que encontre o extremo (se existir), pelo menos — mais rapidamente do que o método de descida de coordenadas.
O primeiro ponto sugere que precisamos olhar para algum ambiente onde tais algoritmos já estão implementados e disponíveis em algum formato pronto para uso no código.
Bem, eu conheço python e cran-r
O segundo ponto indica que precisamos ler sobre os próprios algoritmos, quais existem, quais são seus requisitos, características de funcionamento.
E o que eles oferecem, que podem produzir efeitos colaterais úteis, ou diretamente, a partir do próprio algoritmo.
Ou eles podem ser obtidos a partir dos resultados do funcionamento do algoritmo.
Aqui, muito depende das condições de entrada.
Por exemplo, se por algum motivo, for necessário obter um resultado mais rápido, então é preciso olhar para algoritmo de descida em gradiente, escolhendo um deles.
Ou, se o tempo não for tão importante, podemos usar métodos de otimização estocástica, como algoritmos genéticos.
Proponho considerar o funcionamento desse método, na configuração do sistema, usando o algoritmo genético, no próximo trabalho de laboratório, por assim dizer.
Dados de entrada:
- Vamos assumir que há, como sistema de serviço:
oracle xe 18c - Vamos supor que ele — gerencia a atividade transacional e o objetivo: alcançar a maior capacidade de throughput possível para o SGBD, em transações/segundo.
- As transações — podem ser bastante diferentes, em seu caráter de trabalho com dados e no contexto de operação.
Vamos concordar que são transações que não processam uma grande quantidade de dados de tabelas.
No sentido de que não geram mais dados undo do que redo e não processam grandes porcentagens de linhas, em grandes tabelas.
São transações que alteram uma linha em uma tabela moderadamente grande, com um pequeno número de índices sobre essa tabela.
Nesse caso, a produtividade do SGBD na manipulação de transações será, com ressalvas, definida pela qualidade do processamento dos dados redo.
A ressalva — se falarmos especificamente sobre as configurações do SGBD.
Porque, em um caso geral, podem ocorrer, por exemplo, bloqueios transacionais entre sessões SQL, devido ao design do trabalho do usuário com dados de tabelas e/ou ao modelo de tabelas.
Os quais, naturalmente, terão um impacto negativo na métrica TPS e esse será um fator exógeno, em relação ao SGBD: bem, foi assim que se projetou o modelo de tabelas e o trabalho com os dados nele que surgem os bloqueios.
Portanto, para a clareza do experimento, excluiremos esse fator, abaixo explicarei como exatamente.
- Vamos supor, para clareza, que 100% dos comandos SQL enviados ao SGBD: são comandos DML.
Suponha que as características do trabalho do usuário com o SGBD: permanecem as mesmas, nos testes.
Ou seja: o número de sessões SQL, dados tabulares, como as sessões SQL interagem com eles. - O SGBD opera em
FORCE LOGGING,ARCHIVELOGmodos. O modo de flashback database está desativado, no nível do SGBD. - Os dados redo: estão localizados em um sistema de arquivos separado, em um 'disco' separado;
Todo o restante da parte física do BD: em outro sistema de arquivos separado, em um 'disco' separado:
Mais detalhes sobre a estrutura da parte física do banco de dados de laboratório
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "\/db\/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Inicialmente, eu queria usar um SGBD para transações sob essas condições de carga.
Ele tem uma característica maravilhosa, cito o autor:
No coração do SLOB está o "método SLOB." O método SLOB visa testar plataformas
sem contenção de aplicativo. Não se pode atingir o máximo desempenho de hardware
usando código de aplicativo que, por exemplo, é limitado por bloqueio de aplicativo ou até mesmo
compartilhamento de blocos do Oracle Database. Isso mesmo — há sobrecarga ao compartilhar dados
em blocos de dados! Mas o SLOB — em sua implementação padrão — é imunizado contra tal contenção.
Esta declaração: corresponde, e é verdade.
É conveniente regular o grau de paralelismo das sessões SLOB, isso é crucial. -t inicia o utilitário runit.sh como parte do SLOB
Regula a porcentagem de comandos DML, no total de consultas que cada sessão SLOB envia ao SGBD, o parâmetro UPDATE_PCT
Separadamente e de forma muito conveniente: SLOB ele mesmo, antes e após a sessão de carga — prepara o statspack ou as instantâneas AWR (conforme configurado).
No entanto, descobriu-se que SLOB não suporta sessões SLOB com duração inferior a 30 segundos.
Por isso, inicialmente programei minha própria versão do carregador, rústica, mas funcional, e ela acabou ficando em uso.
Vou esclarecer sobre o carregador — o que ele faz, para que fique claro.
Essencialmente, o carregador se parece com isto:
Código do trabalhador
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Os trabalhadores são iniciados assim:
Início dos trabalhadores
echo "iniciando teste, duração: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "aguardando..." >> "$v_logfile"
wait
As tabelas para os trabalhadores são preparadas da seguinte forma:
Criação de tabelas
function createtable() {
source "\/home\/oracle\/testingredotracе\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\n
create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Ou seja, para cada trabalhador (praticamente: uma sessão SQL separada no SGBD) é criada uma tabela separada, com a qual o trabalhador opera.
Isso permite a ausência de bloqueios transacionais entre as sessões SQL dos trabalhadores.
Cada trabalhador: realiza a mesma ação em sua tabela, todas as tabelas são iguais.
Todos os trabalhadores executam a tarefa durante o mesmo período de tempo.
Além disso, o tempo é suficientemente longo para que, por exemplo, ocorra uma troca de log, e não apenas uma vez.
Assim, surgem os custos e efeitos associados a isso.
No meu caso, a duração do trabalho dos trabalhadores foi configurada para 8 minutos.
Um trecho do relatório statspack, com a descrição do funcionamento do SGBD sob carga.
Banco de Dados    ID do DB    Instância     Número da Instância  Hora de Inicialização   Versão     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Set-20 23:12 18.0.0.0.0  NÃO

Nome do Host             Plataforma                CPUs Núcleos Soquetes   Memória (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Instantâneo       ID do Instantâneo     Hora do Instantâneo      Sessões Curs/Sess Comentário
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Início do Instantâneo:       1630 07-Set-20 23:12:27       55        .7
  Fim do Instantâneo:       1631 07-Set-20 23:20:29       62        .6
   Decorrido:       8.03 (mins) Média de Sessões Ativas:       8.4
   Tempo do DB:      67.31 (mins)      CPU do DB:      15.01 (mins)

Tamanhos de Cache            Início        Fim
~~~~~~~~~~~       ---------- ----------
    Cache de Buffer:     1,392M              Tamanho do Bloco Padrão:         8K
     Pool Compartilhado:       288M                  Buffer de Log:   103,424K

Perfil de Carga              Por Segundo    Por Transação    Por Execução    Por Chamada
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      Tempo do DB(s):                8.4                0.0        0.00        0.20
       CPU do DB(s):                1.9                0.0        0.00        0.04
       Tamanho do Redo:        7,685,765.6              978.4
   Leituras Lógicas:           60,447.0                7.7
   Alterações de Bloco:           47,167.3                6.0
  Leituras Físicas:                8.3                0.0
 Escritas Físicas:              253.4                0.0
      Chamadas de Usuário:               42.6                0.0
          Análises:               23.2                0.0
     Análises Duras:                1.2                0.0
W/A MB processados:                1.0                0.0
          Logins:                0.5                0.0
        Execuções:           15,756.5                2.0
       Reversões:                0.0                0.0
    Transações:            7,855.1
Voltando à proposta de trabalho de laboratório.
Vamos, com outras variáveis constantes, variar os valores de tais parâmetros do SGBD de laboratório:
- Tamanho dos grupos de log do banco de dados. faixa de valores: [32, 1024] Megabytes;
- Número de grupos de log do banco de dados. faixa de valores: [2,32];
log_archive_max_processesfaixa de valores: [1,8];commit_loggingsão permitidos dois valores:batch|immediate;commit_waitsão permitidos dois valores:wait|nowait;log_bufferfaixa de valores: [2,128] Megabytes.log_checkpoint_timeoutfaixa de valores: [60,1200] segundosdb_writer_processesfaixa de valores: [1,4]undo_retentionfaixa de valores: [30;300] segundostransactions_per_rollback_segmentfaixa de valores: [1,8]disk_asynch_iosão permitidos dois valores:true|false;filesystemio_optionssão permitidos os seguintes valores:none|setall|directIO|asynch;db_block_checkingsão permitidos os seguintes valores:OFF|LOW|MEDIUM|FULL;db_block_checksumsão permitidos os seguintes valores:OFF|TYPICAL|FULL;
Uma pessoa com experiência em suporte a bancos de dados Oracle certamente já pode dizer agora — quais e quais valores devem ser definidos entre os parâmetros e seus valores permitidos para obter maior produtividade do SGBD, conforme o trabalho com dados descrito, pelo código aplicativo, aqui, acima.
Mas.
O objetivo do trabalho de laboratório é mostrar que o algoritmo de otimização é, de fato, relativamente rápido.
Nosso trabalho: resta apenas olhar na documentação do sistema configurável, na medida necessária para descobrir: quais parâmetros e em quais intervalos devem ser alterados.
Além disso: codificar o código que implementará o funcionamento com o sistema configurável do algoritmo de otimização escolhido.
Assim, agora sobre o código.
Conforme mencionado anteriormente, cran-r, ou seja: todas as manipulações com o sistema configurável são orquestradas na forma de um script R.
Basicamente, a tarefa é a análise e a seleção de acordo com o valor da métrica e os vetores de estado do sistema: este é o pacote GA ()
O pacote, neste caso, não é muito adequado, no sentido de que ele espera vetores (cromossomos, se usando a terminologia do pacote) como números contínuos.
E meu vetor, a partir dos valores dos parâmetros configuráveis: consiste em 14 valores — números inteiros e valores de string.
O problema, claro, é facilmente contornado, atribuindo valores de string a determinados números.
Assim, no final, a parte principal do script R se parece com isso:
Chamada GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Aqui, com o auxílio lower e upper dos atributos da sub-rotina ga define-se, na verdade, a área do espaço de busca dentro da qual será procurado um vetor (ou vetores) para os quais será obtido o valor máximo da função de fitness.
A sub-rotina ga realiza a busca maximizando a função de fitness.
Portanto, resulta que, neste caso, é necessário que a função de fitness, entendendo o vetor como um conjunto de valores para determinados parâmetros do SGBD, receba a métrica do SGBD.
Ou seja: quantas transações por segundo o SGBD processa, dada a configuração do SGBD e a carga sobre o SGBD.
Ou seja, desdobrando: é preciso que dentro da função de fitness haja um passo intermediário:
- Processamento do vetor de entrada de números — convertê-lo em valores para os parâmetros do SGBD.
- Tentativa de criar o número especificado de grupos redo, de tamanho definido. E a tentativa: pode falhar.
Os grupos de registro já existentes no SGBD, em algum número e tamanho, devem ser removidos para garantir a pureza do experimento. - Se o item anterior for bem-sucedido: atribuir à base os valores dos parâmetros de configuração (novamente: pode haver falha)
- Se o item anterior for bem-sucedido: parar o SGBD, iniciar o SGBD para que os novos valores dos parâmetros entrem em vigor. (novamente: pode haver falha)
- Se o item anterior for bem-sucedido: realizar um teste de carga. obter métricas do SGBD.
- Restaurar o SGBD ao estado original, ou seja, remover grupos de registros adicionais, retornar à configuração original do SGBD.
Código da função de fitness
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," tenta avaliar o vetor: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"falha ao criar grupos adicionais",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module,"não foi possível iniciar o db com esse vetor de configurações",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module,"não foi possível iniciar o db com esse vetor de configurações",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("resultado: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Assim, todo o trabalho: é realizado na função de fitness.
Subprograma ga, processa vetores, ou, mais precisamente, fala-se de cromossomos.
No qual, o que mais nos importa: a seleção de cromossomos com esses genes, para os quais a função de fitness fornece valores altos.
Isso, na essência, é o processo de busca do conjunto ótimo de cromossomos em um vetor, no espaço de pesquisa N-dimensional.
Uma explicação muito clara e detalhada , com exemplos de código R, do funcionamento do algoritmo genético.
Destaco separadamente dois pontos técnicos.
Chamadas auxiliares, da função evaluate, por exemplo, parada-início, definição do valor do parâmetro do SGBD, são executadas com base na cran-r função system2
Com a qual: já é chamado algum script bash ou comando.
Por exemplo:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if (length(attributes(x)) > 0) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
O segundo ponto — linha, evaluate da função, preservando o valor específico da métrica e o vetor de configuração correspondente, no arquivo de log:
cat(paste("resultado: ",v_metric," ",v_vector,sep=""), file=v_logfile, sep="n", append=T)Isso é importante, pois, a partir desse conjunto de dados, será possível obter informações adicionais sobre qual dos componentes do vetor de configuração influencia mais ou menos o valor da métrica.
Isto é: será possível realizar uma análise de importância de atributos.
Então, o que pode resultar.
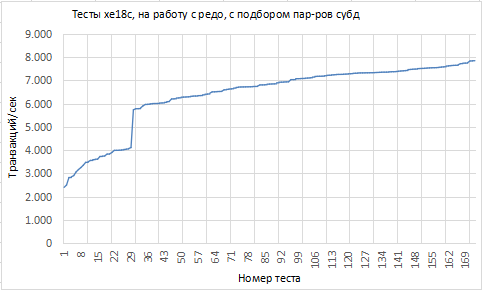
Em forma de gráfico, se ordenarmos os testes pelo aumento da métrica, o quadro é o seguinte:
Alguns dados correspondentes aos valores extremos da métrica:
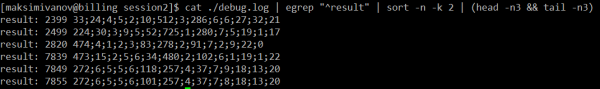
Aqui, na captura de tela com os resultados, esclareço: os valores do vetor de configuração são dados em termos do código da função de fitness, não em termos de uma lista numérica de parâmetros/faixas de valores de parâmetros, conforme formulado anteriormente no texto.
Bem. Muito isso, ou pouco, ~8 mil tps: é uma questão separada.
No âmbito do trabalho de laboratório — este número não importa, o que importa é a dinâmica, como esse valor muda.
A dinâmica aqui é boa.
É evidente que, pelo menos um fator, tendo um impacto significativo no valor da métrica, o algoritmo ga, ao percorrer os vetores-cromossomos: foi bem-sucedido.
Pela dinâmica bastante animada da curva, existe pelo menos um fator que, embora menor, ainda exerce influência.
Aqui precisamos de attribute-importance uma análise para entender quais atributos (neste caso, componentes do vetor de configuração) e quão fortemente influenciam o valor da métrica.
E a partir dessa informação, entender quais fatores foram afetados pelas alterações dos atributos significativos.
Executar attribute-importance pode ser feito de várias maneiras.
Para esses fins, gosto do algoritmo randomForest do pacote R homônimo, que, pelo que entendo do seu funcionamento geral e de sua abordagem para avaliar a importância dos atributos, constrói um modelo de dependência da variável resposta em relação aos atributos.)
randomForestNo nosso caso, a variável resposta é a métrica obtida dos SGBDs em testes de carga:
tps E os atributos são os componentes do vetor de configuração.;
Então, ele
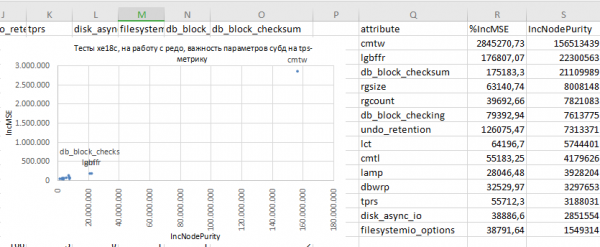
avalia a importância de cada atributo do modelo com dois números: randomForest %IncMSE — que mostra como a presença/ausência desse atributo no modelo altera a qualidade MSE desse modelo (Mean Squared Error); E IncNodePurity — que é um número que reflete quão bem, de acordo com os valores desse atributo, o conjunto de dados pode ser dividido, de modo que uma parte contenha dados com um único valor da métrica explicada, e a outra parte com outro valor da métrica.
Ou seja: quão classificador é esse atributo (a explicação mais clara em russo sobre random forest que encontrei foi
Código R para processar o conjunto de dados com os resultados dos testes de carga: ).
x=NULL v_data_file=paste('\/tmp\/data1.dat',sep="") x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE) colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7)) idxNotTrain=which(! 1:nrow(x) %in% idxTrain ) TrainDS=x[idxTrain,] ValidateDS=x[idxNotTrain,]library(randomForest) #mtry=as.integer( sqrt(dim(x)[2]-1) ) rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F) ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response") sum((ValidateDS$metric-ValidateDS$predicted)^2) rf$importance
Podemos ajustar manualmente os hiperparâmetros do algoritmo e, orientando-nos pela qualidade do modelo, escolher um modelo mais preciso para previsões no conjunto de validação.Podemos escrever alguma função para esse trabalho (aliás, novamente, com algum algoritmo de otimização).
Podemos usar o pacote R
caret , não importa., não importa.
No final, neste caso, obtemos o seguinte resultado para avaliar a importância dos atributos:
Então, podemos começar a reflexões globais:
- Assim, o parâmetro mais significativo, nas condições de teste, foi o
commit_wait
Tecnicamente, ele define o modo de execução da operação io de gravação dos dados de redo, do log buffer do SGBD, no grupo de logs current: síncrono ou assíncrono.
O valornowaitonde ocorre um aumento praticamente vertical e múltiplo do valor da métrica tps: isso habilita o modo assíncrono de io nos grupos de redo.
Uma questão separada é se devemos ou não fazer isso em um banco de dados em produção. Aqui me limito apenas a constatar: isso é um fator significativo. - É lógico que o tamanho do log buffer do SGBD se revela um fator importante.
Quanto menor o tamanho do log buffer, menor é sua capacidade de bufferização, o que resulta em overflow mais frequentes e/ou na impossibilidade de alocar um espaço livre para novos dados de redo.
E significa que: há atrasos relacionados à alocação de espaço no log buffer e/ou ao descarregamento dos dados de redo dele para os grupos de redo.
Esses atrasos, certamente, devem e afetam a capacidade de throughput do SGBD em transações. - Parâmetro
db_block_checksum: bem, isso também está claro — o processamento de transações leva à formação de dirty blocks no cache buffer do SGBD.
Que, com a verificação ativa de checksums dos data blocks, a base precisa processar — calcular esses checksums a partir do corpo do data block, compará-los com o que está escrito no header do data block: coincide/não coincide.
Esse tipo de trabalho, novamente, não pode deixar de atrasar o processamento de dados, e assim o parâmetro e o mecanismo que define esse parâmetro se tornam significativos.
Portanto, o fornecedor sugere, na documentação sobre este parâmetro, diferentes valores para ele e observa que — sim, haverá impacto, mas, bem, você pode escolher entre diferentes valores, até mesmo "desativado", e o impacto variará.
Assim, a conclusão global.
A abordagem, de fato, se mostra bastante funcional.
Ela permite, nas primeiras etapas do teste de carga de um sistema de serviço, escolher a configuração ideal do sistema para cargas sem precisar se aprofundar muito nas particularidades de configuração do sistema para a carga.
Mas não exclui completamente — ao menos no nível da compreensão: é necessário conhecer os "botões de ajuste" e os intervalos permitidos de rotação desses botões.
Em seguida, a abordagem pode rapidamente encontrar a configuração otimizada do sistema.
E pode-se, após os testes, obter informações sobre a natureza da relação entre a métrica de qualidade do desempenho do sistema e os valores dos parâmetros ajustáveis do sistema.
Isso, é claro, deve contribuir para o surgimento desse profundo entendimento do sistema, de seu funcionamento, pelo menos — sob a carga específica.
Praticamente, isso refere-se à troca de custos pela compreensão do sistema configurável, em relação aos custos de preparação para esse tipo de teste de desempenho do sistema.
Destaco que, nesta abordagem, é criticamente importante a adequação dos testes do sistema às condições de operação que ele terá na produção.
Obrigado pela sua atenção e tempo.
Fonte: habr.com
