

Neste artigo, é proposto um método de indução difusa desenvolvido pelo autor como uma fusão dos princípios da matemática difusa e da teoria dos fractais, introduzindo o conceito de grau de recursão de um conjunto difuso e apresentando uma descrição da recursão incompleta do conjunto como sua dimensão fracionária para modelagem de domínio. Como esfera de aplicação do método proposto e dos modelos de conhecimento criados com base nele, contempla-se a gestão do ciclo de vida de sistemas de informação, incluindo o desenvolvimento de cenários de uso e testes de software.
Relevância
Durante o projeto, desenvolvimento, implementação e operação de sistemas de informação, é necessário acumular e sistematizar dados, informações e conhecimentos que são coletados externamente ou surgem em cada etapa do ciclo de vida do software. Isso serve como um suporte informático e metodológico necessário para o trabalho de projeto e tomada de decisões, sendo especialmente relevante em situações de alta incerteza e em ambientes pouco estruturados. A base de conhecimento, formada como resultado da acumulação e sistematização desses recursos, deve ser não apenas uma fonte de experiências úteis adquiridas pela equipe de projeto durante a criação do sistema de informação, mas também uma ferramenta o mais simples possível para modelar novas visões, maneiras e algoritmos para a implementação das tarefas do projeto. Em outras palavras, essa base de conhecimento é um repositório de capital intelectual e, ao mesmo tempo, uma ferramenta de gestão do conhecimento [3, 10].
A eficácia, utilidade e qualidade da base de conhecimento como ferramenta correlacionam-se com a demanda de recursos para sua manutenção e a efetividade na extração de conhecimentos. Quanto mais simples e rápido for o processo de coleta e registro dos conhecimentos na base e mais pertinentes forem os resultados das consultas a ela, melhor e mais confiável será a própria ferramenta [1, 2]. Contudo, métodos discretos e meios de estruturação aplicáveis a sistemas de gestão de bases de dados, incluindo a normalização de relações em bancos de dados relacionais, não conseguem descrever ou modelar componentes semânticos, interpretações, conjuntos semânticos intervalares e contínuos [4, 7, 10]. Para isso, é necessário um abordagen metodológica que generalize casos específicos de ontologias finitas e aproxime o modelo de conhecimento à continuidade da descrição do domínio da informação do sistema.
Tal abordagem pode consistir na combinação dos princípios da teoria da matemática fuzzy e do conceito de dimensão fractal [3, 6]. Otimizando a descrição do conhecimento com base no critério de grau de continuidade (tamanho do passo de discretização da descrição) sob a limitação do princípio da incompletude de Gödel (na informação do sistema – a incompletude fundamental dos raciocínios, conhecimentos derivados desse sistema sob a condição de sua não contradição), realizando uma fuzzificação sequencial (trazendo à imprecisão), obtemos uma descrição formalizada que representa um conjunto de conhecimentos de forma maximamente completa e coerente, com a qual se podem realizar quaisquer operações de processos informacionais – coleta, armazenamento, processamento e transmissão [5, 8, 9].
Definição de recursão de um conjunto fuzzy
Seja X – um conjunto de valores de uma característica do sistema modelado:
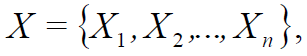 (1)
onde n = [N ≥ 3] – número de valores dessa característica (maior que o conjunto elemental (0; 1) – (falso; verdadeiro)).
Seja X = B, onde B = {a,b,c,…,z} – conjunto de equivalentes, correspondendo elemento a elemento ao conjunto de valores da característica X.
Então o conjunto fuzzy  , que corresponde ao conceito fuzzy (em um sentido geral) que descreve a característica X, pode ser representado na forma:
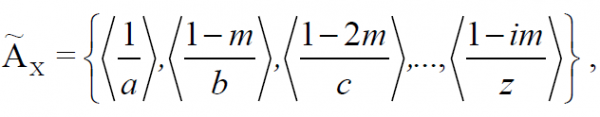 (2)
onde m – passo de discretização da descrição, i pertence a N – multiplicidade do passo.
Assim, para otimizar o modelo de conhecimento sobre o sistema de informação com base no critério de continuidade (suavidade) da descrição, permanecendo dentro das limitações do espaço de incompletude dos raciocínios, introduzimos o grau de recursão do conjunto fuzzy  e obtemos a seguinte variante de sua representação:
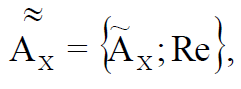 (3)
onde  – conjunto que corresponde ao conceito fuzzy, em termos gerais, descrevendo de forma mais completa a característica X do que o conjunto
 , segundo o critério de suavidade; Re – grau de recursão da descrição.
Deve-se considerar que 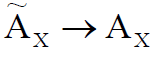 (reduzindo a um conjunto claro) no caso particular, se necessário.
Introdução à dimensionalidade fracionária
Para Re = 1, o conjunto  representa um conjunto nebuloso de 2ª ordem, incluindo como elementos conjuntos nebulosos (ou suas representações claras), que descrevem todos os valores da característica X [1, 2]:
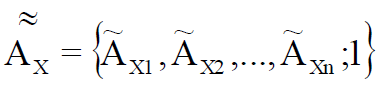 (4)
No entanto, este é um caso degenerado, e na representação mais completa, parte dos elementos  podem ser conjuntos, enquanto os outros são objetos triviais (extremamente simples). Portanto, para definir tal conjunto, é necessário introduzir recursão fracionária – análoga à dimensionalidade fracionária do espaço (neste contexto – espaço de ontologia de uma determinada área temática) [3, 9].
Para Re fracionário, obtemos a seguinte representação  :
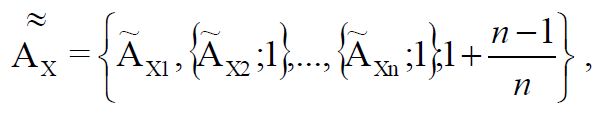 (5)
onde  – conjunto nebuloso para o valor X1,
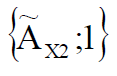 – conjunto nebuloso para o valor X2 e assim por diante.
Nesse caso, a recursão se torna essencialmente fracatal, e os conjuntos de descrições – auto-similares.
Definição do conjunto de funcionalidades do módulo
A arquitetura de um sistema de informação aberto pressupõe o princípio da modularidade, que possibilita escalabilidade, replicação, adaptabilidade e emergência do sistema. A construção modular permite aproximar ao máximo a implementação tecnológica dos processos informacionais à sua manifestação objetiva natural no mundo real, desenvolvendo meios que sejam mais convenientes em suas propriedades funcionais, destinados não a substituir as pessoas, mas a ajudá-las efetivamente na gestão do conhecimento.
O módulo representa uma entidade isolada do sistema de informação, que pode ser obrigatória ou opcional para os fins de existência do sistema, mas, em qualquer caso, fornece um conjunto de funções únicas dentro do sistema.
Toda a diversidade de funcionalidades dos módulos pode ser descrita por três tipos de operações: criação (registro de novos dados), edição (modificação de dados anteriormente registrados), exclusão (apagamento de dados anteriormente registrados).
Seja X uma certa característica dessas funcionalidades, então o conjunto correspondente X pode ser representado como:
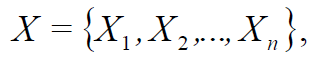 (6)
onde X1 – criação, X2 – edição, X3 – exclusão,
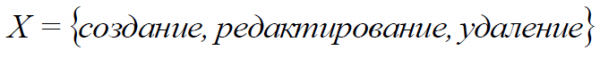 (7)
As funcionalidades de qualquer módulo são tais que a criação de dados não é autorreferencial (implementada sem recursão – a função de criação não se repete), enquanto a edição e a exclusão podem, em geral, prever tanto a implementação por elemento (execução da operação em elementos selecionados de conjuntos de dados) quanto incluir, como parte, operações similares.
É importante notar que, se a operação para a funcionalidade X deste módulo não é executada (não implementada no sistema), o conjunto correspondente a essa operação é considerado vazio.
Assim, para descrever o conceito nebuloso (afirmação) "o módulo permite executar uma operação com o conjunto de dados correspondente para os fins do sistema de informação", o conjunto nebuloso 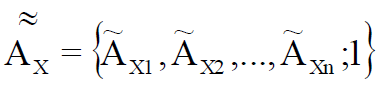 pode ser representado de forma mais simples como:
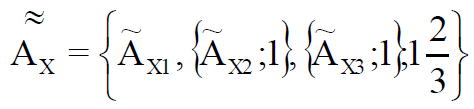 (8)
Esse conjunto, em geral, tem um grau de recursão igual a 1,6(6) e é simultaneamente fratal e nebuloso.
Preparação de cenários de uso e teste do módulo.
Nos estágios de desenvolvimento e exploração do sistema de informação, são necessários cenários especiais que descrevam a ordem e o conteúdo das operações para o uso dos módulos de acordo com sua finalidade funcional (cenários de uso, em inglês, use-case), bem como para verificar a conformidade entre os resultados esperados e reais das operações dos módulos (cenários de teste, em inglês, test-case).
Considerando as representações apresentadas acima, o processo de trabalho nesses cenários pode ser descrito da seguinte maneira.
Para o módulo, é formado um conjunto nebuloso 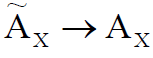 :
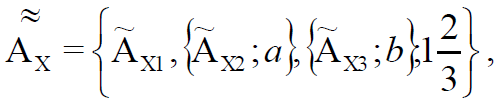 (9)
onde
 – conjunto nebuloso para a operação de criação de dados pela funcionalidade X;
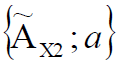 – conjunto nebuloso para a operação de edição de dados pela funcionalidade X, onde o grau de recursão a (encadeamento da função) é um número natural e, no caso trivial, é igual a 1;
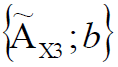 – conjunto nebuloso para a operação de exclusão de dados pela funcionalidade X, onde o grau de recursão b (encadeamento da função) é um número natural e, no caso trivial, é igual a 1.
Esse conjunto descreve o que exatamente (quais objetos de dados) são criados, editados e/ou excluídos em qualquer variante de uso do módulo.
Em seguida, é elaborado um conjunto de cenários de uso Ux para a funcionalidade X do módulo em questão, em cada um dos quais é descrito, para que (para qual tarefa de negócios) objetos de dados são criados, editados e/ou excluídos, descritos por um conjunto de  , e em que ordem:
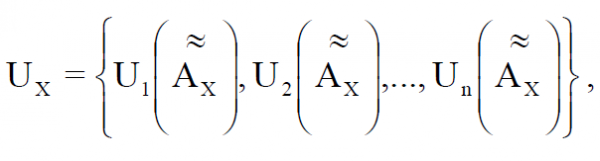 (10)
onde n é o número de cenários de uso para X.
Em seguida, consiste em um conjunto de cenários de teste Tx para a funcionalidade X de cada cenário de uso do módulo em questão. O cenário de teste descreve, quais valores de dados e em que ordem são usados ao executar o cenário de uso, assim como qual resultado deve ser obtido:
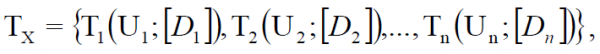 (11)
onde [D] é um array de dados de teste, n é o número de cenários de teste para X.
Na abordagem descrita, o número de cenários de teste é igual ao número correspondente de cenários de uso, o que facilita o trabalho de descrição e atualização conforme o sistema evolui. Além disso, tal algoritmo pode ser utilizado para automatizar o teste de módulos de sistema de informação.
Conclusão
O método apresentado de indução difusa pode ser implementado em diferentes estágios do ciclo de vida de qualquer sistema modular de informação tanto para acumular a parte descritiva da base de conhecimentos quanto para trabalhar em cenários de uso e teste de módulos.
Além disso, a indução difusa ajuda a sintetizar conhecimentos com base nas descrições difusas obtidas, semelhante a um 'caleidoscópio cognitivo', onde parte dos elementos permanece clara e inequívoca, enquanto outros, por regra de auto-similaridade, são aplicados o número de vezes indicado na profundidade de recursão para cada conjunto de dados conhecidos. No conjunto, os conjuntos difusos obtidos formam um modelo que pode ser utilizado tanto para os objetivos do sistema de informação quanto para a busca de novos conhecimentos em geral.
Esse tipo de metodologia pode ser considerado uma forma peculiar de 'inteligência artificial', tendo em vista que os conjuntos sintetizados não devem contradizer o princípio da incompletude do raciocínio e são destinados a auxiliar a inteligência humana, e não a substituí-la.
Lista de referências
- Borísov V.V., Fedulov A.S., Zernov M.M., "Fundamentos da Teoria dos Conjuntos Fuzzy". Moscovo: Linha Quente – Telecom, 2014. – 88 p.
- Borísov V.V., Fedulov A.S., Zernov M.M., "Fundamentos da Teoria da Inferência Lógica Fuzzy". Moscovo: Linha Quente – Telecom, 2014. – 122 p.
- Demenok S.L., "Fractal: Entre Mito e Artesanato". São Petersburgo: Academia de Estudos Culturais, 2011. – 296 p.
- Zade L., "Fundamentos de uma Nova Abordagem à Análise de Sistemas Complexos e Processos de Tomada de Decisão" / "Matemática Hoje". Moscovo: "Conhecimento", 1974. – P. 5 – 49.
- Krants S., "A Natureza Mutável da Demonstração Matemática". Moscovo: Laboratório de Conhecimento, 2016. – 320 p.
- Mavrikidi F.I., "Matemática Fractal e a Natureza das Mudanças" / "Delfis", n.º 54 (2/2008), .
- Mandelbrot B., "Geometria Fractal da Natureza". Moscovo: Instituto de Pesquisa Computacional, 2002. – 656 p.
- "Fundamentos da Teoria dos Conjuntos Fuzzy: Diretrizes Metodológicas", compilado por Korobova I.L., Dyakov I.A. Tambov: Editora da Universidade Estadual Técnica de Tambov, 2003. – 24 p.
- Uspenskiy V.A., "Apologia da Matemática". Moscovo: Alpina Non-Fiction, 2017. – 622 p.
- Zimmerman H. J. "Teoria dos Conjuntos Fuzzy – e suas Aplicações", 4ª edição. Springer Science + Business Media, Nova Iorque, 2001. – 514 p.
Fonte: habr.com
