

Para ser sincero, Ivan frequentemente ria dos esforços fúteis dos colegas do departamento de monitoramento. Eles se esforçavam imensamente para implementar as métricas que a alta administração solicitava. Estavam tão ocupados que mais ninguém queria fazer nada.
E a administração nunca estava satisfeita - estava constantemente pedindo novas e novas métricas, rapidamente deixando de usar as que já haviam sido feitas.
Ultimamente, todos só falavam sobre Lead Time - o tempo de entrega das funcionalidades de negócios. A métrica mostrou um número insano - 200 dias para entregar uma tarefa. Como todos se impressionaram, exclamando e levantando as mãos ao céu!
Depois de um tempo, o barulho gradualmente diminuiu e a administração pediu a criação de mais uma métrica.
Ivan tinha plena certeza de que a nova métrica também morreria silenciosamente em um canto escuro.
De fato, pensou Ivan, saber o número não diz nada a ninguém. 200 dias ou 2 dias - não há diferença, porque com o número não é possível determinar a causa e entender se isso é bom ou ruim.
Esta é a armadilha típica das métricas: parece que a nova métrica revelará a essência da existência e explicará algum segredo oculto. Todos esperam por isso, mas nada acontece. Justamente porque o segredo não deve ser procurado nas métricas!
Para Ivan, isso era um estágio já superado. Ele entendia que para medições, e todos os segredos devem ser buscados em , ou seja, no que forma essa métrica.
Para uma loja online, o objeto de influência serão seus clientes, que trazem dinheiro, enquanto para o DevOps – as equipes que criam e implantam distribuições usando o pipeline.
Certa vez, acomodando-se no saguão em uma poltrona confortável, Ivan decidiu pensar cuidadosamente sobre como gostaria de ver as métricas do DevOps, considerando que o objeto de influência são as equipes.
Objetivo das métricas do DevOps
É claro que todos desejam reduzir o tempo de entrega. 200 dias - isso simplesmente não é aceitável.
Mas como, essa é a questão?
Na empresa, centenas de equipes trabalham, e milhares de distribuições passam diariamente pelo pipeline do DevOps. O tempo real de entrega se apresentará como uma distribuição. Cada equipe terá seu próprio tempo e características próprias. Como encontrar algo entre essa bagunça?
A resposta surgiu por si só – é necessário identificar as equipes problemáticas e entender o que está acontecendo com elas e por que demoram tanto, enquanto se aprende com as equipes "boas" como fazer tudo rapidamente. Para isso, é preciso medir o tempo que as equipes passaram em cada um dos ambientes DevOps:
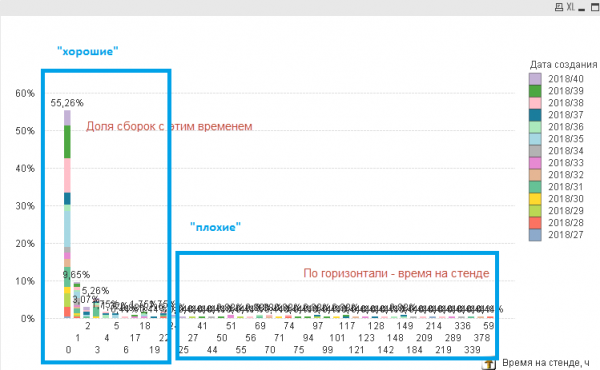
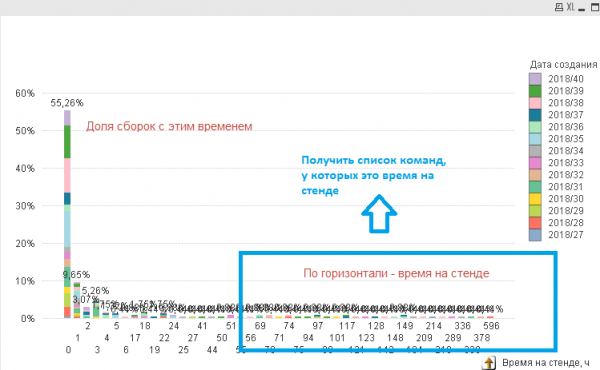
O objetivo do sistema será a seleção de equipes com base no tempo de passagem pelos ambientes, ou seja, no final devemos obter uma lista de equipes com tempos selecionados, e não apenas números.
Se soubermos quanto tempo foi gasto no total em cada ambiente e quanto tempo foi gasto em paralisações entre os ambientes, poderemos contatar as equipes, investigar mais detalhadamente as causas e resolvê-las", pensou Ivan.
Como calcular o tempo de entrega para DevOps
Para fazer a contagem, era necessário se aprofundar no processo DevOps e suas entidades.
Na empresa, é utilizado um número limitado de sistemas, e as informações podem ser obtidas apenas a partir deles, e de mais nenhum outro lugar.
Todas as tarefas na empresa eram registradas no Jira. Quando uma tarefa era iniciada, um branch era criado, e após a implementação, era feito um commit no BitBucket e um Pull Request. Ao aceitar o PR (Pull Request), um pacote era automaticamente criado e salvo no repositório Nexus.

Em seguida, o pacote era implantado em vários ambientes com o uso do Jenkins para verificar a correção do deploy, testes automáticos e manuais:
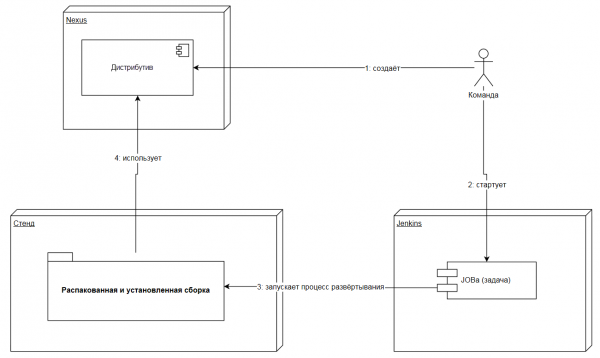
Ivan detalhou quais informações poderiam ser extraídas de quais sistemas para calcular o tempo nos ambientes:
- Do Nexus – Tempo de criação do pacote e nome da pasta que continha o código da equipe.
- Do Jenkins – Hora de início, duração e resultado da execução de cada job, nome do ambiente (nos parâmetros da job), estágios (passos da job), link para o pacote no Nexus.
- Ivan decidiu não incluir o Jira e o BitBucket no pipeline, pois eles estavam mais relacionados à fase de desenvolvimento, e não à implantação do pacote final nos ambientes.
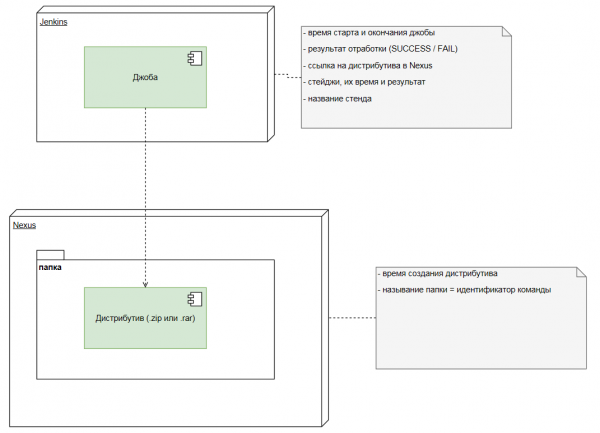
Com base nas informações disponíveis, um esquema foi elaborado:
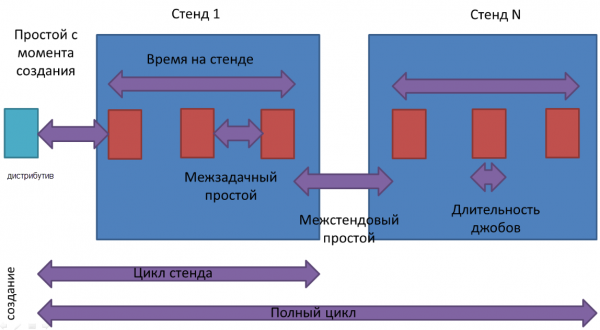
Sabendo quanto tempo é necessário para criar pacotes e quanto tempo é gasto em cada um deles, é possível calcular facilmente os custos totais para a passagem de todo o pipeline DevOps (ciclo completo).
Aqui estão as métricas de DevOps que Ivan obteve no final:
- Número de pacotes criados
- Percentual de pacotes que "entraram" no ambiente e "passaram" pelo ambiente
- Tempo gasto no ambiente (ciclo do ambiente)
- Ciclo completo (tempo total em todas as estações)
- Duração das jobs
- Inatividade entre as estações
- Inatividade entre os lançamentos de jobs na mesma estação
Por um lado, as métricas caracterizavam muito bem o pipeline DevOps em termos de tempo, por outro, eram consideradas muito simples.
Satisfeito com o trabalho bem feito, Ivan preparou uma apresentação e foi apresentá-la à gerência.
Ele voltou com uma expressão carrancuda e os ombros caídos.
— É um fiasco, meu irmão — sorriu o colega irônico...
Leia a continuação no artigo "».
Fonte: habr.com
