

Com a base de dados Apache Cassandra e a necessidade de operá-la em uma infraestrutura baseada em Kubernetes, nos deparamos com essa situação regularmente. Neste material, compartilharemos nossa visão sobre os passos necessários, critérios e soluções existentes (incluindo uma visão geral dos operadores) para migrar o Cassandra para K8s.
«Quem pode gerenciar uma mulher, também lidará com um estado»
Quem é Cassandra? É um sistema de armazenamento distribuído projetado para gerenciar grandes volumes de dados, garantindo alta disponibilidade sem um único ponto de falha. O projeto provavelmente não precisa de uma apresentação longa, então vou listar apenas as principais características do Cassandra que serão relevantes para o tema específico deste artigo:
- Cassandra é escrito em Java.
- A topologia do Cassandra inclui vários níveis:
- Node — uma instância do Cassandra implantada;
- Rack — um grupo de instâncias do Cassandra relacionadas por algum critério, localizado em um único data center;
- Datacenter — a soma de todos os grupos de instâncias do Cassandra localizados em um único data center;
- Cluster — a soma de todos os data centers.
- Para identificar um nó, o Cassandra usa o endereço IP.
- Para acelerar as operações de gravação e leitura, parte dos dados do Cassandra é armazenada na memória RAM.
Agora — sobre a potencial migração para Kubernetes.
Checklist para a transferência
Ao falar sobre a migração do Cassandra para Kubernetes, esperamos que a administração se torne mais conveniente com a transição. O que será necessário para isso, o que ajudará?
1. Armazenamento para dados
Como já mencionado, parte dos dados do Cassandra é armazenada na memória — em Memtable. Mas há outra parte dos dados que é salva em disco — na forma de SSTable. A esses dados se adiciona a entidade Commit Log — registros de todas as transações, que também são salvos em disco.
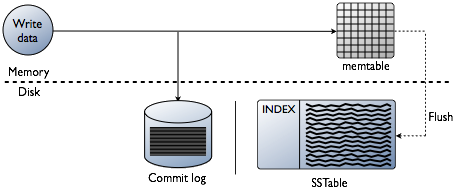
Esquema de transações de gravação no Cassandra
No Kubernetes, podemos usar o PersistentVolume para armazenar dados. Graças aos mecanismos consolidados, trabalhar com dados no Kubernetes se torna mais fácil a cada ano.
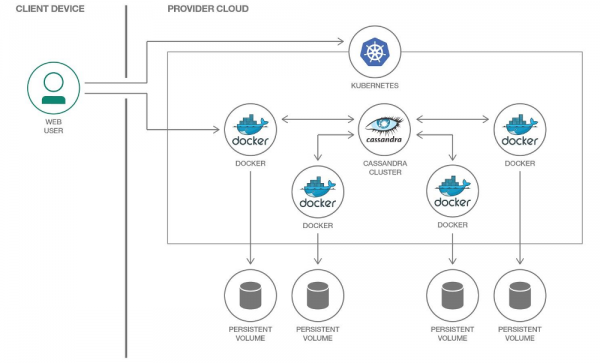
A cada pod com Cassandra, destinaremos seu próprio PersistentVolume.
É importante notar que o Cassandra em si implica em replicação de dados, oferecendo para isso mecanismos integrados. Portanto, se você está formando um cluster Cassandra a partir de um grande número de nós, não há necessidade de usar sistemas distribuídos como Ceph ou GlusterFS para armazenar dados. Nesse caso, é lógico armazenar os dados no disco do nó usando ou montagem hostPath.
Outra questão é se você deseja criar um ambiente separado para cada branch de recurso para desenvolvedores. Nesse caso, a abordagem correta seria levantar um nó Cassandra, enquanto os dados são armazenados em um armazenamento distribuído, ou seja, os mencionados Ceph e GlusterFS se tornam sua opção. Assim, o desenvolvedor terá a certeza de que não perderá dados de teste, mesmo com a perda de um dos nós do cluster Kubernetes.
2. Monitoramento
Praticamente a única escolha para implementar monitoramento no Kubernetes é o Prometheus (falamos sobre isso em detalhes na ). Como está o Cassandra em relação aos exporters de métricas para Prometheus? E, o que é ainda mais importante, com os dashboards adequados para Grafana?
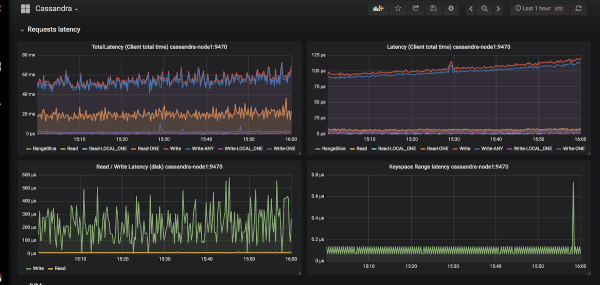
Exemplo da aparência de gráficos no Grafana para Cassandra
Existem apenas dois exporters: e .
Nós escolhemos o primeiro, porque:
- O JMX Exporter está crescendo e se desenvolvendo, enquanto o Cassandra Exporter não conseguiu obter o devido suporte da comunidade. O Cassandra Exporter ainda não suporta a maioria das versões do Cassandra.
- Pode-se executá-lo como um javaagent adicionando a flag
-javaagent:\/cassandra-exporter.jar=--listen=:9180. - Para ele existe um , que é incompatível com o Cassandra Exporter.
3. Escolha de primitivas do Kubernetes
De acordo com a estrutura acima do cluster Cassandra, vamos tentar traduzir tudo o que está descrito em terminologia do Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → pool de StatefulSets
- Cassandra Cluster → ???
Parece que falta alguma entidade adicional para gerenciar todo o cluster Cassandra de uma vez. Mas se algo não existe, podemos criá-lo! No Kubernetes, existe um mecanismo destinado a isso — .
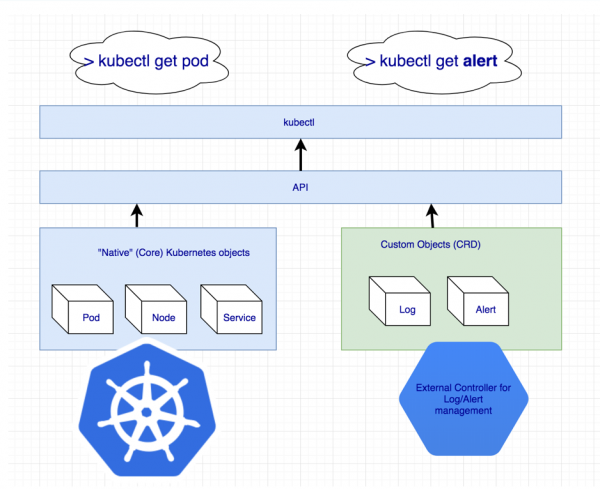
Declaração de recursos adicionais para logs e notificações
Mas um Custom Resource por si só não significa nada: para isso é necessário um controlador. Pode ser necessário recorrer ao …
4. Identificação dos pods
No ponto acima, concordamos que um nó Cassandra corresponderá a um pod no Kubernetes. Mas os endereços IP dos pods serão diferentes a cada vez. E a identificação do nó no Cassandra ocorre precisamente com base no endereço IP... Assim, depois de cada exclusão de pod, o cluster Cassandra adicionará um novo nó.
Há uma saída, e não uma só:
- Podemos acompanhar por identificadores de host (UUIDs, que identificam exclusivamente as instâncias Cassandra) ou por endereços IP e armazenar tudo isso em algumas estruturas/tabelas. O método tem duas desvantagens principais:
- Risco de condição de corrida ao falhar imediatamente com dois nós. Após a recuperação, os nós Cassandra solicitarão ao mesmo tempo um endereço IP da tabela e competirão por um mesmo recurso.
- Se um nó Cassandra perder seus dados, não poderemos mais identificá-lo.
- A segunda solução parece um pequeno truque, mas mesmo assim: podemos criar um Service com ClusterIP para cada nó Cassandra. Os problemas dessa implementação:
- Se o cluster Cassandra tiver muitos nós, teremos que criar muitos Services.
- A funcionalidade ClusterIP é implementada através do iptables. Isso pode se tornar um problema se o cluster Cassandra tiver muitos (1000... ou até mesmo 100?) nós. Embora seja capaz de resolver esse problema.
- A terceira solução é usar a rede de nós para os nós Cassandra em vez de uma rede dedicada de pods ativando a configuração
hostNetwork: true. Esse método impõe algumas limitações:- Na substituição de nós. É necessário que o novo nó tenha obrigatoriamente o mesmo endereço IP que o anterior (em nuvens como AWS, GCP isso é praticamente impossível);
- Usando a rede de nós do cluster, começamos a competir por recursos de rede. Portanto, colocar mais de um pod com Cassandra em um nó do cluster será problemático.
5. Backups
Queremos manter uma versão completa dos dados de um nó Cassandra em um cronograma. Kubernetes fornece uma opção conveniente usando , mas aqui o próprio Cassandra nos coloca obstáculos.
Lembro que parte dos dados do Cassandra é armazenada na memória. Para fazer um backup completo, os dados da memória (Memtables) precisam ser transferidos para o disco (SSTables). Nesse momento, o nó Cassandra para de aceitar conexões, excluindo-se totalmente do trabalho do cluster.
Após isso, o backup é feito (snapshot) e o esquema é salvo (keyspace). E aqui fica claro que apenas um backup não é suficiente: precisamos preservar os identificadores dos dados pelos quais o nó Cassandra é responsável - são tokens especiais.
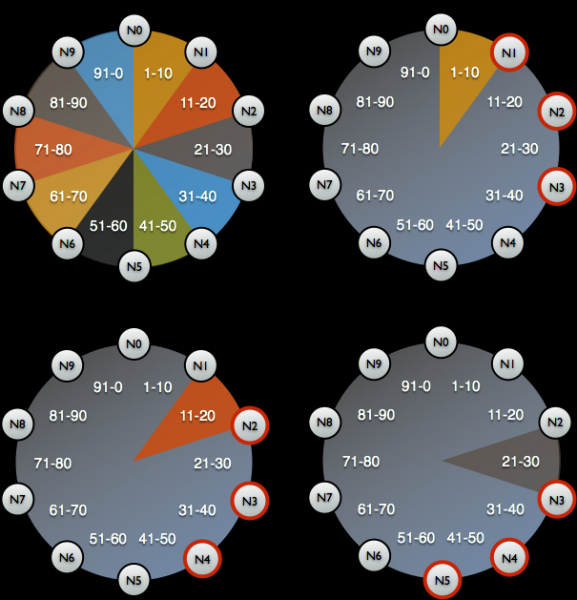
Distribuição de tokens para identificar quais dados os nós Cassandra gerenciam
Um exemplo de script para realizar backup do Cassandra do Google no Kubernetes pode ser encontrado em . A única questão que o script não considera é o reset de dados no nó antes da realização do snapshot. Ou seja, o backup não é feito para o estado atual, mas para um estado um pouco anterior. Mas isso ajuda a não tirar o nó de operação, o que parece muito lógico.
set -eu

if [[ -z "$1" ]]; then
  info "Por favor, forneça um keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Erro ao fazer o snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk '"/Diretório de Snapshot: /" { print $3 }')

mkdir -p "/tmp/backup"

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir "/tmp/backup/$table"
  mv $path "/tmp/backup/$table"
done


tar -zcf "/tmp/backup.tar.gz" -C "/tmp/backup" .

nodetool clearsnapshot "${KEYSPACE}"
Exemplo de script bash para realizar backup de um nó Cassandra
Soluções prontas para Cassandra no Kubernetes
O que estão usando atualmente para implementar Cassandra no Kubernetes e qual delas se encaixa melhor nos requisitos especificados?
1. Soluções baseadas em StatefulSet ou Helm charts
Usar as funções básicas dos StatefulSets para iniciar um cluster Cassandra é uma boa opção. Com um Helm chart e templates Go, é possível oferecer ao usuário uma interface flexível para implementar Cassandra.
Normalmente funciona bem... até que algo inesperado aconteça - como a falha de um nó. As ferramentas padrão do Kubernetes simplesmente não conseguem considerar todas as características mencionadas acima. Além disso, essa abordagem é muito limitada em termos de como pode ser expandida para usos mais complexos: substituição de nós, backup, recuperação, monitoramento, etc.
Representantes:
- ;
- .
Ambos os charts são igualmente bons, mas ambos estão sujeitos aos problemas descritos acima.
2. Soluções baseadas em Kubernetes Operator
Essas opções são mais interessantes, pois oferecem amplas possibilidades de gerenciamento de cluster. Para projetar um operador Cassandra, como qualquer outro banco de dados, um bom padrão é parecido com Sidecar Controller CRD:
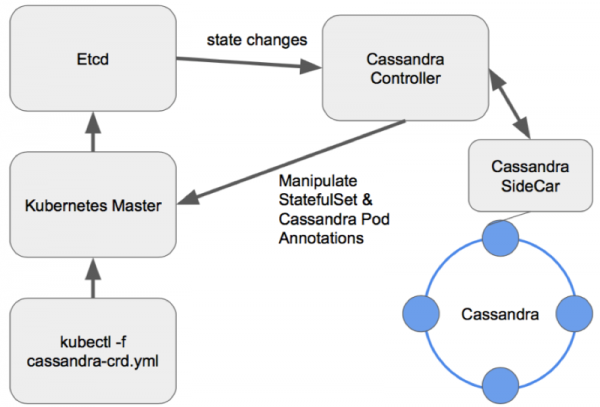
Esquema de gerenciamento de nós em um operador Cassandra bem projetado
Vamos considerar os operadores existentes.
1. Cassandra-operator da instaclustr
- Pronto: Alpha
- Licença: Apache 2.0
- Implementado em: Java
Este é realmente um projeto promissor e em rápido desenvolvimento da empresa que oferece implantações gerenciadas do Cassandra. Ele utiliza, como descrito acima, um contêiner sidecar que aceita comandos via HTTP. Escrito em Java, por isso, às vezes falta-lhe funcionalidades mais avançadas da biblioteca client-go. Além disso, o operador não suporta diferentes Racks para um único Datacenter.
Por outro lado, o operador tem vantagens, como suporte para monitoramento, gerenciamento de clusters em alto nível através de CRD e até documentação sobre backups.
2. Navigator da Jetstack
- Pronto: Alpha
- Licença: Apache 2.0
- Implementado em: Golang
Este operador foi projetado para implantar DB-as-a-Service. No momento, suporta duas bases de dados: Elasticsearch e Cassandra. Inclui soluções interessantes, como controle de acesso ao banco de dados via RBAC (para isso, um servidor api separado é iniciado). Um projeto interessante que merece atenção, no entanto, o último commit foi feito há um ano e meio, o que claramente diminui seu potencial.
3. Cassandra-operator do vgkowski
- Pronto: Alpha
- Licença: Apache 2.0
- Implementado em: Golang
Não o consideramos seriamente, pois o último commit no repositório foi há mais de um ano. O desenvolvimento do operador foi abandonado: a última versão do Kubernetes declarada como suportada é a 1.9.
4. Cassandra-operator do Rook
- Pronto: Alpha
- Licença: Apache 2.0
- Implementado em: Golang
Este operador está se desenvolvendo mais lentamente do que gostaríamos. Tem uma estrutura CRD bem pensada para gerenciar clusters e resolve o problema de identificação de nós usando um Service com ClusterIP (o famoso 'hack')... mas, por enquanto, é só isso. Não há monitoramento e backups disponíveis por padrão no momento (a propósito, quanto ao monitoramento, nós ). Um ponto interessante é que, através deste operador, também é possível implantar ScyllaDB.
NB: Este operador, com algumas pequenas modificações, foi utilizado em um de nossos projetos. Não foram notados problemas no funcionamento do operador durante todo o tempo de uso (~4 meses de operação).
5. CassKop da Orange
- Pronto: Alpha
- Licença: Apache 2.0
- Implementado em: Golang
O operador mais jovem da lista: o primeiro commit foi feito em 23 de maio de 2019. Já possui um grande número de recursos da nossa lista, que podem ser acessados com mais detalhes no repositório do projeto. O operador é baseado no popular operator-sdk. Suporta monitoramento 'out-of-the-box'. A principal diferença em relação aos outros operadores é o uso , desenvolvido em Python e utilizado para comunicação entre nós Cassandra.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
A quantidade de abordagens e possíveis opções para migração do Cassandra para Kubernetes fala por si só: o tema é demandado.
Neste estágio, experimentar algo do que foi descrito acima pode ser feito por conta e risco: nenhum dos desenvolvedores garante o funcionamento 100% de sua solução em ambiente de produção. Mas já agora, muitos produtos parecem promissores para serem testados em ambientes de desenvolvimento.
Acho que, no futuro, essa mulher no navio será útil!
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
