

Mikhail Salosin (a seguir – MS): – Olá a todos! Meu nome é Mikhail. Sou desenvolvedor backend na empresa MC2 Software e vou falar sobre o uso de Go no backend do aplicativo móvel “Смотри+”.
Alguém aqui gosta de hóquei?
Então este aplicativo é para você. Ele está disponível para Android e iOS e serve para assistir transmissões de diversos eventos esportivos ao vivo e gravados. Também oferece diversas estatísticas, transmissões textuais, tabelas de conferências, torneios e outras informações úteis para os fãs.
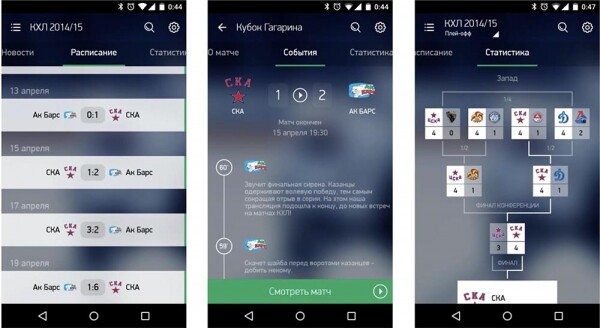
Além disso, o aplicativo possui um recurso chamado momentos de vídeo, ou seja, você pode assistir os melhores momentos das partidas (gols, brigas, pênaltis, etc.). Se você não quer assistir toda a transmissão, pode ver apenas o que há de mais interessante.
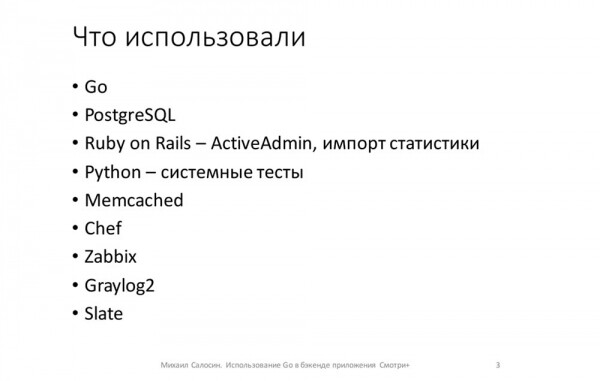
O que foi utilizado no desenvolvimento?
A maior parte foi escrita em Go. A API com a qual os clientes móveis se comunicavam foi desenvolvida em Go. Também foi escrito em Go o serviço para envio de notificações push para dispositivos móveis. Além disso, tivemos que criar nosso próprio ORM, sobre o qual talvez falemos algum dia. Alguns pequenos serviços também foram implementados em Go: redimensionamento e upload de imagens para a parte dos editores...
Como banco de dados, utilizamos PostgreSQL. A interface para editores foi desenvolvida em Ruby on Rails com a gem ActiveAdmin. A importação de estatísticas do fornecedor de dados também foi feita em Ruby.
Para testes sistêmicos da API, utilizamos unittest em Python. Memcached é utilizado para limitar as chamadas da API de pagamento, Chef para controle de configuração, Zabbix para coleta e monitoramento de dados estatísticos internos do sistema. Graylog2 é usado para coleta de logs, e Slate é a documentação da API para os clientes.
Escolha do protocolo
O primeiro problema que enfrentamos: precisávamos escolher um protocolo de interação entre o backend e os clientes móveis, com base nos seguintes pontos...
- A exigência mais importante: os dados nos clientes devem ser atualizados em tempo real. Ou seja, todos que estão assistindo a transmissão no momento devem receber atualizações quase instantaneamente.
- Para simplificar, assumimos que os dados que são sincronizados com os clientes não são excluídos, mas ocultados por meio de flags especiais.
- Solicitações raras (como estatísticas, composição de equipes, estatísticas de equipes) são obtidas através de solicitações GET normais.
- Além disso, o sistema deveria suportar tranquilamente 100 mil usuários simultaneamente.
Com base nisso, tínhamos duas opções de protocolo:
- Websockets. Mas não precisávamos de canais do cliente para o servidor. Precisávamos apenas enviar atualizações do servidor para o cliente, portanto, o websocket era uma opção excessiva.
- Eventos Enviados pelo Servidor (SSE) eram perfeitos! É simples o suficiente e atende, essencialmente, a tudo que precisamos.
Eventos Enviados pelo Servidor
Algumas palavras sobre como isso funciona...
Ele funciona sobre a conexão http. O cliente envia uma solicitação, e o servidor responde com Content-Type: text/event-stream e não fecha a conexão com o cliente, mas continua enviando dados pela conexão:
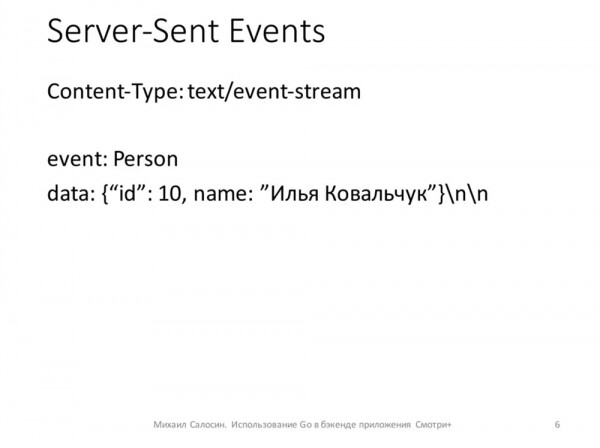
Os dados podem ser enviados em um formato acordado com os clientes. No nosso caso, enviamos da seguinte forma: no campo event, era enviado o nome da estrutura alterada (pessoa, jogador), e no campo data – JSON com os novos campos alterados para o jogador.
Agora sobre como a interação funciona.
- Primeiro, o cliente determina quando foi a última vez que a sincronização com o serviço ocorreu: ele verifica seu banco de dados local e determina a data da última alteração registrada.
- Ele envia uma solicitação com essa data.
- Em resposta, enviamos todas as atualizações que ocorreram desde essa data.
- Depois disso, ele estabelece a conexão com o canal ao vivo e não a fecha enquanto precisar dessas atualizações:
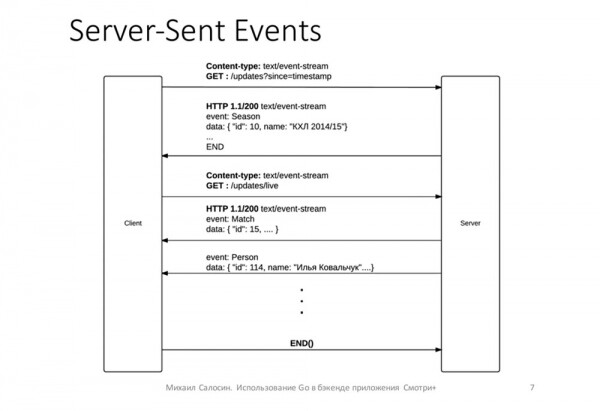
Enviamos a ele uma lista de alterações: se alguém marcou um gol – alteramos a pontuação do jogo; se alguém se machucou – também é enviado em tempo real. Assim, na linha do tempo do evento do jogo, os clientes recebem instantaneamente dados atualizados. Periodicamente, para que o cliente possa entender que o servidor não está offline, que nada aconteceu com ele, enviamos um timestamp a cada 15 segundos – para que soubesse que está tudo bem e que não precisa se reconectar.
Como a conexão ao vivo é mantida?
- Primeiro de tudo, criamos um canal onde as atualizações chegarão com um buffer.
- Em seguida, assinamos este canal para receber atualizações.
- Definimos o cabeçalho correto para que o cliente saiba que está tudo ok.
- Enviamos o primeiro ping. Apenas registramos o timestamp atual da conexão.
- Após isso, lemos do canal em um loop até que o canal de atualizações seja fechado. O canal recebe periodicamente um timestamp atual ou alterações que já registramos nas conexões abertas.
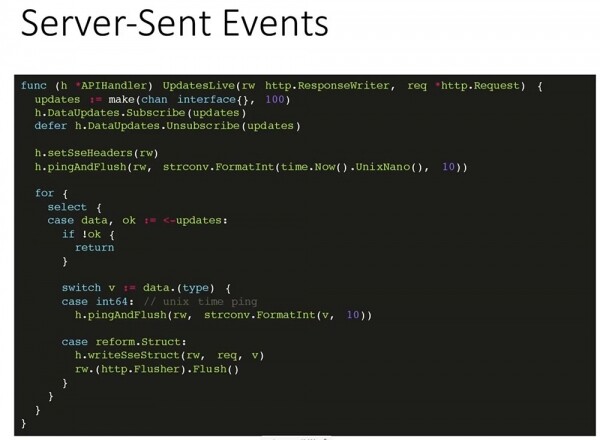
O primeiro problema que enfrentamos foi o seguinte: para cada conexão aberta com o cliente, criamos um timer que disparava a cada 15 segundos – ou seja, se tivéssemos 6 mil conexões abertas com uma máquina (com um único servidor de API), seriam criados 6 mil timers. Isso fazia com que a máquina não suportasse a carga necessária. O problema não era tão óbvio para nós, mas recebemos um pouco de ajuda e conseguimos solucioná-lo.
No final, agora temos o ping vindo do mesmo canal de onde vem a atualização.
Portanto, existe apenas um timer que dispara a cada 15 segundos.
Aqui estão algumas funções auxiliares – envio de cabeçalho, ping e a própria estrutura. Ou seja, aqui é passado o nome da tabela (pessoa, partida, temporada) e as informações sobre esse registro:

O mecanismo de envio de atualizações
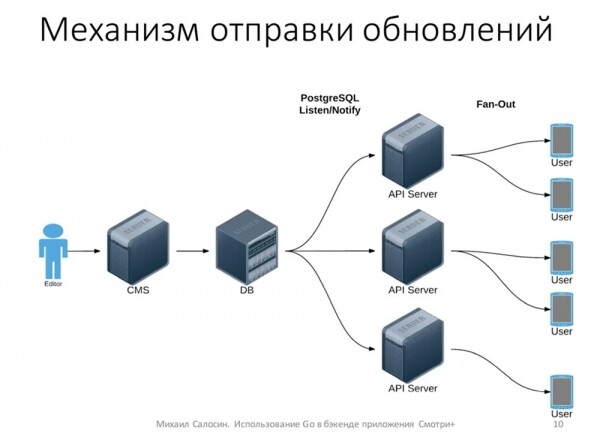
Agora um pouco sobre de onde vêm as mudanças. Temos algumas pessoas, editores, que assistem à transmissão em tempo real. Eles criam todos os eventos: alguém foi expulso, alguém se machucou, alguma substituição…
Com a ajuda do CMS, os dados vão para o banco de dados. Depois disso, o banco, através do mecanismo Listen/Notify, notifica os servidores de API. Os servidores de API, então, distribuem essas informações aos clientes. Assim, temos essencialmente apenas alguns servidores conectados ao banco e nenhuma carga especial no banco, porque o cliente não interage diretamente com o banco:
PostgreSQL: Listen/Notify
O mecanismo Listen/Notify no PostgreSQL permite notificar os assinantes de eventos sobre o que mudou em algum evento – foi criado um registro no banco. Para isso, escrevemos um simples trigger e função:
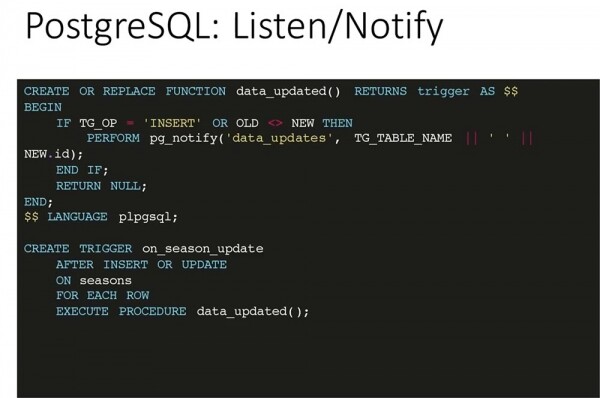
Ao inserir ou alterar um registro, chamamos a função notify no canal data_updates, passando o nome da tabela e o identificador do registro que foi alterado ou inserido.
Para todas as tabelas que devem ser sincronizadas com o cliente, definimos um trigger que, após a modificação/atualização do registro, chama a função indicada no slide abaixo.
Como a API se inscreve nessas mudanças?
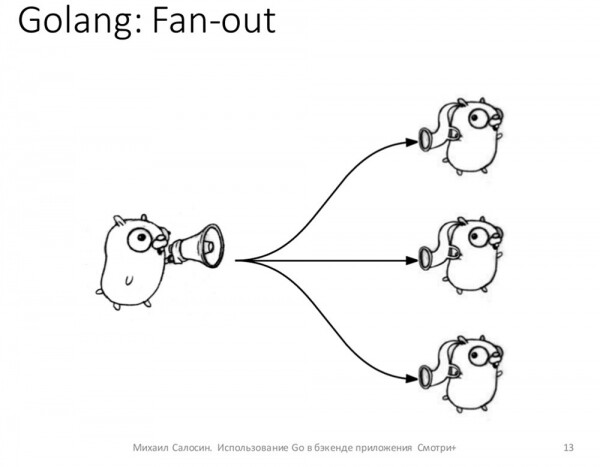
Um mecanismo Fanout é criado – ele dissemina mensagens para os clientes. Ele coleta todos os canais dos clientes e envia as atualizações que recebeu através desses canais:
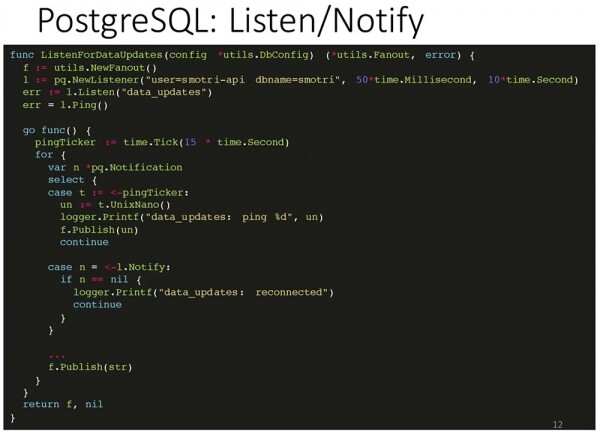
Aqui está a biblioteca padrão pq, que se conecta ao banco de dados e indica que deseja escutar o canal (data_updates), verifica se a conexão está aberta e tudo está bem. Estou pulando a verificação de erros para economizar espaço (não verificar pode ser arriscado).
Em seguida, definimos assíncronamente um Ticker, que enviará pings a cada 15 segundos, e começamos a escutar o canal ao qual nos inscrevemos. Se recebermos um ping, publicamos esse ping. Se recebemos algum registro, publicamos esse registro para todos os assinantes desse Fanout.
Como funciona o Fan-out?
Em português, isso é traduzido como 'distribuidor'. Temos um único objeto que registra os assinantes que desejam receber atualizações. Assim que uma atualização para esse objeto chega, ela é distribuída a todos os assinantes disponíveis. É bastante simples:
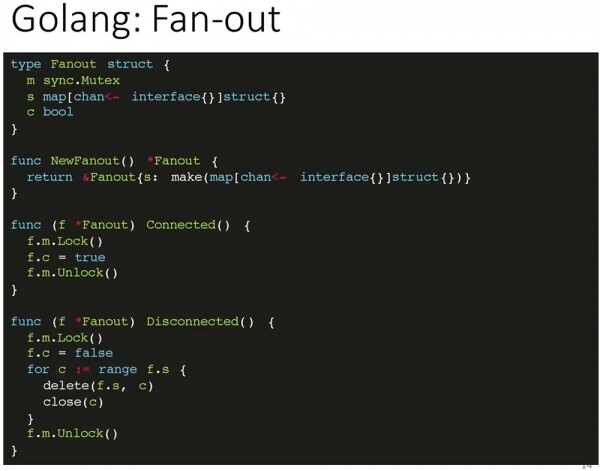
Como isso é implementado em Go:
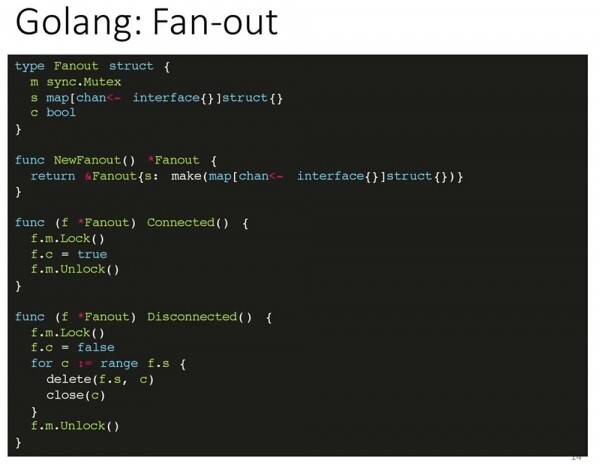
Há uma estrutura que é sincronizada usando Mutexes. Ela possui um campo que salva o estado da conexão Fanout com o banco, ou seja, neste momento ela está escutando e receberá atualizações, além de uma lista de todos os canais disponíveis – um map, onde a chave é o canal e o struct é representado como valores (na verdade, não é utilizado de forma nenhuma).
Dois métodos – Connected e Disconnected – permitem que o Fanout saiba que temos uma conexão com o banco, que ela foi estabelecida e que a conexão com o banco foi interrompida. No segundo caso, todos os clientes precisam ser desconectados e informados de que não podem mais escutar nada e que precisam se reconectar, pois a conexão foi fechada.
Também há um método Subscribe, que adiciona um canal aos 'ouvintes':
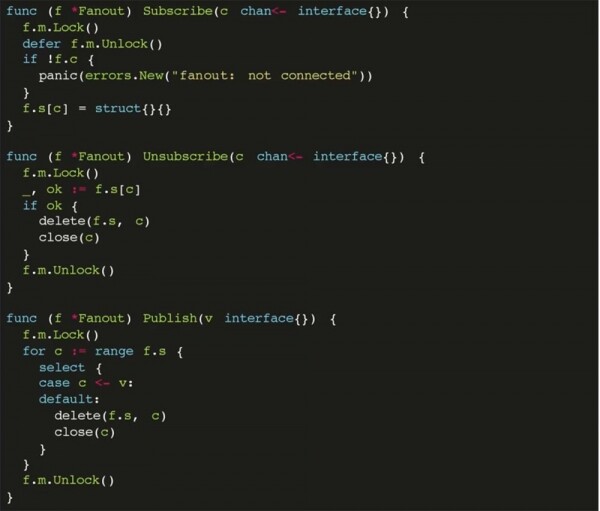
Há um método Unsubscribe, que remove o canal dos ouvintes, caso o cliente tenha se desconectado, além de um método Publish, que permite enviar uma mensagem a todos os assinantes.
Pergunta: – O que está sendo transmitido por este canal?
MC: – É um modelo que foi alterado ou um ping (basicamente apenas um número, inteiro).
MC: – Qualquer coisa pode ser enviada, qualquer estrutura pode ser publicada – ela simplesmente se transforma em JSON e pronto.
MC: Recebemos uma notificação do "Postgres" – que contém o nome da tabela e o identificador. Com o nome da tabela e o identificador, obtemos o registro necessário e enviamos essa estrutura para publicação.
Infraestrutura
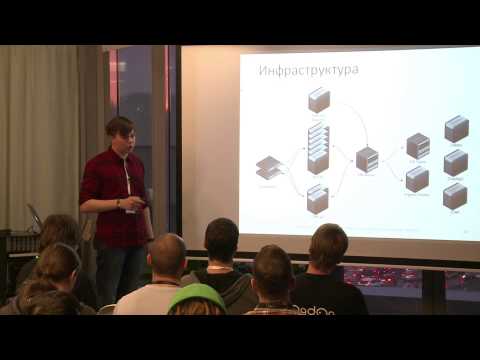
Como isso se apresenta do ponto de vista da infraestrutura? Temos 7 servidores físicos: um deles é totalmente dedicado ao banco de dados, enquanto as outras seis rodam máquinas virtuais. Existem 6 cópias da API: cada máquina virtual com a API roda em um servidor físico separado - isso para garantir a confiabilidade.
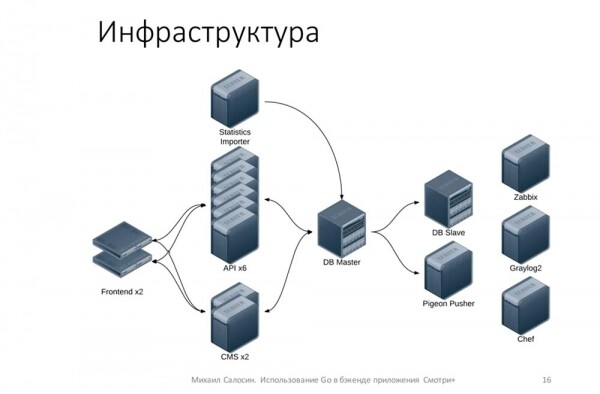
Temos dois front-ends, nos quais o Keepalived está instalado para melhorar a disponibilidade, para que, em caso de necessidade, um front-end possa substituir o outro. Além disso, temos duas cópias do CMS.
Também há um importador de estatísticas. Existe um DB Slave, do qual backups são feitos periodicamente. Existe o Pigeon Pusher - o aplicativo que envia notificações para os clientes, além de ferramentas de infraestrutura: Zabbix, Graylog2 e Chef.
Na verdade, essa infraestrutura é excessiva, pois 100 mil podem ser atendidos com um número menor de servidores. Mas o hardware estava disponível - nós o utilizamos (nos disseram que era possível - por que não).
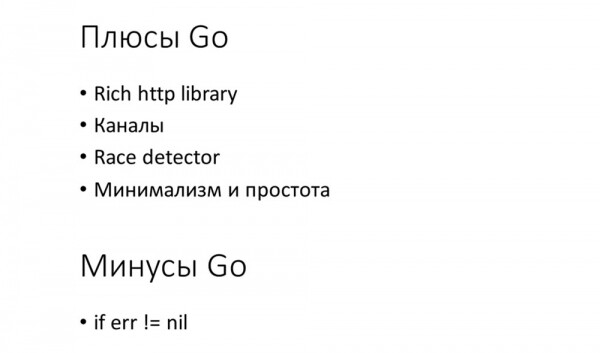
Vantagens do Go
Após trabalharmos neste aplicativo, surgiram algumas vantagens óbvias do Go.
- Uma ótima biblioteca HTTP. Com ela, é possível criar bastante já "pronto para uso".
- Além disso, canais que nos permitiram implementar facilmente um mecanismo de envio de notificações aos clientes.
- A ferramenta Race Detector nos permitiu corrigir vários bugs críticos (infraestrutura de staging). Tudo que roda no staging é iniciado, compilado com a opção Race; e, consequentemente, podemos visualizar na infraestrutura de staging quais problemas potencialmente temos.
- Minimalismo e simplicidade da linguagem.
Estamos procurando desenvolvedores! Se alguém estiver interessado - por favor.
Perguntas
Questão da audiência (daqui em diante – Q): – Eu acho que você passou por um ponto importante relacionado ao Fan-out. Estou correto em entender que, quando você envia uma resposta ao cliente, você fica bloqueado caso o cliente não queira ler?
MC: – Não, nós não bloqueamos. Em primeiro lugar, tudo isso está atrás do nginx, ou seja, não temos problemas com clientes lentos. Em segundo lugar, o cliente tem um canal com buffer – na verdade, podemos armazenar até cem atualizações lá... Se não conseguirmos gravar no canal, ele o deleta. Se vemos que o canal foi bloqueado, simplesmente o fechamos e tudo – o cliente se reconecta, caso ocorra algum problema. Portanto, basicamente, não há bloqueios aqui.
P: – Não seria possível enviar diretamente o registro para Listen/Notify em vez do identificador da tabela?
MC: – O Listen/Notify tem uma limitação de 8 mil bytes no preload que envia. De forma geral, seria possível enviar, se estivéssemos lidando com uma quantidade pequena de dados, mas acho que, da forma que fazemos, é simplesmente mais confiável. As limitações estão no próprio "Postgres".
P: – Os clientes recebem atualizações sobre partidas que não lhes interessam?
MC: – No geral, sim. Normalmente, há 2-3 partidas acontecendo ao mesmo tempo, e isso é bastante raro. Se o cliente está assistindo algo, geralmente é a partida que está rodando. Depois, no cliente há um banco de dados local onde todas essas atualizações são armazenadas, e mesmo sem conexão com a internet, o cliente pode ver todas as partidas passadas, para as quais tem atualizações. Basicamente, sincronizamos nosso banco de dados no servidor com o banco de dados local do cliente, para que ele possa trabalhar também offline.
P: – Por que você criou sua própria ORM?
Alexey (um dos desenvolvedores do "Smotri+"): – Naquele momento (isso foi há um ano), havia menos ORMs do que há agora, quando há muitas. Do grande número de ORMs existentes, o que mais me desagrada é que a maioria delas funciona em interfaces vazias. Ou seja, os métodos dessas ORMs estão prontos para aceitar qualquer coisa: uma estrutura, um ponteiro para a estrutura, um número, algo que não tem nada a ver com o assunto...
Nossa ORM gera estruturas com base no modelo de dados. Sozinha. E, portanto, todos os métodos são específicos, não utilizam reflexão, etc. Eles aceitam estruturas e esperam usar as estruturas que chegam.
P: – Quantas pessoas participaram?
MC: – Na fase inicial, participaram duas pessoas. Começamos em junho, em agosto a maior parte estava pronta (a primeira versão). Em setembro houve o lançamento.
P: – Onde você descreve SSE, você não usa timeout. Por que assim?
MC: – Para ser honesto, o SSE ainda é um protocolo html5: o padrão SSE é destinado à comunicação com navegadores, pelo que entendi. Ele possui recursos adicionais para que os navegadores possam se reconectar (e outras coisas), mas não precisamos disso, pois tínhamos clientes que poderiam implementar qualquer lógica de conexão e obtenção de informações. Fizemos mais algo parecido com SSE do que o próprio protocolo.
Não havia necessidade. Pelo que entendi, os clientes implementaram o mecanismo de conexão praticamente do zero. Para eles, isso não fazia diferença.
P: – Quais utilitários adicionais você utilizou?
MC: – Usamos principalmente o govet e o golint para manter o estilo consistente, além do gofmt. Não usamos mais nada.
P: – Com o que você fez a depuração?
MC: – A depuração, basicamente, foi feita com testes. Não usamos nenhum depurador, nem GOP.
P: – Você pode voltar ao slide onde a função Publish está implementada? Você não se incomoda com os nomes de variáveis com uma letra?
MC: – Não. Elas têm um escopo bem "estreito". Não são usadas em nenhum outro lugar, exceto aqui (além do interior dessa classe), e é uma classe muito compacta – ocupa apenas 7 linhas.
P: – Ainda assim parece pouco intuitivo…
MC: – Não, não, este é um código real! Não é uma questão de estilo. É apenas uma classe utilitária muito pequena – apenas 3 campos dentro da classe…
MC: – No geral, todos os dados que são sincronizados com os clientes (partidas sazonais, jogadores) não mudam. Em termos simples, se formos fazer outro tipo de esporte onde precisássemos alterar a partida, apenas levaremos isso em conta na nova versão do cliente, e as versões antigas do cliente serão banidas.
P: – Existem pacotes de terceiros para gerenciamento de dependências?
MC: – Nós usamos go dep.
P: – No tema da apresentação, havia algo sobre vídeo, mas na apresentação não tem nada sobre vídeo.
MC: – Não, eu não tenho nada sobre vídeo no meu tema. Chama-se "Sмотри+" – é assim que o aplicativo é chamado.
P: – Você mencionou que é transmitido para os clientes?..
MC: – Não trabalhamos com vídeo em streaming. Isso foi completamente feito pela "MegaFon". Sim, eu não mencionei que o aplicativo é da MegaFon.
MC: – Go – para enviar todos os dados – sobre o faturamento, eventos de partidas, estatísticas... O Go é totalmente o backend para o aplicativo. O cliente precisa saber de onde pegar o link a ser usado para o player, para que o usuário possa assistir ao jogo. Temos links para vídeos e streams que foram preparados.
Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
