

Olá, Habr! Apresento a vocês a tradução autoral do artigo .
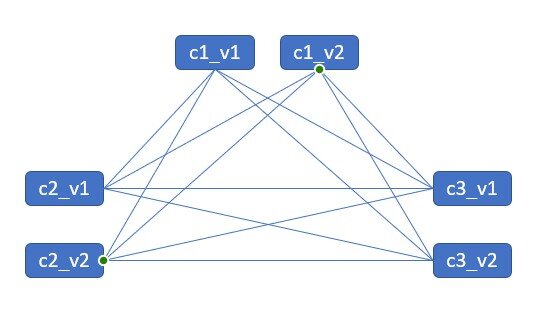
Em tempos em que o mundo de TI está gradualmente migrando para microserviços e ferramentas como Kubernetes, uma única questão se torna cada vez mais evidente. Essa questão é de versões de microserviços. No entanto, a comunidade de TI acredita que a situação atual é significativamente melhor do que da geração anterior de tecnologias. No entanto, a gestão de versões de microserviços é um problema muito complexo. Uma das evidências disso pode ser encontrada em artigos como .
Se você ainda não compreende o problema ao ler este texto, deixe-me explicar. Suponha que seu produto consista em 10 microserviços. Agora suponha que para cada um desses microserviços seja lançada uma nova versão. Apenas uma versão — espero que todos possamos concordar que isso é um fato bastante trivial e insignificante. Agora, no entanto, vamos olhar novamente para o nosso produto. Com apenas uma nova versão para cada componente, agora temos 2^10 — ou 1024 permutações de como podemos compor nosso produto.
Se ainda houver confusão, deixe-me detalhar a matemática. Assim, temos 10 microserviços, cada um recebendo uma atualização. Ou seja, obtemos 2 versões possíveis para cada microserviço (ou a antiga ou a nova). Agora, para cada um dos componentes do produto, podemos usar qualquer uma dessas duas versões. Matematicamente, isso é o mesmo que termos um número binário de 10 dígitos. Por exemplo, digamos que 1 é a nova versão e 0 é a versão antiga — então uma possível permutação pode ser representada como 1001000000 — onde o 1º e o 4º componentes estão atualizados e todos os outros não. Da matemática, sabemos que um número binário de 10 dígitos pode ter 2^10 ou 1024 valores. Ou seja, confirmamos a magnitude do número com o qual estamos lidando.
Vamos continuar a discussão — o que acontecerá se tivermos 100 microserviços e cada um deles com 10 versões possíveis? A situação se torna bastante desagradável — agora temos 10^100 permutações — um número gigantesco. No entanto, prefiro descrever essa situação assim, porque agora não estamos nos escondendo atrás de palavras como 'kubernetes', mas enfrentamos o problema como ele é.
Por que este problema me fascina tanto? Em parte porque, ao trabalhar anteriormente no mundo de NLP e IA, discutimos muito sobre o problema da explosão combinatória há cerca de 5-6 anos. Só que, em vez de versões, tínhamos palavras individuais, e em vez de produtos, tínhamos frases e parágrafos. E embora os problemas de NLP e IA ainda permaneçam em grande parte não resolvidos, é justo reconhecer que, nos últimos anos, houve um progresso considerável. (na minha opinião, o progresso poderia ser maior,maiorse as pessoas da indústria prestassem um pouco menos de atenção ao aprendizado de máquina e um pouco mais a outras técnicas — mas isso já é um tema fora de tópico).
Voltando ao mundo de DevOps e microsserviços. Temos um enorme problema, que se disfarça como um elefante na sala — o que ouço com frequência é: "basta pegar o kubernetes e o helm, e tudo ficará bem!" Mas não, não ficará bem se tudo permanecer como está. Além disso, uma solução analítica para esse problema não é aceitável devido à complexidade. Assim como em NLP, devemos primeiro abordar esse problema reduzindo o escopo da pesquisa — neste caso, eliminando permutações obsoletas.
Uma das coisas que pode ajudar — escrevi no ano passado Também é importante ressaltar que um processo CI/CD bem desenvolvido ajuda muito a reduzir variações. No entanto, a situação atual com CI/CD não é suficientemente boa para resolver o problema das permutações sem ferramentas adicionais de rastreamento e contabilidade de componentes.
O que precisamos é de um sistema de experimentos na fase de integração, onde possamos determinar o fator de risco para cada componente, além de ter um processo automático de atualização de diferentes componentes e testes sem intervenção do operador — para ver o que funciona e o que não funciona.
Esse sistema de experimentos poderia ser estruturado da seguinte forma:
- Os desenvolvedores escrevem testes (esta é uma etapa crítica — porque, caso contrário, não temos um critério de avaliação — é como a rotulagem de dados no aprendizado de máquina).
- Cada componente (projeto) recebe seu próprio sistema CI — esse processo hoje está bem desenvolvido, e a questão de criar um sistema CI para um único componente está, em grande parte, resolvida.
- O sistema de integração inteligente reúne os resultados de vários sistemas CI e compila projetos componentizados em um produto final, executa testes e, por fim, calcula o caminho mais curto para obter a funcionalidade necessária do produto com base nos componentes existentes e nos fatores de risco. Se a atualização não for possível, esse sistema notifica os desenvolvedores sobre os componentes disponíveis e qual deles apresenta erro. Mais uma vez, reitero que o sistema de testes aqui é de importância crítica — pois o sistema de integração usa testes como critério de avaliação.
- Um sistema CD, que então recebe dados da ‘sistema de integração inteligente’ e realiza a atualização propriamente dita. Esta etapa finaliza o ciclo.
Resumindo, para mim, um dos maiores problemas atualmente é a ausência de um ‘sistema de integração inteligente’ que conecte diferentes componentes em um produto e assim permita rastrear como o produto é composto de forma geral. Estou interessado nas opiniões da comunidade sobre isso (spoiler - estou trabalhando em um projeto , que pode se tornar esse sistema de integração inteligente).
Uma última coisa que quero mencionar é que, para mim, um monólito não é aceitável para qualquer projeto de tamanho médio. Sinto um grande ceticismo em relação às tentativas de acelerar o tempo de implementação e a qualidade do desenvolvimento ao retornar ao monólito. Em primeiro lugar, o monólito tem um problema semelhante de gestão de componentes — entre várias bibliotecas das quais é composto, no entanto, tudo isso não é tão perceptível e se manifesta primeiro no tempo que os desenvolvedores gastam. A consequência do problema do monólito é a real impossibilidade de fazer alterações no código — e uma velocidade de desenvolvimento extremamente lenta.
Microserviços melhoram a situação, no entanto, a arquitetura de microserviços enfrenta o problema da explosão combinatória na fase de integração. Sim, de forma geral, deslocamos o mesmo problema — da fase de desenvolvimento para a fase de integração. No entanto, a meu ver, a abordagem de microserviços ainda resulta em melhores resultados e as equipes alcançam resultados mais rapidamente (provavelmente, principalmente devido à redução do tamanho da unidade de desenvolvimento — ou tamanho de lote). No entanto, a transição de monolitos para microsserviços ainda não trouxe uma melhoria suficiente no processo — a explosão combinatória de versões de microsserviços é um grande problema, e temos um grande potencial para melhorar a situação à medida que a resolvemos.
Fonte: habr.com
