

Em 2018, nos círculos profissionais e em conferências temáticas dedicadas à IA, surgiu o conceito de MLOps, que rapidamente se consolidou na indústria e agora se desenvolve como uma área independente. No futuro, o MLOps pode se tornar uma das áreas mais valorizadas em TI. O que exatamente é isso e para que serve, analisamos a seguir.
O que é MLOps
MLOps (a união de tecnologias e processos de aprendizado de máquina e abordagens para integração de modelos desenvolvidos em processos de negócios) é uma nova forma de colaboração entre representantes de negócios, cientistas, matemáticos, especialistas em aprendizado de máquina e engenheiros de TI na criação de sistemas de inteligência artificial.
Em outras palavras, é uma maneira de transformar métodos e tecnologias de aprendizado de máquina em uma ferramenta útil para resolver problemas de negócios.
É importante entender que a cadeia de produtização começa muito antes do desenvolvimento do modelo. O primeiro passo é definir a tarefa de negócios, as hipóteses sobre o valor que pode ser extraído dos dados e a ideia de negócios sobre sua aplicação.
O conceito de MLOps surgiu como uma analogia ao conceito de DevOps aplicado a modelos e tecnologias de aprendizado de máquina. DevOps é uma abordagem para o desenvolvimento de software que permite aumentar a velocidade de implementação de alterações individuais, mantendo flexibilidade e confiabilidade por meio de várias práticas, entre as quais estão o desenvolvimento contínuo, a divisão de funções em microserviços independentes, testes automatizados e implementação de alterações individuais, monitoramento global de desempenho, sistemas de resposta rápida a falhas identificadas, entre outros.
O DevOps definiu o ciclo de vida do software e na comunidade de especialistas surgiu a ideia de aplicar a mesma metodologia aos grandes dados. DataOps é uma tentativa de adaptar e expandir a metodologia levando em conta as peculiaridades de armazenamento, transmissão e processamento de grandes volumes de dados em plataformas variadas e interconectadas.
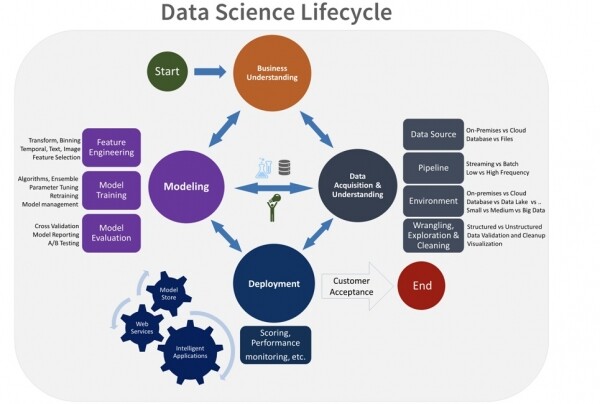
Com o surgimento de uma massa crítica de modelos de aprendizado de máquina implementados nos processos empresariais, foi notada uma forte semelhança entre o ciclo de vida dos modelos de aprendizado de máquina e o ciclo de vida do software. A única diferença é que os algoritmos dos modelos são criados com ferramentas e métodos de aprendizado de máquina. Assim, surgiu naturalmente a ideia de aplicar e adaptar abordagens já conhecidas de desenvolvimento de software para modelos de aprendizado de máquina. Portanto, no ciclo de vida dos modelos de aprendizado de máquina, podemos identificar as seguintes etapas-chave:
- definição da ideia de negócio;
- treinamento do modelo;
- testes e implementação do modelo no processo de negócios;
- operação do modelo.
Quando, durante a operação, surge a necessidade de alterar ou re-treinar o modelo com novos dados, o ciclo reinicia — o modelo é aprimorado, testado e uma nova versão é implantada.
Um parêntese. Por que re-treinar e não re-treinar? O termo "re-treinamento do modelo" tem uma interpretação dupla: entre os especialistas, significa um defeito do modelo, quando o modelo prevê bem, na verdade repete o parâmetro previsto no conjunto de treinamento, mas funciona muito pior no conjunto de dados externo. Naturalmente, tal modelo é considerado defeituoso, pois esse defeito impede sua aplicação.
Nesse ciclo de vida, parece lógico utilizar ferramentas DevOps: testes automatizados, implantação e monitoramento, e o formato de cálculo dos modelos como microsserviços separados. No entanto, existem também várias particularidades que impedem a aplicação direta dessas ferramentas sem um suporte adicional de ML.
Como fazer os modelos funcionarem e gerarem lucro
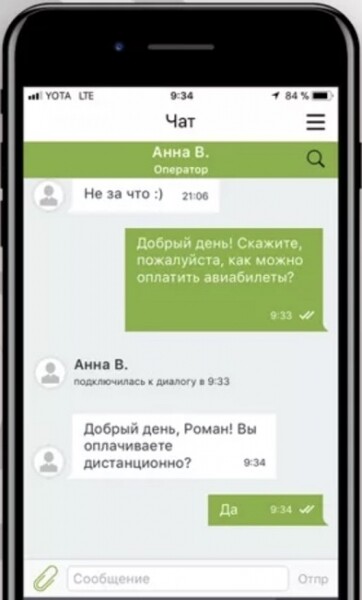
Como exemplo, vamos usar a clássica tarefa de automatização do chat de suporte de um produto bancário (ou de qualquer outro). Normalmente, o processo de suporte via chat funciona da seguinte maneira: o cliente digita uma mensagem com uma pergunta e recebe uma resposta de um especialista dentro de uma árvore de diálogos previamente definida. A tarefa de automatizar esse chat geralmente é resolvida com conjuntos de regras definidas por especialistas, que são muito trabalhosos para desenvolver e manter. A eficácia dessa automação, dependendo do nível de complexidade da tarefa, pode variar entre 20 e 30%. Naturalmente, surge a ideia de que é mais vantajoso implementar um módulo de inteligência artificial - um modelo desenvolvido por meio de aprendizado de máquina, que:
- é capaz de processar um maior número de solicitações sem a intervenção de um operador (dependendo do assunto, em alguns casos a eficácia pode chegar a 70-80%);
- se adapta melhor a formulações não padronizadas no diálogo - consegue identificar a intenção, o desejo real do usuário em relação a um pedido não claramente formulado;
- sabe identificar quando a resposta do modelo é adequada e quando há dúvidas sobre a 'consciência' dessa resposta, sendo necessário fazer uma pergunta complementar ou transferir a conversa para um operador;
- pode ser aprimorada automaticamente (em vez de um grupo de desenvolvedores que adaptam e corrigem constantemente os cenários de resposta, a modelagem é aprimorada por um especialista em Data Science usando bibliotecas de aprendizado de máquina apropriadas).
Como fazer um modelo tão avançado funcionar?
Assim como na resolução de qualquer outra tarefa, antes de desenvolver tal módulo, é necessário definir o processo de negócios e descrever formalmente a tarefa específica que vamos resolver utilizando o método de aprendizado de máquina. É neste ponto que começa o processo de operacionalização, indicado pela sigla Ops.
O próximo passo para o especialista em Data Science, em colaboração com o engenheiro de dados, é verificar a disponibilidade e a suficiência dos dados e a hipótese de negócios sobre a viabilidade da ideia de negócio, desenvolvendo um protótipo do modelo e testando sua eficácia real. Somente após a confirmação do negócio pode-se iniciar a transição do desenvolvimento do modelo para a integração deste em sistemas que executam um processo de negócio específico. Um planejamento integral da implementação, uma compreensão profunda em cada etapa de como o modelo será utilizado e qual o efeito econômico que trará, é fundamental nos processos de implementação das abordagens MLOps no cenário tecnológico da empresa.
Com o avanço das tecnologias de IA, a quantidade e a diversidade de tarefas que podem ser resolvidas com aprendizado de máquina aumentam exponencialmente. Cada um desses processos de negócios representa uma economia para a empresa devido à automação do trabalho de funcionários em posições massivas (como call center, verificação e triagem de documentos, etc.), uma expansão da base de clientes através da adição de novas funções atraentes e convenientes, economia de recursos através da otimização do seu uso e realocação de recursos, entre outras coisas. No final, qualquer processo é voltado para a criação de valor e, como consequência, deve gerar um determinado efeito econômico. Aqui, é extremamente importante formular claramente a ideia de negócio e calcular o lucro esperado da implementação do modelo dentro da estrutura geral de criação de valor da empresa. Existem situações em que a implementação do modelo não se justifica, e o tempo gasto pelos especialistas em aprendizado de máquina acaba custando muito mais do que o salário de um operador que desempenha essa tarefa. Por isso, é essencial tentar identificar esses casos nas fases iniciais de criação dos sistemas de IA.
Portanto, o modelo começa a gerar lucro apenas quando a tarefa de negócios foi corretamente formulada no processo de MLOps, as prioridades definidas e o processo de integração do modelo no sistema delineado nas fases iniciais de desenvolvimento.
Novo processo – novos desafios
Uma resposta abrangente à questão fundamental do negócio sobre a aplicabilidade dos modelos de ML para resolução de problemas e a questão geral da confiança em IA — este é um dos principais desafios no desenvolvimento e implementação de abordagens de MLOps. Inicialmente, os negócios são céticos em relação à implementação de aprendizado de máquina nos processos — é difícil confiar em modelos em áreas onde, tradicionalmente, pessoas costumavam trabalhar. Para os negócios, os programas são vistos como 'caixas pretas', cuja relevância das respostas ainda precisa ser comprovada. Além disso, na atividade bancária, nos negócios de operadores de telecomunicações e em outros setores, existem rigorosos requisitos impostos pelos reguladores governamentais. Todos os sistemas e algoritmos implantados em processos bancários estão sujeitos a auditoria. Para resolver essa questão e demonstrar ao negócio e aos reguladores a validade e a correção das respostas da inteligência artificial, junto com o modelo, são implementados recursos de monitoramento. Além disso, existe um procedimento de validação independente, obrigatório para modelos regulatórios, que atende às exigências do Banco Central. Um grupo de especialistas independentes realiza a auditoria dos resultados obtidos pelo modelo, considerando os dados de entrada.
O segundo desafio é a avaliação e o gerenciamento dos riscos do modelo ao implementar um modelo de aprendizado de máquina. Se até uma pessoa não pode responder à pergunta com cem por cento de certeza, se o vestido era branco ou azul, a inteligência artificial também tem o direito de errar. Além disso, é importante considerar que, com o tempo, os dados podem mudar, e os modelos precisam ser re-treinados para fornecer resultados suficientemente precisos. Para que o processo de negócios não seja prejudicado, é necessário gerenciar os riscos do modelo e monitorar o desempenho do modelo, re-treinando-o regularmente com novos dados.
Mas após a primeira fase de desconfiança, começa a aparecer um efeito reverso. Quanto mais modelos são implementados com sucesso nos processos, maior se torna o apetite dos negócios pelo uso da inteligência artificial — novas e novas tarefas surgem que podem ser resolvidas com métodos de aprendizado de máquina. Cada tarefa inicia um processo inteiro que requer competências específicas:
- engenheiros de dados preparam e processam os dados;
- cientistas de dados aplicam ferramentas de aprendizado de máquina e desenvolvem o modelo;
- A TI implementa o modelo no sistema;
- O engenheiro de ML determina como integrar corretamente esse modelo ao processo, quais ferramentas de TI utilizar, dependendo dos requisitos do modo de aplicação do modelo, levando em conta o fluxo de chamadas, tempo de resposta, etc.
- O arquiteto de ML projeta como o produto de software pode ser implementado fisicamente em um sistema industrial.
Todo o ciclo exige um grande número de profissionais altamente qualificados. Em certo ponto do desenvolvimento e do grau de penetração dos modelos de ML nos processos de negócios, observa-se que escalar linearmente o número de especialistas proporcionalmente ao aumento do número de tarefas torna-se caro e ineficiente. Portanto, surge a questão da automação do processo de MLOps - a definição de várias classes padrão de tarefas de aprendizado de máquina, o desenvolvimento de pipelines típicos de processamento de dados e o re-treinamento de modelos. Na visão ideal, para resolver tais tarefas, são necessários profissionais que dominem igualmente as competências na interseção de Big Data, Data Science, DevOps e TI. Assim, o maior problema na indústria de Data Science e o maior desafio na organização dos processos de MLOps é a falta dessa competência no atual mercado de formação de profissionais. Especialistas que atendam a esses requisitos são atualmente raros no mercado de trabalho e são valorizados como ouro.
Sobre as competências
Em teoria, todas as tarefas de MLOps podem ser resolvidas com ferramentas clássicas de DevOps, sem recorrer à expansão especializada do modelo de papéis. Assim, como já mencionamos, o cientista de dados deve ser não apenas um matemático e um especialista em análise de dados, mas também um guru de todo o pipeline - cabe a ele desenvolver a arquitetura, programar modelos em várias linguagens dependendo da arquitetura, preparar a vitrine de dados e implantar o próprio aplicativo. No entanto, a criação da infraestrutura tecnológica, implementada no processo contínuo de MLOps, consome até 80% do esforço de trabalho, o que significa que um matemático qualificado, que é um bom Cientista de Dados, dedicará apenas 20% do seu tempo à sua especialidade. Portanto, a definição de papéis dos especialistas envolvidos no processo de implementação de modelos de aprendizado de máquina torna-se vital.
O quão detalhadamente os papéis devem ser definidos depende da escala da empresa. É uma coisa quando em uma startup há um único especialista, um verdadeiro faz-tudo que é ao mesmo tempo engenheiro, arquiteto e DevOps. É completamente diferente em uma grande empresa, onde todos os processos de desenvolvimento de modelos estão concentrados em alguns especialistas de Data Science de alto nível, enquanto um programador ou especialista em bancos de dados — uma competência mais comum e menos cara no mercado de trabalho — pode assumir grande parte das tarefas rotineiras.
Assim, a definição de donde passa a linha na escolha de especialistas para garantir o processo de MLOps e como o processo de operacionalização dos modelos desenvolvidos é organizado, afeta diretamente a velocidade e a qualidade dos modelos desenvolvidos, a produtividade da equipe e o clima interno.
O que já foi feito pela nossa equipe
Recentemente, começamos a construir a estrutura de competências e os processos de MLOps. Mas já estão em fase de teste nossas iniciativas de gerenciamento do ciclo de vida de modelos e de aplicação de modelos como serviço.
Além disso, definimos a estrutura de competências e organizacional ideal para uma grande empresa, bem como a interação entre todos os participantes do processo. Formamos equipes Agile para atender a todo o espectro de negócios, além de estabelecer um processo de interação com as equipes de projeto para criar plataformas e infraestrutura que servirão como base para a estrutura de MLOps.
Questões para o futuro
MLOps é um campo em desenvolvimento que enfrenta uma escassez de competências e que, no futuro, deverá ganhar força. Por enquanto, é melhor basear-se em aprendizagens e práticas do DevOps. O principal objetivo do MLOps é o uso mais eficaz de modelos de ML para resolver problemas de negócios. Mas surge uma série de questões:
- Como reduzir o tempo para colocar modelos em produção?
- Como diminuir as fricções burocráticas entre equipes de diferentes competências e aumentar o foco na colaboração?
- Como rastrear modelos, gerenciar versões e organizar uma monitorização eficaz?
- Como criar um ciclo de vida verdadeiramente cíclico para um modelo de ML moderno?
- Como padronizar o processo de aprendizado de máquina?
As respostas a essas perguntas determinarão em grande parte a rapidez com que o MLOps revelará todo o seu potencial.
Fonte: habr.com
