

Neste artigo, vou falar sobre uma situação que ocorreu recentemente com um dos nossos servidores em nuvem VPS, que me deixou perplexo por algumas horas. Tenho cerca de 15 anos de experiência configurando e solucionando problemas com servidores Linux, mas este caso não se encaixa na minha prática — fiz algumas suposições erradas e fiquei um pouco desesperado antes de conseguir identificar corretamente a causa do problema e resolvê-lo.
Préâmbulo
Operamos uma nuvem de médio porte, construída em servidores padrão com a seguinte configuração — 32 núcleos, 256 GB de RAM e um SSD NVMe PCI-E Intel P4500 de 4TB. Gostamos muito dessa configuração, pois nos permite não nos preocupar com a escassez de IO, garantindo uma limitação adequada ao nível dos tipos de instâncias (VMs). Como o NVMe Intel possui um desempenho impressionante, podemos ao mesmo tempo garantir a disponibilização total de IOPS para as máquinas e fazer backup do armazenamento em um servidor de backup com zero IOWAIT.
Fazemos parte dos veteranos que não utilizam SDNs hiperconvergentes e outras coisas legais e modernas para o armazenamento de volumes de VM, acreditando que quanto mais simples o sistema, mais fácil é solucioná-lo em situações de "o guru principal foi para as montanhas". Assim, armazenamos os volumes de VM no formato QCOW2 em XFS ou EXT4, que é instalado sobre LVM2.
O uso de QCOW2 também é imposto pelo produto que usamos para orquestração — Apache CloudStack.
Para realizar backups, fazemos uma imagem completa do volume, como um snapshot LVM2 (sim, sabemos que os snapshots LVM2 são lentos, mas o Intel P4500 nos salva aqui também). Nós executamos lvmcreate -s .. e com isso dd enviamos o backup para um servidor remoto com armazenamento ZFS. Aqui somos um pouco progressistas — afinal, o ZFS consegue armazenar dados de forma compactada, e podemos recuperá-los rapidamente usando DD ou acessar volumes de VM individuais com mount -o loop ....
É claro que também podemos fazer um snapshot que não seja a imagem completa do volume LVM2 e montar o sistema de arquivos em modo
ROe copiar as próprias imagens QCOW2, no entanto, encontramos que o XFS ficava problemático, e não de imediato, mas de forma imprevisível. Nós não gostamos quando os hosts hipervisores "travam" repentinamente nos finais de semana, à noite ou em feriados devido a erros que podem ocorrer a qualquer momento. Portanto, para o XFS, não usamos montagem de snapshots no modoROpara extração de volumes, apenas copiamos o volume LVM2 inteiro.
A velocidade de backup no servidor de backups é determinada, neste caso, pelo desempenho do servidor de backup, que é de cerca de 600-800 MB/s para dados não comprimidos, e o próximo limitador é o canal de 10Gbit/s, ao qual o servidor de backup está conectado ao cluster.
Nesse sentido, um único servidor de backup carrega concomitantemente backups de 8 servidores hipervisores. Assim, os subsistemas de disco e rede do servidor de backup, sendo mais lentos, não sobrecarregam os subsistemas de disco dos hosts hipervisores, pois simplesmente não conseguem processar, digamos, 8 GB/s, que os hosts hipervisores podem fornecer sem esforço.
O processo de cópia descrito acima é muito importante para a narrativa futura, incluindo detalhes — uso de um rápido armazenamento Intel P4500, uso de NFS e, provavelmente, uso de ZFS.
História sobre backup
Em cada nó hipervisor, temos uma pequena seção SWAP de 8 GB, e o próprio nó hipervisor é "instalado" usando DD uma imagem de referência. Para o volume do sistema nos servidores, usamos 2xSATA SSD RAID1 ou 2xSAS HDD RAID1 em um controlador de hardware LSI ou HP. Em geral, não nos importa o que está lá dentro, pois o volume do sistema funciona em modo "quase somente leitura", exceto pelo SWAP. E como temos muita RAM no servidor, e ela está 30-40% livre, não pensamos no SWAP.
O processo de criação de backup. Esta tarefa se parece aproximadamente com:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Preste atenção em ionice -c3, na verdade, isso é completamente inútil para dispositivos NVMe, pois o agendador IO para eles é definido como:
cat /sys/block/nvme0n1/queue/scheduler
[none]
No entanto, temos uma série de nós legados com RAIDs SSD comuns, para os quais isso é relevante, e é por isso que se muda AS IS. Em suma, este é apenas um pedaço interessante de código que explica a futilidade ionice em caso de tal configuração.
Observe a bandeira iflag=direct para DD. Utilizamos IO direto fora do cache de buffer para evitar substituições desnecessárias dos buffers de IO durante a leitura. No entanto, oflag=direct não o fazemos, pois encontramos problemas de desempenho com o ZFS ao utilizá-lo.
Este esquema tem sido utilizado com sucesso por nós durante vários anos sem problemas.
E aqui começou… Descobrimos que para um dos nós, o backup parou de ser executado, e o backup anterior foi concluído com um IOWAIT monstruoso de 50%. Ao tentar entender por que a cópia não estava ocorrendo, nos deparamos com o fenômeno:
Grupo de volume "images" não encontradoComeçamos a pensar sobre "o fim chegou para o Intel P4500", no entanto, antes de desligar o servidor para substituir o dispositivo, era necessário ainda fazer o backup. Corrigimos o LVM2 restaurando os metadados a partir do backup do LVM2:
vgcfgrestore imagesIniciamos o backup e vimos esta cena:
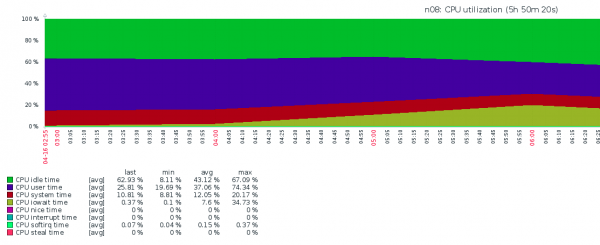
Voltamos a ficar muito tristes — estava claro que não poderíamos viver assim, pois todas as VPS estariam sofrendo, e isso significaria que também sofreríamos. O que estava acontecendo era completamente incompreensível — iostat mostrava IOPS miseráveis e um IOWAIT altíssimo. Não havia ideias, além de "vamos substituir o NVMe", mas uma iluminação ocorreu a tempo.
Análise da situação passo a passo
Registro histórico. Alguns dias antes, foi necessário criar uma grande VPS neste servidor com 128 GB de RAM. A memória parecia suficiente, mas para precaução, alocamos mais 32 GB para a partição de troca. A VPS foi criada, cumpriu sua tarefa e o incidente foi esquecido, enquanto a partição SWAP permaneceu.
Características da configuração. Para todos os servidores da nuvem, o parâmetro vm.swappiness foi definido com o valor padrão 60. E a SWAP foi criada em RAID1 de HDD SAS.
O que estava acontecendo (na visão da redação). Durante o backup DD fornecia muitos dados para gravação, que eram armazenados nos buffers de RAM antes de serem gravados no NFS. O núcleo do sistema, seguindo a política swappiness, movia muitas páginas de memória da VPS para a área de troca, que estava em um volume lento de RAID1 de HDD. Isso fez com que o IOWAIT aumentasse significativamente, mas não devido ao IO do NVMe, e sim ao IO do RAID1 de HDD.
Como o problema foi resolvido. A partição de troca de 32GB foi desativada. Isso levou 16 horas; sobre como e por que a troca desativa tão lentamente, pode-se ler separadamente. Os parâmetros swappiness foram alterados para um valor igual a 5 em toda a nuvem.
Como isso poderia não ter acontecidoPrimeiro, se o SWAP estivesse em um dispositivo SSD RAID ou NVMe, e segundo, se não houvesse um dispositivo NVMe, mas sim um dispositivo mais lento que não conseguisse gerar esse volume de dados — por ironia, o problema ocorreu porque o NVMe é rápido demais.
Depois disso, tudo voltou a funcionar como antes — com zero de IOWAIT.
Fonte: habr.com
