

Gostaria de compartilhar com vocês minha primeira experiência bem-sucedida na restauração completa da funcionalidade da base de dados Postgres. Conheci o SGBD Postgres há seis meses, e antes disso não tinha nenhuma experiência em administração de bases de dados.
Trabalho como engenheiro semi-DevOps em uma grande empresa de TI. Nossa empresa se dedica ao desenvolvimento de software para serviços de alta carga, e eu sou responsável pela funcionalidade, manutenção e deploy. Fui incumbido de uma tarefa padrão: atualizar um aplicativo em um servidor. O aplicativo foi escrito em Django, e durante a atualização, são executadas migrações (mudanças na estrutura da base de dados), e antes desse processo, fazemos um dump completo da base de dados usando o programa padrão pg_dump, por precaução.
Durante a criação do dump, ocorreu um erro inesperado (versão do Postgres – 9.5):
pg_dump: A captura do conteúdo da tabela “ws_log_smevlog” falhou: PQgetResult() falhou.
pg_dump: Mensagem de erro do servidor: ERRO: página inválida no bloco 4123007 do relacionamento base/16490/21396989
pg_dump: O comando foi: COPY public.ws_log_smevlog [...]
pg_dump: [arquivamento paralelo] um processo de trabalho falhou inesperadamente
Erro «Página inválida no bloco» indica problemas no nível do sistema de arquivos, o que não é bom. Em vários fóruns, sugeriram fazer FULL VACUUM com a opção zero_damaged_pages para resolver esse problema. Bem, vamos tentar…
Preparação para a restauração
ATENÇÃO! Certifique-se de fazer um backup do Postgres antes de qualquer tentativa de restaurar a base de dados. Se você tiver uma máquina virtual, pare a base de dados e faça um snapshot. Se não for possível fazer um snapshot, pare a base e copie o conteúdo do diretório do Postgres (incluindo arquivos wal) para um local seguro. O mais importante no nosso trabalho é não piorar a situação. Leia .
Uma vez que, no geral, a base de dados estava funcionando, limitei-me a um dump regular da base de dados, mas excluí a tabela com os dados corrompidos (opção -T, —exclude-table=TABLE no pg_dump).
O servidor era físico, não foi possível fazer um snapshot. O backup foi feito, vamos em frente.
Verificação do sistema de arquivos
Antes de tentar restaurar a base de dados, é necessário garantir que tudo esteja em ordem com o próprio sistema de arquivos. E, caso haja erros, corrigi-los, pois, caso contrário, pode-se apenas piorar.
No meu caso, o sistema de arquivos com a base de dados estava montado em «/srv» e o tipo era ext4.
Parando a base de dados: systemctl stop postgresql@9.5-main.service e verificamos se o sistema de arquivos não está em uso e pode ser desmontado com o comando lsof:
lsof +D /srv
Eu também precisei parar o banco de dados redis, pois ele também estava em uso «/srv». Em seguida, eu o desmontei /srv (umount).
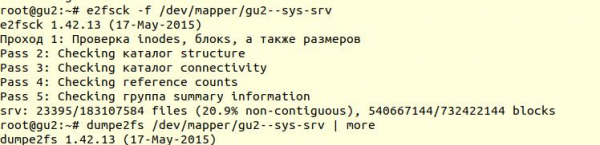
A verificação do sistema de arquivos foi realizada com a ferramenta e2fsck com a opção -f (Forçar verificação mesmo que o sistema de arquivos esteja marcado como limpo):
Em seguida, com a ferramenta dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) podemos confirmar que a verificação realmente foi realizada:
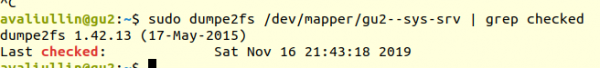
e2fsck diz que não foram encontrados problemas no nível do sistema de arquivos ext4, o que significa que podemos continuar tentando recuperar o banco de dados, ou melhor, voltar para vacuum full (naturalmente, devemos montar o sistema de arquivos novamente e iniciar o banco de dados).
Se você tiver um servidor físico, certifique-se de verificar o estado dos discos (através de smartctl -a /dev/XXX) ou do controlador RAID, para garantir que o problema não está em nível de hardware. No meu caso, o RAID era 'hardware', então pedi ao administrador local que verificasse o estado do RAID (o servidor estava a várias centenas de quilômetros de distância de mim). Ele disse que não havia erros, o que significa que podemos certamente iniciar a recuperação.
Tentativa 1: zero_damaged_pages
Conectamos ao banco de dados através do psql com uma conta que possui privilégios de superusuário. Precisamos exatamente de um superusuário, pois a opção zero_damaged_pages só pode ser alterada por ele. No meu caso é postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Opção zero_damaged_pages é necessária para ignorar erros de leitura (do site postgrespro):
Ao detectar um cabeçalho de página corrompido, o Postgres Pro geralmente relata um erro e interrompe a transação atual. Se a opção zero_damaged_pages estiver ativada, em vez disso, o sistema gera um aviso, zera a página corrompida na memória e continua o processamento. Esse comportamento corrompe os dados, ou seja, todas as linhas na página corrompida.
Ativamos a opção e tentamos fazer um full vacuum na tabela:
VACUUM FULL VERBOSE 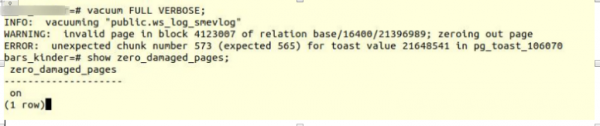
Infelizmente, falhou.
Enfrentamos um erro semelhante:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: página inválida no bloco 4123007 da relação base/16400/21396989; zerando a página
ERROR: número de chunk inesperado 573 (esperado 565) para valor toast 21648541 em pg_toast_106070– mecanismo de armazenamento de 'dados longos' no Postgres, se não couberem em uma página (por padrão 8kb).
Tentativa 2: reindex
O primeiro conselho do Google não ajudou. Após alguns minutos de pesquisa, encontrei o segundo conselho – fazer um reindex tabela danificada. Este conselho encontrei em muitos lugares, mas não inspirava confiança. Vamos fazer reindex:
reindexar a tabela ws_log_smevlog 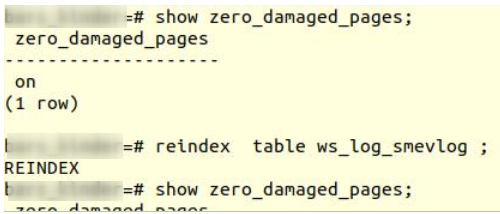
reindex terminou sem problemas.
No entanto, isso não ajudou, VACUUM FULL terminou de forma semelhante com um erro. Como estou acostumado a falhas, comecei a procurar conselhos na internet e encontrei algo bastante interessante .
Tentativa 3: SELECT, LIMIT, OFFSET
No artigo acima, foi sugerido olhar a tabela linha por linha e remover dados problemáticos. Para começar, era necessário revisar todas as linhas:
for ((i=0; i/dev/null || echo $i; doneno meu caso, a tabela continha 1 628 991 linhas! O ideal seria cuidar do , mas esse é um tema para outra discussão. Era sábado, eu executei este comando no tmux e fui dormir:
for ((i=0; i/dev/null || echo $i; donePela manhã, decidi verificar como as coisas estavam. Para minha surpresa, descobri que em 20 horas apenas 2% dos dados foram escaneados! Eu não queria esperar 50 dias. Mais uma falha completa.
Mas eu não desisti. Fiquei curioso para saber por que a varredura estava tão lenta. Na documentação (novamente no postgrespro), descobri:
OFFSET indica pular o número especificado de linhas antes de começar a retornar as linhas.
Se OFFSET e LIMIT forem especificados, o sistema primeiro pula as linhas do OFFSET e depois começa a contar as linhas para o limite do LIMIT.Ao aplicar LIMIT, é importante também usar a cláusula ORDER BY, para que as linhas do resultado sejam retornadas em uma ordem específica. Caso contrário, subconjuntos imprevisíveis de linhas serão retornados.
É óbvio que o comando acima estava incorreto: em primeiro lugar, não havia order by, o resultado poderia estar incorreto. Em segundo lugar, o Postgres precisava primeiro escanear e pular as linhas do OFFSET, e à medida que aumentava OFFSET o desempenho diminuiria ainda mais.
Tentativa 4: fazer um dump em formato texto
Em seguida, me ocorreu, aparentemente, uma ideia genial: fazer um dump em formato texto e analisar a última linha gravada.
Mas antes, vamos conhecer a estrutura da tabela ws_log_smevlog:
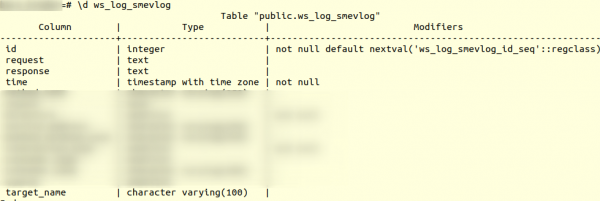
No nosso caso, temos uma coluna "id", que continha um identificador único (contador) da linha. O plano era o seguinte:
- Começar a fazer um dump em formato texto (na forma de comandos sql)
- Em um determinado momento, a exportação de dump poderia ser interrompida devido a um erro, mas o arquivo de texto ainda assim seria salvo no disco.
- Vamos olhar o final do arquivo de texto, assim encontramos o identificador (id) da última linha que foi exportada com sucesso.
Comecei a exportar o dump em formato de texto:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f .\/my_dump.dumpA exportação do dump, como esperado, foi interrompida com o mesmo erro:
pg_dump: Mensagem de erro do servidor: ERRO: página inválida no bloco 4123007 da base de dados/16490/21396989 Depois, através de tail eu verifiquei o final do dump (tail -5 .\/my_dump.dump) e descobri que a exportação foi interrompida na linha com id 186 525. "Significa que o problema está na linha com id 186 526, ela está corrompida, é essa que precisa ser removida!" – pensei. Mas, ao consultar o banco de dados:
«select * from ws_log_smevlog where id=186529não havia problema com essa linha... As linhas com índices de 186 530 a 186 540 também funcionaram sem problemas. Mais uma "ideia genial" falhou. Depois percebi por que isso aconteceu: ao deletar ou modificar dados em uma tabela, eles não são removidos fisicamente, mas marcados como "tuplas mortas"; posteriormente, um processo autovacuum as marca como deletadas e permite que essas linhas sejam reutilizadas. Para entender, se os dados em uma tabela mudam e o autovacuum está ligado, eles não são armazenados sequencialmente.
Tentativa 5: SELECT, FROM, WHERE id=
Os fracassos nos tornam mais fortes. Nunca devemos desistir, devemos ir até o fim e acreditar em nós mesmos e em nossas capacidades. Portanto, decidi tentar mais uma opção: simplesmente revisar todos os registros no banco de dados um por um. Sabendo a estrutura da minha tabela (veja acima), temos um campo id, que é único (chave primária). Na tabela, temos 1.628.991 linhas e id elas estão em ordem, o que significa que podemos simplesmente percorrê-las uma a uma:
for ((i=1; i<1628991; i=$((i+1)) )); do psql -U my_user -d my_database -c "SELECT * FROM ws_log_smevlog where id=$i" >\/dev\/null || echo $i; doneSe alguém não entende, o comando funciona da seguinte maneira: percorre a tabela linha por linha e envia o stdout para /dev/null, mas se o comando SELECT falha, então um texto de erro é mostrado (stderr é enviado para o console) e a linha que contém o erro é exibida (graças ao ||, que indica que houve problemas no select (código de retorno do comando não é 0)).
Tive sorte, pois criei índices sobre o campo id:
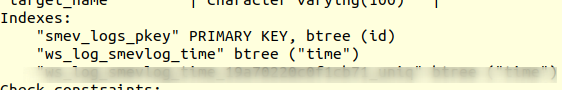
E isso significa que encontrar a linha com o id necessário não deve levar muito tempo. Na teoria, isso deve funcionar. Vamos lá, executando o comando. , demônio e vamos dormir.
Pela manhã, descobri que cerca de 90.000 registros foram visualizados, o que representa um pouco mais de 5%. Um ótimo resultado, se comparado ao método anterior (2%)! Mas não queria esperar 20 dias...
Tentativa 6: SELECT, FROM, WHERE id >= e id <
O cliente tinha um ótimo servidor dedicado para o banco de dados: dual-core Intel Xeon E5-2697 v2, tínhamos 48 threads disponíveis! A carga no servidor era média, conseguíamos facilmente processar cerca de 20 threads. A memória RAM também era suficiente: incríveis 384 gigabytes!
Portanto, a equipe precisava ser paralelizada:
for ((i=1; i<1628991; i=$((i+1)) )); do psql -U my_user -d my_database -c "SELECT * FROM ws_log_smevlog where id=$i" >\/dev\/null || echo $i; doneAqui poderia ser escrito um script bonito e elegante, mas escolhi a maneira mais rápida de paralelização: dividir manualmente o intervalo de 0-1628991 em intervalos de 100.000 registros e executar separadamente 16 comandos do tipo:
for ((i=N; i/dev/null || echo $i; doneMas isso não é tudo. Em teoria, conectar-se ao banco de dados também leva algum tempo e recursos do sistema. Conectar 1.628.991 não era muito razoável, concorda? Portanto, vamos extrair 1000 linhas por conexão em vez de uma. No final, o comando se transformou nisso:
for ((i=N; i=$i and id/dev/null || echo $i; doneAbrimos 16 janelas na sessão tmux e executamos os comandos:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Depois de um dia, recebi os primeiros resultados! A saber (os valores XXX e ZZZ já não foram salvos):
ERROR: missing chunk number 0 for toast value 37837571 in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value XXX in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value ZZZ in pg_toast_106070
146000
Isso significa que temos três linhas com erro. O id do primeiro e do segundo registro problemático estavam entre 829.000 e 830.000, enquanto o id do terceiro estava entre 146.000 e 147.000. A seguir, precisávamos apenas encontrar o valor exato do id dos registros problemáticos. Para isso, vamos percorrer nosso intervalo de registros problemáticos com um passo de 1 e identificar os ids:
for ((i=829000; i/dev/null || echo $i; done
829417
ERRO: número de chunk inesperado 2 (esperado 0) para o valor toast 37837843 em pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERRO: número de chunk inesperado ZZZ (esperado 0) para o valor toast XXX em pg_toast_106070
146911
Final Feliz
Encontramos linhas problemáticas. Conectamos ao banco via psql e tentamos removê-las:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Para minha surpresa, as entradas foram removidas sem quaisquer problemas, mesmo sem a opção zero_damaged_pages.
Em seguida, conectei ao banco, fiz VACUUM FULL (acho que não era necessário), e, finalmente, consegui fazer um backup com pg_dump. O dump foi criado sem nenhum erro! O problema foi resolvido dessa forma simples. A alegria foi imensa, após tantas falhas finalmente encontrei uma solução!
Agradecimentos e Conclusão
Esta foi minha primeira experiência em restaurar um banco de dados real do Postgres. Essa experiência eu vou lembrar por muito tempo.
E, por último, gostaria de agradecer à empresa PostgresPro pela documentação traduzida para o russo e por , que ajudaram muito na análise do problema.
Fonte: habr.com
