

Pensamos na criação de um sistema de monitoramento na fase de formação das equipes de produtos. Ficou claro que nossa área — operação — não se integra a essas equipes de forma alguma. Por quê?
O fato é que todas as nossas equipes são organizadas em torno de sistemas de informação separados, microsserviços e front-ends, então o estado geral da saúde de todo o sistema não é visível para as equipes. Por exemplo, elas podem não saber como uma pequena parte no backend profundo influencia a parte frontal. O escopo de interesse delas é limitado aos sistemas com os quais seus sistemas estão integrados. Se a equipe e seu serviço A praticamente não estão relacionados ao serviço B, então esse serviço é quase invisível para a equipe.
A nossa equipe, por sua vez, trabalha com sistemas que estão muito integrados uns aos outros: existem muitas conexões entre eles, é uma infraestrutura bastante grande. E o funcionamento de todas essas sistemas (dos quais temos, a propósito, uma quantidade enorme) é vital para o funcionamento da loja online.
Portanto, acontece que nosso departamento não pertence a nenhuma equipe, mas está um pouco à parte. Em toda essa história, nossa tarefa é entender de forma abrangente como funcionam os sistemas de informação, suas funcionalidades, integrações, software, rede, hardware e como tudo isso está interconectado.
A plataforma em que nossos e-commerces funcionam é assim:
- front
- middle-office
- back-office
Por mais que queiramos, não existe um cenário em que todos os sistemas operem suavemente e sem falhas. O problema, novamente, está na quantidade de sistemas e integrações — com a quantidade que temos, certos incidentes são inevitáveis, independentemente da qualidade dos testes. E isso acontece tanto dentro de um sistema específico quanto em termos de sua integração. É necessário monitorar a condição de toda a plataforma de forma abrangente, e não apenas de uma parte dela.
Idealmente, a supervisão do estado de saúde de toda a plataforma deve ser automatizada. E chegamos ao monitoramento como uma parte inevitável desse processo. Inicialmente, ele foi construído apenas para a parte frontal, enquanto isso, sistemas próprios de monitoramento em camadas estavam e ainda estão disponíveis para redes, administradores de software e hardware. Todas essas pessoas monitoravam apenas em seu nível, e ninguém tinha uma compreensão abrangente.
Por exemplo, se uma máquina virtual falhar, na maioria dos casos, apenas o administrador responsável pelo hardware e pela máquina virtual saberá disso. A equipe de front-end, nesses casos, vê apenas o fato de que o aplicativo caiu, mas não tem dados sobre a queda da máquina virtual. E o administrador pode saber quem é o cliente e ter uma ideia do que está rodando naquela máquina virtual, desde que seja algum projeto grande. Sobre os pequenos, ele provavelmente não sabe. De qualquer forma, o administrador precisa ir até o proprietário, perguntar o que havia naquela máquina, o que precisa ser recuperado e o que deve ser mudado. E se algo realmente grave quebrar, começa a correria em círculos — porque ninguém vê o sistema como um todo.
No final das contas, essas histórias desconectadas afetam todo o front-end, os usuários e nossa função de negócios principal — vendas online. Como não fazemos parte das equipes e somos responsáveis pela operação de todos os aplicativos de e-commerce dentro da loja online, assumimos a tarefa de criar um sistema abrangente de monitoramento da plataforma de e-commerce.
Estrutura do sistema e stack
Começamos identificando várias camadas de monitoramento para nossos sistemas, ao longo das quais precisaremos coletar métricas. E tudo isso precisava ser integrado, o que fizemos na primeira fase. Agora, nessa fase, estamos ajustando a coleta de métricas com a máxima qualidade para todas as nossas camadas, a fim de construir correlações e entender como os sistemas afetam uns aos outros.
A falta de monitoramento abrangente nas etapas iniciais de lançamento dos aplicativos (já que começamos a construir isso quando a maior parte dos sistemas estava em operação) resultou em uma significativa dívida técnica na configuração do monitoramento de toda a plataforma. Não podíamos nos concentrar em configurar o monitoramento de um único sistema de informações e desenvolvê-lo detalhadamente, pois os outros sistemas ficariam sem monitoramento por algum tempo. Para resolver essa questão, definimos uma lista das métricas mais necessárias para avaliar a condição do sistema de informação por camadas e começamos a implementá-la.
Portanto, decidimos abordar o problema por partes.
Nosso sistema é composto por:
- hardware;
- sistema operacional;
- software;
- Componentes da interface do usuário na aplicação de monitoramento;
- métricas de negócios;
- aplicações de integração;
- segurança da informação;
- redes;
- balanceador de carga.
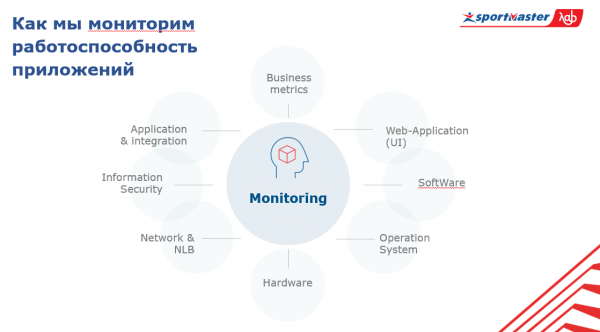
No centro deste sistema está o monitoramento em si. Para entender o estado geral de todo o sistema, é necessário saber o que acontece com as aplicações em todas essas camadas e em relação a toda a variedade de aplicações.
Então, sobre a pilha.
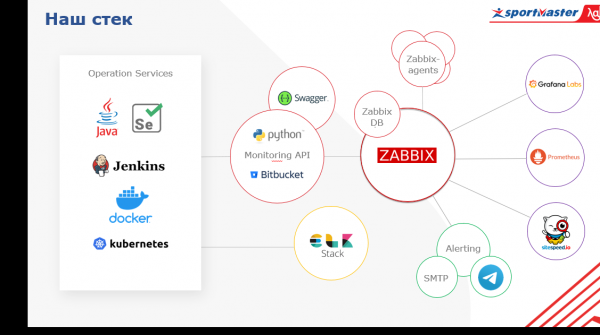
Usamos software de código aberto. O coração do nosso sistema é o Zabbix, que utilizamos principalmente como sistema de alerta. É amplamente conhecido por ser ideal para monitoramento de infraestrutura. O que se entende por isso? Exatamente aquelas métricas de baixo nível que cada empresa tem quando possui seu próprio centro de dados (e o Sportmaster possui seus próprios centros de dados) — temperatura do servidor, estado da memória, RAID, métricas de dispositivos de rede.
Integrámos o Zabbix com o mensageiro Telegram e Microsoft Teams, que são amplamente utilizados nas equipes. O Zabbix cobre a camada da rede real, hardware e parte do software, mas não é uma solução milagrosa. Enriquecemos esses dados a partir de alguns outros serviços. Por exemplo, quanto ao hardware, conectamos diretamente via API ao nosso sistema de virtualização e coletamos dados.
Além disso, utilizamos o Prometheus, que permite monitorar métricas em um ambiente de aplicação dinâmica. Ou seja, conseguimos obter métricas da aplicação através de um endpoint HTTP e não precisamos nos preocupar com quais métricas carregar, pois as podemos ajustar conforme necessário. Com base nesses dados, é possível desenvolver consultas analíticas.
As fontes de dados para as outras camadas, como métricas de negócios, estão divididas em três componentes.
Primeiro, são os sistemas de negócios externos, como o Google Analytics, de onde coletamos métricas dos logs. A partir deles, obtemos dados sobre usuários ativos, conversões e tudo o mais relacionado ao negócio. Em segundo lugar, está o sistema de monitoramento da interface do usuário. Este merece uma explicação mais detalhada.
Começamos com testes manuais, que evoluíram para testes automatizados de funcionalidades e integrações. A partir disso, desenvolvemos o monitoramento, mantendo apenas a funcionalidade principal, e nos baseamos em marcadores que são o mais estáveis possível e não mudam com frequência ao longo do tempo.
A nova estrutura de equipes implica que toda a atividade relacionada aos aplicativos esteja centrada nas equipes de produto, portanto, deixamos de lado os testes puros. Em vez disso, transformamos os testes em monitoramento de UI, escrito em Java, Selenium e Jenkins (usado como sistema de lançamento e geração de relatórios).
Tínhamos muitos testes, mas no final decidimos nos concentrar em métricas de alto nível. E se tivermos muitos testes específicos, será difícil manter a atualidade dos dados. Cada lançamento subsequente romperá significativamente todo o sistema, e estaremos apenas reparando-o. Portanto, nos concentramos em coisas realmente fundamentais que mudam raramente e monitoramos apenas elas.
Finalmente, em terceiro lugar, a fonte de dados é um sistema de registro centralizado. Para os logs, usamos Elastic Stack, e depois podemos importar esses dados para nosso sistema de monitoramento de métricas de negócios. Além de tudo isso, temos nosso próprio serviço Monitoring API, escrito em Python, que consulta quaisquer serviços via API e coleta dados deles para o Zabbix.
Outro atributo indispensável do monitoramento é a visualização. A nossa é construída com base no Grafana. Entre outros sistemas de visualização, ele se destaca por permitir visualizar métricas de diferentes fontes de dados em um painel. Podemos coletar métricas de alto nível de uma loja online, por exemplo, o número de pedidos realizados na última hora, a partir do SGBD, métricas de desempenho do sistema operacional em que a loja online está funcionando, do Zabbix, e métricas das instâncias dessa aplicação, do Prometheus. E tudo isso estará em um único painel. Visível e acessível.
Quero destacar a segurança — estamos atualmente aprimorando o sistema que posteriormente será integrado ao sistema global de monitoramento. Na minha opinião, os principais problemas que o e-commerce enfrenta na área de segurança da informação estão relacionados a bots, scrapers e força bruta. É necessário monitorar isso, pois pode impactar criticamente tanto o funcionamento de nossos aplicativos quanto a reputação do negócio. E com a stack escolhida, estamos cobrindo essas tarefas com sucesso.
Um ponto importante a ser destacado é que o nível de aplicações é monitorado pelo Prometheus. Ele também está integrado ao Zabbix. Além disso, temos o sitespeed, um serviço que nos permite observar parâmetros como a velocidade de carregamento da nossa página, gargalos, renderização de página, carregamento de scripts e outros, também integrado via API. Assim, as métricas são coletadas no Zabbix, onde também realizamos os alertas. Todos os alertas atualmente são enviados pelos principais métodos (no momento, e-mail e Telegram; também conectamos recentemente o MS Teams). Temos planos para aprimorar o sistema de alertas para que bots inteligentes funcionem como um serviço e forneçam informações de monitoramento para todas as equipes de produto interessadas.
Para nós, é importante ter métricas não apenas de sistemas de informação individuais, mas também métricas gerais de toda a infraestrutura que os aplicativos utilizam: clusters de servidores físicos, onde as máquinas virtuais operam, balanceadores de carga, Network Load Balancers, a própria rede e a utilização dos canais de comunicação. Além disso, temos métricas dos nossos próprios data centers (temos vários e a infraestrutura é bastante significativa).
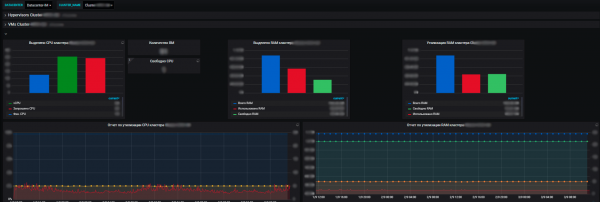
As vantagens do nosso sistema de monitoramento são que, com ele, podemos ver o estado de funcionamento de todos os sistemas, avaliar suas interações e o impacto sobre os recursos gerais. E, ao final, isso nos permite planejar os recursos, o que também faz parte de nossa responsabilidade. Nós gerenciamos os recursos do servidor — um pool dentro da e-commerce, introduzimos e retiramos equipamentos novos de operação, adquirimos novos, realizamos auditorias de utilização de recursos, entre outros. Todo ano, as equipes planejam novos projetos, desenvolvem seus sistemas, e é importante que garantamos os recursos necessários.
E, com a ajuda das métricas, conseguimos ver a tendência do consumo de recursos por nossos sistemas de informação. Com base nisso, podemos realizar planejamentos. No nível de virtualização, coletamos dados e visualizamos informações sobre a quantidade disponível de recursos nos diferentes data centers. E dentro de cada data center, podemos observar tanto a utilização quanto a distribuição e o consumo real de recursos. Isso é visível tanto em servidores standalone quanto em máquinas virtuais e clusters de servidores físicos, onde todas essas máquinas virtuais operam eficientemente.
Perspectivas
Atualmente, temos o núcleo do sistema pronto como um todo, mas ainda há muitos pontos a serem trabalhados. No mínimo, há a camada de segurança da informação, mas também é importante chegar à rede, desenvolver o alerta e resolver a questão da correlação. Temos muitas camadas e sistemas, e em cada camada existem inúmeras métricas. É como uma matryoshka em um grau de matryoshka.
Nossa tarefa é, em última análise, gerar alertas corretos. Por exemplo, se ocorrer um problema com a parte de hardware, novamente, com a máquina virtual, e lá havia um aplicativo importante, e o serviço não foi de forma alguma reservado. Faremos a descoberta de que a máquina virtual morreu. Em seguida, as métricas de negócios serão alertadas: os usuários desapareceram, não há conversões, a interface da UI não está acessível, o software e os serviços também falharam.
Com essa situação, teremos spam de alertas, o que já não se encaixa no formato de um sistema de monitoramento correto. A questão da correlação se levanta. Portanto, idealmente, nosso sistema de monitoramento deve dizer: "Pessoal, sua máquina física morreu, e junto com ela, este aplicativo e essas métricas", com um único alerta em vez de nos sobrecarregar com centenas de alertas. Ele deve reportar o principal — a causa, o que contribui para a rapidez na resolução do problema, localizando-o.
Nosso sistema de notificações e processamento de alertas é construído em torno de uma linha de atendimento 24 horas. Todos os alertas que consideramos essenciais e que fazem parte da lista de verificação são enviados para lá. Cada alerta deve obrigatoriamente ter uma descrição: o que aconteceu, o que isso realmente significa, a que afeta. Além disso, um link para o dashboard e instruções sobre o que fazer neste caso.
Isso abrange todos os requisitos para a construção de alertas. A partir daí, a situação pode se desenvolver em duas direções — ou existe um problema que precisa ser resolvido, ou ocorreu uma falha no sistema de monitoramento. Mas, de qualquer forma, é necessário investigar e esclarecer.
Em média, atualmente, recebemos cerca de cem alertas por dia, isso considerando que a correlação dos alertas ainda não está configurada corretamente. E se for necessário realizar trabalhos técnicos, e nós desligamos algo forçadamente, esse número aumenta drasticamente.
Além do monitoramento dos sistemas que operamos e da coleta de métricas que consideramos importantes, o sistema de monitoramento permite reunir dados para as equipes de produtos. Elas podem influenciar a composição das métricas nos sistemas de informação que monitoramos.
Um colega pode chegar e pedir para adicionar alguma métrica que seja útil tanto para nós quanto para a equipe. Ou, por exemplo, a equipe pode achar que as métricas básicas que temos não são suficientes, e precisarão monitorar algo específico. No Grafana, criamos um espaço para cada equipe e concedemos direitos de administrador. Além disso, se a equipe precisar de painéis e não puder/não souber como fazer isso, nós os ajudamos.
Como estamos fora do fluxo de criação de valor da equipe, seus lançamentos e planejamento, gradualmente chegamos ao ponto em que os lançamentos de todos os sistemas são contínuos e podem ser implementados diariamente, sem necessidade de aprovação nossa. E é importante para nós monitorar esses lançamentos, porque potencialmente podem afetar o funcionamento do aplicativo e causar falhas, o que é crítico. Para gerenciamento de lançamentos, usamos o Bamboo, de onde obtemos dados via API e podemos ver quais lançamentos saíram em quais sistemas de informação e seu status. E a coisa mais importante — a que horas. Colocamos marcadores sobre os lançamentos nas métricas críticas principais, o que é muito indicativo em caso de problemas.
Dessa forma, conseguimos ver a correlação entre os novos lançamentos e os problemas que surgem. A ideia principal é entender como o sistema funciona em todas as camadas, localizar rapidamente um problema e corrigi-lo com a mesma rapidez. Afinal, muitas vezes, o que mais consome tempo não é resolver o problema, mas encontrar a causa.
E nesse sentido, no futuro, queremos nos concentrar na proatividade. Idealmente, gostaríamos de ser notificados antecipadamente sobre um problema iminente, e não depois que já ocorreu, para que possamos prevenir, em vez de resolver. Às vezes, ocorrem falsos alarmes no sistema de monitoramento, tanto devido a erros humanos quanto a mudanças no aplicativo. Estamos trabalhando nisso, ajustando, e tentando avisar os usuários que utilizam o sistema de monitoramento junto conosco antes de qualquer manipulação, ou realizando essas atividades em janelas de manutenção.
Assim, o sistema foi lançado e está funcionando com sucesso desde o início da primavera... e mostra um lucro bem real. Claro, esta não é sua versão final, ainda implantaremos muitas funcionalidades úteis. Mas, neste momento, com tantas integrações e aplicativos, não é possível lidar sem automação de monitoramento.
Se você também monitora grandes projetos com um número significativo de integrações, escreva nos comentários qual solução eficaz você encontrou para isso.
Fonte: habr.com
