

Vamos considerar o conceito de monitoramento do Kubernetes, conheceremos a ferramenta Prometheus e discutiremos sobre alertas.
O tema do monitoramento é amplo, não pode ser completamente abordado em um único artigo. O objetivo deste texto é fornecer uma visão geral das ferramentas, conceitos e abordagens.
O conteúdo deste artigo é um resumo de . Se você deseja fazer um curso completo — inscreva-se no curso de .
O que monitorar em um cluster Kubernetes
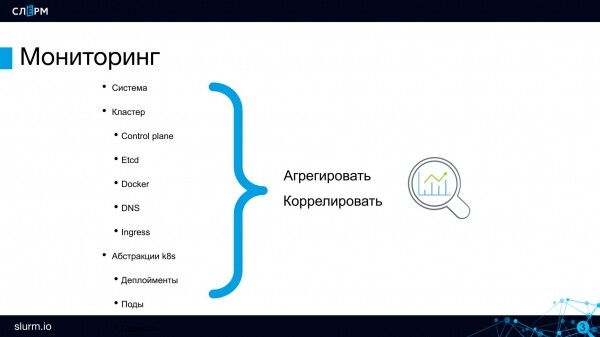
Servidores físicos. Se o cluster Kubernetes estiver implantado em seus próprios servidores, é necessário monitorar a saúde deles. Essa tarefa é realizada pelo Zabbix; se você já está utilizando, não há necessidade de desistir, não haverá conflitos. O Zabbix é responsável por monitorar o estado dos nossos servidores.
Vamos passar para o monitoramento a nível de cluster.
Componentes do Control Plane: API, Scheduler e outros. Pelo menos, é necessário monitorar para garantir que os servidores API ou etcd estejam sempre acima de 0. O etcd pode fornecer muitas métricas: sobre os discos nos quais está rodando, sobre a saúde do seu cluster etcd e outras.
Docker apareceu há muito tempo e seus problemas são bem conhecidos: muitos containers geram travamentos e outros problemas. Portanto, o próprio Docker, como sistema, também deve ser monitorado, mesmo que apenas para garantir sua disponibilidade.
DNS. Se o DNS falhar no cluster, todo o serviço de Discovery também falhará, impedindo a comunicação entre os pods. Na minha experiência, problemas desse tipo não ocorreram, mas isso não significa que não devemos monitorar a saúde do DNS. Atrasos nas consultas e algumas outras métricas podem ser rastreadas no CoreDNS.
Ingress. É preciso monitorar a disponibilidade dos ingressos (incluindo o Ingress Controller) como pontos de entrada no projeto.
Analisamos os principais componentes do cluster — agora vamos descer um nível, para o nível das abstrações.
À primeira vista, os aplicativos são executados em pods, então deveria-se monitorá-los, mas na verdade não é bem assim. Os pods são efêmeros: hoje estão funcionando em um servidor, amanhã em outro; hoje são 10, amanhã 2. Portanto, ninguém monitora apenas os pods. No contexto de uma arquitetura de microsserviços, é mais importante garantir a disponibilidade do aplicativo como um todo. Em particular, verificar a acessibilidade dos endpoints do serviço: algo está funcionando? Se o aplicativo estiver acessível, o que acontece por trás dele, quantas réplicas estão ativas — essas são questões de segundo plano. Monitorar instâncias individuais não é necessário.
No último nível, é necessário monitorar o funcionamento do próprio aplicativo, coletando métricas de negócios: número de pedidos, comportamento dos usuários e outros.
Prometheus
O melhor sistema para monitoramento de clusters é . Não conheço nenhuma ferramenta que possa se comparar ao Prometheus em termos de qualidade e facilidade de uso. Ele é excelente para uma infraestrutura flexível, então quando se fala em "monitoramento de Kubernetes", geralmente refere-se ao Prometheus.
Existem algumas opções para começar a trabalhar com o Prometheus: utilizando Helm, é possível instalar o Prometheus padrão ou o Prometheus Operator.
- Prometheus padrão. Funciona bem, mas é necessário configurar o ConfigMap — essencialmente, escrever arquivos de configuração de texto, como fazíamos antes, na era das arquiteturas de microsserviços.
- O Prometheus Operator é um pouco mais complexo, mas mais fácil de trabalhar: existem objetos separados, abstrações são adicionadas ao cluster, portanto, é muito mais conveniente controlá-las e configurá-las.
Para entender o produto, recomendo começar com o Prometheus padrão. Você terá que configurar tudo pelo arquivo de configuração, mas isso será benéfico: você entenderá o que se relaciona e como se configura. No Prometheus Operator, você já começa em um nível de abstração mais alto, embora também seja possível se aprofundar nas questões mais técnicas, se desejar.
O Prometheus se integra bem ao Kubernetes: pode fazer chamadas ao API Server e interagir com ele.
O Prometheus é popular, por isso é suportado por um grande número de aplicações e linguagens de programação. O suporte é necessário, pois o Prometheus possui seu próprio formato de métricas, e para sua transmissão é necessária uma biblioteca dentro da aplicação ou um exportador pré-pronto. E existem muitos desses exportadores. Por exemplo, há o PostgreSQL Exporter: ele coleta dados do PostgreSQL e os converte para o formato do Prometheus, permitindo que o Prometheus trabalhe com eles.
Arquitetura do Prometheus
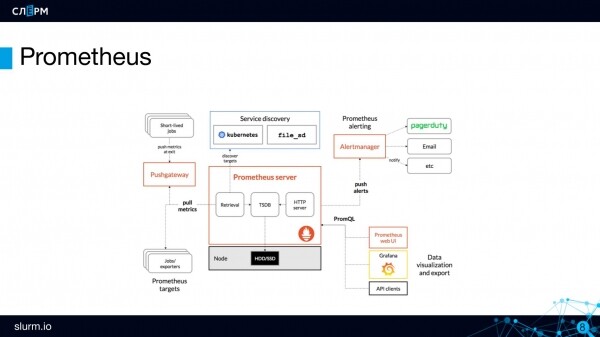
Servidor Prometheus — é a parte do servidor, o cérebro do Prometheus. Aqui são armazenadas e processadas as métricas.
As métricas são armazenadas em um banco de dados de séries temporais (TSDB). TSDB não é um banco de dados separado, mas um pacote na linguagem Go, incorporado ao Prometheus. Em termos simples, tudo está em um único binário.
Não armazene dados no TSDB por muito tempo.
A infraestrutura do Prometheus não é adequada para o armazenamento prolongado de métricas. Por padrão, o período de retenção é de 15 dias. É possível ultrapassar esse limite, mas deve-se ter em mente: quanto mais dados você armazenar no TSDB e quanto mais tempo você o fizer, mais recursos ele consumirá. Armazenar dados históricos no Prometheus é considerado uma má prática.
Se você tem um tráfego enorme, com o número de métricas contando em centenas de milhares por segundo, é melhor limitar o armazenamento por volume de disco ou por tempo. Normalmente, os dados "quentes" são armazenados no TSDB, métricas que são geradas em questão de horas. Para armazenamento mais prolongado, utilizam-se repositórios externos em bancos de dados realmente adequados para isso, como InfluxDB, ClickHouse, e assim por diante. Recebi mais comentários positivos sobre o ClickHouse.
O Prometheus Server opera no modelo pull: ele busca as métricas nos endpoints que lhe fornecemos. Dizemos: "vá para o API Server", e ele vai lá a cada n segundos e coleta as métricas.
Para objetos com curta duração de vida (job ou cron job), que podem aparecer entre períodos de scraping, há um componente chamado Pushgateway. Nele, as métricas de objetos de curto prazo são enviadas: o job inicia, executa uma ação, envia métricas para o Pushgateway e termina. Após algum tempo, o Prometheus vai até lá e coleta essas métricas do Pushgateway.
Para a configuração de notificações no Prometheus, existe um componente separado — Alertmanager. E as regras de alerta — regras de alerting. Por exemplo, é necessário criar um alerta caso os servidores API retornem 0. Quando o evento ocorre, o alerta é transmitido para o gerenciador de alertas para posterior envio. O gerenciador de alertas possui configurações de roteamento bastante flexíveis: um grupo de alertas pode ser enviado para um chat no Telegram dos administradores, outro para o chat dos desenvolvedores, e um terceiro para o chat da equipe de infraestrutura. As notificações podem chegar pelo Slack, Telegram, por e-mail e em outros canais.
E, por último, vou falar sobre o recurso killer do Prometheus — Discovering. Ao trabalhar com o Prometheus, não é necessário especificar endereços concretos de objetos para monitoramento, basta definir seu tipo. Ou seja, não é preciso escrever "aqui está o IP, aqui está a porta — monitore", em vez disso, é necessário determinar quais princípios usar para encontrar esses objetos (targets — alvos). O Prometheus, dependendo de quais objetos estão ativos no momento, puxa automaticamente os necessários e os adiciona à monitoração.
Essa abordagem se encaixa bem na estrutura do Kubernetes, onde tudo muda: hoje há 10 servidores, amanhã 3. Para não ter que indicar o IP do servidor a cada vez, descrevemos uma vez como localizá-lo — e o Discovering faz isso.
A linguagem do Prometheus se chama PromQL. Com essa linguagem, é possível extrair valores de métricas específicas e depois transformá-los, construindo análises a partir deles.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Uma consulta simples

    container_memory_usage_bytes

Operações matemáticas

    container_memory_usage_bytes / 1024 / 1024

Funções embutidas

    sum(container_memory_usage_bytes) / 1024 / 1024

Esclarecimento da consulta

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Interface web do Prometheus
O Prometheus possui uma interface web bastante minimalista. É adequada apenas para depuração ou demonstrações.
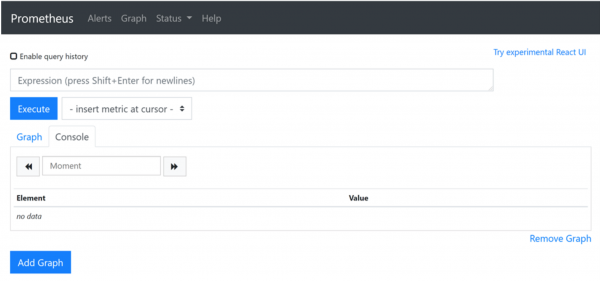
Na linha Expression, pode-se escrever consultas na linguagem PromQL.
Na aba Alerts, estão as regras de alerta — alerting rules, e elas possuem três status:
- inactive — se o alerta não está ativo no momento, ou seja, tudo está bem e ele não disparou;
- pending — isso ocorre se o alerta disparou, mas a notificação ainda não foi enviada. O atraso é configurado para compensar oscilações na rede: se, em um minuto, o serviço especificado foi retomado, não é necessário soar o alarme ainda;
- firing — este é o terceiro status, quando o alerta dispara e envia mensagens.
No menu Status você encontrará acesso às informações sobre o que é o Prometheus. Lá também há um link para os targets, sobre os quais falamos anteriormente.
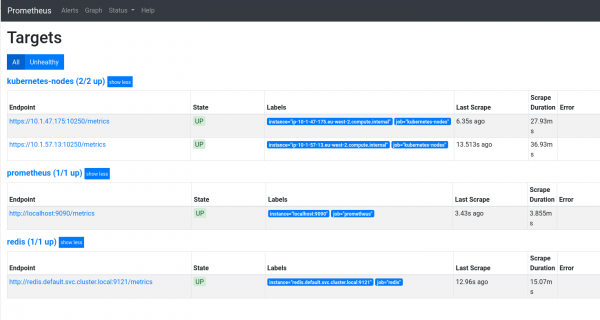
Uma visão mais detalhada da interface do Prometheus pode ser encontrada .
Integração com o Grafana
Na interface web do Prometheus você não encontrará gráficos bonitos e claros, de onde se pode deduzir o estado do cluster. Para construí-los, o Prometheus se integra ao Grafana. Resultado: painéis como este.
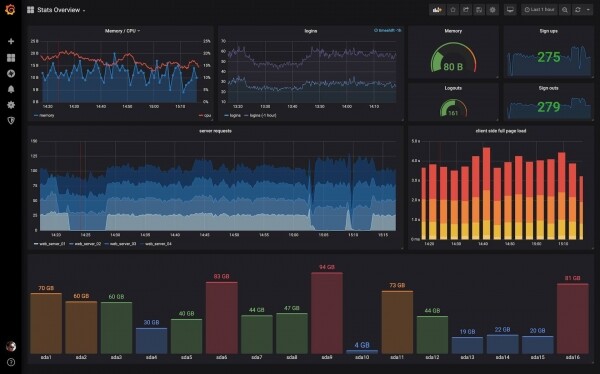
Configurar a integração entre Prometheus e Grafana não é difícil, as instruções podem ser encontradas na documentação: , e eu vou encerrar por aqui.
Nos próximos artigos, continuaremos o tema de monitoramento: falaremos sobre coleta e análise de logs utilizando Grafana Loki e ferramentas alternativas.
Autor: Marcel Ibraev, administrador Kubernetes certificado, engenheiro prático na empresa , palestrante e desenvolvedor dos cursos do Slyrm.
Fonte: habr.com
