

Nossa empresa atua desde 2008, principalmente na gestão de infraestruturas e no suporte técnico 24/7 para projetos web: temos mais de 400 clientes, o que representa cerca de 15% do comércio eletrônico da Rússia. Portanto, na área de suporte, lidamos com uma arquitetura bastante diversificada. Se algo falha, somos obrigados a consertá-lo em até 15 minutos. Mas para entender que um acidente ocorreu, é preciso monitorar o projeto e reagir a incidentes. Mas como fazer isso?
Acredito que, na organização de um sistema de monitoramento adequado, ocorra uma falha. Se não houvesse essa falha, meu discurso consistiria em um único ponto: "Por favor, instale Prometheus + Grafana e os plugins 1, 2, 3". Infelizmente, agora isso não funciona assim. E o principal problema é que todos continuam acreditando em algo que existia em 2008, no que diz respeito aos componentes de software.
Em relação à organização do sistema de monitoramento, arrisco dizer que... projetos com monitoramento adequado não existem. E a situação é tão ruim que, se algo falhar, há o risco de isso passar despercebido — afinal, todos acreditam que "tudo está sendo monitorado".
Talvez tudo esteja sendo monitorado. Mas como?
Todos nós já nos deparamos com uma história semelhante: um devops, um administrador, e eles são abordados pela equipe de desenvolvedores que diz — "fizemos o release, agora monitore". O que devemos monitorar? Como isso funciona?
Ok. Estamos monitorando da velha maneira. Mas já mudou, e descobre-se que você estava monitorando o serviço A, que se tornou o serviço B, que interage com o serviço C. Mas a equipe de desenvolvedores diz: "Instale o software, ele deve monitorar tudo!"
Então, o que mudou? — Tudo mudou!
2008. Tudo perfeito.
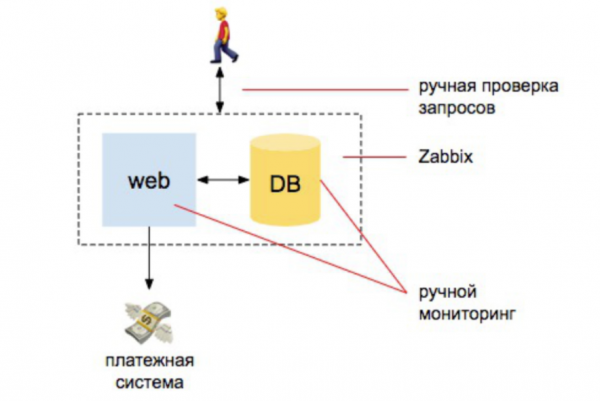
Há alguns desenvolvedores, um servidor, um servidor de banco de dados. A partir daí tudo começa. Temos algumas informações, instalamos Zabbix, Nagios, Cacti. E então configuramos alertas claros para CPU, funcionamento dos discos, espaço em disco. Também fazemos alguns checagens manuais para verificar se o site está respondendo, se os pedidos estão chegando ao banco de dados. E é isso – estamos mais ou menos protegidos.
Ao comparar o volume de trabalho que o administrador realizava para garantir a monitorização, 98% era automático: a pessoa responsável pela monitorização precisava entender como instalar o Zabbix, como configurá-lo e ajustar os alertas. E 2% eram dedicados a verificações externas: se o site respondia e fazia consultas ao banco, se novos pedidos chegavam.
Ano de 2010. A carga está aumentando.
Começamos a escalar os sites, adicionando um mecanismo de busca. Queremos ter certeza de que o catálogo de produtos contém todos os itens. E que a busca de produtos funciona. Que o banco de dados está operando, que os pedidos estão sendo feitos, que o site responde externamente e responde com dois. servidores e o usuário não é desconectado do site enquanto é reequilibrado para outro servidor, etc. O número de entidades está aumentando.
Além disso, a entidade relacionada à infraestrutura continua sendo a maior na mente do gerente. A ideia de que a pessoa responsável pela monitorização é quem instala o Zabbix e consegue configurá-lo ainda persiste.
Mas ao mesmo tempo surgem trabalhos para conduzir verificações externas, para criar um conjunto de scripts de consulta para o indexador de busca, um conjunto de scripts para verificar se a busca muda durante a indexação, um conjunto de scripts que conferem se os produtos estão sendo enviados para o serviço de entrega, etc.
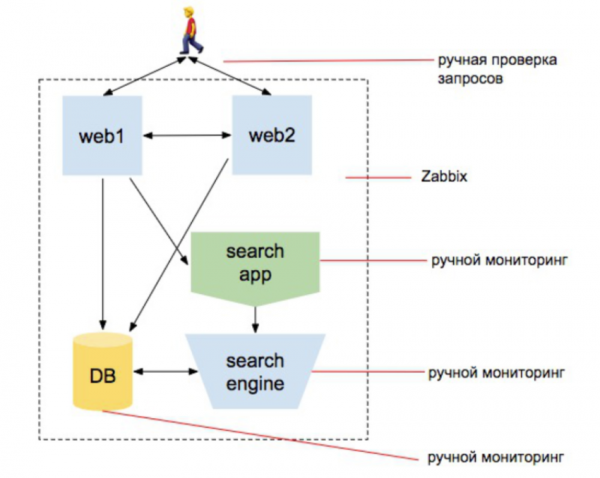
Note que eu escrevi "conjunto de scripts" três vezes. Ou seja, o responsável pela monitorização não é mais apenas quem instala o Zabbix. É alguém que começa a programar. Mas na cabeça da equipe, nada ainda mudou.
No entanto, o mundo está mudando, tornando-se cada vez mais complexo. Adiciona-se uma camada de virtualização, vários novos sistemas. Eles começam a interagir entre si. Quem disse "cheira a microsserviços?" Mas cada serviço ainda parece, por si só, um site separado. Podemos acessá-lo e entender que ele fornece as informações necessárias e funciona por conta própria. E se você é um administrador, lidando constantemente com um projeto que está se desenvolvendo por 5-7-10 anos, você acumula esses conhecimentos: um novo nível surge - você o percebe, e outro nível surge - você o percebe...
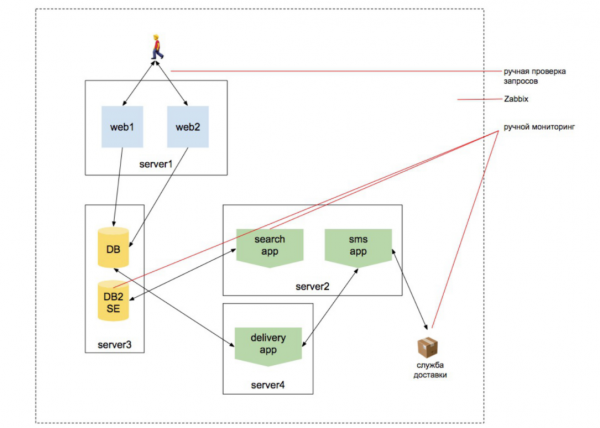
Mas raramente alguém mantém um projeto por 10 anos.
Resumo do monitoramento
Suponhamos que você entrou em uma nova startup que rapidamente reuniu 20 desenvolvedores, escreveu 15 microsserviços, e você é o administrador que diz: "Construa CI/CD. Por favor". Você construiu o CI/CD e de repente ouve: "É difícil trabalharmos com produção no 'kube', sem entender como a aplicação funcionará nele. Crie um sandbox nesse mesmo 'kube'."
Você cria um sandbox nesse kube. Eles imediatamente dizem: "Queremos um banco de dados de stage que seja atualizado diariamente com a produção, para entender se isso funciona no banco de dados, mas sem prejudicar o banco de dados de produção."
Você vive tudo isso. Faltam 2 semanas para o lançamento e eles dizem: "Agora precisamos monitorar tudo isso..." Ou seja, monitorar a infraestrutura em cluster, monitorar a arquitetura de microsserviços, monitorar a interação com serviços externos...
E os colegas tiram de sua mente um esquema habitual e dizem: "Aqui está tudo claro! Instale um programa que faça essa monitoração". Sim, Sim: Prometheus + Grafana + plugins.
E acrescentam: "Você tem duas semanas, faça com que tudo seja confiável".
Em muitos projetos que vemos, destaca-se uma pessoa apenas para a monitoração. Imagine que queremos contratar uma pessoa por 2 semanas para se dedicar à monitoração e estamos elaborando seu currículo. Quais habilidades essa pessoa deve ter, considerando tudo o que dissemos até agora?
- Ela deve entender a monitoração e a especificidade da operação da infraestrutura física.
- Ela deve entender as especificidades da monitoração do Kubernetes (todos querem ir para o 'kube', porque pode-se abstrair tudo, esconder-se, já que o administrador resolverá o resto) — e do Kubernetes em si, sua infraestrutura, e compreender como monitorar aplicações dentro dele.
- Ela deve entender que os serviços se comunicam de maneiras específicas, e conhecer as características da interação entre serviços. É comum ver um projeto onde parte dos serviços se comunicam de forma síncrona, porque de outra forma não há como. Por exemplo, o backend usa REST, vai ao serviço de catálogo via gRPC, obtém uma lista de produtos e retorna. Aqui não há como esperar. Com outros serviços, ele trabalha de forma assíncrona. Enviar um pedido para o serviço de entrega, enviar um e-mail, etc.
Você, provavelmente, já está perdido com tudo isso? E o administrador que precisa monitorar isso está ainda mais perdido. - Ele deve saber planejar e planejar corretamente — à medida que o trabalho vai aumentando.
- Portanto, ele precisa criar uma estratégia para o serviço criado para entender como monitorá-lo especificamente. É necessário um entendimento da arquitetura do projeto e seu desenvolvimento, além de compreender as tecnologias utilizadas no desenvolvimento.
Vamos lembrar de um caso absolutamente normal: parte dos serviços em PHP, parte em Go, parte em JS. Eles trabalham juntos de alguma forma. Daí vem o termo 'microsserviço': o número de sistemas distintos se tornou tão grande que os desenvolvedores não conseguem entender o projeto como um todo. Uma parte da equipe escreve serviços em JS, que funcionam de forma independente e não sabem como o restante do sistema funciona. Outra parte escreve serviços em Python e não se envolve em como os outros serviços funcionam; eles estão isolados em sua própria área. A terceira parte escreve serviços em PHP ou em outra linguagem.
Todas essas 20 pessoas estão divididas em 15 serviços, e há apenas um administrador que deve entender tudo isso. Espera aí! Acabamos de dividir o sistema em 15 microsserviços, porque 20 pessoas não conseguem compreender o sistema inteiro.
Mas isso precisa ser monitorado de alguma forma...
E no final? No final, há uma única pessoa que armazena tudo o que uma equipe inteira de desenvolvedores não consegue entender, e ainda assim, essa pessoa precisa saber e ser capaz do que mencionamos acima — infraestrutura de hardware, infraestrutura Kubernetes, etc.
O que dizer... Houston, temos um problema.
O monitoramento de um projeto de software moderno é, por si só, um projeto de software.
A partir da falsa confiança de que monitoramento é software, surge a crença em milagres. E milagres, infelizmente, não existem. Não se pode instalar o Zabbix e esperar que tudo funcione. Não faz sentido instalar o Grafana e esperar que tudo fique bem. A maior parte do tempo será gasta organizando verificações de como os serviços funcionam e sua interação entre si, além das verificações de como os sistemas externos funcionam. Faticamente, 90% do tempo será gasto não na escrita de scripts, mas no desenvolvimento de software. E essa tarefa deve ser realizada por uma equipe que compreenda o funcionamento do projeto.
Se nessa situação uma única pessoa for encarregada do monitoramento, ocorrerá um desastre. E isso acontece em toda parte.
Por exemplo, existem vários serviços que se comunicam entre si através do Kafka. Um pedido chegou, enviamos a mensagem do pedido para o Kafka. Há um serviço que escuta as informações sobre o pedido e realiza a entrega do produto. Há um serviço que escuta as informações sobre o pedido e envia um e-mail ao usuário. E então surgem muitos outros serviços, e começamos a nos confundir.
E se você ainda entregar isso ao administrador e aos desenvolvedores na fase em que falta pouco para o lançamento, a pessoa precisará entender todo esse protocolo. Ou seja, um projeto dessa magnitude leva um tempo considerável, e isso deve ser considerado no desenvolvimento do sistema.
Mas muito frequentemente, especialmente no início, em startups, vemos como a monitoração é adiada. "Agora vamos fazer o Proof of Concept, lançaremos com ele, que ele caia – estamos prontos para sacrificar. E depois, nós monitoraremos tudo isso". Quando (ou se) o projeto começa a gerar receita, os negócios querem adicionar ainda mais recursos — porque começou a funcionar, então é preciso continuar desenvolvendo! E você está em um ponto em que primeiro precisa monitorar tudo o que foi feito anteriormente, o que leva muito mais do que 1% do tempo. E, a propósito, para a monitoração, serão necessários desenvolvedores, e é mais fácil direcioná-los para novos recursos. No final, novos recursos são desenvolvidos, tudo é ampliado, e você se encontra em um deadlock infinito.
Então, como monitorar um projeto desde o início, e o que fazer se você recebeu um projeto que precisa ser monitorado, mas não sabe por onde começar?
Em primeiro lugar, é necessário planejar.
Um desvio lírico: muito frequentemente, começa-se pela monitoração da infraestrutura. Por exemplo, temos Kubernetes. Vamos começar instalando o Prometheus com o Grafana, instalaremos plugins para monitorar o 'cubinho'. Não apenas os desenvolvedores, mas também os administradores têm a triste prática de: 'Vamos instalar este plugin, e o plugin provavelmente sabe como fazer isso'. As pessoas gostam de começar com etapas simples e compreensíveis, e não com ações importantes. E a monitoração da infraestrutura é apenas isso.
Para começar, decida o que e como deseja monitorar, e depois escolha a ferramenta, pois outras pessoas não podem pensar por você. E deveriam mesmo? Outras pessoas pensaram em si mesmas, em um sistema universal — ou não pensaram, quando escreveram este plugin. E o fato de que este plugin tem 5 mil usuários não significa que ele traz algum benefício. Talvez você se torne o 5001º apenas porque já havia 5000 pessoas antes.
Se você começou a monitorar a infraestrutura e o backend do seu aplicativo parou de responder, todos os usuários perderão a conexão com o aplicativo móvel. Vai aparecer um erro. Eles vão até você e dirão "O aplicativo não funciona, o que você está fazendo aqui?" — "Estamos monitorando." — "Como vocês estão monitorando se não veem que o aplicativo não está funcionando?!"
- Eu acredito que o monitoramento deve começar exatamente no ponto de entrada do usuário. Se o usuário não vê que o aplicativo está funcionando — já era, isso é um fracasso. E o sistema de monitoramento deve avisar sobre isso em primeiro lugar.
- E só depois podemos monitorar a infraestrutura. Ou fazer isso em paralelo. Com a infraestrutura é mais simples — aqui finalmente podemos apenas instalar o zabbix.
- E agora precisamos ir às raízes do aplicativo para entender onde as coisas não estão funcionando.
Minha principal ideia é que o monitoramento deve ocorrer em paralelo com o processo de desenvolvimento. Se você desviar a equipe de monitoramento para outras tarefas (como criar CI/CD, um sandbox, reorganizar a infraestrutura), o monitoramento começará a ficar para trás e, possivelmente, você nunca conseguirá acompanhá-lo com o desenvolvimento (ou cedo ou tarde terá que interromper o desenvolvimento).
Tudo por níveis
Veja como eu imagino a organização do sistema de monitoramento.
1) Nível do aplicativo:
- monitoramento da lógica de negócios do aplicativo;
- monitoramento das métricas de saúde dos serviços;
- monitoramento de integração.
2) Nível da infraestrutura:
- monitoramento do nível de orquestração;
- monitoramento do software de sistema;
- monitoramento do nível de hardware.
3) Novamente o nível do aplicativo — mas agora como um produto de engenharia:
- coleta e observação de logs do aplicativo;
- APM;
- tracing.
4) Alerta:
- organização do sistema de aviso;
- organização do sistema de plantão;
- organização da "base de conhecimento" e do fluxo de trabalho para o tratamento de incidentes.
Importante: chegamos à alertagem não depois, mas imediatamente! Não é necessário iniciar o monitoramento e pensar em quem receberá os alertas “mais tarde”. Afinal, qual é a finalidade do monitoramento: entender onde algo não está funcionando bem no sistema e informar as pessoas certas sobre isso. Se deixarmos para o final, as pessoas certas só saberão que algo está errado quando receberem a ligação “nada está funcionando”.
Nível de aplicativo — monitoramento da lógica de negócios
Aqui falamos sobre a verificação do próprio fato de que o aplicativo está funcionando para o usuário.
Esse nível deve ser implementado na fase de desenvolvimento. Por exemplo, temos um Prometheus hipotético: ele acessa o servidor que realiza as verificações, chama um endpoint, e esse endpoint verifica a API.
Quando frequentemente pedem para monitorar a página inicial para garantir que o site está funcionando, os programadores fornecem um endpoint que pode ser chamado sempre que é necessário verificar se a API está funcionando. E os programadores naquele momento ainda criam /api/test/helloworld.
A única maneira de ter certeza de que tudo está funcionando? — Não!
- Criar essas verificações é, essencialmente, uma tarefa para os desenvolvedores. Testes unitários devem ser escritos por programadores que estão criando o código. Porque, se você passar isso para o administrador “Cara, aqui está a lista de protocolos da API de todas as 25 funções, por favor, monitore tudo!” — nada sairá certo.
- Se você fizer print “hello world”, ninguém jamais saberá que a API deveria e de fato está funcionando. Cada mudança na API deve levar à modificação das verificações.
- Se você já está nessa situação – pare as funcionalidades e aloque desenvolvedores para escrever essas verificações, ou se conforma com as perdas, aceita que nada será verificado e que cairá.
Dicas técnicas:
- Certifique-se de organizar um servidor externo para realizar as verificações — você deve ter certeza de que seu projeto está acessível para o mundo externo.
- Organize a verificação em todo o protocolo da API, e não apenas em endpoints específicos.
- Crie um endpoint prometheus com os resultados das verificações.
Nível de aplicativo — monitoramento de métricas de saúde
Agora falamos sobre métricas de saúde externas dos serviços.
Decidimos que todos os “endpoints” da aplicação devem ser monitorados com verificações externas, que chamamos de um sistema de monitoramento externo. Mas são precisamente os “endpoints” que o usuário “vê”. Queremos ter certeza de que nossos serviços estão funcionando. Aqui a história é um pouco melhor: no K8s existem verificações de saúde para que pelo menos o próprio “cubinho” assegure que o serviço está ativo. Mas metade das verificações que vi é a mesma impressão de “hello world”. Ou seja, ele chama uma vez após a implantação, recebe a confirmação de que está tudo bem — e é isso. E um serviço, se ele fornece sua API via REST, tem uma enorme quantidade de pontos de entrada dessa mesma API, que também precisam ser monitorados, porque queremos saber se está funcionando. E nós o monitoramos internamente.
Como implementar isso corretamente do ponto de vista técnico: cada serviço deve expor um endpoint sobre seu estado atual, e nos gráficos do Grafana (ou de qualquer outra aplicação) vemos o status de todos os serviços.
- Cada mudança na API deve resultar em uma mudança nas verificações.
- Crie novos serviços imediatamente com métricas de saúde.
- Um administrador pode se aproximar dos desenvolvedores e pedir "adicionem algumas funcionalidades para que eu possa entender tudo e adicionar informações sobre isso ao meu sistema de monitoramento". Mas os desenvolvedores normalmente respondem: "Duas semanas antes do lançamento não vamos adicionar nada".
Deixem os gerentes de desenvolvimento saberem que haverá essas perdas, e que a gerência dos gerentes de desenvolvimento também deve estar ciente. Porque, quando tudo falhar, alguém vai ligar e exigir que monitoremos o "serviço que falha constantemente" (c). - A propósito, designem desenvolvedores para escrever plugins para o Grafana — isso será uma grande ajuda para os administradores.
Nível de aplicação — Monitoramento Integrado
O monitoramento integrado se concentra na fiscalização da comunicação entre sistemas críticos para os negócios.
Por exemplo, há 15 serviços que se comunicam entre si. Eles não são mais sites separados. Ou seja, não podemos apenas chamar um serviço, obter /helloworld e concluir que o serviço está funcionando. Porque o serviço de processamento de pedidos precisa enviar informações do pedido para o barramento — então, do barramento, o serviço de gerenciamento de estoque deve receber essa mensagem e continuar a trabalhar com ela. E o serviço de envio de e-mails deve processar isso de alguma forma, e assim por diante.
Portanto, não conseguimos entender, clicando em cada serviço individualmente, como tudo isso funciona. Porque temos um certo barramento, através do qual tudo se comunica e interage.
Assim, esta etapa deve representar o teste de serviços em interação com outros serviços. Não é possível, ao monitorar um corretor de mensagens, estabelecer um monitoramento da comunicação. Se há um serviço que fornece dados, e um serviço que os recebe, ao monitorar o corretor, veremos apenas os dados que vão de um lado para o outro. Mesmo que consigamos monitorar a interação desses dados internamente — que um produtor publica dados, e alguém os lê, esse fluxo continua indo para o Kafka — isso ainda não nos dará informações, se um serviço enviou uma mensagem em uma versão, e o outro serviço não esperava essa versão e a perdeu. Não saberemos disso, pois os serviços nos dirão que está tudo funcionando.
Como eu recomendo fazer:
- Para comunicação síncrona: o endpoint executa solicitações a serviços relacionados. Ou seja, pegamos este endpoint, executamos um script dentro do serviço que percorre todos os pontos e diz 'posso chamar aqui, e posso chamar ali, posso chamar aqui...'
- Para comunicação assíncrona: mensagens de entrada — o endpoint verifica o barramento em busca de mensagens de teste e fornece o status do processamento.
- Para comunicação assíncrona: mensagens de saída — o endpoint envia mensagens de teste para o barramento.
Como geralmente acontece: temos um serviço que envia dados para o barramento. Chegamos a esse serviço e pedimos para ele nos contar sobre sua saúde de integração. E se o serviço deve produzir alguma mensagem para algum lugar (WebApp), então ele produzirá essa mensagem de teste. E se chamamos o serviço do lado de OrderProcessing, ele primeiro publica o que pode publicar independente, e se há alguma coisa dependente — ele lê do barramento um conjunto de mensagens de teste, entende o que pode processar, informa sobre isso e, se necessário, publica adiante, e sobre isso ele diz — tudo ok, estou vivo.
Muitas vezes ouvimos a pergunta "como podemos testar isso com dados de produção?" Por exemplo, estamos falando do mesmo serviço de pedidos. O pedido envia mensagens para o armazém, onde os produtos são removidos: não podemos testar isso com dados de produção, porque "os meus produtos serão removidos!" A solução: no início, planeje todo esse teste. Você já tem testes unitários que fazem mocks. Então, faça isso em um nível mais profundo, onde você terá um canal de comunicação que não prejudicará o funcionamento do negócio.
Nível de infraestrutura
O monitoramento da infraestrutura é o que há muito é considerado o próprio monitoramento.
- O monitoramento da infraestrutura pode e deve ser iniciado como um processo separado.
- Não comece com o monitoramento da infraestrutura em um projeto em funcionamento, mesmo que você tenha muita vontade. É uma dor de cabeça para todos os DevOps. "Primeiro vou monitorar o cluster, depois a infraestrutura" - ou seja, ele vai monitorar o que está embaixo e não vai se preocupar com o aplicativo. Porque o aplicativo é uma coisa confusa para o DevOps. Ele recebeu isso, mas não entende como funciona. E ele entende a infraestrutura e começa por ela. Mas não — sempre é preciso monitorar o aplicativo primeiro.
- Não exagere na quantidade de alertas. Considerando a complexidade dos sistemas modernos, os alertas estão constantemente chegando, e é preciso conviver com essa avalanche. E a pessoa de plantão, ao olhar para uma centena de alertas, decidirá "não quero pensar sobre isso". Os alertas devem notificar apenas sobre coisas críticas.
Nível do aplicativo como unidade de negócio
Pontos-chave:
- ELK. Este é um padrão da indústria. Se, por algum motivo, você não está agregando logs, comece a fazê-lo urgentemente.
- APM. APM externos como uma forma de rapidamente cobrir o monitoramento do aplicativo (NewRelic, BlackFire, Datadog). Você pode instalar temporariamente essa ferramenta para entender o que está acontecendo.
- Tracing. Em dezenas de microsserviços, você deve rastrear tudo, porque a solicitação já não vive sozinha. Adicionar depois é muito difícil, então é melhor planejar o tracing no desenvolvimento desde o início — isso é um trabalho e uma ferramenta para os desenvolvedores. Se ainda não implantou, comece a implementar! Veja Jaeger/Zipkin.
Alertando
- Organização do sistema de notificações: em um ambiente de monitoramento de várias coisas, deve haver um sistema unificado de envio de alertas. Isso pode ser feito no Grafana. No Ocidente, todos usam o PagerDuty. Os avisos devem ser claros (por exemplo, de onde eles vêm...). E é desejável controlar se as notificações estão realmente chegando.
- Organização do sistema de plantões: os alertas não devem ser enviados a todos (caso contrário, todos reagirão em grupo ou ninguém reagirá). Os desenvolvedores também precisam estar em plantão: defina claramente as áreas de responsabilidade, elabore instruções claras e especifique a quem exatamente ligar na segunda e na quarta-feira, e a quem — na terça e na sexta (caso contrário, ninguém fará ligações, mesmo em caso de grande emergência — as pessoas têm medo de acordar ou incomodar os outros: elas realmente não gostam de ligar e acordar outras pessoas, especialmente à noite). E explique que pedir ajuda não é um sinal de incompetência ("eu estou pedindo ajuda — então sou um mal trabalhador"), incentive os pedidos de ajuda.
- Organização de uma "base de conhecimento" e fluxo de trabalho para tratamento de incidentes: para cada incidente sério, deve haver um post-mortem planejado. Como medida temporária, as ações que resolvem o incidente devem ser documentadas. E crie a prática de que alertas repetidos são um pecado; eles devem ser corrigidos no código ou nas operações de infraestrutura.
Pilha tecnológica
Vamos imaginar que nossa pilha é a seguinte:
- coleta de dados — Prometheus + Grafana;
- análise de logs — ELK;
- para APM ou Tracing — Jaeger (Zipkin).

A escolha das opções não é crítica. Porque, se você entendeu desde o início como monitorar o sistema e elaborou um plano, a partir daí você começa a escolher as ferramentas de acordo com suas necessidades. A questão é o que você escolheu monitorar inicialmente. Porque, talvez, a ferramenta que você escolheu no começo não se encaixe nas suas necessidades.
Alguns pontos técnicos que vejo em todo lugar ultimamente:
Prometheus sendo inserido dentro do Kubernetes — quem teve essa ideia?! Se o seu cluster cair, o que você fará? Se você tiver um cluster complexo por dentro, deve haver algum sistema de monitoramento dentro do cluster, e um outro — por fora, que colete dados do interior do cluster.
Dentro do cluster, coletamos logs e todo o resto. Mas o sistema de monitoramento deve estar externo. Muito frequentemente em um cluster onde há Prometheus instalado internamente, existem sistemas que realizam verificações externas do funcionamento do site. E se suas conexões com o mundo externo caírem e o aplicativo não funcionar? Aparentemente, tudo está bem internamente, mas isso não ajuda os usuários.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
- Desenvolver um monitoramento não é apenas instalar utilitários, mas sim desenvolver um produto de software. 98% do monitoramento atual é codificação. Codificação em serviços, codificação de verificações externas, verificações de serviços externos, e tudo mais.
- Não economize o tempo dos desenvolvedores em monitoramento: isso pode consumir até 30% do trabalho deles, mas vale a pena.
- DevOps, não se preocupe se vocês não conseguem monitorar algumas coisas, porque certos aspectos exigem uma mentalidade completamente diferente. Vocês não foram programadores, e o trabalho de monitoramento é exatamente deles.
- Se o projeto já estiver em funcionamento e não estiver monitorado (e você é o gerente) — direcione recursos para o monitoramento.
- Se o produto já está em produção e você é um devops que recebeu a tarefa de "configurar o monitoramento" — tente explicar à gerência o que eu escrevi aqui.
Esta é uma versão estendida da apresentação na conferência Saint Highload++.
Se você está interessado nas minhas ideias e reflexões sobre TI e temas relacionados, aqui você pode 🙂
Fonte: habr.com
