

Antecedentes
Temos máquinas de venda automática desenvolvidas internamente. Dentro delas estão Raspberry Pi e um pouco de hardware em uma placa separada. Estão conectados a um validador de moedas, um validador de notas, um terminal bancário... Tudo é controlado por um programa desenvolvido internamente. Todo o histórico de operação é gravado em um registro em um pen drive (MicroSD), que depois é transmitido pela internet (usando um modem USB) para um servidor, onde é armazenado em um banco de dados. As informações de vendas são carregadas no 1C, e também existe uma interface web simples para monitoramento, etc.
Ou seja, o registro é vital — para contabilidade (eletrificando a receita, vendas e assim por diante), monitoramento (diversas falhas e outros imprevistos); tudo isso é, de certa forma, toda a informação que temos sobre esta máquina.
O problema
Os pen drives se mostram como dispositivos muito pouco confiáveis. Eles falham com uma regularidade impressionante. Isso resulta tanto em inatividade das máquinas quanto (se, por algum motivo, o registro não puder ser transmitido online) em perda de dados.
Este não é o primeiro experimento com pen drives, antes houve outro projeto com mais de cem dispositivos, onde o registro era armazenado em pen drives USB, e lá também houve problemas de confiabilidade, às vezes o número de falhas por mês chegava a dezenas. Testamos várias marcas de pen drives, incluindo modelos de memória SLC, alguns modelos são mais confiáveis que outros, mas a troca dos pen drives não resolveu o problema de forma radical.
Atenção! Leitura longa! Se você não está interessado em "por que", mas apenas em "como", pode ir direto artigo.
Solução
A primeira ideia que vem à mente: abandonar o MicroSD, instalar, por exemplo, um SSD, e inicializar a partir dele. Teoricamente é possível, talvez, mas relativamente caro e não tão confiável (adiciona-se um adaptador USB-SATA; a estatística de falhas para SSDs de baixo custo também não é animadora).
Discos rígidos USB também não parecem uma solução muito atraente.
Portanto, chegamos a esta opção: manter a inicialização a partir do MicroSD, mas usá-los em modo somente leitura, e armazenar o registro de operação (e outras informações únicas para cada hardware — número de série, calibrações de sensores, etc.) em outro lugar.
O tema de sistemas de arquivos somente leitura para a Raspberry Pi já foi bastante estudado, não vou me aprofundar nos detalhes de implementação neste artigo. (mas se houver interesse — talvez eu escreva um mini-artigo sobre isso). Um ponto que gostaria de ressaltar: tanto pela experiência pessoal quanto pelas avaliações de quem já implementou, há um ganho em confiabilidade. Sim, é impossível se livrar completamente das falhas, mas é bem viável reduzir a frequência delas. Além disso, os cartões estão se tornando padronizados, o que simplifica bastante a substituição para a equipe de manutenção.
Hardware
Não houve grandes dúvidas sobre o tipo de memória — NOR Flash.
Argumentos:
- conexão simples (na maioria das vezes pela interface SPI, cujo uso já temos experiência, então não há problemas de hardware previsíveis);
- preço acessível;
- protocolo padrão de operação (a implementação já existe no núcleo Linux, se desejado, é possível usar soluções de terceiros, que também estão disponíveis, ou até mesmo escrever a sua, visto que tudo é simples);
- confiabilidade e durabilidade:
do datasheet típico: os dados são armazenados por 20 anos, 100.000 ciclos de apagamento para cada bloco;
de fontes externas: taxa de erro muito baixa, postulando a ausência de necessidade de códigos de correção de erros (em alguns trabalhos se considera ECC para NOR, mas geralmente se refere a MLC NOR, que também existe).
Vamos estimar os requisitos de volume e durabilidade.
Gostaria que os dados fossem garantidamente mantidos por vários dias. Isso é necessário para que, em caso de qualquer problema de comunicação, a história das vendas não seja perdida. Vamos nos orientar para 5 dias, nesse período (mesmo considerando fins de semana e feriados) é possível resolver o problema.
Atualmente, acumulamos cerca de 100 KB de registro por dia (3-4 mil entradas), porém esse número está crescendo gradualmente — a detalhação está aumentando, novos eventos estão sendo adicionados. Além disso, às vezes ocorrem picos (algum sensor começa a disparar falsos positivos, por exemplo). Vamos considerar 10 mil entradas de 100 bytes — 1 megabyte por dia.
No total, temos 5 MB de dados limpos (bem compactáveis). A isso ainda (estimativa grosseira) 1 MB de dados de serviço.
Ou seja, precisamos de um chip de 8 MB se não usarmos compressão, ou de 4 MB se utilizarmos. Números bastante razoáveis para esse tipo de memória.
Quanto à durabilidade: se planejarmos que a memória seja reescrita no máximo uma vez a cada 5 dias, ao longo de 10 anos de operação, teremos menos de mil ciclos de regravação.
Lembro que o fabricante promete cem mil.
Um pouco sobre NOR vs NAND
Hoje, certamente, a memória NAND é muito mais popular, mas para este projeto eu não a utilizaria: a NAND, ao contrário da NOR, exige obrigatoriamente o uso de códigos de correção de erros, tabelas de blocos defeituosos etc., e as fichas da NAND geralmente têm muitos mais pinos.
Quanto às desvantagens da NOR, podemos apontar:
- pequena capacidade (e, consequentemente, alto custo por megabyte);
- baixa velocidade de transferência (muito devido ao uso de uma interface serial, geralmente SPI ou I2C);
- apaga lento (dependendo do tamanho do bloco, pode levar de frações de segundo a vários segundos).
Parece que não há nada crítico para nós, então vamos continuar.
Se você estiver interessado nos detalhes, o chip escolhido foi (no entanto, isso não é essencial, há muitos análogos no mercado, compatíveis em pinagem e sistema de comandos; mesmo que decidamos usar um chip de outro fabricante e/ou de outra capacidade, tudo funcionará sem alteração do código).
Eu uso o driver embutido no núcleo Linux, na Raspberry, graças ao suporte do device tree overlay, é tudo muito simples — basta colocar o overlay compilado em /boot/overlays e modificar um pouco o /boot/config.txt.
Exemplo de arquivo dts
Honestamente, não tenho certeza se está escrito sem erros, mas funciona.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
E mais uma linha no config.txt
dtoverlay=at25:spimaxfrequency=50000000Vou omitir a descrição da conexão do chip ao Raspberry Pi. Por um lado, não sou especialista em eletrônica, por outro, é tudo banal até para mim: o chip tem apenas 8 pinos, dos quais precisamos de terra, alimentação, SPI (CS, SI, SO, SCK); os níveis coincidem com os do Raspberry Pi, não é necessário nenhum circuito adicional — basta conectar os 6 pinos indicados.
Formulação do problema
Como de costume, a definição da tarefa passa por várias iterações, e acho que chegou a hora de mais uma. Portanto, vamos parar, reunir o que já foi escrito e esclarecer os detalhes que ainda estão obscuros.
Assim, decidimos que o log será armazenado na SPI NOR Flash.
O que é NOR Flash para quem não sabe
É uma memória não volátil, com a qual podemos realizar três operações:
- Leitura:
A mais comum leitura: passamos o endereço e lemos quantos bytes precisamos; - Gravação:
A gravação na memória NOR flash parece normal, mas tem uma particularidade: só é possível mudar 1 para 0, mas não o contrário. Por exemplo, se tivermos 0x55 armazenado na célula de memória, após gravar 0x0f, ela conterá 0x05. (veja a tabela um pouco abaixo); - Apagar:
Naturalmente, também precisamos ser capazes de realizar a operação inversa — mudar 0 para 1; para isso existe a operação de apagar. Ao contrário das duas primeiras, ela opera em blocos, não em bytes (o bloco mínimo de apagamento na microcircuito escolhido é de 4 kb). Apagar destrói o bloco inteiro e é a única maneira de mudar 0 para 1. Portanto, ao trabalhar com memória flash, muitas vezes é necessário alinhar as estruturas de dados na borda do bloco de apagar.
Gravação na NOR Flash:
Dados binários
Foi
01010101
Gravado
00001111
Tornou-se
00000101
O próprio log representa uma sequência de gravações de comprimento variável. O comprimento típico de uma gravação é de cerca de 30 bytes (embora, às vezes, ocorram gravações com vários kilobytes de comprimento). Neste caso, lidamos com eles simplesmente como um conjunto de bytes, mas, se houver interesse, dentro das gravações é utilizado CBOR.
Além do log, precisamos armazenar algumas informações de 'configuração', tanto atualizáveis quanto não: um certo ID do dispositivo, calibrações de sensores, um sinalizador de 'dispositivo temporariamente desligado', etc.
Essas informações consistem em um conjunto de gravações key-value, também armazenadas em CBOR. Temos uma quantidade relativamente pequena dessa informação (no máximo alguns kilobytes), que não é atualizada com frequência.
No futuro, nos referiremos a isso como contexto.
Se lembrarmos de como começou este artigo, é extremamente importante garantir a confiabilidade do armazenamento de dados e, sempre que possível, a operação contínua, mesmo em caso de falhas de hardware/danos aos dados.
Que fontes de problemas podemos considerar?
- Desligamento de energia durante as operações de gravação/apagamento. Isso é algo como 'não há remédio contra armadilha'.
Informação de stackexchange: durante o desligamento de energia enquanto se trabalha com flash, tanto apagar (definindo para 1) quanto gravar (definindo para 0) levam a um comportamento indefinido: os dados podem ser gravados, gravados parcialmente (digamos, enviamos 10 bytes/80 bits, mas apenas 45 bits conseguiram ser gravados), e não se pode excluir a possibilidade de que parte dos bits fique em um estado 'intermediário' (a leitura pode retornar tanto 0 quanto 1); - Erros da própria memória flash.
O BER, embora muito baixo, não pode ser igual a zero; - Erros na linha de transmissão.
Os dados transmitidos por SPI não estão protegidos de forma alguma, podem ocorrer tanto erros de bit isolados quanto erros de sincronização — perda ou inserção de bits (o que leva a distorções massivas de dados); - Outros erros/falhas
Erros de código, ‘glitches’ do Raspberry, intervenção de alienígenas...
Eu formulei os requisitos que, na minha opinião, são necessários para garantir a confiabilidade:
- as gravações devem ser armazenadas na memória flash imediatamente, gravação em atraso não é considerada; - se um erro ocorrer, ele deve ser detectado e tratado o mais cedo possível; - o sistema deve ser capaz de se recuperar após erros.
(exemplo da vida real ‘como não deve ser’, com o qual acredito que todos já se depararam: após uma reinicialização forçada, o sistema de arquivos foi corrompido e o sistema operacional não inicializa)
Ideias, abordagens, reflexões
Quando comecei a pensar sobre essa tarefa, muitas ideias passaram pela minha mente, por exemplo:
- usar compressão de dados;
- usar estruturas de dados engenhosas, por exemplo, armazenar cabeçalhos de registros separadamente dos próprios registros, para que, em caso de erro em algum registro, seja possível ler os demais sem problemas;
- usar campos de bits para controlar a conclusão do registro durante a queda de energia;
- armazenar somas de verificação para tudo e todos;
- usar alguma variedade de codificação de correção de erros.
Parte dessas ideias foi utilizada, e parte foi decidida por descartar. Vamos por partes.
Compressão de dados
Os eventos que registramos no log são bastante homogêneos e repetitivos (‘jogou uma moeda de 5 reais’, ‘pressionou o botão de devolução’, ...). Portanto, a compressão deve ser bastante eficaz.
Os custos de compressão não são significativos (nosso processador é bastante poderoso, mesmo no primeiro Pi havia um núcleo com frequência de 700MHz, nos modelos atuais vários núcleos com frequência acima de um gigahertz), a velocidade de troca com o armazenamento é baixa (vários megabytes por segundo), o tamanho dos registros é pequeno. Em geral, se a compressão impactar a performance, isso será apenas de forma positiva. (absolutamente não crítico, apenas constatando). Além disso, não temos um verdadeiro embedded, mas sim um Linux comum — então, a implementação não deve exigir muito esforço (basta vincular a biblioteca e usar algumas funções dela).
Foi retirada uma parte do log de um dispositivo em funcionamento (1,7MB, 70 mil registros) e, para começar, foi verificada a compressibilidade usando gzip, lz4, lzop, bzip2, xz, zstd disponíveis no computador.
- gzip, xz, zstd mostraram resultados próximos (40KB).
Surpreendeu-me que o popular xz se comportou aqui no nível do gzip ou zstd; - lzip com configurações padrão deu um resultado ligeiramente pior;
- lz4 e lzop mostraram um resultado não muito bom (150KB);
- bzip2 apresentou um resultado surpreendentemente bom (18KB).
Assim, os dados são comprimidos muito bem.
Portanto, (se não encontrarmos falhas fatais) a compressão será uma realidade! Apenas porque mais dados caberão no mesmo pen-drive.
Vamos pensar sobre as desvantagens.
O primeiro problema: já concordamos que cada registro deve ser imediatamente gravado no pen-drive. Normalmente, um compressor acumula dados do fluxo de entrada até decidir que é hora de gravar na saída. Precisamos obter imediatamente um bloco de dados comprimidos e salvá-lo na memória não volátil.
Vejo três caminhos:
- Comprimir cada registro usando compressão por dicionário em vez dos algoritmos acima mencionados.
Uma opção viável, mas que não me agrada. Para garantir um nível de compressão razoável, o dicionário deve ser "aprimorado" para os dados específicos; qualquer alteração fará com que o nível de compressão caia drasticamente. Sim, o problema pode ser resolvido criando uma nova versão do dicionário, mas isso é uma dor de cabeça — teremos que armazenar todas as versões do dicionário; em cada registro precisaremos indicar com qual versão do dicionário ele foi comprimido… - Comprimir cada registro usando algoritmos "clássicos", mas independentemente dos outros.
Os algoritmos de compressão considerados não são adequados para trabalhar com registros desse tamanho (dezenas de bytes), a taxa de compressão será claramente menor que 1 (ou seja, o volume de dados aumentará em vez de diminuir); - Fazer FLUSH após cada registro.
Em muitas bibliotecas de compressão, há suporte para FLUSH. Este é um comando (ou parâmetro para o procedimento de compressão), que, ao ser recebido, faz com que o compressor forme um fluxo comprimido de tal forma que seja possível recuperar tudo os dados não comprimidos que já foram recebidos. Tal análogosyncem sistemas de arquivos oucommitem sql.
O que é importante, as operações de compressão subsequentes poderão usar o dicionário acumulado e o grau de compressão não sofrerá tanto quanto na versão anterior.
Acho que é óbvio que escolhi a terceira opção, vamos nos aprofundar mais nela.
Encontrado sobre FLUSH no zlib.
Fiz um teste inspirado em um artigo, peguei 70 mil registros de logs de um dispositivo real, com um tamanho de página de 60KB (sobre o tamanho da página ainda voltaremos) obtive:
Dados de origem
Compressão gzip -9 (sem FLUSH)
zlib com Z_PARTIAL_FLUSH
zlib com Z_SYNC_FLUSH
Volume, KB
1692
40
352
604
À primeira vista, o custo trazido pelo FLUSH parece excessivamente alto, no entanto, na verdade temos uma escolha limitada — ou não comprimir de forma alguma, ou comprimir (de forma bastante eficaz) com FLUSH. Não devemos esquecer que temos 70 mil registros, a redundância criada pelo Z_PARTIAL_FLUSH é de apenas 4-5 bytes por registro. E a taxa de compressão resultou em quase 5:1, que é um resultado mais do que excelente.
Pode parecer surpreendente, mas na verdade o Z_SYNC_FLUSH é uma forma mais eficiente de fazer o FLUSH.
No caso de usar Z_SYNC_FLUSH, os últimos 4 bytes de cada registro serão sempre 0x00, 0x00, 0xff, 0xff. E se soubermos disso — podemos não armazená-los, assim o tamanho final acaba sendo apenas 324KB.
No artigo ao qual me refiro, há uma explicação:
Um novo bloco de tipo 0 com conteúdos vazios é anexado.
Um bloco de tipo 0 com conteúdos vazios consiste em:
- o cabeçalho de bloco de três bits;
- 0 a 7 bits iguais a zero, para alcançar alinhamento de byte;
- a sequência de quatro bytes 00 00 FF FF.
Como é fácil notar, no último bloco antes desses 4 bytes existem de 3 a 10 bits nulos. No entanto, a prática mostrou que os bits nulos na verdade são no mínimo 10.
Aparentemente, blocos de dados tão curtos normalmente (sempre?) são codificados usando um bloco do tipo 1 (bloco fixo), que deve sempre terminar com 7 bits nulos, totalizando garantidamente 10-17 bits nulos (e os restantes serão nulos com uma probabilidade de cerca de 50%).
Assim, nos dados de teste, em 100% dos casos antes de 0x00, 0x00, 0xff, 0xff aparece um byte nulo, e em mais de um terço dos casos — dois bytes nulos. (talvez o problema seja que estou usando CBOR binário, enquanto ao usar JSON textual eu encontraria mais frequentemente blocos do tipo 2 — bloco dinâmico, que consequentemente incluiria blocos sem bytes nulos adicionais antes de 0x00, 0x00, 0xff, 0xff).
Portanto, com os dados de teste disponíveis, é possível manter menos de 250KB de dados comprimidos.
É possível economizar um pouco mais ao brincar com os bits: agora estamos ignorando a presença de vários bits zerados no final do bloco, e vários bits no início do bloco também não mudam…
Mas aqui tomei a decisão de parar, senão, nesse ritmo, acabaria desenvolvendo meu próprio compactador.
No total, consegui de meus dados de teste 3-4 bytes por gravação, a taxa de compressão foi superior a 6:1. Vou ser honesto: não esperava esse resultado, na minha opinião, qualquer coisa melhor que 2:1 já justifica o uso da compressão.
Tudo ótimo, mas o zlib (deflate) ainda é um algoritmo de compressão antiquado e um pouco ultrapassado. Apenas o fato de que o dicionário usa os últimos 32KB do fluxo de dados não compactados já parece estranho hoje (ou seja, se algum bloco de dados for muito semelhante ao que estava no fluxo de entrada há 40KB, ele começará a ser compactado novamente, e não fará referência à entrada anterior). Em compactadores modernos, o tamanho do dicionário é frequentemente medido em megabytes, não em kilobytes.
Portanto, vamos continuar nossa mini-investigação em compactadores.
O próximo testado foi o bzip2 (lembro que, sem FLUSH, mostrou uma taxa de compressão fantástica, quase 100:1). Infelizmente, com FLUSH, seu desempenho foi muito ruim, o tamanho dos dados compactados foi maior que o dos dados não compactados.
Minhas suposições sobre as causas do fracasso
Libbz2 oferece apenas uma opção de flush, que, aparentemente, limpa o dicionário (semelhante ao Z_FULL_FLUSH no zlib), portanto, não se pode esperar uma compressão eficiente após isso.
E por último, testei o zstd. Dependendo dos parâmetros, ele comprime ou no nível do gzip, mas muito mais rápido, ou melhor que gzip.
Infelizmente, com FLUSH, ele também não se saiu muito bem: o tamanho dos dados compactados ficou em cerca de 700KB.
Eu na página do projeto no github, obtive a resposta de que devemos esperar até 10 bytes de dados auxiliares para cada bloco de dados compactados, o que está perto dos resultados obtidos, não será possível alcançar o deflate.
Decidi parar os experimentos com compactadores (lembro que xz, lzip, lzo, lz4 não se saíram bem na fase de teste sem FLUSH, e não me dediquei a considerar algoritmos de compressão mais exóticos).
Voltando aos problemas de arquivamento.
O segundo problema (como se diz em ordem, e não em significado) é que os dados comprimidos representam um único fluxo, onde há constantemente referências a trechos anteriores. Assim, ao danificar alguma parte dos dados comprimidos, perdemos não apenas o bloco de dados descomprimidos a ele relacionado, mas também todos os subsequentes.
Existem abordagens para resolver esse problema:
- Prevenir o surgimento do problema — adicionar redundância aos dados comprimidos que permita identificar e corrigir erros; sobre isso falaremos mais tarde;
- Minimizar as consequências em caso de ocorrência do problema.
Já mencionamos anteriormente que é possível comprimir cada bloco de dados de forma independente, o que faria o problema desaparecer por conta própria (a corrupção de dados de um bloco levaria à perda de dados apenas desse bloco). No entanto, esse é um caso extremo, onde a compressão de dados seria ineficaz. A outra extremidade: usar os 4MB de nosso chip como um único arquivo, o que nos daria uma compressão excelente, mas consequências catastróficas em caso de corrupção de dados.
Sim, é necessário um compromisso em termos de confiabilidade. Mas é preciso lembrar que estamos desenvolvendo um formato de armazenamento para memória não volátil com BER extremamente baixo e prazo de armazenamento de dados de 20 anos.
Durante os experimentos, descobri que as perdas significativas no nível de compressão começam em blocos de dados comprimidos com menos de 10KB.
Foi mencionado anteriormente que a memória utilizada tem uma organização em páginas, e não vejo razões para não utilizar a correspondência 'uma página - um bloco de dados comprimidos'.
Ou seja, o tamanho mínimo razoável da página é 16KB (com margem para informações administrativas). No entanto, um tamanho de página tão pequeno impõe limitações significativas ao tamanho máximo do registro.
Embora eu ainda não preveja registros maiores do que um quilobyte em forma comprimida, decidi usar páginas de 32KB (o que resulta em 128 páginas no chip).
Resumo:
- Os dados são armazenados comprimidos usando zlib (deflate);
- Para cada registro, estabelecemos Z_SYNC_FLUSH;
- Cortamos os bytes finais de cada registro comprimido (por exemplo, 0x00, 0x00, 0xff, 0xff); no cabeçalho, especificamos quantos bytes cortamos;
- Os dados são armazenados em páginas de 32KB; dentro da página, há um fluxo contínuo de dados comprimidos; em cada página, a compressão começa do zero.
E, antes de finalizar a compressão, gostaria de ressaltar que temos apenas alguns bytes comprimidos por registro, portanto, é extremamente importante não inflar as informações de controle, cada byte conta aqui.
Armazenamento de cabeçalhos de dados
Como temos registros de comprimento variável, precisamos de alguma forma de determinar a localização/fronteira dos registros.
Eu conheço três abordagens:
- Todos os registros são armazenados em um fluxo contínuo, primeiro vem o cabeçalho do registro, que contém o comprimento, e depois o próprio registro.
Nesse caso, tanto os cabeçalhos quanto os dados podem ter comprimento variável.
Essencialmente, temos uma lista encadeada que é amplamente utilizada; - Os cabeçalhos e os próprios registros são armazenados em fluxos separados.
Usando cabeçalhos de comprimento fixo, garantimos que a corrupção de um cabeçalho não afete os outros.
Abordagem semelhante é usada, por exemplo, em muitos sistemas de arquivos; - Os registros são armazenados em um fluxo contínuo, e a fronteira do registro é determinada por um determinado marcador (símbolo/sequência de símbolos que são proibidos dentro dos blocos de dados). Se um marcador for encontrado dentro do registro, ele é substituído por uma determinada sequência (é escapado).
Abordagem semelhante é utilizada, por exemplo, no protocolo PPP.
Vou ilustrar.
Opção 1:
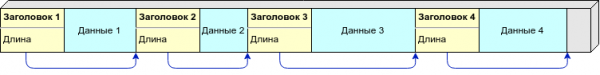
Aqui é muito simples: sabendo o comprimento do registro, podemos calcular o endereço do próximo cabeçalho. Assim, avançamos pelos cabeçalhos até encontrarmos uma área preenchida com 0xff (área livre) ou o final da página.
Opção 2:
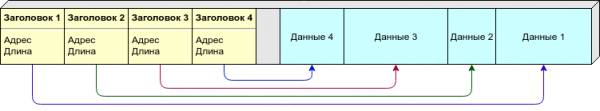
Devido ao comprimento variável dos registros, não podemos dizer antecipadamente quantos registros (e, portanto, cabeçalhos) precisaremos por página. Pode-se distribuir os cabeçalhos e os dados em páginas diferentes, mas eu prefiro outra abordagem: armazenamos tanto os cabeçalhos quanto os dados na mesma página, mas os cabeçalhos (de tamanho fixo) começam do início da página, enquanto os dados (de comprimento variável) vêm do final. Assim que eles 'se encontrarem' (o espaço livre não for suficiente para um novo registro) — consideramos essa página preenchida.
Opção 3:

Não há necessidade de armazenar no cabeçalho o comprimento ou qualquer outra informação sobre a localização dos dados; apenas marcadores indicando os limites dos registros são suficientes. No entanto, os dados precisam ser processados ao gravar/leitura.
Como marcador, eu usaria 0xff (que preenche a página após a exclusão), dessa forma a área livre não será interpretada como dados.
Tabela comparativa:
Opção 1
Opção 2
Opção 3
Resistência a erros
—
+
+
Compactação
+
—
+
Complexidade de implementação
*
**
**
A opção 1 tem uma desvantagem fatal: ao danificar algum dos cabeçalhos, toda a cadeia subsequente é destruída. As outras opções permitem recuperar parte dos dados mesmo em caso de danos em massa.
Mas aqui é apropriado lembrar que decidimos armazenar os dados de forma compacta, e de qualquer forma perderemos todos os dados na página após um registro 'corrompido', então, embora a tabela indique um menos, não o consideramos.
Compactação:
- Na primeira opção, precisamos armazenar no cabeçalho apenas o comprimento; se usarmos inteiros de comprimento variável, na maioria dos casos podemos nos contentar com um byte;
- Na segunda opção, precisamos armazenar o endereço inicial e o comprimento; o registro deve ter um tamanho fixo, que eu avalio em 4 bytes por registro (dois bytes para deslocamento e dois bytes para comprimento);
- A terceira opção precisa de apenas um símbolo para indicar o início do registro, mais o próprio registro que, devido à necessidade de escape, crescerá em 1-2%. Em geral, a paridade aproximada com a primeira opção.
Inicialmente, considerei a segunda opção como a principal (e até escrevi uma implementação). Desisti dela apenas quando decidi definitivamente usar compressão.
Talvez um dia eu use uma opção como essa. Por exemplo, se eu tiver que lidar com o armazenamento de dados para uma nave que viaja entre a Terra e Marte — requisitos totalmente diferentes para confiabilidade, radiação espacial, …
Quanto à terceira opção: eu dei duas estrelas pela complexidade de implementação simplesmente porque não gosto de lidar com escape, mudança de comprimento no processo, etc. Sim, talvez de forma tendenciosa, mas eu terei que escrever o código — por que me forçar a fazer algo que não gosto?
Resumo: Escolhemos a opção de armazenar na forma de cadeias 'cabeçalho com comprimento — dados de comprimento variável' devido à eficiência e simplicidade de implementação.
O uso de campos de bits para controlar o sucesso das operações de gravação
Já não me lembro onde eu vi a ideia, mas funciona mais ou menos assim:
Para cada gravação, reservamos alguns bits para armazenar as flags.
Como mencionamos anteriormente, após o erase, todos os bits são preenchidos com 1, e podemos alterar 1 para 0, mas não o contrário. Portanto, para "flag não definida" usamos 1, para "flag definida" — 0.
Assim pode parecer o armazenamento de uma gravação de comprimento variável na flash:
- Definimos a flag "gravação de comprimento iniciada";
- Gravamos o comprimento;
- Definimos a flag "gravação de dados iniciada";
- Gravamos os dados;
- Definimos a flag "gravação finalizada".
Além disso, teremos uma flag "ocorreu um erro", totalizando 4 flags de bits.
Nesse caso, temos dois estados estáveis "1111" — gravação não iniciada e "1000" — gravação bem-sucedida; em caso de interrupção inesperada do processo de gravação, obteremos estados intermediários, que depois poderemos detectar e processar.
A abordagem é interessante, mas ela protege apenas contra a inesperada falha de energia e interrupções semelhantes, o que, claro, é importante, mas não é a única (e nem a principal) razão para possíveis falhas.
Resumo: Vamos avançar na busca por uma boa solução.
Somas de verificação
As somas de verificação também permitem garantir (com uma probabilidade razoável) que estamos lendo exatamente o que deveria ter sido gravado. E, ao contrário dos campos de bits discutidos acima, elas funcionam sempre.
Se considerarmos a lista de potenciais fontes de problemas que discutimos acima, uma soma de verificação pode identificar um erro independentemente de sua origem (exceto, talvez, por alienígenas maliciosos — eles podem falsificar até mesmo a soma de verificação).
Portanto, se nosso objetivo é verificar se os dados estão íntegros, as somas de verificação são uma excelente ideia.
A escolha do algoritmo para cálculo da soma de verificação não suscitou dúvidas — CRC. Por um lado, as propriedades matemáticas permitem capturar 100% dos erros de certos tipos, por outro — em dados aleatórios, esse algoritmo geralmente mostra uma probabilidade de colisões não muito maior do que o limite teórico.  . Embora este não seja o algoritmo mais rápido e nem sempre o que minimiza o número de colisões, ele possui uma qualidade muito importante: nos testes que encontrei, não surgiram padrões nos quais ele falhasse claramente. A estabilidade é a principal qualidade neste caso.
Exemplo de uma pesquisa abrangente: , (links para narod.ru, desculpe).
No entanto, a tarefa de escolher um checksum não está concluída; o CRC é uma família inteira de checksums. É necessário determinar o comprimento e, em seguida, escolher um polinômio.
A escolha do comprimento do checksum não é uma questão tão simples quanto parece à primeira vista.
Vou ilustrar:
Vamos considerar a probabilidade de erro em cada byte  e o checksum ideal, vamos calcular o número médio de erros em um milhão de registros:
Dados, byte
Checksum, byte
Erro não detectado
Falsos positivos de erro
Total de falhas incorretas
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Parece simples – escolha o comprimento do checksum com base no comprimento dos dados protegidos, minimizando as falhas incorretas – e está resolvido.
No entanto, com checksums curtos, surge o problema: embora eles detectem bem erros bit a bit, podem com uma probabilidade bastante alta considerar como válidos dados completamente aleatórios. Já houve um artigo no Habr que descrevia .
Portanto, para tornar uma coincidência aleatória de checksum praticamente impossível, precisa-se usar checksums de 32 bits ou mais (para comprimentos superiores a 64 bits, normalmente utilizam-se funções hash criptográficas).
Apesar de eu ter escrito anteriormente que devemos economizar espaço a todo custo, vamos optar por um checksum de 32 bits (16 bits é pouco, a probabilidade de colisão é maior que 0,01%; e 24 bits, como dizem, não chega e não sai).
Pode surgir uma objeção: não economizamos cada byte ao escolher a compressão para agora entregar 4 bytes de uma só vez? Não seria melhor não comprimir e não adicionar checksum? Claro que não, a falta de compressão não significa, que a verificação de integridade não é necessária.
Quanto à escolha do polinômio, não vamos inventar a roda, e sim pegar o CRC-32C, que é popular atualmente.
Este código detecta 6 erros de bit em pacotes de até 22 bytes (talvez o caso mais comum para nós), 4 erros de bit em pacotes de até 655 bytes (também um caso comum para nós), 2 ou qualquer número ímpar de erros de bit em pacotes de qualquer comprimento razoável.
Se alguém estiver interessado em detalhes
sobre CRC.
para – talvez o principal especialista em CRC do planeta.
Em tem , que fornece parâmetros ligeiramente melhores para os comprimentos de pacotes que nos interessam, mas não considerei a diferença significativa, e me sinto suficientemente competente para escolher um código personalizado em vez de um padrão bem pesquisado.
Além disso, como nossos dados estão comprimidos, surge a questão: devemos calcular a soma de verificação de dados comprimidos ou não comprimidos?
Argumentos "a favor" do cálculo da soma de verificação de dados não comprimidos:
- precisamos, em última análise, verificar a integridade do armazenamento de dados – é isso que estamos verificando diretamente (ao mesmo tempo, também serão verificados possíveis erros na implementação de compressão/descompressão, danos causados por memória com defeito, etc.);
- o algoritmo deflate em zlib possui uma implementação bastante madura e não deve falhar com dados de entrada "irregulares", além disso, muitas vezes pode detectar automaticamente erros no fluxo de entrada, reduzindo a probabilidade geral de não detecção de erros (realizei um teste invertendo um único bit em uma gravação curta, o zlib detectou o erro em cerca de um terço das vezes).
Argumentos "contra" o cálculo da soma de verificação de dados não comprimidos:
- o CRC é otimizado especificamente para poucos erros de bit, que são comuns em memória flash (um erro de bit em um fluxo comprimido pode causar uma alteração maciça no fluxo de saída, com a qual, teoricamente, podemos "capturar" uma colisão);
- não gosto muito da ideia de passar dados potencialmente corrompidos ao descompretor, , como ele reagirá.
Neste projeto, decidi me afastar da prática comum de armazenar a soma de verificação de dados não comprimidos.
Resumo: usamos CRC-32C, calculamos a soma de verificação dos dados na forma em que são gravados na flash (após a compressão).
Redundância
O uso de codificação redundante não elimina, é claro, a perda de dados, no entanto, pode reduzir significativamente (muitas vezes em várias ordens de grandeza) a probabilidade de perda irreversível de dados.
Podemos usar diferentes tipos de redundância para corrigir erros.
Os códigos de Hamming podem corrigir erros individuais de bits, os códigos de Reed-Solomon são simbólicos; várias cópias de dados juntamente com somas de verificação, ou codificações como RAID-6 podem ajudar a recuperar dados mesmo em caso de danos massivos.
Inicialmente, eu estava inclinado a usar amplamente a codificação resistente a falhas, mas depois percebi que primeiro precisamos ter uma ideia de quais erros queremos nos proteger, e depois escolher a codificação.
Dissemos anteriormente que os erros devem ser detectados o mais rápido possível. Em que momentos podemos enfrentar erros?
- Gravação incompleta (por algum motivo, no momento da gravação, a energia foi cortada, o Raspberry travou, etc.)
Infelizmente, em caso de tal erro, só resta ignorar os registros inválidos e considerar os dados perdidos; - Erros de gravação (por algum motivo, o que foi gravado na memória flash não é o que deveria ter sido gravado)
Podemos detectar esses erros imediatamente se fizermos uma leitura de verificação logo após a gravação; - Distorção de dados na memória durante o armazenamento;
- Erros de leitura
Para corrigir, basta repetir a leitura algumas vezes em caso de discrepância na soma de verificação.
Ou seja, apenas erros do terceiro tipo (corruptela espontânea de dados durante o armazenamento) não podem ser corrigidos sem codificação resistente a falhas. Acredita-se que tais erros são extremamente improváveis.
Resumo: decidiu-se abrir mão da codificação redundante, mas, se a operação mostrar a falha dessa decisão, será possível reconsiderar a questão (com a estatística já acumulada sobre falhas, que permitirá escolher o tipo de codificação ideal).
Outros
É claro que o formato do artigo não permite justificar cada bit no formato (e já estou sem forças), portanto, passarei brevemente por alguns pontos que não foram abordados anteriormente.
- Decidiu-se tornar todas as páginas "igualmente importantes"
Ou seja, não haverá páginas especiais com metadados, fluxos separados, etc., mas sim um único fluxo que reescreve todas as páginas sequencialmente.
Isso garante um desgaste uniforme das páginas, a ausência de um único ponto de falha, e simplesmente agrada; - É imprescindível considerar a versionabilidade do formato.
Um formato sem número de versão no cabeçalho é um mal!
Basta adicionar um campo no cabeçalho da página com um número mágico (assinatura), que indicará a versão do formato utilizado. (não acho que na prática haverá até dez deles); - Usar um cabeçalho de comprimento variável para os registros (que são muitos), tentando em grande parte dos casos mantê-lo com comprimento de 1 byte;
- Para codificar o comprimento do cabeçalho e o comprimento da parte cortada do registro comprimido, utilizar códigos binários de comprimento variável.
Ajudou muito de códigos de Huffman. Em questão de minutos, consegui encontrar os códigos de comprimento variável necessários.
Descrição do formato de armazenamento de dados
Ordem dos bytes
Os campos que excedem um byte de tamanho são armazenados em formato big-endian (ordem de bytes da rede), ou seja, 0x1234 é gravado como 0x12, 0x34.
Divisão em páginas
Toda a memória flash está dividida em páginas de tamanho igual.
O tamanho da página por padrão é 32KB, mas não mais do que 1/4 do tamanho total do chip de memória (para um chip de 4MB isso resulta em 128 páginas).
Cada página armazena dados de forma independente das outras (ou seja, os dados de uma página não referenciam os dados de outra página).
Todas as páginas estão numeradas em ordem natural (em ordem crescente de endereços), começando pelo número 0 (a página zero começa no endereço 0, a primeira — no 32KB, a segunda — no 64KB, e assim por diante).
O chip de memória é usado como um buffer circular (ring buffer), ou seja, primeiro a gravação vai para a página número 0, depois para a número 1, … quando preenchemos a última página, um novo ciclo começa e a gravação continua a partir da página zero.
Dentro da página
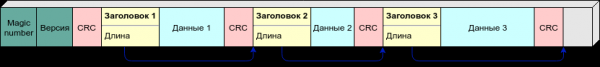
No início da página, armazena-se um cabeçalho de 4 bytes, seguido pela soma de verificação do cabeçalho (CRC-32C), e, em seguida, armazenam-se registros no formato “cabeçalho, dados, soma de verificação”.
O cabeçalho da página (na ilustração em verde sujo) consiste em:
- um campo de dois bytes chamado Magic Number (que também é um sinal de versão do formato)
para a versão atual do formato, ele é considerado como0xed00 ⊕ número da página; - contador de dois bytes "Versão da página" (número do ciclo de reescrita de memória).
As entradas na página são armazenadas de forma compactada (usando o algoritmo deflate). Todas as entradas em uma página são comprimidas em um único fluxo (utilizando um dicionário comum), e a compressão em cada nova página começa do zero. Ou seja, para descomprimir qualquer entrada, são necessárias todas as entradas anteriores dessa página (e apenas dessa).
Cada entrada será comprimida com a flag Z_SYNC_FLUSH, resultando em 4 bytes 0x00, 0x00, 0xff, 0xff no final do fluxo comprimido, possivelmente precedidos por um ou dois bytes nulos.
Descartamos essa sequência (com comprimento de 4, 5 ou 6 bytes) ao gravar na memória flash.
O cabeçalho da entrada consiste em 1, 2 ou 3 bytes, armazenando:
- um bit (T) que indica o tipo da entrada: 0 — contexto, 1 — log;
- um campo de comprimento variável (S) de 1 a 7 bits que define o comprimento do cabeçalho e o "toque" que deve ser adicionado à entrada para descompressão;
- o comprimento da entrada (L).
Tabela de valores S:
S
Comprimento do cabeçalho, bytes
Descartado ao gravar, byte
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Tentei ilustrar, não sei quão claro ficou:
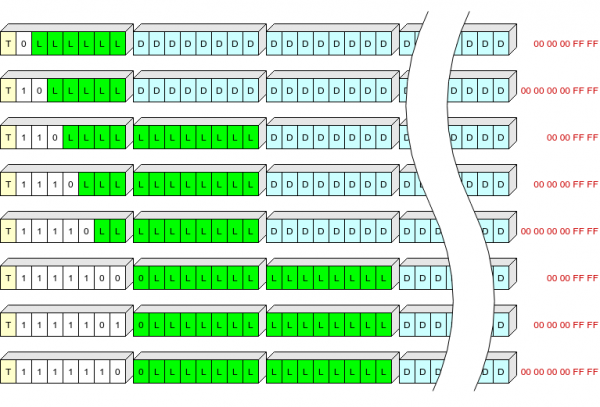
O campo T está marcado em amarelo, o campo S em branco, L (comprimento dos dados comprimidos em bytes) em verde, os dados comprimidos em azul, os bytes finais dos dados comprimidos que não são gravados na memória flash em vermelho.
Assim, os cabeçalhos das entradas mais comuns (até 63+5 bytes em formato comprimido) poderão ser gravados em um único byte.
Após cada entrada, é armazenada uma soma de verificação CRC-32C, que usa como valor inicial (init) o valor invertido da soma de verificação anterior.
O CRC possui a propriedade de "continuidade", agindo (mais ou menos com a inversão de bits no processo) tal fórmula:  .
Ou seja, na prática, estamos calculando o CRC de todos os bytes anteriores dos cabeçalhos e dados nessa página.
Imediatamente após a soma de verificação, encontra-se o cabeçalho da próxima entrada.
O cabeçalho é construído de tal maneira que seu primeiro byte seja sempre diferente de 0x00 e 0xff (se encontrarmos 0xff em vez do primeiro byte do cabeçalho, isso significa que é uma área não utilizada; 0x00 sinaliza um erro).
Algoritmos aproximados
Leitura da memória flash
Qualquer leitura é feita com verificação de soma de verificação.
Se a soma de verificação não corresponder, a leitura será repetida várias vezes na esperança de ler os dados corretos.
(isso faz sentido, o Linux não armazena em cache as leituras da NOR Flash, comprovado)
Gravação na memória flash
Estamos gravando dados.
Estamos os lendo.
Se os dados lidos não corresponderem aos dados gravados, preenchemos a área com zeros e sinalizamos um erro.
Preparando o novo chip para operação
Para a inicialização, um cabeçalho com a versão 1 é gravado na primeira (ou, mais precisamente, na página zero).
Depois disso, um contexto inicial é gravado nesta página (contém o UUID do dispositivo e configurações padrão).
Tudo pronto, a memória flash está pronta para operação.
Carregamento do dispositivo
Durante o carregamento, os primeiros 8 bytes de cada página (cabeçalho + CRC) são lidos, e páginas com um número mágico desconhecido ou CRC inválido são ignoradas.
Das páginas 'corretas', são selecionadas as páginas com a versão mais alta, e delas é escolhida a página com o maior número.
A primeira entrada é lida, a validade do CRC é verificada, assim como a presença da flag 'contexto'. Se tudo estiver correto, essa página é considerada atual. Se não, retrocedemos para a anterior, até encontrarmos uma página 'viva'.
Na página encontrada, lemos todas as entradas, aquelas com a flag 'contexto' aplicamos.
Salvamos o dicionário zlib (será necessário para escrevê-lo novamente nesta página).
Isso é tudo, o carregamento foi concluído, o contexto foi restaurado, é possível trabalhar.
Adicionando uma entrada ao log
Comprimimos a entrada com o dicionário correto, especificando Z_SYNC_FLUSH. Verificamos se a entrada comprimida cabe na página atual.
Se não couber (ou se houver erros de CRC na página), começamos uma nova página (veja abaixo).
Gravamos a entrada e o CRC. Se ocorrer um erro, começamos uma nova página.
Nova página
Escolhemos uma página livre com o menor número (consideramos livre uma página com uma soma de verificação errada no cabeçalho ou com uma versão inferior à atual). Se não houver tais páginas, escolhemos a página com o menor número que tenha a versão igual à atual.
Realizamos o erase na página selecionada. Comparamos o conteúdo com 0xff. Se algo estiver errado, pegamos a próxima página livre, e assim por diante.
Na página apagada, gravamos o cabeçalho, com o estado atual do contexto como a primeira entrada e, em seguida, a entrada do log não gravada (se houver).
Aplicabilidade do formato
Na minha opinião, este é um formato razoável para armazenar qualquer fluxo de informações que seja minimamente comprimível (texto simples, JSON, MessagePack, CBOR, possivelmente protobuf) em NOR Flash.
Claro, o formato é "especialmente projetado" para SLC NOR Flash.
Não deve ser utilizado com dispositivos que possuem um BER alto, como NAND ou MLC NOR. (existe realmente memória desse tipo à venda? só encontrei menções em trabalhos sobre códigos de correção).
Ainda mais, não deve ser usado com dispositivos que possuem seu próprio FTL: USB flash, SD, MicroSD, etc. (para esse tipo de memória, eu criei um formato com tamanho de página de 512 bytes, uma assinatura no início de cada página e números únicos para os registros — às vezes, consegui recuperar todos os dados de um pen drive "falho" apenas com leitura sequencial).
Dependendo das tarefas, o formato pode ser usado sem alterações em flash de 128Kbits (16Kbytes) até 1Gbit (128Mbytes). Se desejado, também pode ser utilizado em chips de maior capacidade, mas provavelmente é necessário ajustar o tamanho da página. (Mas aqui já surge a questão da viabilidade econômica, o preço da NOR Flash em grande capacidade não é animador.).
Se alguém achou o formato interessante e quiser usá-lo em um projeto aberto — escreva, tentarei encontrar tempo para organizar o código e publicá-lo no github.
Conclusão
Como podemos ver, no final o formato acabou sendo simples. E até mesmo monótono..
Na artigo, é difícil refletir a evolução do meu ponto de vista, mas acredite: inicialmente eu queria criar algo sofisticado, indestrutível, capaz de sobreviver mesmo após uma explosão nuclear nas proximidades. No entanto, a razão (espero) acabou prevalecendo e, gradualmente, as prioridades se deslocaram para a simplicidade e compactação.
Pode ser que eu esteja errado? Sim, claro. É bem possível, por exemplo, que tenhamos adquirido um lote de chips de baixa qualidade. Ou, por algum outro motivo, o equipamento não atenda às expectativas de confiabilidade.
Tenho um plano para esse caso? Eu acho que, após ler o artigo, você não duvida de que há um plano. E não só um.
Sejamos um pouco mais sérios, o formato foi desenvolvido tanto como uma opção prática quanto como um "teste experimental".
Até o momento, tudo está funcionando normalmente na mesa, e em breve a solução será implantada. (aproximadamente) em centenas de dispositivos, vamos ver como se comporta na operação 'real' (felizmente, espero que o formato permita detectar falhas de forma confiável; assim, será possível reunir estatísticas completas). Em alguns meses, poderemos tirar conclusões (e se não tiver sorte — antes disso).
Se, após o uso, surgirem problemas sérios e forem necessárias melhorias, com certeza vou mencionar isso.
Literatura
Não queria fazer uma longa lista entediante de trabalhos utilizados, afinal, o Google está acessível a todos.
Decidi manter uma lista de descobertas que me pareceram particularmente interessantes, mas gradualmente elas foram incorporadas diretamente no texto do artigo, e na lista ficou apenas um item:
- Utilitário de autoria de zlib. É capaz de exibir o conteúdo de arquivos deflate/zlib/gzip de forma compreensível. Se você precisa entender a estrutura interna do formato deflate (ou gzip) — recomendo fortemente.
Fonte: habr.com
