

Olá, Habr!
Neste artigo, falarei sobre a geração de números pseudo-aleatórios entre participantes que não confiam uns nos outros. Como veremos a seguir, implementar um gerador "quase" bom é bastante simples, enquanto um muito bom é complexo.
Por que é necessário gerar números aleatórios para participantes que não confiam entre si? Uma das áreas de aplicação é em aplicativos descentralizados. Por exemplo, um aplicativo que aceita uma aposta de um participante e, com 49% de probabilidade, dobra o valor ou retira com 51%, funcionará apenas se puder obter um número aleatório de forma imparcial. Se um atacante puder influenciar o resultado do gerador de números aleatórios, mesmo que de forma sutil, para aumentar sua chance de receber um pagamento pelo aplicativo, ele pode facilmente esvaziá-lo.
Quando desenvolvemos um protocolo distribuído para geração de números aleatórios, queremos que ele possua três propriedades:
Ele deve ser imparcial. Em outras palavras, nenhum participante deve de forma alguma influenciar o resultado do gerador de números aleatórios.
Ele deve ser imprevisível. Em outras palavras, nenhum participante deve ter a capacidade de prever qual número será gerado (ou extrair quaisquer de suas propriedades) antes de ser gerado.
O protocolo deve ser viável, ou seja, resistente ao fato de que uma certa porcentagem de participantes desconectará da rede ou tentará parar o protocolo intencionalmente.
Neste artigo, analisaremos duas abordagens: RANDAO + VDF e uma abordagem baseada em códigos de apagamento. Na próxima parte, examinaremos em detalhes a abordagem baseada em assinaturas de limite.
Mas, primeiro, vamos analisar um algoritmo simples e frequentemente utilizado que é viável, imprevisível, mas tendencioso.
RANDAO
RANDAO é uma abordagem muito simples e, portanto, bastante comum para obter aleatoriedade. Todos os participantes da rede primeiro escolhem um número pseudo-aleatório localmente, então cada participante envia o hash do número escolhido. Depois, os participantes revelam seus números escolhidos um a um, e realizam a operação XOR nos números revelados, resultando na saída do protocolo.
A etapa de publicação de hashes antes de revelar os números é necessária para que um invasor não possa escolher seu número após ver os números dos outros participantes. Isso lhe permitiria, de fato, determinar unilateralmente a saída do gerador de números aleatórios.
Durante o protocolo, os participantes precisam concordar duas vezes em uma solução comum (o chamado consenso): quando começar a revelar os números escolhidos e, consequentemente, parar de aceitar hashes, e quando terminar de aceitar os números escolhidos e calcular o número aleatório resultante. Tomar tais decisões entre participantes que não confiam uns nos outros é uma tarefa difícil, e voltaremos a isso em artigos futuros; neste artigo, presumiremos que tal algoritmo de consenso está disponível para nós.
Quais das propriedades que descrevemos acima estão presentes no RANDAO? Ele é imprevisível, possui a mesma viabilidade que o protocolo de consenso subjacente, mas é tendencioso. Em particular, um invasor pode observar a rede e, após outros participantes revelarem seus números, pode calcular seu XOR e decidir se deve ou não revelar seu número para influenciar o resultado. Embora isso não permita que o invasor determine unilateralmente a saída do gerador de números aleatórios, ainda lhe dá 1 bit de influência. E se os invasores controlarem vários participantes, o número de bits sob seu controle será igual ao número de participantes que eles controlam.
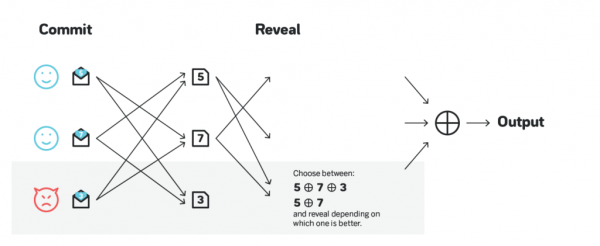
A influência dos invasores pode ser significativamente reduzida se exigir que os participantes revelem os números em ordem. Assim, um invasor só conseguirá influenciar o resultado se revelar seu número por último. Embora a influência seja muito menor, o algoritmo ainda é tendencioso.
RANDAO + VDF
Uma das maneiras de tornar o RANDAO não tendencioso é a seguinte: depois que todos os números forem revelados e o XOR calculado, seu resultado é inserido em uma função que leva muito tempo para ser computada, mas permite verificar a correção do cálculo muito rapidamente.
(vdf_output, vdf_proof) = VDF_compute(input) // isso é muito lento
correct = VDF_verify(input, vdf_output, vdf_proof) // isso é muito rápido
Essa função é chamada de Função de Atraso Verificável, ou VDF. Se o cálculo do resultado final levar mais tempo do que a fase de revelação dos números, o atacante não será capaz de prever o efeito da demonstração ou ocultação de seu número, e portanto, perderá a capacidade de influenciar o resultado.
Desenvolver bons VDF é extremamente desafiador. Recentemente, várias inovações foram feitas, como e que tornaram os VDF mais aplicáveis na prática, e o Ethereum 2.0 planeja a longo prazo usar RANDAO com VDF como fonte de números aleatórios. Além do fato de que essa abordagem é imprevisível e imparcial, ela possui a vantagem adicional de viabilidade, desde que pelo menos dois participantes estejam disponíveis na rede (desde que o protocolo de consenso utilizado seja viável com esse pequeno número de participantes).
A maior dificuldade dessa abordagem reside em configurar o VDF de modo que mesmo um participante com equipamento especializado caro não consiga calcular o VDF antes do término da fase de revelação. Idealmente, o algoritmo deve ter até mesmo uma margem de segurança significativa, digamos, 10x. Abaixo está mostrado um ataque de um participante que possui um ASIC especializado, que lhe permite executar o VDF mais rápido do que o tempo alocado para a revelação da confirmação RANDAO. Tal participante ainda pode calcular o resultado final usando ou não seu número, e depois, com base em seus cálculos, decidir se o mostrará ou não.
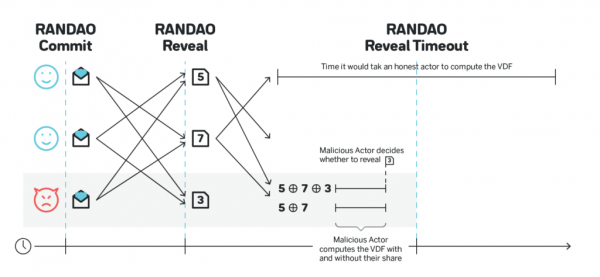
Para a família de VDF mencionada acima, o desempenho de um ASIC especializado pode ser mais de 100 vezes superior ao do equipamento comum. Assim, se a fase de revelação durar 10 segundos, o VDF calculado em um ASIC desse tipo deve levar mais de 100 segundos para ter 10 vezes a margem de segurança, e, portanto, o mesmo VDF calculado em um equipamento comum deve levar 100 x 100 segundos = ~ 3 horas.
A Ethereum Foundation planeja resolver esse problema por meio da criação de seus próprios ASIC públicos e gratuitos. Assim que isso acontecer, todos os outros protocolos também poderão aproveitar essa tecnologia, mas até lá, a abordagem RANDAO + VDF não será tão viável para os protocolos que não podem investir no desenvolvimento de seus próprios ASIC.
Muitos artigos, vídeos e outras informações sobre VDF foram reunidos neste site .
Usamos códigos de apagamento
Nesta seção, vamos explorar o protocolo de geração de números aleatórios que utiliza . Ele pode suportar até ⅓ de atacantes, permanecendo viável, e permite a existência de até ⅔ de atacantes antes que eles possam prever ou influenciar o resultado.
A ideia principal do protocolo é a seguinte. Para simplificar, vamos supor que existem exatamente 100 participantes. Suponha também que todos os participantes têm localmente uma chave privada e que as chaves públicas de todos os participantes são conhecidas por todos os participantes:
Cada participante localmente cria uma longa sequência, a divide em 67 partes, gera códigos de apagamento para obter 100 partes, de modo que quaisquer 67 sejam suficientes para reconstruir a sequência, designa cada uma das 100 partes a um dos participantes e as criptografa usando a chave pública do mesmo participante. Em seguida, todas as partes codificadas são publicadas.
Os participantes usam algum consenso para alcançar um acordo sobre os conjuntos codificados de 67 participantes específicos.
Assim que o consenso é alcançado, cada participante pega as partes codificadas em cada um dos 67 conjuntos, criptografadas com sua chave pública, decifra todas essas partes e publica todas essas partes decifradas.
Assim que 67 participantes completam a etapa (3), todos os conjuntos acordados podem ser completamente decifrados e restaurados graças às propriedades dos códigos de apagamento, e o número final pode ser obtido como XOR das sequências iniciais a partir das quais os participantes começaram na etapa (1).
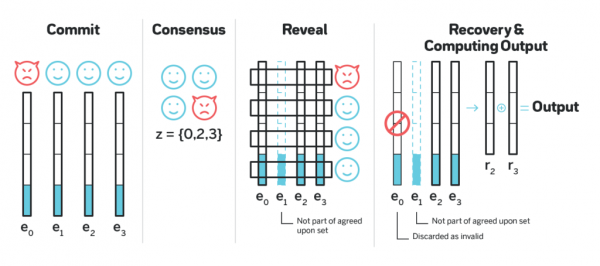
É possível demonstrar que este protocolo é imparcial e imprevisível. O número aleatório resultante é definido após o consenso ser alcançado, mas ninguém sabe até que ⅔ dos participantes decodifiquem as partes criptografadas com sua chave pública. Assim, o número aleatório é determinado antes que a informação necessária para sua recuperação seja publicada.
O que acontece se, no passo (1), um dos participantes enviar aos outros participantes partes codificadas que não são um código de apagamento correto de alguma string? Sem modificações adicionais, diferentes participantes podem não conseguir recuperar a string de forma alguma, ou recuperar strings diferentes, o que fará com que diferentes participantes recebam um número aleatório diferente. Para evitar isso, pode-se fazer o seguinte: cada participante, além das partes codificadas, também computa de todas essas partes, e envia a cada participante tanto a parte codificada em si como a raiz da árvore de Merkle, e a prova de inclusão da parte na árvore de Merkle. No consenso do passo (2), os participantes não apenas concordam com um conjunto de conjuntos, mas com um conjunto específico de raízes dessas árvores (se algum participante se afastou do protocolo e enviou raízes diferentes da árvore de Merkle para diferentes participantes, e duas dessas raízes forem mostradas durante o consenso, sua string não é incluída no conjunto resultante). No final do consenso, teremos 67 strings codificadas e suas respectivas raízes de árvore de Merkle, de forma que há pelo menos 67 participantes (não necessariamente os mesmos que propuseram as strings correspondentes), para os quais, para cada uma das 67 strings, há uma mensagem com a parte do código de apagamento e uma prova da inclusão de sua parte na árvore de Merkle correspondente.
Quando, no passo (4), um participante decodifica 67 partes de uma determinada string e tenta reconstruir a string original, uma das opções possíveis é:
A string é restaurada, e se for codificada novamente com códigos de apagamento, e a árvore de Merkle for calculada para as partes calculadas localmente, a raiz coincide com aquela em que o consenso foi alcançado.
A string é restaurada, mas a raiz calculada localmente não corresponde àquela em que o consenso foi alcançado.
A string não é restaurada.
É fácil mostrar que se, para pelo menos um participante, ocorreu a variante (1), então para todos os participantes ocorrerá a variante (1), e vice-versa, se para pelo menos um participante ocorreu a variante (2) ou (3), então para todos os participantes ocorrerá a variante (2) ou (3). Assim, para cada linha no conjunto, ou todos os participantes conseguem restaurá-la com sucesso, ou todos os participantes não conseguem restaurá-la. Portanto, o número aleatório resultante é o XOR apenas das linhas que os participantes conseguiram restaurar.
Assinaturas de limite
Outra abordagem para a aleatoriedade envolve o uso das chamadas assinaturas de limite BLS. Um gerador de números aleatórios baseado em assinaturas de limite possui exatamente as mesmas garantias que o algoritmo descrito acima baseado em códigos de apagamento, mas possui uma assimptótica significativamente menor da quantidade de mensagens transmitidas pela rede para cada número gerado.
As assinaturas BLS são uma construção que permite a vários participantes criar uma única assinatura comum para uma mensagem. Essas assinaturas são frequentemente utilizadas para economizar espaço e largura de banda, pois não requerem o envio de várias assinaturas.
Uma aplicação frequente para assinaturas BLS em protocolos de blockchain, além da geração de números aleatórios, é a assinatura de blocos em protocolos BFT. Digamos que 100 participantes criam blocos, e um bloco é considerado finalizado se 67 deles o assinam. Todos podem apresentar suas partes da assinatura BLS e usar algum algoritmo de consenso para concordar com 67 delas, e então combiná-las em uma única assinatura BLS. Quaisquer 67 (ou mais) partes podem ser usadas para criar a assinatura final, que dependerá de quais 67 assinaturas específicas foram combinadas e, portanto, pode variar. No entanto, embora a escolha diferente de 67 participantes possa criar uma assinatura diferente, qualquer uma dessas assinaturas será uma assinatura válida para o bloco. Os outros participantes, então, precisam apenas receber pela rede e verificar uma única assinatura para cada bloco, ao invés de 67, o que reduz significativamente a carga na rede.
Descobriu-se que, se as chaves privadas utilizadas pelos participantes forem geradas de uma determinada maneira, então, independentemente de quais 67 assinaturas (ou mais, mas não menos) sejam agregadas, a assinatura resultante será a mesma. Isso pode ser usado como uma fonte de aleatoriedade: os participantes primeiro concordam com uma mensagem que assinarão (pode ser a saída do RANDAO ou simplesmente um hash do último bloco, na verdade, isso não importa, desde que mude a cada vez e seja acordado) e criam uma assinatura BLS para isso. O resultado da geração será imprevisível até que 67 participantes forneçam suas partes, e depois disso, as saídas já estarão predefinidas e não poderão depender das ações de qualquer participante.
Essa abordagem à aleatoriedade é viável se pelo menos ⅔ dos participantes estiverem online e seguirem o protocolo, e é imparcial e imprevisível enquanto pelo menos ⅓ dos participantes seguirem o protocolo. É importante notar que um invasor que controla mais de ⅓, mas menos de ⅔ dos participantes pode parar o protocolo, mas não pode prever ou influenciar sua saída.
As assinaturas de limiar são, por si mesmas, um tema muito interessante. Na segunda parte do artigo, vamos analisar em detalhe como elas funcionam e como os participantes devem gerar suas chaves para que as assinaturas de limiar possam ser usadas como geradores de números aleatórios.
Para concluir
Este artigo é o primeiro de uma série de artigos técnicos no blog. . NEAR é um protocolo de blockchain e plataforma para desenvolvimento de aplicativos descentralizados com foco na simplicidade de desenvolvimento e na facilidade de uso para os usuários finais.
O código do protocolo é aberto, nossa implementação é escrita em Rust e pode ser encontrada .
Você pode ver como é o desenvolvimento para NEAR e experimentar na IDE online .
Acompanhe todas as notícias em russo em e no , e em inglês no oficial .
Até breve!
Fonte: habr.com
