

Espere! Espere! Na verdade, não se trata de mais um artigo sobre tipos de backups do SQL Server. Eu nem vou falar sobre as diferenças entre os modelos de recuperação ou como lidar com logs crescidos.
Talvez (apenas talvez), depois de ler este post, você consiga fazer com que o backup, que é gerado com as funcionalidades padrão, aconteça amanhã à noite, bem, 1,5 vez mais rápido. E tudo isso por usar um pouquinho a mais de parâmetros BACKUP DATABASE.
Se o conteúdo do post foi óbvio para você — peço desculpas. Eu li tudo que consegui encontrar no Google com a frase "habr sql server backup", e em nenhum artigo encontrei menção de que é possível influenciar o tempo de backup de alguma maneira com os parâmetros.
Chamo sua atenção para o comentário de Alexander Gladchenko ():
Nunca altere os parâmetros BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE em produção. Eles foram feitos apenas para escrever artigos como esse. Na prática, você terá problemas com a memória seriamente.
Seria claro, é claro, maravilhoso ser o mais inteligente e publicar conteúdo exclusivo, mas, infelizmente, não é assim. Existem artigos/posts tanto em inglês quanto em russo (sempre confundo como chamá-los corretamente) dedicados a esse tema. Aqui está uma parte do que encontrei: , , .
Então, para começar, vou anexar uma sintaxe reduzida de BACKUP de (a propósito, mencionei acima sobre BACKUP DATABASE, mas tudo isso é aplicável ao backup do log de transações e ao backup diferencial, embora, talvez, com um efeito menos óbvio):
BACKUP DATABASE { database_name | @database_name_var }
  TO  [ ,...n ]

  [ WITH {
           |  [ ,...n ] } ]
[;]

 [ ,...n ]::=

--Opções do Conjunto de Mídia

 | BLOCKSIZE = { blocksize | @blocksize_variable }

--Opções de Transferência de Dados
   BUFFERCOUNT = { buffercount | @buffercount_variable }
 | MAXTRANSFERSIZE = { maxtransfersize | @maxtransfersize_variable }
— significa que havia algo lá, mas eu removi porque isso não está relacionado ao tema atual.
Como você geralmente faz backups? Como "ensinam" a fazer backups em bilhões de artigos? Na verdade, se precisar fazer um backup pontual de algum banco de dados não muito grande, eu automaticamente escreveria algo assim:
BACKUP DATABASE smth
TO DISK = 'D:Backupsmth.bak'
WITH STATS = 10, CHECKSUM, COMPRESSION, COPY_ONLY;
--tá, escrevi CHECKSUM apenas para parecer mais inteligente.
E, na verdade, aqui estão listados cerca de 75-90% de todos os parâmetros que geralmente são mencionados em artigos sobre backups. Há também INIT, SKIP, entre outros. Você já consultou o MSDN? Viu quantas opções existem lá? Eu também vi...
Provavelmente, você já entendeu que agora falaremos sobre três parâmetros que ficaram no primeiro bloco de código - BLOCKSIZE, BUFFERCOUNT e MAXTRANSFERSIZE. Aqui estão suas descrições do MSDN:
BLOCKSIZE = { blocksize | @ blocksize_variable } - indica o tamanho do bloco físico em bytes. Tamanhos suportados incluem 512, 1024, 2048, 4096, 8192, 16.384, 32.768 e 65.536 bytes (64 KB). O valor padrão é 65.536 para dispositivos de fita e 512 para outros dispositivos. Normalmente, este parâmetro não é necessário, pois o comando BACKUP escolhe automaticamente o tamanho do bloco apropriado para o dispositivo. A definição explícita do tamanho do bloco substitui a escolha automática do tamanho do bloco.
BUFFERCOUNT = { buffercount | @ buffercount_variable } - define o número total de buffers de entrada/saída que serão utilizados para a operação de backup. Pode-se especificar qualquer valor inteiro positivo, mas um número excessivamente alto de buffers pode causar erro de falta de memória devido ao espaço virtual de endereço excessivo durante o processo Sqlservr.exe.
O volume total de espaço utilizado pelos buffers é definido pela seguinte fórmula:
BUFFERCOUNT * MAXTRANSFERSIZE.
MAXTRANSFERSIZE = { maxtransfersize | @ maxtransfersize_variable } indica o maior volume de pacotes de dados em bytes para a troca de dados entre o SQL Server e o meio do conjunto de backup. Os valores suportados são múltiplos de 65.536 bytes (64 KB), até 4.194.304 bytes (4 MB).
Juro que já li isso antes, mas nunca pensei na influência que eles poderiam ter no desempenho. Além disso, parece que preciso fazer uma espécie de "saída do armário" e admitir que mesmo agora não entendo completamente o que eles fazem. Provavelmente, preciso ler mais sobre entrada/saída bufferizada e como funciona um disco rígido. Um dia farei isso, mas agora posso apenas escrever um script que verifique como esses valores afetam a velocidade com que o backup é feito.
Criei uma pequena base, com cerca de 10 GB, coloquei-a em um SSD e o diretório para backups em um HDD.
Estou criando uma tabela temporária para armazenar os resultados (para mim, não é temporária, pois permite um exame mais detalhado dos resultados, mas você decide):
DROP TABLE IF EXISTS ##bt_results;

CREATE TABLE ##bt_results (
    id              int IDENTITY (1, 1) PRIMARY KEY,
    start_date      datetime NOT NULL,
    finish_date     datetime NOT NULL,
    backup_size     bigint NOT NULL,
    compressed_size bigint,
    block_size      int,
    buffer_count    int,
    transfer_size   int
);
O funcionamento do script é simples — laços aninhados, cada um mudando o valor de um parâmetro, que insiro no comando BACKUP, salvo o último registro histórico de msdb.dbo.backupset, excluo o arquivo de backup e prossigo para a próxima iteração. Como os dados sobre a execução do backup são retirados do backupset, a precisão é um pouco comprometida (não há frações de segundo lá), mas isso vamos superar.
Primeiro, é necessário permitir o uso do xp_cmdshell, para poder remover backups (não se esqueça de desativar depois, se não precisar):
EXEC sp_configure 'show advanced options', 1;
EXEC sp_configure 'xp_cmdshell', 1;
RECONFIGURE;
EXEC sp_configure 'show advanced options', 0;
GO
E, na verdade:
DECLARE @tmplt AS nvarchar(max) = N'
BACKUP DATABASE [bt]
TO DISK = ''D:SQLServerbackupbt.bak''
WITH
    COMPRESSION,
    BLOCKSIZE = {bs},
    BUFFERCOUNT = {bc},
    MAXTRANSFERSIZE = {ts}';

DECLARE @sql AS nvarchar(max);

\
Se precisar de explicações sobre o que está acontecendo aqui — escreva nos comentários ou envie uma mensagem pessoal. Por enquanto, falarei apenas sobre os parâmetros que estou passando para o BACKUP DATABASE.
Para BLOCKSIZE, temos uma lista de valores "fechada", e não consegui realizar um backup com BLOCKSIZE < 4KB. MAXTRANSFERSIZE pode ser qualquer número múltiplo de 64KB — de 64KB a 4MB. Por padrão, no meu sistema, está em 1024KB, eu usei 512 — 1024 — 2048 — 4096.
Foi mais complicado com BUFFERCOUNT — ele pode ser qualquer número positivo, mas o link diz . Também está escrito como obter informações sobre o BUFFERCOUNT que realmente é usado no backup — para mim, isso é 7. Não valia a pena reduzi-lo, e o limite superior foi descoberto empiricamente — com BUFFERCOUNT = 896 e MAXTRANSFERSIZE = 4194304, o backup falhou com um erro (do qual está escrito no link acima):
Msg 3013, Level 16, State 1, Line 7 BACKUP DATABASE está terminando anormalmente.
Msg 701, Level 17, State 123, Line 7 Não há memória do sistema suficiente no pool de recursos 'default' para executar esta consulta.
Para comparação, primeiro vou mostrar os resultados da execução do backup sem especificar parâmetros:
BACKUP DATABASE [bt]
TO DISK = 'D:SQLServerbackupbt.bak'
WITH COMPRESSION;
Bem, é backup e backup:
Processadas 1070072 páginas para o banco de dados 'bt', arquivo 'bt' no arquivo 1.
Processadas 2 páginas para o banco de dados 'bt', arquivo 'bt_log' no arquivo 1.
BACKUP DATABASE processou com sucesso 1070074 páginas em 53.171 segundos (157.227 MB/seg).
O próprio script que testa os parâmetros levou algumas horas, todas as medições estão . Aqui está uma amostra dos resultados com os três melhores tempos de execução (tentei fazer um gráfico bonito, mas, no post, terei que me contentar com uma tabela, e nos comentários adicionou ).
SELECT TOP 7 WITH TIES
    compressed_size,
    block_size,
    buffer_count,
    transfer_size,
    DATEDIFF(SECOND, start_date, finish_date) AS backup_time_sec
FROM ##bt_results
ORDER BY backup_time_sec ASC;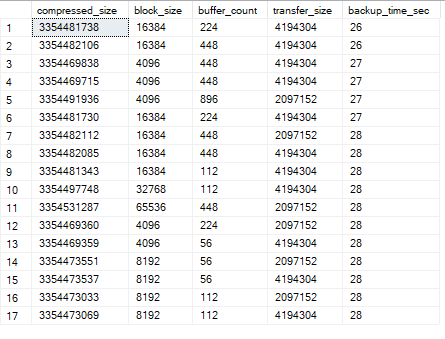
Atenção, uma observação muito importante logo de início de do :
pode-se afirmar com segurança que a relação entre os parâmetros e a velocidade do backup dentro desses limites de valores é aleatória, não há padrão algum. Mas a mudança nos parâmetros padrão, claramente, teve um bom impacto no resultado
Ou seja, apenas através do gerenciamento dos parâmetros padrão do BACKUP, foi obtido um ganho no tempo de realização do backup de 2 vezes: 26 segundos, contra 53 no início. E não é ruim, certo? Mas precisamos verificar como está a recuperação. E se agora a recuperação levar 4 vezes mais?
Para começar, vamos medir quanto tempo leva para restaurar o backup com as configurações padrão:
RESTORE DATABASE [bt]
FROM DISK = 'D:SQLServerbackupbt.bak'
WITH REPLACE, RECOVERY;
Bem, isso você já sabe, os caminhos lá, replace- não replace, recovery- não recovery. E o que eu executei foi assim:
Processadas 1070072 páginas para o banco de dados 'bt', arquivo 'bt' no arquivo 1.
Processadas 2 páginas para o banco de dados 'bt', arquivo 'bt_log' no arquivo 1.
RESTORE DATABASE processou com sucesso 1070074 páginas em 40.752 segundos (205.141 MB/seg).
Agora vou tentar restaurar os backups feitos com BLOCKSIZE, BUFFERCOUNT e MAXTRANSFERSIZE alterados.
BLOCKSIZE = 16384, BUFFERCOUNT = 224, MAXTRANSFERSIZE = 4194304RESTORE DATABASE processou com sucesso 1070074 páginas em 32.283 segundos (258.958 MB/seg).
BLOCKSIZE = 4096, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 4194304RESTORE DATABASE processou com sucesso 1070074 páginas em 32.682 segundos (255.796 MB/seg).
BLOCKSIZE = 16384, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 2097152RESTORE DATABASE processou com sucesso 1070074 páginas em 32.091 segundos (260.507 MB/seg).
BLOCKSIZE = 4096, BUFFERCOUNT = 56, MAXTRANSFERSIZE = 4194304RESTORE DATABASE processou com sucesso 1070074 páginas em 32.401 segundos (258.015 MB/seg).
A instrução RESTORE DATABASE não muda durante a restauração, esses parâmetros não são especificados, o SQL Server os determina pelo backup. E é visível que mesmo durante a restauração há uma vitória — praticamente 20% mais rápido (para ser sincero, não dediquei muito tempo à restauração, testei alguns dos backups mais "rápidos" e confirmei que não há degradação.).
Caso necessário, esclareço — aqui não estão descritos parâmetros ótimos para todos. Os parâmetros ótimos para você só podem ser obtidos através de testes. Eu obtive esses resultados, você obterá outros. Mas você vê que seus backups podem ser "otimizados" e eles realmente podem ser formados e restaurados mais rapidamente.
Além disso, recomendo fortemente ler toda a documentação, pois podem haver nuances específicas para o seu sistema.
Uma vez que comecei a escrever sobre backups, quero imediatamente mencionar outra "otimização" que ocorre mais frequentemente do que o "tuning" de parâmetros (e que, pelo que entendo, é utilizada por pelo menos parte das utilidades de backup, possivelmente junto com os parâmetros descritos anteriormente), mas que ainda não foi descrita no Habr.
Se olharmos para a segunda linha na documentação, logo abaixo de BACKUP DATABASE, vemos:
TO [, ...n]O que você acha que acontecerá se vários backup_device's forem especificados? A sintaxe permite. E será uma coisa muito interessante — o backup simplesmente "se espalhará" por vários dispositivos. Ou seja, cada "dispositivo" separadamente será inútil, se você perder um, perderá todo o backup. Mas como essa distribuição afetará a velocidade do backup?
Vamos tentar fazer um backup em dois "dispositivos" que estão próximos em uma mesma pasta:
BACKUP DATABASE [bt]
TO
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak'
WITH COMPRESSION;
Minha nossa, o que está acontecendo aqui?
Processadas 1070072 páginas para o banco de dados 'bt', arquivo 'bt' no arquivo 1.
Processadas 2 páginas para o banco de dados ‘bt’, arquivo ‘btlog’ no arquivo 1.
O BACKUP DO BANCO DE DADOS foi processado com sucesso, 1070074 páginas em 40.092 segundos (208.519 MB/seg).
O backup foi 25% mais rápido por puro acaso? E se adicionar mais alguns dispositivos?
BACKUP DATABASE [bt]
TO
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak',
    DISK = 'D:SQLServerbackupbt3.bak',
    DISK = 'D:SQLServerbackupbt4.bak'
COM COMPRIMIR;
O BACKUP DO BANCO DE DADOS foi processado com sucesso, 1070074 páginas em 34.234 segundos (244.200 MB/seg).
No total, a economia é de cerca de 35% no tempo de realização do backup, apenas pelo fato de que o backup é gravado simultaneamente em 4 arquivos em um único disco. Testei uma quantidade maior — no meu notebook não houve ganho, o ideal são 4 dispositivos. Para você — não sei, é preciso testar. E, aliás, se esses dispositivos forem realmente discos diferentes, parabéns, o ganho deve ser ainda mais significativo.
Agora, vamos falar sobre como restaurar essa felicidade. Para isso, será necessário alterar o comando de restauração e listar todos os dispositivos:
RESTORE DATABASE [bt]
FROM
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak',
    DISK = 'D:SQLServerbackupbt3.bak',
    DISK = 'D:SQLServerbackupbt4.bak'
COM REPLACE, RECOVERY;
O RESTORE DO BANCO DE DADOS foi processado com sucesso, 1070074 páginas em 38.027 segundos (219.842 MB/seg).
Um pouco mais rápido, mas em algum lugar próximo, não substancial. Em geral, o backup é realizado mais rápido, e a restauração permanece a mesma — sucesso? Para mim, é um sucesso considerável. Isso é importante, portanto, vou repetir — se você perder pelo menos um desses arquivos — perderá todo o backup.
Se observarmos no log as informações do backup, geradas com o Trace Flag 3213 e 3605, podemos notar que, ao fazer backup em vários dispositivos, o número de BUFFERCOUNT, pelo menos, aumenta. Provavelmente, é possível tentar encontrar parâmetros mais otimizados para BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE, mas eu não consegui de imediato, e me deu preguiça fazer esse teste novamente para diferentes quantidades de arquivos. Além disso, lamento pelos discos. Se você deseja organizar esse teste, não é difícil reescrever o script.
No final, vamos falar sobre o preço. Se o backup for realizado paralelamente ao trabalho dos usuários — é necessário abordar os testes com muita responsabilidade, pois se o backup for realizado mais rápido — os discos são mais exigidos, a carga no processador aumenta (ainda é necessário compactar tudo isso em tempo real), consequentemente, a responsividade geral do sistema diminui.
Brincadeiras à parte, eu entendo perfeitamente que não trouxe nenhuma revelação. O que foi escrito acima é apenas uma demonstração de como é possível definir os parâmetros ideais para a realização de backups.
Lembre-se de que tudo o que você faz é por sua conta e risco. Verifique seus backups e não se esqueça do DBCC CHECKDB.
Fonte: habr.com
