

Nota do tradutor.: Este ciclo foi dedicado à apresentação das capacidades do Istio e sua demonstração em ação. Agora, vamos abordar aspectos mais complexos da configuração e uso deste service mesh, especialmente sobre o roteamento finamente ajustável e a gestão do tráfego de rede.
Lembramos também que o artigo utiliza configurações (manifestos para Kubernetes e Istio) do repositório .
Gerenciamento de tráfego
Com o Istio, o cluster ganha novas possibilidades que garantem:
- Roteamento dinâmico de solicitações: lançamentos canários, testes A/B;
- Balanceamento de carga: simples e consistente, baseada em hashes;
- Recuperação de falhas: timeouts, tentativas de repetição, circuit breakers;
- Introdução de falhas: atrasos, interrupções de solicitações, etc.
No decorrer do artigo, essas capacidades serão demonstradas com um aplicativo selecionado e conceitos novos serão introduzidos. O primeiro desses conceitos será DestinationRules (ou seja, regras sobre o destinatário do tráfego/solicitações — nota do tradutor), com as quais ativamos testes A/B.
Teste A/B: DestinationRules na prática
Os testes A/B são aplicados quando existem duas versões de um aplicativo (normalmente, elas diferem visualmente) e não temos 100% de certeza sobre qual delas melhorará a interação com o usuário. Portanto, lançamos ambas as versões simultaneamente e coletamos métricas.
Para implantar a segunda versão do frontend necessária para demonstrar o teste A/B, execute o seguinte comando:
$ kubectl apply -f resource-manifests/kube/ab-testing/sa-frontend-green-deployment.yaml
deployment.extensions/sa-frontend-green criado
O manifesto do deployment para a 'versão verde' difere em dois pontos:
- A imagem é baseada em outra tag —
istio-green, - Os Pods têm o rótulo
version: green.
Como ambos os deployments têm o rótulo app: sa-frontend, as solicitações roteadas pelo serviço virtual sa-external-services para o serviço sa-frontend, serão redirecionadas para todas as suas instâncias e a carga será distribuída através do , resultando na seguinte situação:
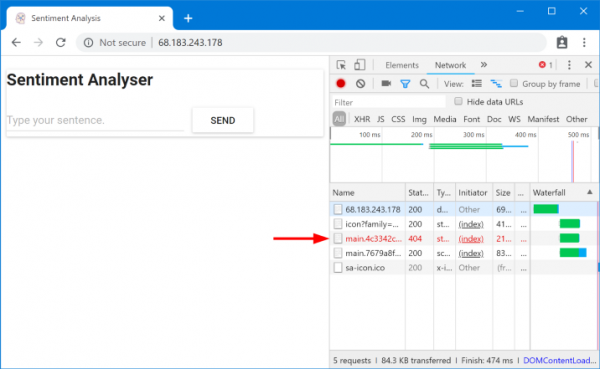
Arquivos requisitados não encontrados
Esses arquivos não foram encontrados porque possuem nomes diferentes em diferentes versões do aplicativo. Vamos nos certificar disso:
$ curl --silent http://$EXTERNAL_IP/ | tr '"' 'n' | grep main
/static/css/main.c7071b22.css
/static/js/main.059f8e9c.js
$ curl --silent http://$EXTERNAL_IP/ | tr '"' 'n' | grep main
/static/css/main.f87cd8c9.css
/static/js/main.f7659dbb.js
Isso significa que index.html, solicitando uma versão dos arquivos estáticos, pode ser enviado por um balanceador de carga para pods que possuem uma versão diferente, onde, por razões óbvias, tais arquivos não existem. Portanto, para que o aplicativo funcione, precisamos impor uma limitação: “a mesma versão do aplicativo que retornou o index.html deve atender às solicitações subsequentes».
Alcançaremos nosso objetivo com balanceamento de carga consistente baseado em hashes (Consistent Hash Loadbalancing). Nesse caso as solicitações de um cliente são enviadas para a mesma instância do backend, para o qual é utilizada uma propriedade predefinida - por exemplo, um cabeçalho HTTP. Isso é implementado usando DestinationRules.
DestinationRules
Depois que VirtualService direcionou a solicitação para o serviço desejado, com o uso de DestinationRules, podemos definir políticas que serão aplicadas ao tráfego destinado às instâncias desse serviço:
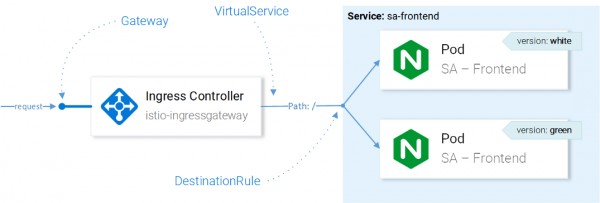
Gerenciamento de tráfego com recursos Istio
Nota: O impacto dos recursos Istio no tráfego de rede é apresentado aqui de forma simplificada para maior compreensão. Para ser mais preciso, a decisão de para qual instância enviar a solicitação é feita pelo Envoy no Ingress Gateway configurado em CRD.
Com as Destination Rules, podemos configurar o balanceamento de carga para que hashes consistentes sejam usados e garantir que respostas da mesma instância do serviço cheguem ao mesmo usuário. A seguinte configuração permite alcançar isso ():
apiVersion: networking.istio.io/v1alpha3
kind: DestinationRule
metadata:
  name: sa-frontend
spec:
  host: sa-frontend
  trafficPolicy:
    loadBalancer:
      consistentHash:
        httpHeaderName: version   # 1
1 — o hash será gerado com base no conteúdo do cabeçalho HTTP version.
Aplique a configuração com o seguinte comando:
$ kubectl apply -f resource-manifests/istio/ab-testing/destinationrule-sa-frontend.yaml
destinationrule.networking.istio.io/sa-frontend criado
Agora, execute o comando abaixo e verifique se você recebe os arquivos corretos ao especificar o cabeçalho version:
$ curl --silent -H "version: yogo" http://$EXTERNAL_IP/ | tr '"' 'n' | grep mainNota: Para adicionar diferentes valores no cabeçalho e testar os resultados diretamente no navegador, você pode usar para Chrome (ou para Firefox — nota do tradutor).
No geral, as DestinationRules têm mais possibilidades em termos de balanceamento de carga - para mais detalhes, consulte .
Antes de prosseguir com o estudo do VirtualService, vamos remover a "versão verde" do aplicativo e a regra correspondente para o direcionamento de tráfego, executando os seguintes comandos:
$ kubectl delete -f resource-manifests/kube/ab-testing/sa-frontend-green-deployment.yaml
deployment.extensions "sa-frontend-green" excluído
$ kubectl delete -f resource-manifests/istio/ab-testing/destinationrule-sa-frontend.yaml
destinationrule.networking.istio.io "sa-frontend" excluído
Espelhamento: Virtual Services na prática
Shadowing ("encapsulamento") ou Mirroring ("espelhamento") é aplicado quando queremos testar uma alteração em produção, sem impactar os usuários finais: para isso, duplicamos ("espelhamos") as solicitações para uma segunda instância, onde as alterações necessárias foram feitas, e observamos as consequências. Em outras palavras, isso acontece quando seu(s) colega(s) escolhe(m) o issue mais crítico e faz(em) um pull request na forma de uma enorme bola de sujeira, que ninguém consegue realmente revisar.
Para verificar esse cenário em ação, vamos criar uma segunda instância do SA-Logic com bugs (buggy), executando o seguinte comando:
$ kubectl apply -f resource-manifests/kube/shadowing/sa-logic-service-buggy.yaml
deployment.extensions/sa-logic-buggy criado
E agora vamos executar o comando para garantir que todas as instâncias com app=sa-logic também tenham rótulos com as versões correspondentes:
$ kubectl get pods -l app=sa-logic --show-labels
NOME                              PRONTO   RÓTULOS
sa-logic-568498cb4d-2sjwj         2/2     app=sa-logic,version=v1
sa-logic-568498cb4d-p4f8c         2/2     app=sa-logic,version=v1
sa-logic-buggy-76dff55847-2fl66   2/2     app=sa-logic,version=v2
sa-logic-buggy-76dff55847-kx8zz   2/2     app=sa-logic,version=v2
Serviço sa-logic focado em pods com o rótulo app=sa-logic, portanto, todas as solicitações serão distribuídas entre todas as instâncias:
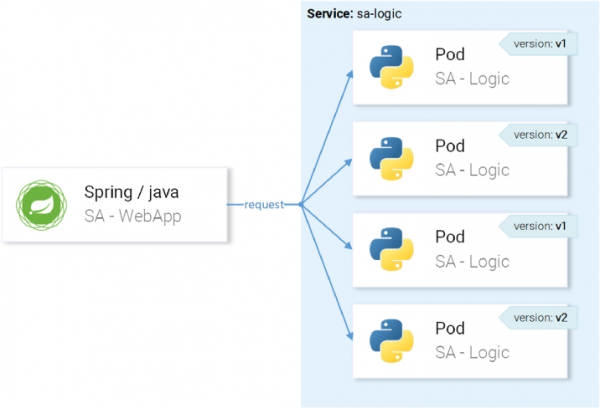
… mas queremos que as solicitações sejam direcionadas para as instâncias com versão v1 e espelhadas nas instâncias com versão v2:
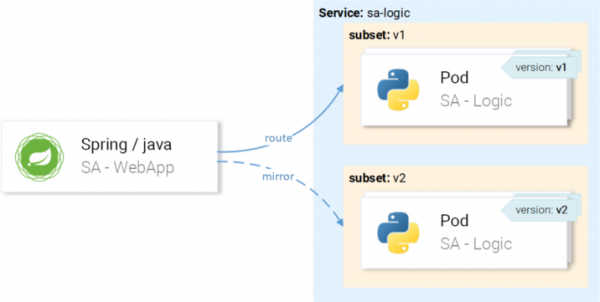
Iremos conseguir isso através do VirtualService em combinação com o DestinationRule, onde as regras definirão subconjuntos e rotas do VirtualService para um subconjunto específico.
Definição de subconjuntos nas Destination Rules
Subconjuntos (subsets) são definidos pela seguinte configuração ():
apiVersion: networking.istio.io/v1alpha3
kind: DestinationRule
metadata:
  name: sa-logic
spec:
  host: sa-logic    # 1
  subsets:
  - name: v1        # 2
    labels:
      version: v1   # 3
  - name: v2
    labels:
version: v2- O host (
host) define que esta regra se aplica apenas nos casos em que o trajeto vai em direção ao serviçosa-logic; - Os nomes (
nome) dos subconjuntos são usados durante a roteação para as instâncias do subconjunto; - O rótulo (
label) define pares chave-valor que as instâncias devem corresponder para se tornarem parte de um subconjunto.
Aplique a configuração com o seguinte comando:
$ kubectl apply -f resource-manifests/istio/shadowing/sa-logic-subsets-destinationrule.yaml
destinationrule.networking.istio.io/sa-logic criado
Agora que os subconjuntos estão definidos, podemos seguir em frente e configurar o VirtualService para aplicar as regras às solicitações para sa-logic, de modo que elas:
- sejam roteadas para o subconjunto
v1, - sejam espelhadas para o subconjunto
v2.
O próximo manifesto permite alcançar o planejado ():
apiVersion: networking.istio.io/v1alpha3
kind: VirtualService
metadata:
  name: sa-logic
spec:
  hosts:
    - sa-logic
  http:
  - route:
    - destination:
        host: sa-logic
        subset: v1
    mirror:
      host: sa-logic
      subset: v2
Explicações aqui não são necessárias, então vamos apenas observar em ação:
$ kubectl apply -f resource-manifests/istio/shadowing/sa-logic-subsets-shadowing-vs.yaml
virtualservice.networking.istio.io/sa-logic criado
Vamos adicionar carga chamando o seguinte comando:
$ while true; do curl -v http://$EXTERNAL_IP/sentiment
    -H "Content-type: application/json"
    -d '{"sentence": "Eu amo yogobella"}';
    sleep .8; done
Vamos ver os resultados no Grafana, onde podemos observar que a versão com bugs (buggy) resulta em falha para ~60% das solicitações, mas nenhuma dessas falhas afeta os usuários finais, pois eles recebem respostas do serviço funcional.
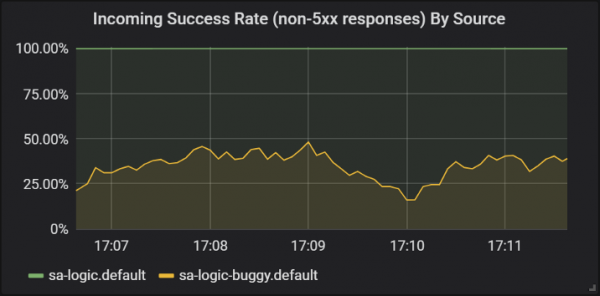
Taxa de sucesso das respostas das diferentes versões do serviço sa-logic
Aqui vimos pela primeira vez como o VirtualService é aplicado em relação aos Envoys de nossos serviços: quando sa-web-app faz uma solicitação para sa-logic, ela passa pelo sidecar Envoy, que — através do VirtualService — está configurado para roteamento da solicitação para o subconjunto v1 e espelhamento da solicitação para o subconjunto v2 do serviço. sa-logic.
Eu sei: você já deve estar pensando que os Virtual Services são simples. Na próxima seção, vamos expandir essa ideia mostrando que eles são realmente magníficos.
Implantações canary
O Canary Deployment é o processo de lançamento de uma nova versão do aplicativo para um pequeno número de usuários. É utilizado para assegurar que não haja problemas na versão e, somente após estar certo da qualidade suficiente (da versão), espalhar para umamaioraudiência maior.
Para demonstrar implantações canárias, continuaremos trabalhando com o subconjunto buggy u sa-logic.
Não vamos ser mesquinhos e já enviamos 20% dos usuários para a versão com bugs (que representará nosso lançamento canário), enquanto os restantes 80% irão para o serviço normal. Para isso, vamos aplicar o seguinte VirtualService ():
apiVersion: networking.istio.io/v1alpha3
kind: VirtualService
metadata:
  name: sa-logic
spec:
  hosts:
    - sa-logic
  http:
  - route:
    - destination:
        host: sa-logic
        subset: v1
      weight: 80         # 1
    - destination:
        host: sa-logic
        subset: v2
      weight: 20 # 1
1 — é o peso (peso), que determina a porcentagem de requisições que serão direcionadas ao destinatário ou subconjunto do destinatário.
Vamos atualizar a configuração anterior do VirtualService com sa-logic o seguinte comando:
$ kubectl apply -f resource-manifests/istio/canary/sa-logic-subsets-canary-vs.yaml
virtualservice.networking.istio.io/sa-logic configurado
… e logo veremos que parte das requisições resulta em falhas:
$ while true; do
   curl -i http://$EXTERNAL_IP/sentiment
   -H "Content-type: application/json"
   -d '{"sentence": "I love yogobella"}'
   --silent -w "Time: %{time_total}s t Status: %{http_code}n"
   -o /dev/null; sleep .1; done
Time: 0.153075s Status: 200
Time: 0.137581s Status: 200
Time: 0.139345s Status: 200
Time: 30.291806s Status: 500
Os VirtualServices ativam lançamentos canários: neste caso, restringimos as consequências potenciais de problemas a 20% da base de usuários. Ótimo! Agora, sempre que não estivermos seguros de nosso código (ou seja, sempre…), podemos usar espelhamento e lançamentos canários.
Timeouts e tentativas novamente
Mas nem sempre os bugs estão no código. Na lista de “”, a primeira se refere à crença errônea de que “a rede é confiável”. Na verdade, a rede não é confiável, e por isso precisamos de timeouts (timeouts) e tentativas novamente (retries).
Para a demonstração, continuaremos usando o mesmo problema versione sa-logic (buggy), e simularemos a falta de confiabilidade da rede com falhas aleatórias.
Vamos imaginar que nosso serviço com bugs tem 1/3 de chance de uma resposta muito demorada, 1/3 de chance de um erro Internal Server Error, e 1/3 de chance de retornar a página com sucesso.
Para mitigar os efeitos desses problemas e melhorar a experiência do usuário, podemos:
- adicionar um timeout, caso o serviço responda por mais de 8 segundos,
- realizar uma nova tentativa se ocorrer uma falha na requisição.
Para isso, usaremos a seguinte definição de recurso ():
apiVersion: networking.istio.io/v1alpha3
kind: VirtualService
metadata:
  name: sa-logic
spec:
  hosts:
    - sa-logic
  http:
  - route:
    - destination:
        host: sa-logic
        subset: v1
      weight: 50
    - destination:
        host: sa-logic
        subset: v2
      weight: 50
    timeout: 8s           # 1
    retries:
      attempts: 3         # 2
perTryTimeout: 3s # 3- O timeout para a requisição está definido em 8 segundos;
- As tentativas de requisições são feitas 3 vezes;
- E cada tentativa é considerada uma falha se o tempo de resposta exceder 3 segundos.
Assim, conseguimos otimizar, pois o usuário não precisará esperar mais de 8 segundos e faremos três novas tentativas para obter uma resposta em caso de falhas, aumentando a chance de uma resposta bem-sucedida.
Aplique a configuração atualizada com o seguinte comando:
$ kubectl apply -f resource-manifests/istio/retries/sa-logic-retries-timeouts-vs.yaml
virtualservice.networking.istio.io/sa-logic configurado
E verifique nos gráficos do Grafana se o número de respostas bem-sucedidas aumentou para além de:
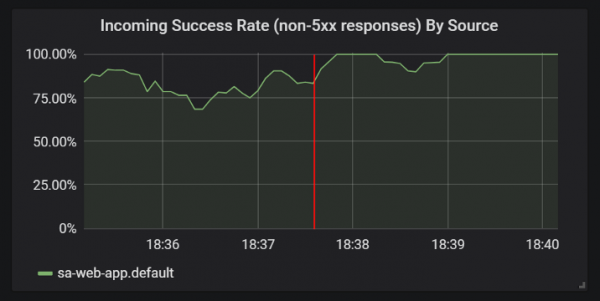
Melhorias nas estatísticas de respostas bem-sucedidas após a adição de timeouts e tentativas.
Antes de prosseguir para a próxima seção, (ou melhor, já para a próxima parte do artigo, pois nesta não haverá mais experimentos práticos – nota do tradutor.), remova sa-logic-buggy e VirtualService, executando os seguintes comandos:
$ kubectl delete deployment sa-logic-buggy
deployment.extensions “sa-logic-buggy” excluído
$ kubectl delete virtualservice sa-logic
virtualservice.networking.istio.io “sa-logic” excluído
Padrões Circuit Breaker e Bulkhead
Estamos falando de dois padrões importantes na arquitetura de microsserviços que permitem a auto-recuperação (self-healing) dos serviços.
Circuit Breaker (“disjuntor”) é usado para interromper solicitações que chegam a uma instância de serviço considerada não saudável, e sua recuperação enquanto as solicitações dos clientes são redirecionadas para instâncias saudáveis desse serviço (o que aumenta a porcentagem de respostas bem-sucedidas). (Nota do tradutor: Uma descrição mais detalhada do padrão pode ser encontrada, por exemplo, .)
Bulkhead (“compartimento”) isola falhas nos serviços para evitar que afetem todo o sistema. Por exemplo, se o serviço B estiver quebrado, e outro serviço (cliente do serviço B) fizer uma solicitação ao serviço B, isso consumirá seu pool de threads e ele não poderá atender a outras solicitações (mesmo que não estejam relacionadas ao serviço B). (Nota do tradutor: Uma descrição mais detalhada do padrão pode ser encontrada, por exemplo, .)
Vou pular os detalhes sobre a implementação desses padrões, porque é fácil encontrá-los em , e também já é muito desejável mostrar autenticação e autorização, que será o foco na próxima parte do artigo.
P.S. do tradutor
Confira também em nosso blog:
- «De Volta aos Microserviços com Istio»: , ;
- «»;
- «».
Fonte: habr.com
