

Entre engenheiros SRE/DevOps, não é surpresa que, em algum momento, um cliente (ou um sistema de monitoramento) reclame que "tudo está perdido": o site não está funcionando, os pagamentos não estão sendo processados, a vida é um tédio... Por mais que queiramos ajudar em uma situação assim, isso pode ser muito difícil sem uma ferramenta simples e clara. Muitas vezes, o problema está escondido no próprio código do aplicativo — só precisamos localizá-lo.
Nas alegrias e nas tristezas…
De fato, já amamos o New Relic há bastante tempo. Ele tem sido e continua a ser uma excelente ferramenta para monitoramento de desempenho de aplicativos, além de permitir instrumentar a arquitetura de microsserviços (através de seu agente) e muito mais. E tudo poderia ser maravilhoso, se não fossem as mudanças na política de preços do serviço: ele custo aumentou mais de 3 vezes. Além disso, desde o ano passado, para obter uma conta de teste, é necessário interagir com um gerente pessoal, o que dificulta a apresentação do produto para o potencial cliente.
Situação comum: o New Relic não é necessário em "base contínua", sendo lembrado apenas quando surgem problemas. Mas é preciso pagar regularmente (140 USD por servidor por mês), e em uma infraestrutura de nuvem que se escala automaticamente, os valores podem se acumular substancialmente. Embora exista a opção "Pay-As-You-Go", ativar o New Relic exige reiniciar o aplicativo, o que pode resultar na perda da situação problemática que motivou tudo isso. Recentemente, o New Relic lançou um novo plano tarifário — , — que à primeira vista parece uma alternativa razoável ao Professional… mas, ao analisá-lo mais de perto, constatamos que algumas funcionalidades importantes estão ausentes (em particular, não possui Transações Principais, Rastreamento de Aplicações Cruzadas, Rastreamento Distribuído).
Como resultado, começamos a considerar a busca por alternativas mais baratas, e nossa escolha recaiu sobre dois serviços: Datadog e Atatus. Por que exatamente esses?
Sobre os concorrentes
Devo esclarecer que existem outras soluções no mercado. Nós até consideramos opções de Código Aberto, mas nem todo cliente tem recursos disponíveis para implementar soluções do tipo self-hosted... — além disso, elas exigiriam manutenção adicional. A dupla que escolhemos se mostrou a mais próxima de nossas necessidades:
- suporte integrado e avançado para aplicações PHP (o stack dos nossos clientes é bastante diversificado, mas esta é uma escolha clara em busca de uma alternativa ao New Relic);
- preço acessível (menos de 100 USD por mês para hospedagem);
- instrumentação automática;
- integração com Kubernetes;
- semelhança com a interface do New Relic — um ponto positivo (pois nossos engenheiros estão acostumados com ela).
Portanto, na fase inicial de seleção, descartamos várias outras soluções populares, especificamente:
- Tideways, AppDynamics e Dynatrace — devido ao custo;
- Stackify — bloqueado na Rússia e fornece dados muito limitados.
O artigo a seguir é estruturado de tal forma que inicialmente apresentaremos brevemente as soluções consideradas, após o que falarei sobre nossa interação típica com o New Relic e experiências/impressões ao realizar operações semelhantes em outros serviços.
Apresentação dos concorrentes selecionados
Sobre , provavelmente, todo mundo já ouviu falar? Este serviço começou seu desenvolvimento há mais de 10 anos, em 2008. Usamos ativamente desde 2012 e não tivemos problemas com a integração de um número realmente grande de aplicações nas linguagens PHP, Ruby e Python, além de termos experiência em integração com C# e Go. Os criadores do serviço oferecem soluções para monitoramento de aplicações, infraestrutura, rastreamento de infraestruturas de microsserviços, aplicativos convenientes para dispositivos do usuário e muito mais.
No entanto, o agente do New Relic funciona com protocolos proprietários, sem suporte ao OpenTracing. Para instrumentação avançada, são necessárias alterações específicas para o New Relic. Por fim, o suporte ao Kubernetes ainda tem um status experimental.
Começou seu desenvolvimento em 2010 parece muito mais interessante que o New Relic em termos de aplicação em ambientes Kubernetes. Em particular, ele suporta integração com NGINX Ingress, coleta de logs, protocolos statsd e OpenTracing, permitindo rastrear a solicitação do usuário desde a conexão até a conclusão do trabalho, assim como localizar logs dessa solicitação (tanto no lado do servidor web quanto no lado dos consumidores).
Ao usar o Datadog, enfrentamos o problema de que, às vezes, ele construía incorretamente o mapa de microsserviços e apresentava algumas deficiências técnicas. Por exemplo, identificou incorretamente o tipo de serviço (confundiu Django com um serviço de cache) e causou erros 500 em uma aplicação PHP que utiliza a popular biblioteca Predis.
— a ferramenta mais jovem; o serviço foi lançado em 2014. Seu orçamento de marketing é claramente inferior ao dos concorrentes mencionados, e suas menções são significativamente menos frequentes. No entanto, a ferramenta em si é muito semelhante ao New Relic, tanto em suas funcionalidades (APM, Monitoramento de Navegador, etc.), quanto na aparência.
Uma desvantagem significativa é o suporte apenas para Node.js e PHP. Por outro lado, esse suporte é implementado de maneira muito superior à do Datadog. Ao contrário deste, Atatus não exige modificações nos aplicativos ou a adição de etiquetas extras no código.
Como trabalhamos com o New Relic
Agora vamos entender como normalmente usamos o New Relic. Suponha que temos um problema que precisa ser resolvido:
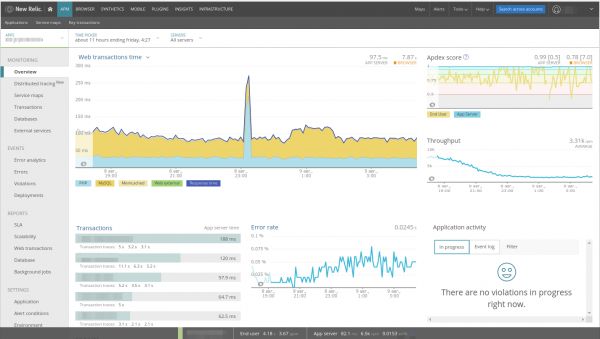
É fácil perceber no gráfico um pico — vamos analisá-lo. No New Relic, para a aplicação web, as transações web são selecionadas imediatamente, e no gráfico de desempenho estão todos os componentes, com painéis de taxa de erros, taxa de requisições… O principal é que diretamente desses painéis podemos navegar entre diferentes partes da aplicação (por exemplo, clicar em MySQL levará à seção de bancos de dados).
Como no exemplo analisado temos um pico de atividade PHP, vamos clicar neste gráfico e automaticamente iremos para Transações:
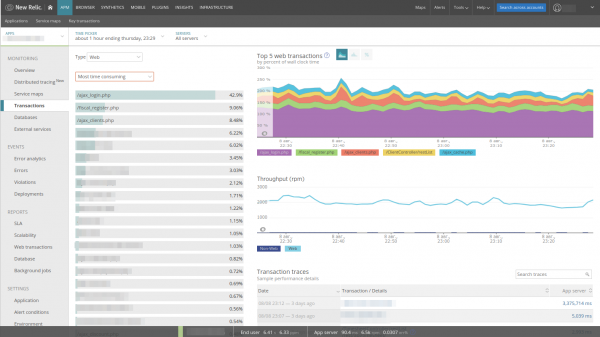
A lista de transações, que essencialmente são os controladores do modelo MVC, já está ordenada por Maior consumo de tempo, o que é muito conveniente: já podemos ver o que a aplicação está fazendo. Aqui também estão exemplos de requisições longas, que são coletadas automaticamente pelo New Relic. Alterando a ordenação, fica fácil encontrar:
- o controlador mais carregado da aplicação;
- o controlador mais frequentemente requisitado;
- o controlador mais lento.
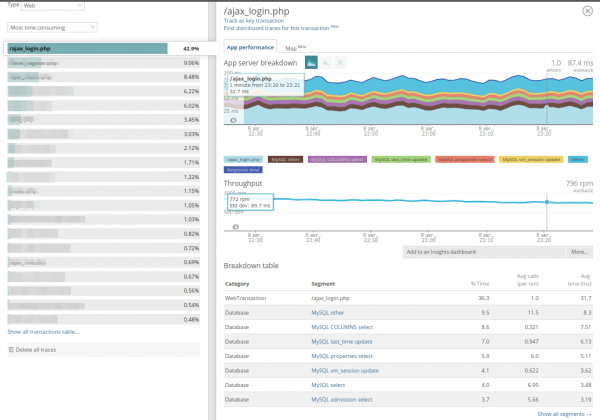
Além disso, é possível expandir cada transação e ver o que a aplicação estava realizando no momento da execução do código:
Finalmente, a aplicação mantém exemplos de rastros de requisições longas (que demoram mais de 2 segundos para serem processadas). Aqui está o painel para uma transação longa:
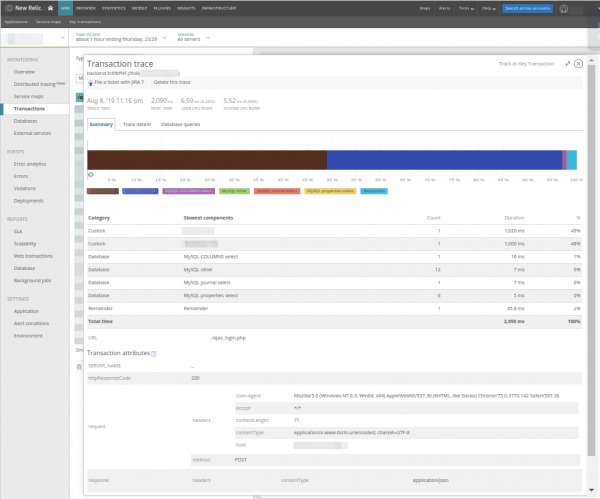
É visível que dois métodos estão consumindo muito tempo, e junto a isso é mostrado também o momento em que a requisição foi executada, seu URI e domínio. Muitas vezes, isso ajuda a encontrar a requisição nos logs. Ao acessar Detalhes do rastreio, podemos ver de onde esses métodos são chamados:
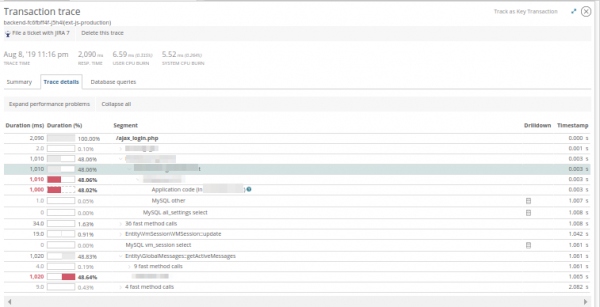
E em Consultas ao banco de dados — avaliar as consultas ao banco de dados que estavam sendo executadas no momento em que a aplicação estava em operação:
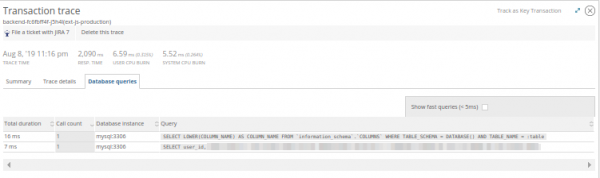
Armados com esse conhecimento, podemos avaliar a causa da lentidão do aplicativo e desenvolver uma estratégia de solução de problemas junto com o desenvolvedor. Na realidade, o New Relic nem sempre oferece uma visão clara, mas ajuda a escolher uma direção para a investigação:
- longo
PDO::Constructnos levou a um funcionamento estranho do pgpoll; - instabilidade ao longo do tempo
Memcache::Getindicou uma configuração incorreta da máquina virtual; - o tempo de processamento suspeitosamente alto do template levou a um loop aninhado verificando a presença de 500 avatares no armazenamento de objetos;
- e assim por diante…
Às vezes, em vez de executar o código na tela principal, algo relacionado ao armazenamento externo de dados cresce — não importa o que seja: Redis ou PostgreSQL — todos eles se escondem na aba Databases.
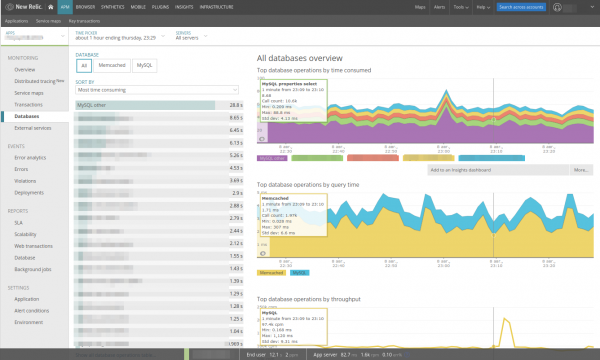
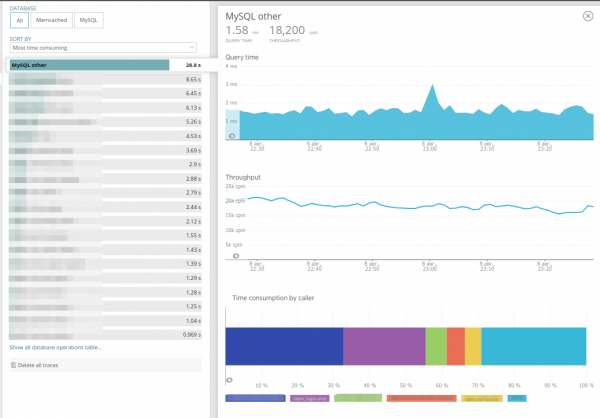
É possível selecionar um banco de dados específico para pesquisa e classificar as consultas — semelhante ao que é feito em Transactions. Ao acessar a aba de consultas, é possível ver quantas vezes essa consulta aparece em cada um dos controladores do aplicativo, além de avaliar com que frequência ela é chamada. Isso é muito conveniente:
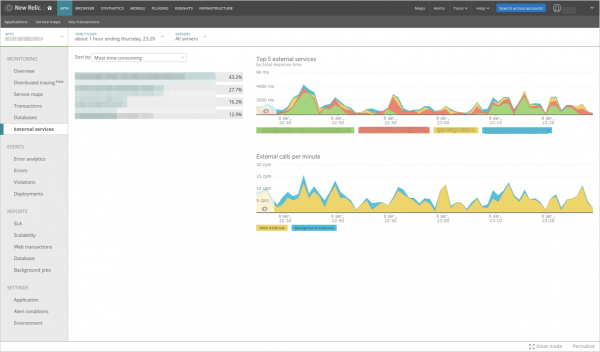
Dados semelhantes estão na aba Serviços Externos, que esconde as consultas a serviços HTTP externos, como chamadas para armazenamento de objetos, envio de eventos para o Sentry ou algo do tipo. O conteúdo da aba é totalmente análogo ao Databases:
Concorrentes: capacidades e impressões
Agora, a parte mais interessante — vamos comparar as capacidades do New Relic com o que os concorrentes oferecem. Infelizmente, não conseguimos testar todas as três ferramentas em uma versão do mesmo aplicativo em produção. No entanto, esforçamo-nos para comparar situações/configurações o mais idênticas possível.
1. Datadog
O Datadog nos recebe com um painel de serviços:
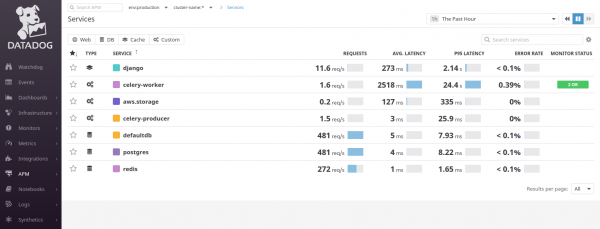
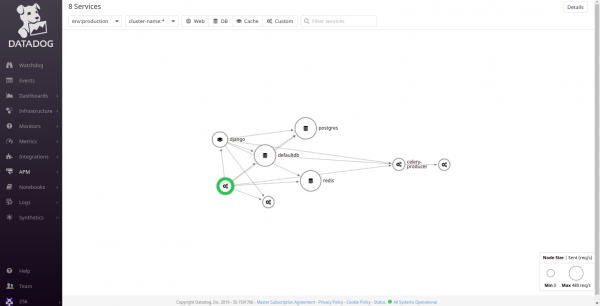
Ele tenta dividir os aplicativos em componentes/microserviços, portanto, no exemplo dado do aplicativo Django, veremos 2 conexões ao PostgreSQL (defaultdb e postgres), além de Celery e Redis. Trabalhar com o Datadog exige de você um conhecimento mínimo dos princípios MVC: é necessário entender para onde vão as solicitações dos usuários. Geralmente, isso é auxiliado por um mapa de serviços:
A propósito, algo semelhante também está no New Relic:
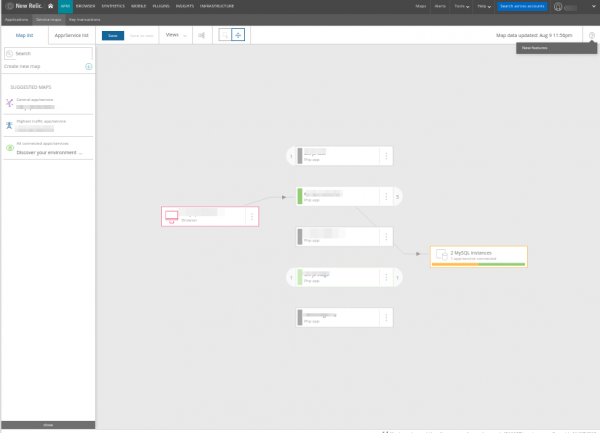
… a sua interface, na minha opinião, é mais simples e clara: ela exibe não os componentes de uma única aplicação (o que a tornaria excessivamente detalhada, como no caso do Datadog), mas apenas serviços ou microsserviços específicos.
Voltando ao Datadog: a partir do mapa de serviços, é possível ver que as solicitações dos usuários chegam ao Django. Vamos para o serviço Django e finalmente veremos o que esperávamos:
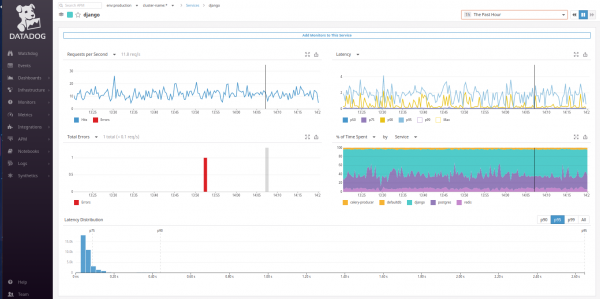
Infelizmente, por padrão, não há gráfico aqui Tempo de transação na Web, semelhante ao que vemos no painel principal do New Relic. No entanto, é possível configurá-lo no lugar do gráfico % do Tempo gasto. Basta alternar para Tempo médio por solicitação por Tipo… e já temos o gráfico conhecido olhando para nós!
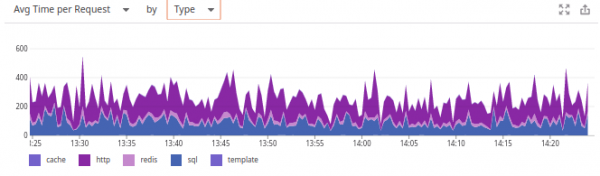
Por que o Datadog optou por um gráfico diferente é um mistério para nós. Fiquei também chateado pelo fato de que o sistema não lembra a escolha do usuário (ao contrário de ambos os concorrentes), portanto, só é possível criar painéis personalizados.
Mas fiquei agradavelmente surpreso com a possibilidade no Datadog de alternar entre esses gráficos para as métricas dos servidores relacionados, ler os logs e avaliar a carga dos manipuladores do servidor web (Gunicorn). É quase como no New Relic… e até um pouco mais (logs)!
Abaixo dos gráficos estão as transações, completamente análogas ao New Relic:
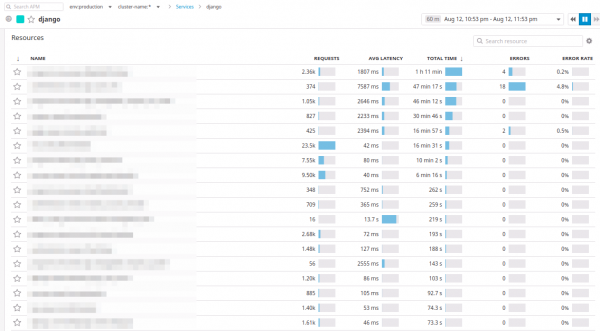
No Datadog, as transações são chamadas de recursos. É possível classificar os controladores por número de solicitações, pelo tempo médio de resposta ou pelo tempo máximo gasto durante o intervalo de tempo selecionado.
O recurso pode ser expandido e podemos ver tudo o que já observamos no New Relic:
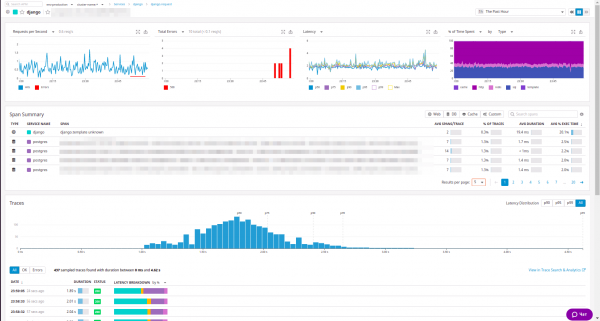
Estão disponíveis estatísticas do recurso, uma lista resumida de chamadas internas e amostras de solicitações que podem ser classificadas por código de resposta… Vale mencionar que essa classificação agradou muito nossos engenheiros.
Qualquer exemplo de recurso no Datadog pode ser expandido e examinado:
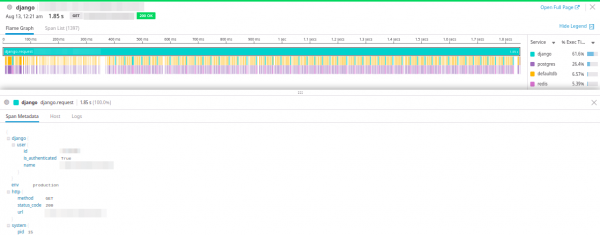
Os parâmetros da solicitação são apresentados, um gráfico resumido do tempo gasto em cada componente e um gráfico de cascata, onde é visível a sequência das chamadas. Há também a opção de alternar para a visualização em árvore do gráfico de cascata:
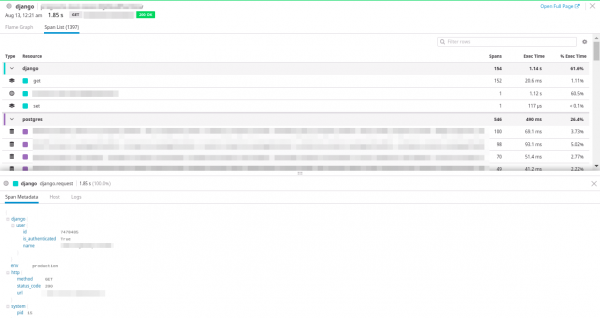
E o mais interessante — a visualização da carga do host onde a solicitação foi executada e a visualização dos logs da solicitação.
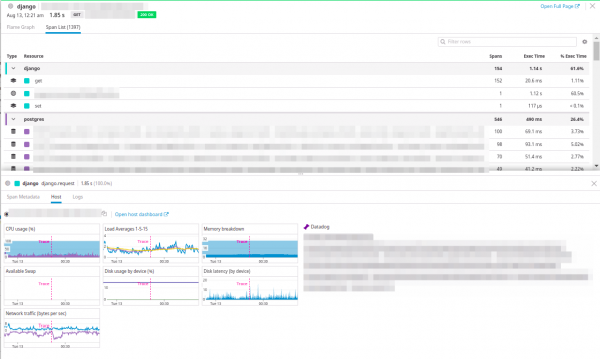
Ótima integração!
Pode surgir a pergunta sobre onde estão as abas Databases e Serviços Externos, como no New Relic. Aqui elas não existem: como o Datadog analisa a aplicação em componentes, o PostgreSQL será considerado um serviço separado, e em vez de Serviços Externos, deve-se procurar por aws.storage (será o mesmo para cada outro serviço externo ao qual o aplicativo possa se conectar).
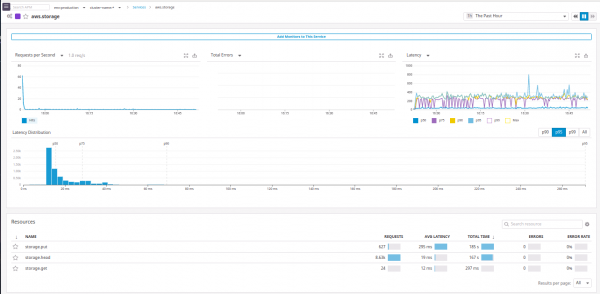
Aqui está um exemplo de postgres:
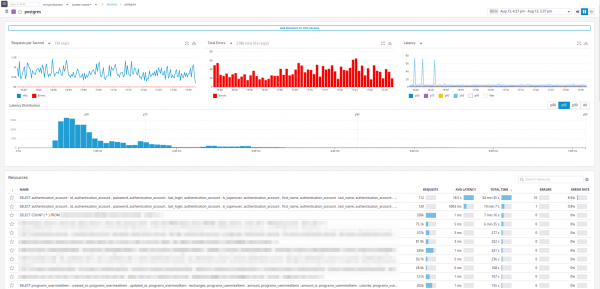
Na verdade, temos tudo o que desejávamos:
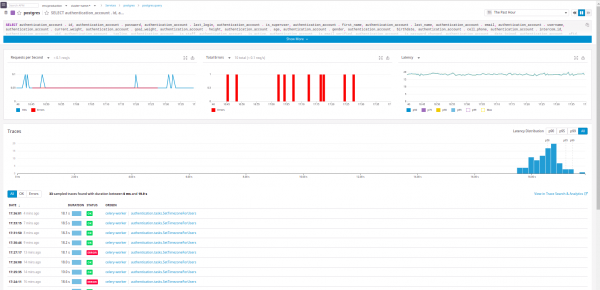
É visível de qual 'serviço' a solicitação veio.
Vale lembrar que o Datadog se integra perfeitamente com o NGINX Ingress e permite rastreamento completo desde o momento em que a solicitação chega ao cluster, além de admitir métricas statsd, coletar logs e métricas de hosts.
Um enorme ponto positivo do Datadog é que seu preço é composto por monitoramento de infraestrutura, APM, gerenciamento de logs e testes sintéticos, ou seja, é possível escolher um plano de forma flexível.
2. Atatus
A equipe da Atatus afirma que seu serviço é "igual ao New Relic, mas melhor". Vamos ver se isso é verdade.
O painel realmente parece semelhante, mas não conseguimos identificar o Redis e o memcached usados no aplicativo.
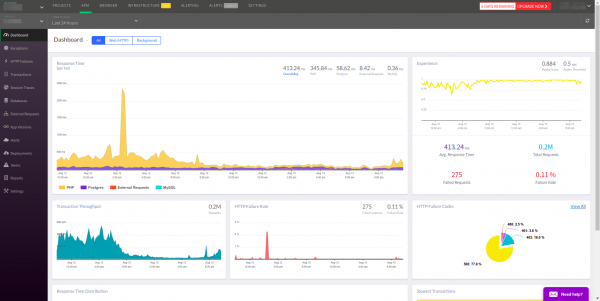
O APM, por padrão, escolhe todas as transações, embora, na maioria das vezes, sejam necessárias apenas as Web. Assim como no Datadog, não há como ir para o serviço desejado a partir do painel principal. Além disso, as transações aparecem na lista após os erros, o que não parece muito lógico para um APM.
Nas transações da Atatus, tudo é muito parecido com o New Relic. Um ponto negativo é que a dinâmica para cada um dos controladores não é imediatamente visível. É necessário procurá-la na tabela de controladores, classificando por Most Time Consumed:
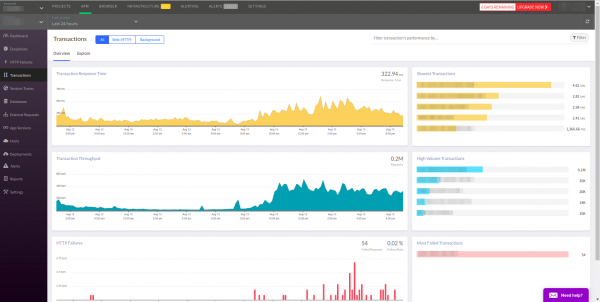
A lista de controladores que conhecemos está disponível na aba Explore:
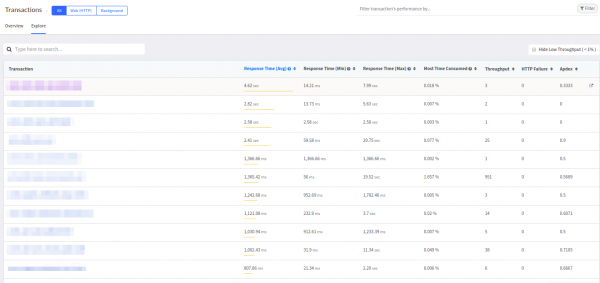
De certa forma, essa tabela lembra o Datadog e é mais agradável do que a correspondente no New Relic.
Cada transação pode ser expandida e você pode ver o que o aplicativo estava fazendo:
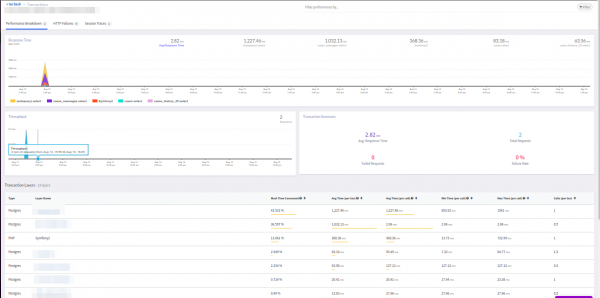
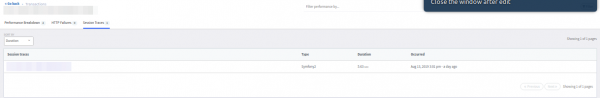
O painel também lembra mais o Datadog: há o número de solicitações, uma visão geral das chamadas. O painel superior fornece uma aba com erros HTTP Failures e exemplos de solicitações lentas Session Traces:
Se você entrar na transação, verá um exemplo do traçado, pode obter uma lista de solicitações ao banco de dados e observar os cabeçalhos da solicitação. Tudo semelhante ao New Relic:
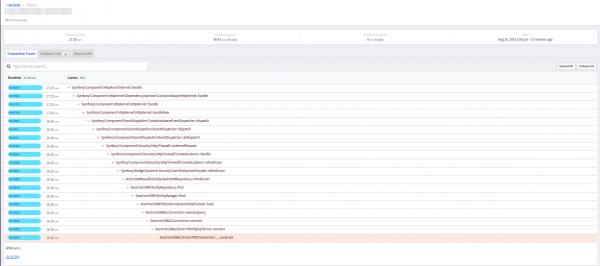
No geral, a Atatus impressionou com os detalhes dos traços — sem as típicas combinações de chamadas em um bloco de lembrete como no New Relic:
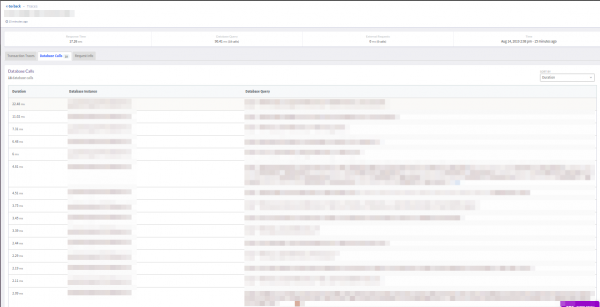
No entanto, aqui falta um filtro que (como no New Relic) elimine solicitações muito rápidas (<5ms). Por outro lado, a exibição da resposta final da transação (se bem-sucedida ou erro) foi agradável.
Painel Databases ajudará a examinar as solicitações a bancos de dados externos que o aplicativo faz. Lembro que o Atatus identificou apenas PostgreSQL e MySQL, embora no projeto também estejam envolvidos Redis e memcached.
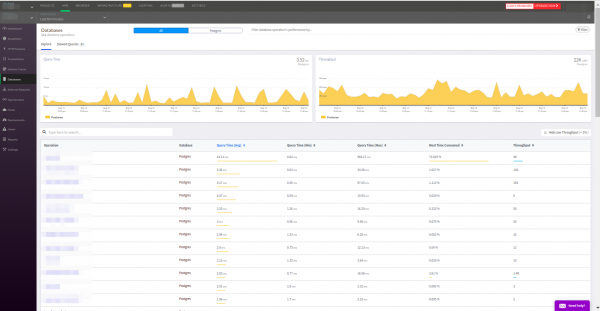
As solicitações são classificadas por critérios habituais: frequência de ativação, tempo médio de resposta e assim por diante. É interessante destacar a guia com as solicitações mais lentas - isso é muito conveniente. Além disso, os dados nesta guia para PostgreSQL coincidiram com os dados da extensão — excelente resultado!
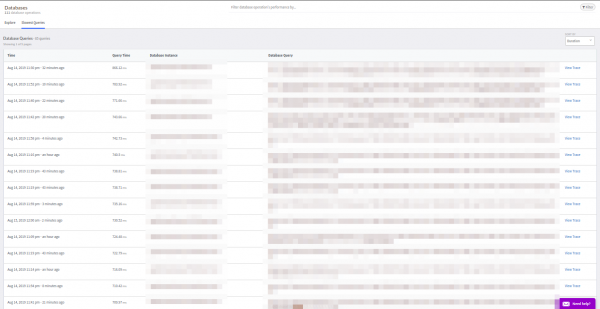
Guia Solicitações Externas é idêntica a Databases.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Ambas as ferramentas apresentadas se saíram bem como APM. Qualquer uma delas pode oferecer o mínimo necessário. Podemos resumir nossas impressões da seguinte forma:
Datadog
Acesso direto aos sistemas de cabos transpacíficos. Ping mínimo para a China, Japão, Austrália e costa oeste dos EUA.
- grade tarifária conveniente (APM custa 31 USD por host);
- mostrou-se excelente com Python;
- possibilidade de integração com OpenTracing
- integração com Kubernetes;
- integração com NGINX Ingress.
Pontos negativos:
- o único APM que causou a indisponibilidade do aplicativo devido a um erro do módulo (predis);
- autoinstrumentação de PHP fraca;
- definição e designação de serviços um tanto estranha.
Atatus
Acesso direto aos sistemas de cabos transpacíficos. Ping mínimo para a China, Japão, Austrália e costa oeste dos EUA.
- instrumentação profunda de PHP;
- interface do usuário semelhante à do New Relic.
Pontos negativos:
- não funciona em sistemas operacionais antigos (Ubuntu 12.05, CentOS 5);
- autoinstrumentação fraca;
- suporte a apenas duas linguagens de programação (Node.js e PHP);
- interface de trabalho lenta.
Considerando o preço do Atatus de 69 USD por mês por servidor, provavelmente usaríamos o Datadog, que se integra muito bem às nossas necessidades (aplicativos web em K8s) e possui várias funções úteis.
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
