

Os dias em que você não precisava se preocupar com a otimização do desempenho de bancos de dados já passaram. O tempo não para. Cada novo empresário do setor de tecnologia deseja criar mais um Facebook, buscando coletar todos os dados que pode alcançar. Esses dados são essenciais para os negócios, permitindo um treinamento mais eficaz de modelos que ajudam a lucrar. Nessas condições, os programadores precisam criar APIs que permitam trabalhar de forma rápida e confiável com grandes volumes de informações.
Se você já está projetando por um tempo as partes de servidor de aplicativos ou bancos de dados, provavelmente você escreveu código para executar consultas com paginação. Por exemplo — assim:
SELECT * FROM table_name LIMIT 10 OFFSET 40
É assim mesmo?
Mas se você tem feito a paginação dessa forma, lamento informar que você não estava fazendo isso da maneira mais eficiente.
Você quer contestar isso? . , e já aplicam as técnicas que quero discutir hoje.
Nomeie pelo menos um desenvolvedor de back-end que nunca usou OFFSET e LIMIT para executar consultas com paginação. Em MVP (Produto Mínimo Viável) e em projetos que usam pequenos volumes de dados, essa abordagem é bastante aplicável. Funciona, por assim dizer.
Mas se você precisa construir sistemas confiáveis e eficientes do zero, deve se preocupar com a eficiência da execução de consultas aos bancos de dados utilizados nesses sistemas desde o início.
Hoje, falaremos sobre os problemas associados às implementações amplamente utilizadas (infelizmente) dos mecanismos de execução de consultas com paginação, e como atingir alta performance ao executar essas consultas.
O que há de errado com OFFSET e LIMIT?
Como já mencionado, OFFSET e LIMIT têm um ótimo desempenho em projetos que não exigem trabalhar com grandes volumes de dados.
O problema surge quando o banco de dados cresce a ponto de não caber mais na memória do servidor. Mas, ao mesmo tempo, você precisa utilizar consultas com paginação para trabalhar com esse banco de dados.
Para que esse problema se manifeste, é necessário que surja uma situação em que o SGBD recorra a uma operação ineficiente de varredura completa da tabela (Full Table Scan) ao executar cada consulta com paginação (ao mesmo tempo, podem ocorrer operações de inserção e exclusão de dados, e dados obsoletos não nos interessam!).
O que é uma "varredura completa da tabela" (ou "exibição sequencial da tabela", Sequential Scan)? Trata-se de uma operação na qual o SGBD lê sequencialmente cada linha da tabela, ou seja, os dados contidos nela, e verifica se atendem a uma condição específica. Sabe-se que esse tipo de varredura de tabelas é o mais lento. O motivo é que, ao realizá-la, muitas operações de entrada/saída são realizadas, envolvendo o subsistema de disco do servidor. A situação é agravada pelos atrasos associados ao trabalho com dados armazenados em discos e pelo fato de que a transferência de dados do disco para a memória é uma operação que consome muitos recursos.
Por exemplo, você possui registros de 100000000 usuários, e está realizando uma consulta com a estrutura OFFSET 50000000. Isso significa que o SGBD terá que carregar todos esses registros (e eles nem nos interessam!), colocá-los na memória e, após isso, pegar, por exemplo, 20 resultados, conforme informado em LIMIT.
Digamos que isso pode ser assim: "selecionar linhas de 50000 a 50020 de 100000". Ou seja, para o sistema executar a consulta, será necessário primeiro carregar 50000 linhas. Vê como há muito trabalho desnecessário a ser feito?
Se você não acredita, dê uma olhada no exemplo que criei usando as funcionalidades de .
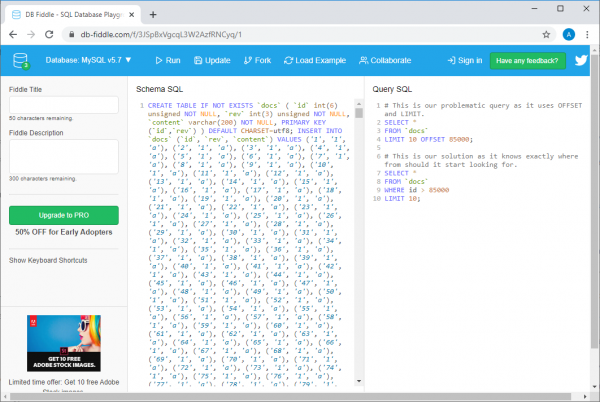
Exemplo no db-fiddle.com
Lá, à esquerda, no campo Schema SQL, há um código que insere 100000 linhas no banco de dados, e à direita, no campo Query SQL, estão mostradas duas consultas. A primeira, lenta, é assim:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
E a segunda, que representa uma solução eficiente para a mesma tarefa, é assim:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Para executar essas consultas, basta clicar no botão Run na parte superior da página. Fazendo isso, vamos comparar as informações sobre o tempo de execução das consultas. Descobre-se que a execução de uma consulta ineficiente demora, no mínimo, 30 vezes mais que a execução da segunda (de execução para execução, esse tempo varia; por exemplo, o sistema pode relatar que a execução da primeira consulta levou 37 ms, enquanto a da segunda levou 1 ms).
E se houver mais dados, a situação ficará ainda pior (para verificar isso, veja meu com 10 milhões de linhas).
O que acabamos de discutir deve lhe dar uma certa compreensão de como, na verdade, as consultas às bases de dados são processadas.
Considere que quanto maior o valor OFFSET — mais tempo a consulta levará.
O que deve ser usado em vez da combinação OFFSET e LIMIT?
Em vez da combinação OFFSET e LIMIT deve-se usar uma construção organizada de forma a:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Esta é uma execução de consulta com paginação, baseada em cursor (Cursor based pagination).
Em vez de armazenar localmente os atuais OFFSET e LIMIT e transmiti-los a cada consulta, deve-se armazenar a última chave primária recebida (normalmente, é ID) e LIMIT, e assim se obtêm consultas semelhantes àquela acima.
Por quê? O fato é que, ao especificar explicitamente o identificador da última linha lida, você informa ao seu SGBD onde ele deve começar a busca pelos dados necessários. Além disso, a busca, graças ao uso da chave, será realizada de forma eficiente, e o sistema não precisará se distrair com as linhas fora do intervalo especificado.
Vamos dar uma olhada na seguinte comparação de desempenho de várias consultas. Aqui está uma consulta ineficiente.
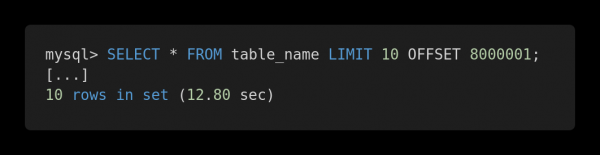
Consulta lenta
E aqui está — a versão otimizada dessa consulta.
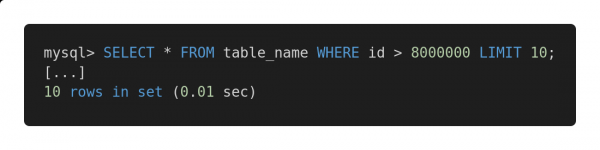
Consulta rápida
Ambas as consultas retornam exatamente o mesmo volume de dados. Mas a execução da primeira leva 12,80 segundos, enquanto a da segunda leva 0,01 segundo. Você sente a diferença?
Problemas potenciais
Para garantir o funcionamento eficaz do método proposto para a execução de consultas, é necessário que a tabela tenha uma coluna (ou colunas) contendo índices exclusivos e sequenciais, como um identificador inteiro. Em alguns casos específicos, isso pode determinar o sucesso da aplicação de tais consultas para aumentar a velocidade de operação com o banco de dados.
Naturalmente, ao construir consultas, é preciso considerar as características da arquitetura das tabelas e escolher os mecanismos que se destacam nas tabelas existentes. Por exemplo, se for necessário trabalhar em consultas com grandes volumes de dados relacionados, você pode achar interessante artigo.
Se enfrentamos o problema da falta de uma chave primária, por exemplo, se tivermos uma tabela com um relacionamento "muitos-para-muitos", a abordagem tradicional que prevê a utilização OFFSET e LIMIT, certamente se aplicará. Mas sua aplicação pode levar à execução de consultas potencialmente lentas. Nesses casos, eu recomendaria usar uma chave primária com incremento automático, mesmo que seja necessária apenas para organizar a execução de consultas com paginação.
Se você tem interesse nesse tema — , e — aqui estão alguns materiais úteis.
Resultados
A principal conclusão que podemos tirar é que, independentemente do tamanho dos bancos de dados, é sempre necessário analisar a velocidade de execução das consultas. Nos dias de hoje, a escalabilidade das soluções é extremamente importante, e se desde o início do trabalho em um sistema tudo for projetado corretamente, isso pode, no futuro, livrar o desenvolvedor de muitos problemas.
Como você analisa e otimiza as consultas em bancos de dados?
Fonte: habr.com
