

O LINQ entrou no .NET como uma nova linguagem poderosa para manipulação de dados. O LINQ to SQL, como parte dele, permite uma comunicação bastante conveniente com bancos de dados usando, por exemplo, o Entity Framework. No entanto, ao utilizá-lo com frequência, os desenvolvedores costumam esquecer de observar qual consulta SQL será gerada pelo provedor queryable, no seu caso — Entity Framework.
Vamos discutir dois pontos principais através de um exemplo.
Para isso, no SQL Server, criaremos um banco de dados Teste e, dentro dele, criaremos duas tabelas com o seguinte comando:
Criação de tabelas
USE [TESTE]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TESTE]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Agora vamos preencher a tabela Ref executando o seguinte script:
Preenchimento da tabela Ref
USE [TESTE]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Analogamente, iremos preencher a tabela Customer com o seguinte script:
Preenchimento da tabela Customer
USE [TEST]
GO

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

WHILE(@ind<=12000000)
BEGIN
	IF(@ind%3=0) SET @ind_ref=1;
	ELSE IF (@ind%5=0) SET @ind_ref=2;
	ELSE IF (@ind%7=0) SET @ind_ref=3;
	ELSE IF (@ind=0) SET @ind_ref=4;
	ELSE IF (@ind=0) SET @ind_ref=5;
	ELSE IF (@ind=0) SET @ind_ref=6;
	ELSE IF (@ind=0) SET @ind_ref=7;
	ELSE IF (@ind=0) SET @ind_ref=8;
	ELSE IF (@ind=0) SET @ind_ref=9;
	ELSE IF (@ind=0) SET @ind_ref=10;
	ELSE IF (@ind=0) SET @ind_ref=11;
	ELSE SET @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SELECT
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
END
GO
Assim, conseguimos duas tabelas, uma com mais de 1 milhão de linhas de dados e a outra com mais de 10 milhões de linhas de dados.
Agora, no Visual Studio, é necessário criar um projeto de teste Visual C# Console App (.NET Framework):
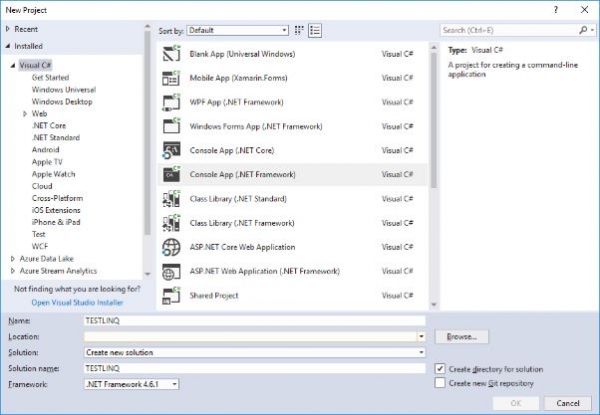
Em seguida, é necessário adicionar a biblioteca para interação com o banco de dados para o Entity Framework.
Para adicionar, clique com o botão direito no projeto e selecione no menu de contexto Gerenciar Pacotes NuGet:
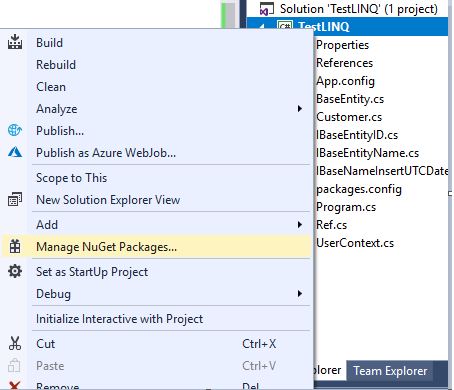
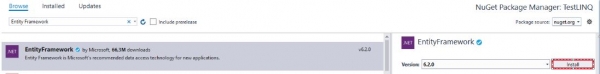
Em seguida, na janela de gerenciamento de pacotes NuGet que aparece, digite a palavra "Entity Framework" na caixa de pesquisa, selecione o pacote Entity Framework e instale-o:
Depois, no arquivo App.config, após o fechamento do elemento configSections, adicione o seguinte bloco:
No connectionString, você precisa inserir a string de conexão.
Agora, vamos criar 3 interfaces em arquivos separados:
- Implementação da interface IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementação da interface IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementação da interface IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
E em um arquivo separado, criaremos a classe base BaseEntity para nossas duas entidades, que conterá os campos comuns:
Implementação da classe base BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Em seguida, criaremos nossas duas entidades em arquivos separados:
- Implementação da classe Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementação da classe Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Agora, criaremos o contexto UserContext em um arquivo separado:
Implementação da classe UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
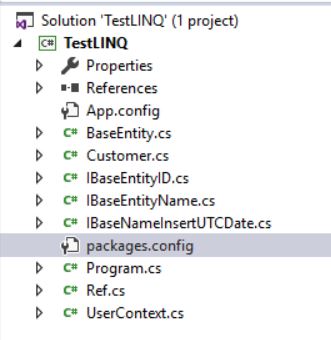
Obtivemos uma solução pronta para executar testes de otimização com LINQ to SQL através do EF para MS SQL Server:
Agora, insira o seguinte código no arquivo Program.cs:
Arquivo Program.cs
usando System;
usando System.Collections.Generic;
usando System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            usando (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
A seguir, vamos iniciar nosso projeto.
No final da execução, será exibido no console:
Consulta SQL gerada
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Ou seja, de forma geral, o LINQ gerou uma consulta SQL bastante aceitável para o SGBD MS SQL Server.
Agora, vamos alterar a condição de E para OU na consulta LINQ:
LINQ-query
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
E novamente, vamos executar nosso aplicativo.
A execução falhará com um erro relacionado ao tempo limite da execução do comando em 30 segundos:
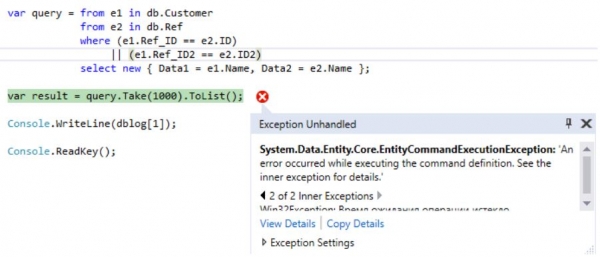
Se observarmos qual consulta foi gerada pelo LINQ:
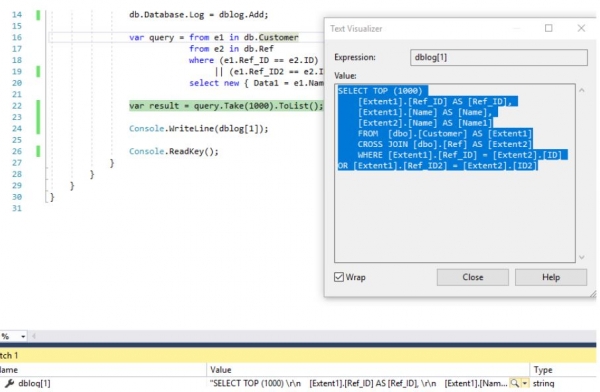
, podemos confirmar que a seleção está ocorrendo através do produto cartesiano de dois conjuntos (tabelas):
Consulta SQL gerada
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Vamos reescrever a consulta LINQ da seguinte forma:
Consulta LINQ otimizada
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Então, obteremos a seguinte consulta SQL:
SQL-query
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Infelizmente, em consultas LINQ, a condição de junção pode ser apenas uma, por isso é possível realizar uma consulta equivalente através de duas consultas para cada condição, com posterior união delas por meio do Union para eliminar duplicatas entre as linhas.
Sim, as consultas em geral resultarão em não equivalentes, considerando que podem ser retornadas duplicatas completas de linhas. No entanto, na vida real, duplicatas completas de linhas não são necessárias e procura-se eliminá-las.
Agora vamos comparar os planos de execução dessas duas consultas:
- para CROSS JOIN, o tempo médio de execução é de 195 segundos:

- para INNER JOIN-UNION, o tempo médio de execução é de menos de 24 segundos:

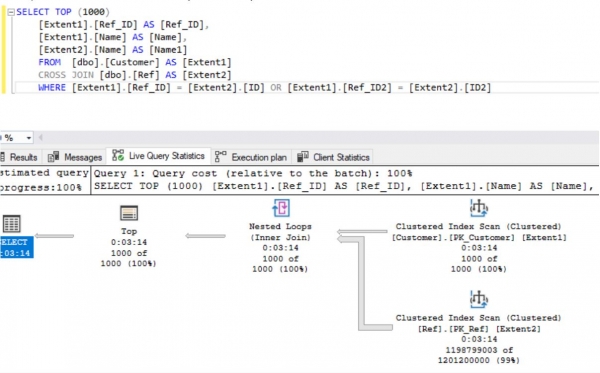
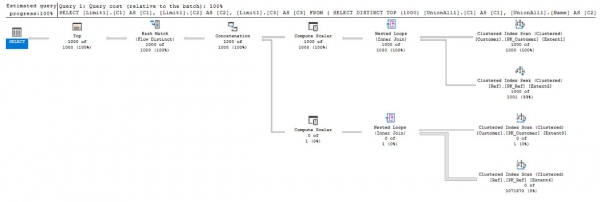
Como pode ser visto nos resultados, para duas tabelas com milhões de registros, a consulta LINQ otimizada funciona várias vezes mais rápido do que a não otimizada.
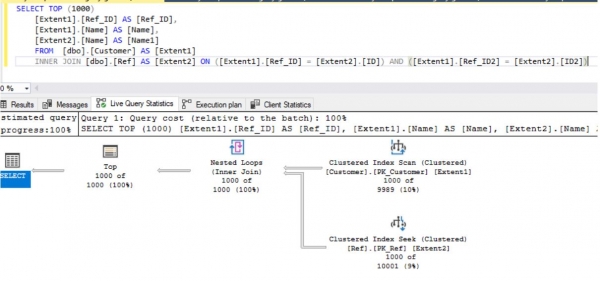
Para a versão com E nas condições da consulta LINQ do tipo:
LINQ-query
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
quase sempre será gerada uma consulta SQL correta, que será executada em média em cerca de 1 segundo:
Além disso, para manipulações LINQ to Objects, em vez da consulta do tipo:
Consulta LINQ (1ª versão)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
pode-se usar uma consulta do tipo:
Consulta LINQ (2ª versão)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
onde:
Definição de dois arrays
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, e o tipo Para é definido da seguinte forma:
Definição do tipo Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Assim, consideramos alguns aspectos na otimização de consultas LINQ para MS SQL Server.
Infelizmente, até mesmo desenvolvedores .NET experientes e principais esquecem que é necessário entender o que as instruções que usam fazem nos bastidores. Caso contrário, tornam-se configuradores e podem colocar uma bomba de atraso no futuro, tanto ao escalar a solução de software quanto com pequenas mudanças nas condições externas do ambiente.
Também foi realizada uma breve revisão e .
Os arquivos fonte para o teste — o próprio projeto, a criação de tabelas no banco de dados TEST e também o preenchimento dessas tabelas está localizado .
Além disso, neste repositório, na pasta Plans, estão os planos de execução de consultas com condições OU.
Fonte: habr.com
