

Olá, Habr!
Neste artigo, gostaríamos de discutir a automação da infraestrutura de rede. Será apresentada uma estrutura de rede que opera em uma pequena, mas muito orgulhosa empresa. Qualquer semelhança com equipamentos de rede reais é mera coincidência. Analisaremos um caso que ocorreu nessa rede, que poderia levar à paralisação dos negócios por um longo período e a perdas financeiras significativas. A solução desse caso se encaixa muito bem no conceito de 'Automação da infraestrutura de rede'. Com o auxílio de ferramentas de automação, mostraremos como resolver problemas complexos de maneira eficaz em prazos curtos e refletiremos sobre por que é mais promissor resolver tais problemas exatamente dessa forma, e não de outra (via console).
Aviso Legal
As principais ferramentas de automação que temos são Ansible (como ferramenta de automação) e Git (como repositório de playbooks do Ansible). É importante ressaltar que este não é um artigo introdutório, onde falamos sobre a lógica de funcionamento do Ansible ou Git e explicamos conceitos básicos (como o que são roles, módulos, arquivos de inventário e variáveis no Ansible, ou o que acontece ao inserir os comandos git push ou git commit). Esta é uma história sobre como é possível resolver rapidamente e preferencialmente sem erros problemas de rede. Também é desejável ter uma boa compreensão de como a rede funciona, em particular, o que é a pilha de protocolos TCP/IP, OSPF, BGP. A escolha do Ansible e Git também deixaremos de lado. Se você ainda está decidindo sobre uma solução específica, recomendamos fortemente a leitura do livro 'Network Programmability and Automation. Skills for the Next-Generation Network Engineer' de Jason Edelman, Scott S. Lowe e Matt Oswalt.
Vamos ao ponto.
Formulação do problema
Imagine a situação: 3 horas da manhã, você está dormindo profundamente e sonhando. O telefone toca. O diretor técnico liga:
— Alô?
— ###, ####, #####, o cluster de firewalls caiu e não está subindo!!!
Você esfrega os olhos, tenta entender o que está acontecendo e imaginar como isso pode ter ocorrido. Na linha, é possível ouvir os cabelos do diretor sendo arrancados, e ele pede para retornar a ligação, porque na segunda linha está ligando o diretor executivo.
Após meia hora, você coletou as primeiras informações da equipe de plantão, acordou todos que podiam ser acordados. No fim, o diretor técnico não mentiu, é tudo verdade, o cluster principal dos firewalls caiu, e nenhum movimento básico o traz de volta à vida. Todos os serviços oferecidos pela empresa não estão funcionando.
Escolha o problema de sua preferência, cada um lembrará de algo que lhe aconteceu. Por exemplo, após a atualização noturna, na ausência de grande carga, tudo funcionou bem, e todos satisfeitos foram dormir. O tráfego começou a fluir, e os buffers das interfaces começaram a transbordar devido a um bug no driver da placa de rede.
A situação pode ser bem descrita por Jackie Chan.
Obrigado, Jackie.
A situação não é muito agradável, não é?
Deixemos por um tempo nosso amigo da rede com seus pensamentos tristes.
Vamos discutir como os eventos se desenrolarão a partir daqui.
Propomos a seguinte ordem para a apresentação do material
- Vamos analisar o esquema de rede e entender como ele funciona;
- Descreveremos como transferimos as configurações de um roteador para outro usando o Ansible;
- Vamos falar sobre a automação da infraestrutura de TI como um todo.
Esquema de rede e sua descrição
Esquema
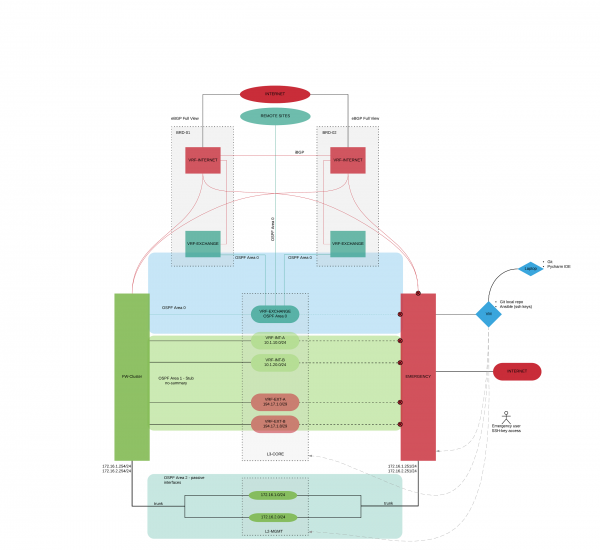
Vamos examinar o esquema lógico de nossa organização. Não mencionaremos fabricantes de equipamentos específicos, pois isso não é relevante para o artigo. (O leitor atento irá deduzir por si mesmo quais equipamentos estão sendo usados.). Este é um dos bons pontos de trabalhar com o Ansible, pois na configuração, em geral, não nos importa qual equipamento é esse. Apenas para entendimento, esses equipamentos são de fornecedores conhecidos, como Cisco, Juniper, Check Point, Fortinet, Palo Alto... você pode preencher com sua opção.
Temos duas tarefas principais para mover o tráfego:
- Garantir a publicação de nossos serviços, que são o negócio da empresa;
- Garantir a conexão com filiais, o data center remoto e organizações externas (parceiros e clientes), bem como o acesso à internet das filiais via escritório central.
Vamos começar com os elementos principais:
- Dois roteadores de borda (BRD-01, BRD-02);
- Cluster de firewalls (FW-CLUSTER);
- Comutador de núcleo (L3-CORE);
- Roteador que funcionará como um salva-vidas (durante a resolução do problema, transferiremos as configurações de rede do FW-CLUSTER para o EMERGENCY) (EMERGENCY);
- Switches para gerenciar a infraestrutura de rede (L2-MGMT);
- Máquina virtual com Git e Ansible (VM-AUTOMATION);
- Laptop usado para testes e desenvolvimento de playbooks para Ansible (Laptop-Automation).
Na rede, o protocolo de roteamento dinâmico OSPF está configurado com as seguintes áreas:
- Área 0 – área que inclui os roteadores responsáveis pelo tráfego na zona EXCHANGE;
- Área 1 – área que inclui os roteadores responsáveis pela operação dos serviços da empresa;
- Área 2 – área que inclui os roteadores responsáveis pelo roteamento de tráfego de gerenciamento;
- Área N – áreas das redes filiais.
Nos roteadores de borda, foi criado um roteador virtual (VRF-INTERNET), onde foi configurado um eBGP full view com o AS correspondente atribuído. Entre os VRFs, está configurado um iBGP. A empresa possui um pool de endereços IP públicos, que estão publicados nesses VRF-INTERNET. Parte dos endereços públicos é roteada diretamente para o FW-CLUSTER (endereços onde os serviços da empresa operam), e parte é roteada através da zona EXCHANGE (serviços internos da empresa que necessitam de endereços IP externos, e endereços externos NAT para os escritórios). A seguir, o tráfego chega aos roteadores virtuais, criados no L3-CORE com endereços públicos e privados (zonas de segurança).
Na rede de gerenciamento, são utilizados switches dedicados que constituem uma rede fisicamente isolada. A rede de gerenciamento também é dividida em zonas de segurança.
O roteador EMERGENCY duplica física e logicamente o FW-CLUSTER. Todas as interfaces estão desligadas, exceto aquelas que se conectam à rede de gerenciamento.
Automatização e sua descrição
Já entendemos como a rede funciona. Agora, vamos abordar passo a passo o que faremos para redirecionar o tráfego do FW-CLUSTER para o EMERGENCY:
- Desconectar as interfaces no switch do núcleo (L3-CORE) que o conectam ao FW-CLUSTER;
- Desconectar as interfaces no switch do núcleo L2-MGMT que o conectam ao FW-CLUSTER;
- Configurar o roteador EMERGENCY (por padrão, todas as interfaces estão desligadas, exceto aquelas conectadas ao L2-MGMT):
- Ligar as interfaces no EMERGENCY;
- Configurar o endereço IP externo (para NAT) que estava no FW-Cluster;
- Gerar solicitações gARP, para que nas tabelas ARP do L3-CORE os endereços MAC mudem do FW-Cluster para o EMERGENCY;
- Definir um rota padrão estática até BRD-01, BRD-02;
- Criar regras de NAT;
- Ativar OSPF Area 1 no EMERGENCY;
- Ativar OSPF Area 2 no EMERGENCY;
- Alterar o custo das rotas na Área 1 para 10;
- Alterar o custo da rota padrão na Área 1 para 10;
- Altere endereço IP, relacionadas ao L2-MGMT (aquelas que estavam no FW-CLUSTER);
- Estamos gerando requisições gARP para que os endereços MAC na tabela ARP do L2-MGMT mudem de FW-CLUSTER para EMERGENCY.
Novamente, voltamos à formulação inicial do problema. Três horas da manhã, enorme estresse, um erro em qualquer uma das etapas pode levar a novos problemas. Estão prontos para digitar os comandos via CLI? Sim? Ok, vá pelo menos lavar o rosto, tome um café e reúna a coragem.
Bruce, por favor, ajude a equipe.
Enquanto isso, continuamos aprimorando a nossa automação.
Abaixo está o esquema de funcionamento do playbook em termos do Ansible. Este esquema reflete o que descrevemos anteriormente, agora já é uma implementação concreta no Ansible.
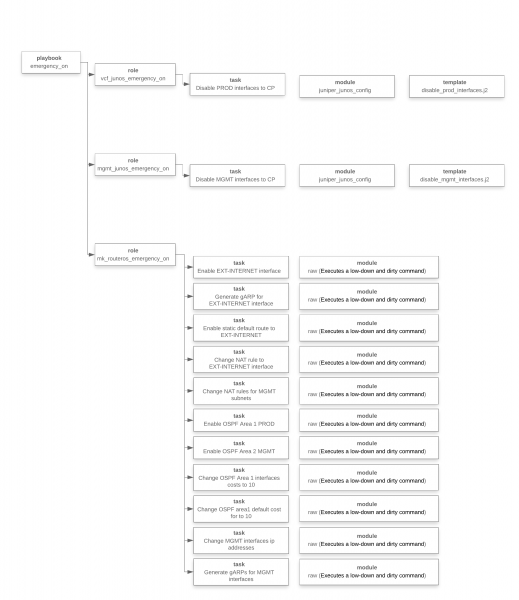
Neste estágio, entendemos o que precisava ser feito, desenvolvemos o playbook, realizamos os testes e agora estamos prontos para executá-lo.
Mais uma pequena digressão. A fluidez da narrativa não deve iludir você. O processo de escrita dos playbooks não foi tão simples e rápido quanto pode parecer. Os testes demoraram bastante, um ambiente virtual foi criado, a solução foi testada várias vezes, foram realizados cerca de 100 testes.
Estamos iniciando... Há uma sensação de que tudo está acontecendo muito lentamente, há algum erro em algum lugar, algo no final não vai funcionar. A sensação é como pular de paraquedas, e o paraquedas parece não querer abrir... isso é normal.
Em seguida, lemos o resultado das operações executadas pelo playbook do Ansible (endereços IP foram substituídos por motivos de segurança):
[xxx@emergency ansible]$ ansible-playbook -i /etc/ansible/inventories/prod_inventory.ini /etc/ansible/playbooks/emergency_on.yml

PLAY [------->Emergência no VCF] ********************************************************

TASK [vcf_junos_emergency_on : Desabilitar interfaces PROD para FW-CLUSTER] *********************
mudado: [vcf]

PLAY [------->Emergência no MGMT-CORE] ************************************************

TASK [mgmt_junos_emergency_on : Desabilitar interfaces MGMT para FW-CLUSTER] ******************
mudado: [m9-03-sw-03-mgmt-core]

PLAY [------->Emergência em] ****************************************************

TASK [mk_routeros_emergency_on : Habilitar interface EXT-INTERNET] **************************
mudado: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Gerar gARP para interface EXT-INTERNET] ****************
mudado: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Habilitar rota padrão estática para EXT-INTERNET] ****************
mudado: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Alterar regra NAT para interface EXT-INTERNET] ****************
mudado: [m9-04-r-04] => (item=12)
mudado: [m9-04-r-04] => (item=14)
mudado: [m9-04-r-04] => (item=15)
mudado: [m9-04-r-04] => (item=16)
mudado: [m9-04-r-04] => (item=17)

TASK [mk_routeros_emergency_on : Habilitar OSPF Área 1 PROD] ******************************
mudado: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Habilitar OSPF Área 2 MGMT] *****************************
mudado: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Alterar custos das interfaces OSPF Área 1 para 10] *****************
mudado: [m9-04-r-04] => (item=VLAN-1001)
mudado: [m9-04-r-04] => (item=VLAN-1002)
mudado: [m9-04-r-04] => (item=VLAN-1003)
mudado: [m9-04-r-04] => (item=VLAN-1004)
mudado: [m9-04-r-04] => (item=VLAN-1005)
mudado: [m9-04-r-04] => (item=VLAN-1006)
mudado: [m9-04-r-04] => (item=VLAN-1007)
mudado: [m9-04-r-04] => (item=VLAN-1008)
mudado: [m9-04-r-04] => (item=VLAN-1009)
mudado: [m9-04-r-04] => (item=VLAN-1010)
mudado: [m9-04-r-04] => (item=VLAN-1011)
mudado: [m9-04-r-04] => (item=VLAN-1012)
mudado: [m9-04-r-04] => (item=VLAN-1013)
mudado: [m9-04-r-04] => (item=VLAN-1100)

TASK [mk_routeros_emergency_on : Alterar custo padrão da área OSPF 1 para 10] ******************
mudado: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Alterar endereços IP das interfaces MGMT] ********************
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n.254', u'name': u'VLAN-803'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+1.254', u'name': u'VLAN-805'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+2.254', u'name': u'VLAN-807'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+3.254', u'name': u'VLAN-809'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+4.254', u'name': u'VLAN-820'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+5.254', u'name': u'VLAN-822'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+6.254', u'name': u'VLAN-823'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+7.254', u'name': u'VLAN-824'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+8.254', u'name': u'VLAN-850'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+9.254', u'name': u'VLAN-851'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+10.254', u'name': u'VLAN-852'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+11.254', u'name': u'VLAN-853'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+12.254', u'name': u'VLAN-870'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+13.254', u'name': u'VLAN-898'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+14.254', u'name': u'VLAN-899'})

TASK [mk_routeros_emergency_on : Gerar gARPs para interfaces MGMT] *********************
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n.254', u'name': u'VLAN-803'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+1.254', u'name': u'VLAN-805'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+2.254', u'name': u'VLAN-807'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+3.254', u'name': u'VLAN-809'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+4.254', u'name': u'VLAN-820'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+5.254', u'name': u'VLAN-822'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+6.254', u'name': u'VLAN-823'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+7.254', u'name': u'VLAN-824'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+8.254', u'name': u'VLAN-850'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+9.254', u'name': u'VLAN-851'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+10.254', u'name': u'VLAN-852'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+11.254', u'name': u'VLAN-853'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+12.254', u'name': u'VLAN-870'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+13.254', u'name': u'VLAN-898'})
mudado: [m9-04-r-04] => (item={u'ip': u'х.х.n+14.254', u'name': u'VLAN-899'})

PLAY RECAP ************************************************************************
Pronto!
Na verdade, não está totalmente pronto, não podemos esquecer a convergência dos protocolos de roteamento dinâmico e a carga de um grande número de rotas no FIB. Não podemos influenciar isso. Estamos aguardando. Convergiu. Agora sim, está pronto.
E na aldeia de Vilabaggio (que não quer automatizar a configuração da rede), continuam a lavar a louça. Bruce (na verdade, já é outro, mas não menos impressionante) tenta entender quantas vezes mais precisará reconfigurar o equipamento manualmente.
Gostaria de focar em um ponto importante. Como podemos reverter tudo isso? Depois de algum tempo, vamos ressuscitar nosso FW-CLUSTER. Este é o equipamento principal, não o reserva, e a rede deve operar nele.
Você sente que os profissionais de TI estão começando a ficar nervosos? O diretor técnico ouvirá mil argumentos sobre por que isso não deve ser feito, por que isso pode ser feito depois. Infelizmente, o trabalho da rede é formado por uma infinidade de remendos, pedaços, sobras de um luxo passado. O resultado é um patchwork. Nossa tarefa, não apenas nesta situação específica, mas de maneira geral, como especialistas em TI, é trazer o funcionamento da rede para uma bela palavra inglesa: "consistency". Essa palavra é multifacetada e pode ser traduzida como: coerência, consistência, lógica, coordenação, sistematicidade, comparabilidade, conexidade. Tudo isso se refere a ela. Somente nesse estado a rede é gerenciável; entendemos claramente o que e como funciona, sabemos exatamente o que precisa ser mudado, se necessário, e sabemos aonde olhar em caso de problemas. E apenas em tal rede podemos realizar truques semelhantes aos que descrevemos atualmente.
Na verdade, foi preparado mais um playbook, que restaurava as configurações ao estado original. A lógica de seu funcionamento é a mesma (é importante lembrar que a ordem das tarefas é muito importante). Para não alongar ainda mais este artigo, decidimos não publicar a listagem da execução do playbook. Ao realizar esses exercícios, você se sentirá muito mais tranquilo e confiante no futuro. Além disso, quaisquer gambiarras que você criou lá se manifestarão imediatamente.
Todos os interessados podem nos escrever e receber os fontes de todo o código escrito, juntamente com todos os playbooks. Contatos estão no perfil.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Na nossa opinião, os processos que podem ser automatizados ainda não se cristalizaram. Com base no que encontramos e no que discutem nossos colegas ocidentais, as seguintes temáticas são visíveis por enquanto:
- Provisionamento de dispositivos;
- Coleta de dados;
- Relatórios;
- Solução de problemas;
- Conformidade.
Se houver interesse, podemos continuar a discussão sobre um dos tópicos apresentados.
Também gostaríamos de refletir um pouco sobre o tema da automação. Como deve ser, em nossa perspectiva:
- O sistema deve operar sem intervenção humana, enquanto melhora com a ajuda de um humano. O sistema não deve depender do ser humano;
- A operação deve ser especializada. Não existe a classe de especialistas que realizam tarefas rotineiras. Há especialistas que já automatizaram toda a rotina e resolvem apenas tarefas complexas;
- As tarefas rotineiras e padrão são realizadas automaticamente "com um clique", sem desperdício de recursos. O resultado dessas tarefas é sempre previsível e claro.
E a que esses pontos devem levar:
- Transparência da infraestrutura de TI (Menores riscos de operação, modernização, implementação. Menos inatividade por ano);
- Capacidade de planejar recursos de TI (Sistema de planejamento de capacidade — é visível quanto é consumido, e é visível quantos recursos são necessários em um único sistema, e não por e-mails e visitas aos gerentes de departamentos);
- Possibilidade de reduzir o número de pessoal de TI de suporte.
Autores do artigo: Alexandre Chelekenov (CCIE RS, CCIE SP) e Pavel Kirilov. Estamos interessados em discutir e propor soluções sobre automação da infraestrutura de TI.
Fonte: habr.com
