

Deixe-me explicar o título do artigo. Inicialmente, era planejado fornecer um bom e confiável conselho sobre como acelerar o uso da reflexão com um exemplo simples, mas realista. No entanto, durante a análise de desempenho, descobri que a reflexão não é tão lenta quanto eu pensava, enquanto o LINQ funciona mais lentamente do que eu poderia imaginar em pesadelos. E, no final, percebi que cometi um erro nas medições... Os detalhes dessa história de vida estão abaixo e nos comentários. Como o exemplo é bastante cotidiano e implementado de maneira típica em ambientes corporativos, achei que seria uma demonstração interessante da vida: a influência sobre a velocidade de funcionamento do principal assunto do artigo não foi percebida devido à lógica externa: Moq, Autofac, EF Core e outros "envoltórios".
Comecei meu trabalho impressionado por este artigo:
Como podemos ver, o autor sugere usar delegados compilados em vez de chamadas diretas a métodos de tipos refletidos como uma excelente maneira de acelerar significativamente o desempenho da aplicação. Há também a emissão de IL, mas eu preferiria evitá-la, pois é o método mais trabalhoso para realizar a tarefa e que pode levar a erros.
Considerando que sempre mantive uma opinião semelhante sobre a velocidade da reflexão, não pretendia questionar as conclusões do autor.
Não é raro encontrar o uso ingênuo da reflexão em ambientes corporativos. Pegamos um tipo. Obtemos informações sobre a propriedade. Chamamos o método SetValue e todos ficam felizes. O valor foi recebido no campo alvo, todos satisfeitos. As pessoas não são ingênuas — seniores e líderes de equipe — escrevem suas extensões em object, baseadas em implementações tão ingênuas de mapeadores "universais" de um tipo para outro. A essência é geralmente a seguinte: pegamos todos os campos, obtemos todas as propriedades, iteramos sobre elas: ao coincidir os nomes dos membros do tipo, executamos SetValue. Ocasionalmente, capturamos exceções por tentativas de acessar propriedades que não existem em um dos tipos, mas aqui há uma solução que melhora a performance. Try/catch.
Eu vi pessoas reinventando parsers e mappers, sem estarem totalmente armadas com informações sobre como funcionam os que vieram antes. Eu vi pessoas escondendo suas implementações ingênuas atrás de estratégias, interfaces e injeções, como se isso desculpasse a confusão subsequente. Eu me afastei de tais implementações. Na verdade, eu não medi a real vazão de desempenho e, quando possível, simplesmente trocava a implementação por algo mais "otimizado", se eu tivesse tempo. Por isso, as primeiras medições que vou mencionar abaixo me deixaram bastante confuso.
Acho que muitos de vocês, ao lerem Richter ou outros ideólogos, já se depararam com a afirmação perfeitamente válida de que a reflexão no código é um fenômeno que impacta negativamente o desempenho da aplicação.
A chamada de reflexão força o CLR a percorrer os assemblies em busca do necessário, carregando seus metadados, analisando-os, etc. Além disso, a reflexão durante a passagem das sequências leva à alocação de grandes volumes de memória. Ao consumir memória, o CLR ativa o GC e os problemas começam. Isso deve ser notavelmente lento, acredite. Os enormes volumes de memória de servidores de produção modernos ou máquinas em nuvem não salvam de altas latências de processamento. Na verdade, quanto mais memória, maior a probabilidade de você NOTAR como o GC opera. A reflexão é, na verdade, um estorvo desnecessário para ele.
No entanto, todos nós usamos tanto containers de IoC quanto data mappers, cujo princípio de funcionamento também se baseia na reflexão; no entanto, questões sobre seu desempenho geralmente não surgem. Não, não porque a injeção de dependências e a abstração de modelos de contexto limitado sejam tão necessárias que temos que sacrificar o desempenho de qualquer forma. É mais simples – isso realmente não afeta muito o desempenho.
A questão é que os frameworks mais comuns que utilizam a tecnologia de reflexão empregam diversos artifícios para operar de maneira mais otimizada. Normalmente isso envolve cache. Geralmente – isso significa Expressions e delegados compilados a partir de árvores de expressão. O mesmo automapper mantém um dicionário concorrente, mapeando tipos com funções que podem converter um no outro sem chamar a reflexão.
Como isso é alcançado? Na essência, não é diferente da lógica que a própria plataforma usa para gerar código JIT. Na primeira chamada do método, ele é compilado (e sim, esse processo não é rápido), nas chamadas subsequentes o controle é transferido para o método já compilado, e aqui não haverá quedas significativas de desempenho.
No nosso caso, também pode-se utilizar a compilação JIT e depois usar o comportamento compilado com o mesmo desempenho que seus análogos AOT. As expressões nos ajudarão nesse caso.
Resumidamente, pode-se formular o princípio em questão da seguinte maneira:
Deve-se armazenar em cache o resultado final da reflexão na forma de um delegado que contém a função compilada. Todos os objetos necessários com informações sobre os tipos também faz sentido armazenar em campos que estão fora dos objetos do seu tipo – trabalhador.
Isso faz sentido. O bom senso nos diz que, se algo pode ser compilado e armazenado em cache, então isso deve ser feito.
Adiantando-se, deve-se dizer que o cache no trabalho com reflexão tem suas vantagens, mesmo que não se utilize o método de compilação de expressões proposto. Na verdade, aqui eu vou apenas repetir as teses do autor do artigo mencionado acima.
Agora, sobre o código. Vamos considerar um exemplo, que é baseado na minha recente dor, com a qual tive que lidar em uma produção séria de uma organização de crédito séria. Todas as entidades são fictícias, para que ninguém desconfie.
Há uma certa entidade. Vamos chamá-la de Contato. Existem cartas com um corpo padronizado, das quais o parser e o hidratador criam esses contatos. Uma carta chegou, a lemos, decompomos em pares chave-valor, criamos o contato e salvamos no banco de dados.
É elementar. Suponha que o contato tenha propriedades Nome Completo, Idade e telefone de contato. Esses dados são os que são enviados na carta. Além disso, a empresa quer que os suportes possam rapidamente adicionar novas chaves para mapear propriedades da entidade em pares no corpo da carta. Isso, caso alguém cometa um erro no modelo ou se antes do lançamento for necessário ativar rapidamente o mapeamento de um novo parceiro, adaptando-se a um novo formato. Assim, poderíamos adicionar a nova correlação de mapeamento como uma correção rápida de dados. Ou seja, é um exemplo da vida real.
Realizamos e criamos testes. Funciona.
Não vou fornecer o código: o código fonte ficou extenso, e ele está disponível no GitHub pelo link no final do artigo. Você pode baixá-lo, testá-lo exaustivamente e medir como isso afetaria seu caso. Vou apresentar apenas o código de dois métodos de template, que diferem entre o hidratador que deve ser rápido e o hidratador que deve ser lento.
A lógica é a seguinte: o método de template recebe pares formados pela lógica básica do parser. O nível LINQ é o parser e a lógica básica do hidratador, que faz uma consulta ao contexto do banco de dados e mapeia as chaves com os pares do parser (para essas funções, há código sem LINQ para comparação). Em seguida, os pares são passados para o método principal de hidratação e os valores das propriedades são definidos nas respectivas propriedades da entidade.
“Rápido” (Prefixo Fast nos benchmarks):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Como podemos ver, é utilizada uma coleção estática com setters de propriedades – lambdas compiladas que chamam o setter da entidade. São criadas com o seguinte código:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
De forma geral, está claro. Percorremos as propriedades, criamos delegados que chamam os setters e salvamos. Depois, chamamos quando necessário.
“Lento” (Prefixo Slow nos benchmarks):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Aqui, percorremos imediatamente as propriedades e chamamos diretamente SetValue.
Para facilitar a visualização e como referência, implementei um método ingênuo que escreve os valores de seus pares de correlação diretamente nos campos da entidade. Prefixo – Manual.
Agora vamos pegar o BenchmarkDotNet e investigar o desempenho. E de repente… (spoiler — esse não é o resultado correto, detalhes — abaixo)
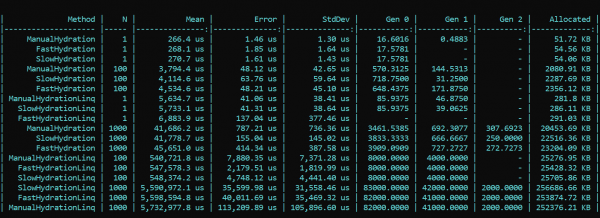
O que estamos vendo aqui? Métodos que ostentam o prefixo Fast, quase em todas as execuções, acabam sendo mais lentos do que os métodos com o prefixo Slow. Isso é verdade tanto para a alocação quanto para a velocidade de execução. Por outro lado, uma implementação bonita e elegante de mapeamento utilizando, onde for possível, os métodos LINQ destinados a isso, consome fortemente o desempenho. A diferença é significativa. A tendência não muda com o número de passagens. A diferença está apenas em escala. Com LINQ, é de 4 a 200 vezes mais lento, e há mais lixo em uma escala semelhante.
ATUALIZADO
Eu não pude acreditar nos meus olhos, mas o mais importante, nem meus olhos, nem meu código acreditou nosso colega — . Reverificando minha solução, ele detectou e apontou brilhantemente um erro que eu deixei passar devido a várias mudanças na implementação, da inicial para a final. Após corrigir o bug encontrado na configuração do Moq, todos os resultados se alinharam. Nos resultados do reteste, a tendência principal não muda — o LINQ ainda afeta o desempenho mais fortemente do que a reflexão. No entanto, é bom que o trabalho com a compilação de Expressions não seja em vão, e o resultado pode ser visto tanto na alocação quanto no tempo de execução. A primeira execução, quando os campos estáticos são inicializados, é naturalmente mais lenta no método 'rápido', mas depois disso a situação muda.
Aqui está o resultado do reteste:
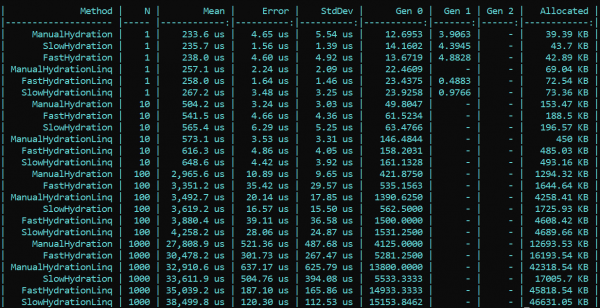
Conclusão: ao usar reflexão em enterprise, não é necessário recorrer a artifícios — o LINQ consumirá mais desempenho. No entanto, em métodos de alta carga que requerem otimização, você pode manter a reflexão na forma de inicializadores e compiladores de delegados, que depois garantirão a lógica 'rápida'. Assim, você pode preservar tanto a flexibilidade da reflexão quanto a velocidade de execução do aplicativo.
O código com o benchmark está disponível aqui. Todos os interessados podem verificar minhas palavras:
PS: O código nos testes usa IoC, enquanto nos benchmarks – uma construção explícita. A questão é que na implementação final, eu eliminei todos os fatores que poderiam impactar o desempenho e perturbar os resultados.
PPS: Agradeço ao usuário por identificar meu erro na configuração do Moq, que afetou as primeiras medições. Se algum leitor tiver suficiente karma, por favor, curta-o. A pessoa parou, leu atentamente, revisou e apontou o erro. Acho que isso merece respeito e simpatia.
PPPS: Obrigado ao leitor minucioso que criticou a estilística e a apresentação. Eu sou a favor da uniformidade e da conveniência. A diplomacia na apresentação deixa a desejar, mas levei a crítica em consideração. Peço que venham se alistar.
Fonte: habr.com
