

Este artigo é uma tradução do meu artigo no medium — , que acabou se tornando bastante popular, provavelmente devido à sua simplicidade. Portanto, resolvi escrevê-lo em russo e acrescentar um pouco para que uma pessoa comum, que não é especialista em dados, entendesse o que é um armazém de dados (DW), o que é um lago de dados (Data Lake) e como eles coexistem.
Por que quis escrever sobre lago de dados? Trabalho com dados e análise há mais de 10 anos, e atualmente estou trabalhando com big data na Amazon Alexa AI em Cambridge, que fica perto de Boston, embora eu more em Victoria, na ilha de Vancouver, e frequentemente esteja em Boston, Seattle e Vancouver, e às vezes até em Moscovo, onde falo em conferências. Também escrevo de vez em quando, mas principalmente em inglês, e já escrevi , além de sentir a necessidade de compartilhar tendências de análise da América do Norte, e às vezes escrevo no .
Sempre trabalhei com armazéns de dados, e desde 2015 comecei a trabalhar intensamente com Amazon Web Services, e de modo geral, passei para a análise em nuvem (AWS, Azure, GCP). Observei a evolução das soluções de análise desde 2007 e até trabalhei em um fornecedor de armazéns de dados, a Teradata, implementando-a no Sberbank, foi nesse momento que surgiu o Big Data com Hadoop. Todos começaram a dizer que a era dos armazéns havia acabado e agora tudo era sobre Hadoop, e depois começaram a falar sobre Data Lake, novamente afirmando que o armazém de dados realmente chegara ao fim. Mas, felizmente (ou talvez infelizes para aqueles que ganhavam muito dinheiro configurando Hadoop), o armazém de dados não desapareceu.
Neste artigo, vamos explorar o que é um lago de dados. O artigo é destinado a pessoas com pouca ou nenhuma experiência com armazéns de dados.
Na imagem está o lago Bled, um dos meus lagos favoritos, embora eu tenha estado lá apenas uma vez, mas me lembro dele para a vida toda. Mas vamos falar sobre outro tipo de lago — o lago de dados. Talvez muitos de vocês já tenham ouvido esse termo várias vezes, mas mais uma definição não fará mal a ninguém.
Antes de tudo, aqui estão as definições mais populares de Lago de Dados:
«um repositório de arquivos de todos os tipos de dados brutos, que estão disponíveis para análise por qualquer pessoa na organização» — Martin Fowler.
«Se você pensa que um data lake é como uma garrafa de água — purificada, envasada e embalada para consumo conveniente, então um data lake é um enorme reservatório de água em seu estado natural. Os usuários podem pegar água para si, mergulhar em profundidade, explorar» — James Dixon.
Agora sabemos com certeza que um data lake se relaciona com análise, permitindo que armazenemos grandes volumes de dados em sua forma original e que tenhamos acesso conveniente a esses dados.
Costumo simplificar as coisas. Se consigo explicar um termo complexo em palavras simples, significa que eu entendi como funciona e para que serve. Certo dia, eu estava mexendo no iPhone na galeria de fotos, e percebi que isso é um verdadeiro data lake; até fiz um slide para conferências:
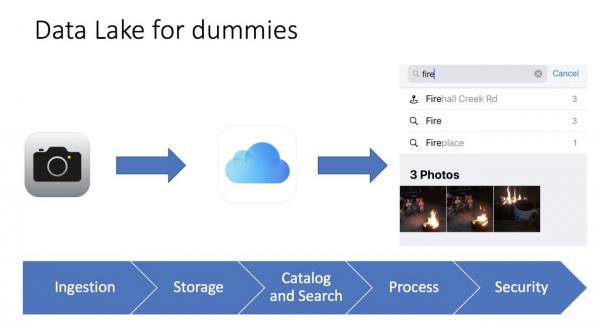
É bem simples. Tiramos uma foto com o telefone, a foto é salva no telefone e pode ser armazenada no iCloud (armazenamento em nuvem). Além disso, o telefone coleta metadados da foto: o que está na imagem, geolocalização, horário. Como resultado, podemos usar a interface do iPhone para encontrar nossa foto e ainda vemos métricas; por exemplo, quando busco fotos com a palavra fogo, encontro 3 fotos de uma fogueira. Para mim, isso funciona como uma ferramenta de Business Intelligence, que opera de maneira rápida e eficaz.
E claro, não podemos esquecer da segurança (autenticação e autorização); caso contrário, nossos dados podem facilmente se tornar acessíveis publicamente. Há muitas notícias sobre grandes corporações e startups que tiveram dados expostos devido à negligência dos desenvolvedores e à falta de cumprimento de regras simples.
Até mesmo uma imagem simples nos ajuda a entender o que é um data lake, suas diferenças em relação a um armazenamento de dados tradicional e seus principais elementos:
- Carregamento de dados (Ingestion) — um componente chave do data lake. Os dados podem ser armazenados de duas maneiras: batch (carregamento em intervalos) e streaming (fluxo de dados).
- Armazenamento de arquivos (Storage) — o componente principal do Data Lake. Precisamos que o armazenamento seja fácil de escalar, extremamente confiável e de baixo custo. Por exemplo, no AWS é o S3.
- Catálogo e Pesquisa (Catálogo e Pesquisa) — para evitarmos o Lago de Dados (que é quando jogamos todos os dados em um só lugar e depois se torna impossível manipulá-los), precisamos criar uma camada de metadados para classificar os dados, para que os usuários possam facilmente encontrar as informações necessárias para análise. Além disso, soluções adicionais de busca, como o ElasticSearch, podem ser utilizadas. A busca ajuda os usuários a encontrarem os dados que precisam através de uma interface amigável.
- Processamento (Processo) — esta etapa é responsável pelo processamento e transformação dos dados. Podemos transformar dados, alterar suas estruturas, limpar e muito mais.
- Segurança (Segurança) — é importante dedicar tempo ao design da segurança da solução. Por exemplo, a criptografia de dados durante o armazenamento, processamento e carregamento. É essencial utilizar métodos de autenticação e autorização. Em resumo, uma ferramenta de auditoria é necessária.
Sob uma perspectiva prática, podemos caracterizar um lago de dados por três atributos:
- Colete e armazene qualquer coisa — o lago de dados contém todos os dados, tanto dados brutos não processados de qualquer período quanto dados processados/limpos.
- Análise profunda — o lago de dados permite aos usuários explorar e analisar os dados.
- Acesso flexível — o lago de dados proporciona acesso flexível a diferentes dados e cenários diversos.
Agora podemos discutir a diferença entre um armazém de dados e um lago de dados. As pessoas geralmente costumam perguntar:
- E quanto ao armazém de dados?
- Estamos substituindo o armazém de dados pelo lago de dados ou estamos expandindo-o?
- Podemos realmente ficar sem um lago de dados?
Em resumo, não há uma resposta clara. Tudo depende da situação específica, das habilidades da equipe e do orçamento. Por exemplo, a migração de um armazém de dados Oracle para AWS e a criação de um lago de dados pela subsidiária da Amazon — Woot — .
Por outro lado, o fornecedor Snowflake declara que você não precisa mais se preocupar com um lago de dados, pois sua plataforma de dados (até 2020 era um armazém de dados) permite que você una tanto um lago de dados quanto um armazém de dados. Trabalhei um pouco com o Snowflake, e é realmente um produto único que pode fazer isso. O preço é outra questão.
Em conclusão, na minha opinião, ainda precisamos de um armazenamento de dados como a principal fonte de dados para nossos relatórios, e tudo o que não cabe armazenamos em um lago de dados. O papel da análise é fornecer acesso conveniente para os negócios para a tomada de decisões. De qualquer forma, os usuários de negócios trabalham de maneira mais eficiente com o armazenamento de dados do que com o lago de dados; por exemplo, na Amazon — existe o Redshift (armazenamento de dados analítico) e o Redshift Spectrum/Athena (interface SQL para o lago de dados em S3 baseada em Hive/Presto). O mesmo se aplica a outros armazéns de dados analíticos modernos.
Vamos considerar uma arquitetura típica de armazenamento de dados:
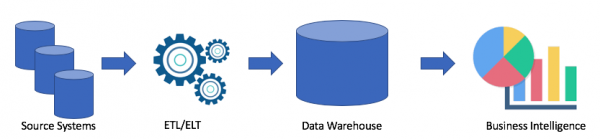
Esta é uma solução clássica. Temos sistemas de origem, através de ETL/ELT copiamos dados para o armazenamento de dados analítico e conectamos à solução de Business Intelligence (meu favorito é o Tableau, e o seu?).
Essa solução tem as seguintes desvantagens:
- Operações ETL/ELT exigem tempo e recursos.
- Em geral, a memória para armazenamento de dados em um armazenamento de dados analítico não é barata (por exemplo, Redshift, BigQuery, Teradata), pois precisamos comprar um cluster inteiro.
- Os usuários de negócios têm acesso a dados limpos e frequentemente agregados e não têm a possibilidade de acessar dados brutos.
Claro, tudo depende do seu caso. Se você não tem problemas com seu armazenamento de dados, então não precisa de um lago de dados. Mas quando surgem problemas com falta de espaço, poder ou o custo tem um papel crucial, então você pode considerar a opção do lago de dados. É por isso que o lago de dados é muito popular. Aqui está um exemplo de arquitetura de lago de dados:
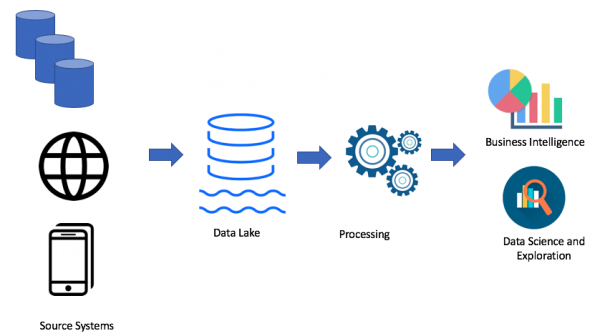
Utilizando a abordagem de lago de dados, carregamos dados brutos em nosso lago de dados (em lote ou streaming), em seguida, processamos os dados conforme necessário. O lago de dados permite que os usuários de negócios criem suas próprias transformações de dados (ETL/ELT) ou analisem os dados em soluções de Business Intelligence (se houver o driver necessário).
O objetivo de qualquer solução analítica é servir os usuários de negócios. Portanto, devemos sempre trabalhar a partir das necessidades do negócio. (Na Amazon, este é um dos princípios — trabalhar retrocedendo).
Ao trabalhar tanto com armazenamento de dados quanto com lago de dados, podemos comparar ambas as soluções:
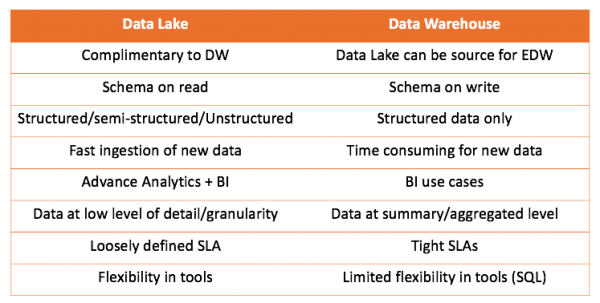
A principal conclusão que se pode tirar é que o armazenamento de dados não compete com o lago de dados, mas o complementa. Mas cabe a você decidir o que é adequado para o seu caso. Sempre é interessante experimentar por si mesmo e chegar a conclusões corretas.
Gostaria também de compartilhar um dos casos em que comecei a usar a abordagem do lago de dados. Tudo é bastante simples, tentei usar uma ferramenta ELT (tínhamos o Matillion ETL) e o Amazon Redshift. Minha solução funcionou, mas não atendia aos requisitos.
Eu precisava pegar os logs da web, transformá-los e agregá-los para fornecer dados para 2 casos:
- A equipe de marketing queria analisar a atividade dos bots para SEO.
- A equipe de TI queria ver métricas sobre o desempenho dos sites.
Logs muito simples, log simples. Aqui está um exemplo:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Um arquivo pesava de 1 a 4 megabytes.
Mas havia uma dificuldade. Tínhamos 7 domínios espalhados pelo mundo, e um total de 7000 arquivos era criado em um dia. Isso não era um volume muito alto, apenas 50 gigabytes. Mas o tamanho do nosso cluster Redshift também era pequeno (4 nós). O carregamento da maneira tradicional de um arquivo demorava cerca de um minuto. Ou seja, a tarefa não poderia ser resolvida diretamente. E foi nesse caso que decidi usar a abordagem do lago de dados. A solução era mais ou menos assim:
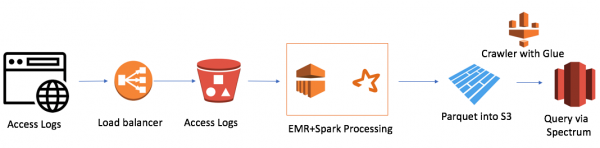
É bastante simples (quero notar que a vantagem de trabalhar na nuvem é a simplicidade). Eu usei:
- AWS Elastic Map Reduce (Hadoop) como poder de computação.
- AWS S3 como armazenamento de arquivos com possibilidade de criptografia de dados e controle de acesso.
- Spark como poder de computação em memória e PySpark para lógica e transformação de dados.
- Parquet como resultado do trabalho do Spark.
- AWS Glue Crawler como coletor de metadados sobre novos dados e partições.
- Redshift Spectrum como interface SQL para o lago de dados para os usuários existentes do Redshift.
O menor cluster EMR+Spark processava todos os arquivos em 30 minutos. Existem outros casos para AWS, especialmente muitos relacionados ao Alexa, onde há muitos dados.
Recentemente, descobri uma das desvantagens do data lake — a GDPR. O problema é que, quando um cliente pede para excluir seus dados e eles estão em um dos arquivos, não podemos usar a Data Manipulation Language e a operação DELETE como em um banco de dados.
Espero que o artigo tenha esclarecido a diferença entre armazenamento de dados e data lake. Se você achou interessante, posso traduzir mais meus artigos ou artigos de profissionais que leio. Além disso, posso falar sobre as soluções com as quais trabalho e sua arquitetura.
Fonte: habr.com
