

A clássica pergunta que um desenvolvedor faz ao seu DBA ou ao proprietário de um negócio — ao consultor de PostgreSQL — quase sempre é a mesma: «Por que os pedidos demoram tanto a serem executados no banco de dados?»
Um conjunto tradicional de razões:
- algoritmo ineficiente
quando você decidiu fazer um JOIN de várias CTE com algumas dezenas de milhares de registros - estatísticas desatualizadas
se a distribuição real dos dados na tabela já difere significativamente da que foi coletada pelo ANALYZE na última vez - um ‘estrangulamento’ de recursos
e já não há poder computacional suficiente no CPU, megabytes de memória estão sendo consumidos constantemente ou o disco não é capaz de acompanhar todas as ‘demandas’ do banco de dados - bloqueios de processos concorrentes
E se os bloqueios são bastante difíceis de capturar e analisar, para todo o resto, podemos simplesmente usar o plano da consulta, que pode ser obtido com (é claro que é melhor usar EXPLAIN (ANALYZE, BUFFERS) …) ou .
Mas, como diz a documentação,
«Entender o plano é uma arte e para dominá-lo é necessário ter alguma experiência,…»
Mas você também pode conseguir isso sem ele, se usar a ferramenta certa!
Como geralmente é o plano da consulta? Algo assim:
Index Scan using pg_class_relname_nsp_index on pg_class (tempo real=0.049..0.050 linhas=1 loops=1)
  Condição do Índice: (relname = $1)
  Filtro: (oid = $0)
  Buffers: hit compartilhado=4
  InitPlan 1 (retorna $0,$1)
    ->  Limit (tempo real=0.019..0.020 linhas=1 loops=1)
          Buffers: hit compartilhado=1
          ->  Seq Scan on pg_class pg_class_1 (tempo real=0.015..0.015 linhas=1 loops=1)
                Filtro: (relkind = 'r'::"char")
                Linhas Removidas pelo Filtro: 5
                Buffers: hit compartilhado=1
ou assim:
"Append  (custo=868.60..878.95 linhas=2 largura=233) (tempo real=0.024..0.144 linhas=2 loops=1)"
"  Buffers: hit compartilhado=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (custo=0.00..868.60 linhas=9972 largura=537) (tempo real=0.016..0.042 linhas=101 loops=1)"
"          Buffers: hit compartilhado=3"
"  ->  Limit  (custo=0.00..0.10 linhas=1 largura=233) (tempo real=0.023..0.024 linhas=1 loops=1)"
"        Buffers: hit compartilhado=1"
"        ->  CTE Scan on cl  (custo=0.00..997.20 linhas=9972 largura=233) (tempo real=0.021..0.021 linhas=1 loops=1)"
"              Buffers: hit compartilhado=1"
"  ->  Limit  (custo=10.00..10.10 linhas=1 largura=233) (tempo real=0.117..0.118 linhas=1 loops=1)"
"        Buffers: hit compartilhado=2"
"        ->  CTE Scan on cl cl_1  (custo=0.00..997.20 linhas=9972 largura=233) (tempo real=0.001..0.104 linhas=101 loops=1)"
"              Buffers: hit compartilhado=2"
"Tempo de Planejamento: 0.634 ms"
"Tempo de Execução: 0.248 ms"
Mas ler o plano texto ‘do papel’ é muito complicado e pouco intuitivo:
- no nó é exibida a soma dos recursos da subárvore
ou seja, para entender quanto tempo levou para executar um determinado nó, ou quanto especificamente essa leitura da tabela trouxe dados do disco - é necessário subtrair uma coisa da outra - o tempo do nó é necessário multiplicar por loops
sim, a subtração ainda não é a operação mais difícil que deve ser feita "na cabeça" - pois o tempo de execução é o médio para uma execução de nó, e eles podem ser centenas - bem, tudo isso junto dificulta responder à pergunta principal - então quem é "o elo mais fraco"?
Quando tentamos explicar tudo isso para algumas centenas de nossos desenvolvedores, percebemos que de fora parece mais ou menos assim:
Ah, então, precisamos de…
A ferramenta
Nele, tentamos reunir todas as mecânicas-chave que ajudam a entender, por plano e solicitação, "quem é o culpado e o que fazer". E, além disso, compartilhar parte de nossa experiência com a comunidade.
Conheçam e utilizem -
Clareza nos planos
É fácil entender o plano quando ele aparece assim?
Seq Scan em pg_class (tempo real=0.009..1.304 linhas=6609 loops=1)
  Buffers: compartilhado hit=263
Tempo de Planejamento: 0.108 ms
Tempo de Execução: 1.800 ms
Não muito.
Mas assim, de forma condensada, quando as métricas chave estão separadas - já fica muito mais claro:
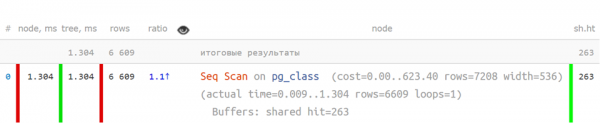
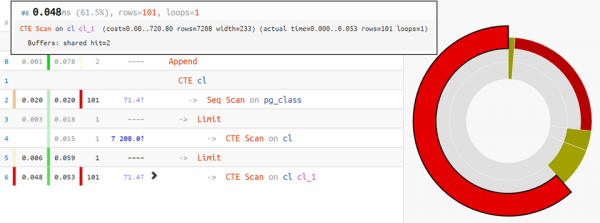
Mas se o plano for mais complicado - a ajuda virá gráfico de pizza de distribuição de tempo por nós:
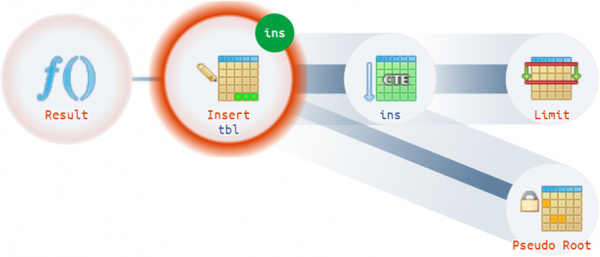
Bem, para os casos mais complicados, a ajuda vem com diagrama de execução:
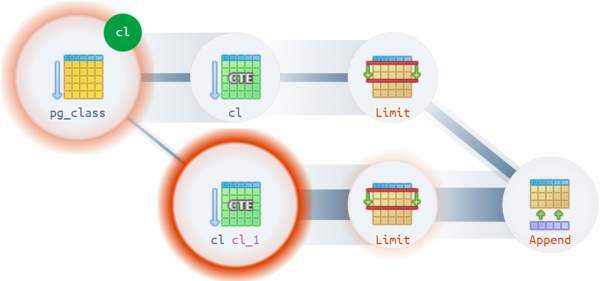
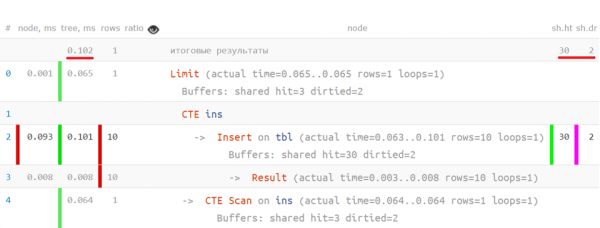
Por exemplo, podem ocorrer situações não triviais em que o plano pode ter mais de uma raiz real:
Sugestões estruturais
Bem, se toda a estrutura do plano e seus pontos fracos já estão dispostos e visíveis - por que não destacá-los para o desenvolvedor e explicar em 'linguagem simples'?
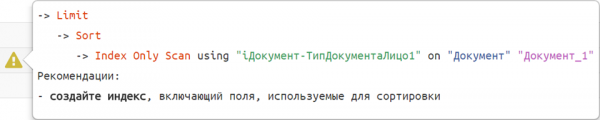 Reunimos já várias dezenas desses modelos de recomendações.
Profiler de consulta linha a linha
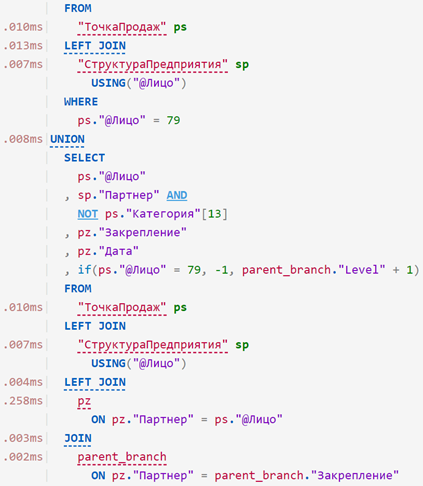
Agora, se sobrepusermos a consulta inicial ao plano analisado, poderemos ver quanto tempo foi gasto em cada operador específico - aproximadamente assim:
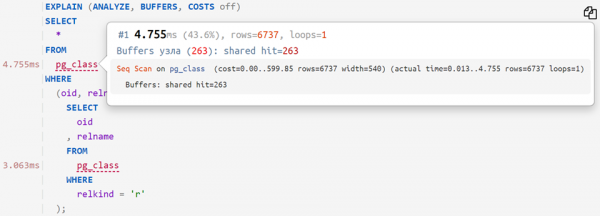
… ou até assim:
Substituição de parâmetros na consulta
Se você 'anexou' ao plano não apenas a consulta, mas também seus parâmetros da linha DETAIL do log, poderá copirá-la adicionalmente em uma das variantes:
- com substituição de valores na consulta
para execução direta em sua base e posterior perfilagemSELECT 'const', 'param'::text; - com substituição de valores através de PREPARE/EXECUTE
para emular o funcionamento do agendador, quando a parte paramétrica pode ser ignorada — por exemplo, ao trabalhar com tabelas particionadasDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Arquivo de planos
Insira, analise e compartilhe com seus colegas! Os planos permanecerão no arquivo e você poderá retorná-los mais tarde:
Mas se você não quiser que seu plano seja visto por outros, não se esqueça de marcar a opção "não publicar no arquivo".
Nos próximos artigos, falarei sobre as dificuldades e soluções que surgem ao analisar o plano.
Fonte: habr.com
