

Ao entrar em um produto que está em desenvolvimento há mais de uma década, não é surpreendente encontrar tecnologias desatualizadas. Mas e se, em seis meses, você precisar suportar uma carga dez vezes maior, e o custo das falhas aumentar centenas de vezes? Nesse caso, você precisará de um engenheiro de alta carga qualificado. Porém, na falta de tal profissional, a solução do problema foi confiada a mim. Na primeira parte do artigo, contarei como migramos de Redis para Redis-cluster, e na segunda parte, darei dicas de como começar a usar o cluster e o que observar na sua operação.
Escolha da tecnologia
É tão ruim um Redis separado (redis standalone) na configuração de 1 mestre e N escravos? Por que o considero uma tecnologia desatualizada?
Não, o Redis não é tão ruim... No entanto, há algumas falhas que não podem ser ignoradas.
Primeiro, o Redis não suporta mecanismos de recuperação de falhas após a queda do mestre. Para resolver esse problema, utilizamos uma configuração com redirecionamento automático de VIPs para um novo mestre, trocando o papel de um dos escravos e alternando os demais. Esse mecanismo funcionou, mas não pode ser considerado uma solução confiável. Em primeiro lugar, houve disparos falsos, e em segundo lugar, era uma solução de uso único, e após a ativação eram necessárias ações manuais para reiniciar o sistema.
Em segundo lugar, a existência de apenas um mestre levou ao problema de sharding. Era necessário criar vários clusters independentes de '1 mestre e N escravos', depois distribuir manualmente os bancos de dados entre essas máquinas e torcer para que amanhã um dos bancos não crescesse tanto que fosse necessário movê-lo para uma instância separada.
Quais são as opções?
- A solução mais cara e completa é o Redis-Enterprise. Esta é uma solução pronta com suporte técnico completo. Embora pareça ideal do ponto de vista técnico, não nos serviu por razões ideológicas.
- Redis-cluster. A partir da caixa, há suporte para failover automático do mestre e sharding. A interface quase não difere da versão comum. Parece promissora; falaremos sobre as armadilhas mais adiante.
- Tarantool, Memcache, Aerospike e outros. Todas essas ferramentas fazem aproximadamente a mesma coisa. Mas cada uma tem suas desvantagens. Decidimos não colocar todos os ovos na mesma cesta. Usamos Memcache e Tarantool para outras tarefas e, adiantando, posso dizer que em nossa prática tivemos mais problemas com eles.
Especificidade de uso
Vamos dar uma olhada nas tarefas que historicamente resolvemos com Redis e qual funcionalidade utilizamos:
- Cache antes de solicitações a serviços remotos, como 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache antes do MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Armazenamento principal para o serviço de gerenciamento de sessões e coordenadas de motoristas | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Como podem ver, não há nada de alta matemática. Então, qual é a dificuldade? Vamos analisar separadamente cada método.
Método
Descrição
Características do Redis-cluster
Solução
GET SET
Gravar/ler uma chave
MGET MSET
Gravar/ler várias chaves
As chaves estarão em diferentes nós. Bibliotecas prontas conseguem realizar operações múltiplas apenas dentro de um único nó.
Substituir MGET por um pipeline de N operações GET
SELECT DB
Selecionar o banco que vamos trabalhar
Não suporta múltiplos bancos de dados
Armazenar tudo em um único banco. Adicionar prefixos às chaves
SCAN
Percorrer todas as chaves no banco
Como temos um banco, percorrer todas as chaves no cluster é muito custoso.
Manter o invariante dentro de uma chave e fazer HSCAN nessa chave. Ou abrir mão completamente.
GEO
Operações com chave geográfica
A chave geográfica não é particionada
KEY BY PATTERN
Procurar chave por padrão
Como temos um banco, vamos buscar por todas as chaves no cluster. Muito custoso.
Abrir mão ou manter o invariante, assim como no caso do SCAN.
Redis vs Redis-cluster
O que perdemos e o que ganhamos ao migrar para o cluster?
- Desvantagens: perdemos a funcionalidade de vários bancos.
- Se quisermos armazenar dados logicamente não relacionados em um único cluster, teremos que criar gambiarras na forma de prefixos.
- Perdemos todas as operações 'por banco', como SCAN, DBSIZE, CLEAR DB, etc.
- Operações múltiplas se tornaram significativamente mais complexas de implementar, pois pode ser necessário acessar vários nós.
- Vantagens:
- Resiliência em forma de failover de mestre.
- Particionamento no lado do Redis.
- Transferência de dados entre nós de forma atômica e sem downtime.
- Adição e redistribuição de recursos e cargas sem downtime.
Eu diria que se você não precisa garantir um alto nível de disponibilidade, a migração para um cluster não vale a pena, pois pode ser uma tarefa não trivial. Mas se a escolha inicial for entre uma versão separada e uma versão em cluster, é melhor optar pelo cluster, já que ele não é inferior em nada e, além disso, aliviará parte da sua dor de cabeça.
Preparação para a migração
Vamos começar pelos requisitos para a migração:
- Ela deve ser sem interrupções. Uma parada total do serviço por 5 minutos não é aceitável para nós.
- Deve ser o mais segura e gradual possível. Queremos ter algum controle sobre a situação. Não desejamos despejar tudo de uma vez e rezar sobre o botão de retorno.
- Mínimas perdas de dados durante a migração. Entendemos que migrar de forma atômica será muito difícil, portanto, aceitamos alguma desincronização entre os dados no Redis normal e no cluster.
Manutenção do cluster
Antes da migração, devemos considerar se conseguimos manter o cluster:
- Gráficos. Usamos Prometheus e Grafana para gráficos de carga dos processadores, memória ocupada, número de clientes, quantidade de operações GET, SET, AUTH, etc.
- Especialização. Imagine que amanhã você será responsável por um enorme cluster. Se ele falhar, ninguém além de você poderá consertá-lo. Se começar a travar, todos correrão até você. Se precisar adicionar recursos ou redistribuir a carga, será novamente com você. Para não ficar grisalho aos 25, é desejável prever esses casos e testar de antemão como a tecnologia se comportará em determinadas ações. Vamos discutir isso mais detalhadamente na seção "Especialização".
- Monitoramento e alertas. Quando o cluster falhar, queremos ser os primeiros a saber. Aqui limitamos a notificação para quando todos os nós retornam as mesmas informações sobre o estado do cluster (sim, isso pode ser diferente). E os outros problemas podem ser percebidos mais rapidamente através das notificações dos serviços-clientes do Redis.
Migração
Como vamos migrar:
- Primeiro, é preciso preparar a biblioteca para trabalhar com o cluster. Para a versão em Gо, utilizamos o go-redis e fizemos algumas alterações para atender às nossas necessidades. Implementamos métodos Multi através de pipelines e também ajustamos as regras de repetição de solicitações. A versão para PHP apresentou mais problemas, mas no final decidimos usar o php-redis. Recentemente, eles introduziram suporte para clusters, e, em nossa opinião, isso está bem implementado.
- Em seguida, precisamos implantar o próprio cluster. Isso é feito literalmente com dois comandos com base em um arquivo de configuração. Vamos discutir a configuração mais detalhadamente abaixo.
- Para uma transição gradual, utilizamos o modo dry. Como temos duas versões da biblioteca com a mesma interface (uma para a versão padrão e outra para o cluster), não é difícil criar um wrapper que trabalhe com a versão separada e, ao mesmo tempo, duplique todas as solicitações no cluster, comparando as respostas e registrando as discrepâncias nos logs (neste caso, no NewRelic). Dessa forma, mesmo que a versão cluster falhe durante a implantação, nossa produção não será afetada.
- Ao implantar o cluster em modo dry, podemos observar tranquilamente o gráfico de discrepâncias nas respostas. Se a proporção de erros se aproxima lentamente, mas de forma constante, de uma pequena constante, significa que está tudo bem. Por que ainda existem discrepâncias? Porque a gravação na versão separada ocorre um pouco antes do que no cluster, e devido ao microdelay, os dados podem divergir. Basta olhar para os logs de discrepâncias, e se todas forem explicáveis pela não atomicidade da gravação, podemos prosseguir.
- Agora podemos inverter o modo dry. Vamos gravar e ler do cluster, enquanto duplicamos na versão separada. Por quê? Durante a próxima semana, queremos observar o funcionamento do cluster. Se, de repente, constatamos que há problemas sob carga máxima ou esquecemos algo, sempre teremos um retorno de emergência para o código antigo e dados atualizados graças ao modo dry.
- Agora só precisamos desativar o modo dry e desmontar a versão separada.
Especialização
Primeiro, vamos falar brevemente sobre a estrutura do cluster.
Primeiro de tudo, o Redis é um armazenamento key-value. Strings arbitrárias são utilizadas como chaves. Os valores podem ser números, strings e estruturas inteiras. Existem inúmeras dessas estruturas, mas para entender a configuração geral, isso não é importante.
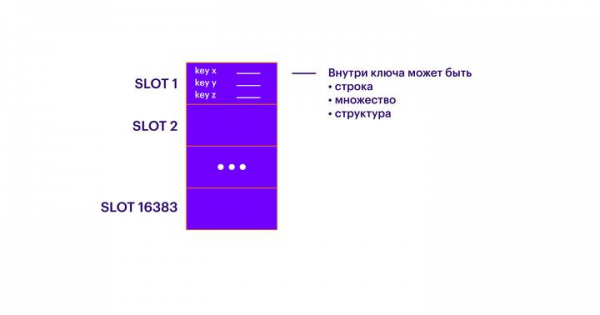
O próximo nível de abstração após as chaves são os slots (SLOTS). Cada chave pertence a um dos 16.383 slots. Dentro de cada slot, pode haver quantas chaves forem necessárias. Assim, todas as chaves se dividem em 16.383 conjuntos não sobrepostos.
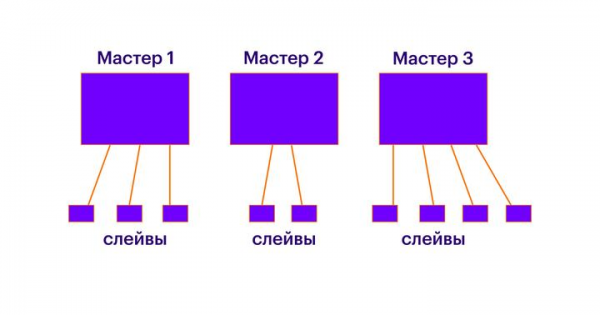
Além disso, deve haver N nós mestres no cluster. Cada nó pode ser visto como uma instância separada do Redis, que conhece tudo sobre os outros nós dentro do cluster. Cada nó mestre contém uma certa quantidade de slots. Cada slot pertence apenas a um único nó mestre. Todos os slots devem ser distribuídos entre os nós. Se alguns slots não forem distribuídos, as chaves armazenadas neles estarão inacessíveis. Faz sentido executar cada nó mestre em uma máquina lógica ou física separada. Também é importante lembrar que cada nó opera em apenas um núcleo, e se você quiser executar várias instâncias do Redis em uma única máquina lógica, certifique-se de que elas funcionem em núcleos diferentes (não experimentamos isso, mas teoricamente deveria funcionar). Em essência, os nós mestres proporcionam a fragmentação normal, e um maior número de nós mestres permite escalar as solicitações de gravação e leitura.
Depois que todas as chaves estiverem distribuídas pelos slots e os slots estiverem espalhados pelos nós mestres, pode-se adicionar um número arbitrário de nós escravos a cada nó mestre. Dentro de cada tal par "mestre-escravo", a replicação padrão ocorrerá. Os escravos são necessários para escalar solicitações de leitura e para failover em caso de falha do mestre.
Agora, vamos falar sobre as operações que seria bom saber fazer.
Vamos acessar o sistema através do Redis-CLI. Como o Redis não possui um único ponto de entrada, as seguintes operações podem ser executadas em qualquer um dos nós. Em cada item, chamo a atenção para a possibilidade de realizar a operação sob carga.
- A primeira e mais importante operação de que precisamos: cluster nodes. Ela retorna o estado do cluster, mostrando a lista de nós, seus papéis, a distribuição dos slots, etc. Informações adicionais podem ser obtidas com cluster info e cluster slots.
- Seria bom poder adicionar e remover nós. Para isso, existem as operações cluster meet e cluster forget. Note que o cluster forget deve ser aplicado a CADA nó, tanto mestres quanto réplicas. Já o cluster meet pode ser chamado apenas em um nó. Essa diferença pode ser desencorajador, então é melhor conhecê-la antes de colocar o cluster em produção. A adição de um nó é feita com segurança durante operações e não afeta o funcionamento do cluster (o que faz sentido). No entanto, se você pretende remover um nó do cluster, deve garantir que não sobraram slots nele (caso contrário, você corre o risco de perder o acesso a todas as chaves nesse nó). Além disso, não remova um mestre que tem escravos, pois isso resultará em uma votação desnecessária para um novo mestre. Se não há mais slots nos nós, isso é um pequeno problema, mas por que queremos decisões extras se podemos primeiro remover os escravos.
- Se for necessário forçar a troca entre mestre e escravo, então use o comando cluster failover. Ao chamá-lo durante operações, é necessário entender que, durante a execução da operação, o mestre ficará indisponível. Normalmente, a troca ocorre em menos de um segundo, mas não de forma atômica. Você pode esperar que parte das solicitações para o mestre termine com erro nesse tempo.
- Antes de remover um nó do cluster, não deve haver slots restantes nele. É melhor redistribuí-los usando o comando cluster reshard. Os slots serão transferidos de um mestre para outro. Todo o processo pode levar alguns minutos, dependendo do volume de dados a serem transferidos, mas a transferência é segura e não afeta o funcionamento do cluster. Assim, todos os dados podem ser transferidos de um nó para outro sob carga, sem se preocupar com sua disponibilidade. No entanto, existem algumas nuances. Primeiro, a transferência de dados impõe uma certa carga ao nó receptor e ao remetente. Se o nó receptor já estiver muito sobrecarregado em termos de CPU, não deve ser sobrecarregado com a recepção de novos dados. Em segundo lugar, assim que não houver nenhum slot no mestre remetente, todos os seus slaves automaticamente se conectarão ao mestre para o qual esses slots foram transferidos. O problema é que todos esses slaves quererão sincronizar os dados ao mesmo tempo. E você pode ter sorte se isso for uma sincronização parcial e não total. Leve isso em consideração e combine as operações de transferência de slots com a desconexão/transferência de slaves. Ou então, espere que você tenha uma margem de segurança suficiente.
- O que fazer se, durante a transferência, você descobrir que perdeu slots? Espero que esse problema não ocorra com você, mas se acontecer, existe a operação cluster fix. Ela redistribui os slots pelos nós de forma aleatória. Recomendo verificar seu funcionamento, removendo previamente do cluster um nó com slots distribuídos. Como os dados nos slots não distribuídos já estão indisponíveis, preocupar-se com problemas de disponibilidade desses slots já é tarde demais. Por sua vez, a operação não afetará os slots distribuídos.
- Outra operação útil é a monitor. Ela permite visualizar em tempo real toda a lista de solicitações que estão indo para o nó. Além disso, você pode fazer um grep nela para saber se há o tráfego necessário.
Também vale mencionar o procedimento de failover do master. Em resumo, ele existe e, na minha opinião, funciona muito bem. No entanto, não se deve pensar que, se você desconectar o cabo da tomada de uma máquina com um nó master, o Redis mudará imediatamente e os clientes não notarão a queda. Na minha prática, a transição leva alguns segundos. Durante esse tempo, parte dos dados ficará indisponível: a indisponibilidade do master é detectada, os nós votam em um novo, os slaves fazem a troca e os dados são sincronizados. A melhor maneira de se certificar de que o esquema funciona é realizar exercícios locais. Levante um cluster no seu laptop, aplique uma carga mínima, simule uma queda (por exemplo, bloqueando as portas), e avalie a velocidade de troca. Na minha opinião, só depois de brincar assim por um ou dois dias é que se pode ter certeza do funcionamento da tecnologia. Ou, então, contar que o software que metade da internet usa deve funcionar bem.
Configuração
Geralmente, a configuração é a primeira coisa que é necessária para começar a trabalhar com a ferramenta. E quando tudo está funcionando, não se quer mexer na configuração. É necessário um esforço considerável para se forçar a voltar às configurações e revisá-las minuciosamente. Na minha memória, tivemos pelo menos dois problemas sérios devido à falta de atenção à configuração. Preste atenção especial aos seguintes pontos:
- timeout 0
O tempo após o qual as conexões inativas são fechadas (em segundos). 0 — não são fechadas.
Nem toda nossa biblioteca conseguia fechar as conexões corretamente. Desativando essa configuração, corremos o risco de atingir o limite de número de clientes. Por outro lado, se esse problema existir, a quebra automática de conexões perdidas poderá mascará-lo, e podemos não perceber. Além disso, não é recomendável ativar essa configuração ao usar conexões persistentes. - Save x y & appendonly yes
Salvamento de snapshot em RDB.
Problemas com RDB/AOF discutiremos detalhadamente a seguir. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Se ativado, ao ocorrer uma falha no snapshot RDB, o master deixará de aceitar requisições de alteração. Se a conexão com o master for perdida, o slave pode continuar a responder às requisições (yes). Ou pode parar de responder (no).
Não estamos satisfeitos com a situação em que o Redis se torna um abóbora. - repl-ping-slave-period 5
Após esse intervalo, começaremos a nos preocupar que o mestre falhou, e será hora de realizar o procedimento de failover.
Teremos que encontrar manualmente um equilíbrio entre alarmes falsos e o acionamento do failover. Em nossa experiência, isso leva cerca de 5 segundos. - repl-backlog-size 1024mb & epl-backlog-ttl 0
É exatamente a quantidade de dados que podemos armazenar no buffer para uma réplica que falhou. Se o buffer acabar, será necessário fazer uma sincronização completa.
A prática sugere que é melhor definir um valor maior. Existem muitas razões pelas quais a réplica pode começar a ficar para trás. Se ela estiver para trás, provavelmente seu mestre já está lutando, e a sincronização completa será a gota d'água. - maxclients 10000
Número máximo de clientes simultâneos.
Em nossa experiência, é melhor definir um valor maior. O Redis lida bem com até 10 mil conexões. Apenas certifique-se de que o sistema tenha sockets suficientes. - maxmemory-policy volatile-ttl
Regra pela qual as chaves são removidas ao atingir o limite de memória disponível.
Aqui, o importante não é apenas a regra, mas a compreensão de como isso ocorrerá. O Redis merece elogios por saber lidar bem ao atingir o limite de memória.
Problemas RDB e AOF
Embora o próprio Redis armazene todas as informações na memória RAM, também há mecanismos para salvar dados no disco. Mais precisamente, três mecanismos:
- RDB-snapshot — um snapshot completo de todos os dados. É configurado usando SAVE X Y e interpretado como 'Salvar um snapshot completo de todos os dados a cada X segundos, se pelo menos Y chaves mudarem'.
- Arquivo de append-only — uma lista de operações na ordem em que foram realizadas. Adiciona novas operações ao arquivo a cada X segundos ou a cada Y operações.
- RDB e AOF — uma combinação dos dois anteriores.
Todos os métodos têm suas vantagens e desvantagens; não vou listar todas, mas gostaria de chamar a atenção para alguns pontos que não são óbvios, na minha opinião.
Primeiro, para salvar um snapshot RDB, é necessário chamar o FORK. Se os dados forem muitos, isso pode travar todo o Redis por um período que varia de alguns milissegundos a um segundo. Além disso, o sistema precisa alocar memória para esse snapshot, o que leva à necessidade de manter uma reserva de memória RAM na máquina lógica: se o Redis aloca 8 GB, a máquina virtual deve ter 16 GB disponíveis.
Em segundo lugar, existem problemas com a sincronização parcial. No modo AOF, ao reconectar o slave, em vez da sincronização parcial, pode ocorrer uma sincronização completa. Não consegui entender por que isso acontece. Mas é algo que vale a pena lembrar.
Esses dois pontos já fazem você pensar se realmente precisamos desses dados no disco, já que tudo é duplicado pelos slaves. A perda de dados só pode ocorrer se todos os slaves falharem, e isso é um problema de nível "incêndio no datacenter". Como compromisso, pode-se sugerir que os dados sejam armazenados apenas nos slaves, mas nesse caso é preciso garantir que esses slaves nunca se tornem mestres em uma recuperação de emergência (para isso, existe uma configuração de prioridade dos slaves em sua configuração). Para cada caso específico, refletimos se é necessário armazenar dados no disco e, na maioria das vezes, respondemos "não".
Conclusão
Por fim, espero ter dado uma visão geral do funcionamento do redis-cluster para aqueles que nunca ouviram falar dele, além de ter destacado alguns pontos não óbvios para quem já o utiliza há algum tempo.
Obrigado pelo seu tempo e, como sempre, comentários sobre o assunto são bem-vindos.
Fonte: habr.com
