

Outro usuário quer gravar um novo pedaço de dados no disco rígido, mas não tem espaço livre para isso. Também não quer excluir nada, pois "tudo é muito importante e necessário". E o que fazemos com isso?
Esse problema não é exclusivo dele. Nossos discos rígidos armazenam terabytes de informações, e essa quantidade não está diminuindo. Mas quão única é? Afinal, todos os arquivos são apenas conjuntos de bits de um determinado comprimento e, provavelmente, o novo não é tão diferente do que já está armazenado.
É claro que procurar pedaços de informações já armazenadas no disco rígido é uma tarefa, se não falha, no mínimo, ineficaz. Por outro lado, se a diferença é pequena, podemos ajustá-la um pouco...
TL;DR - uma segunda tentativa de explicar um método estranho de otimização de dados usando arquivos JPEG, agora de forma mais compreensível.
Sobre bits e diferenças
Se pegarmos dois pedaços de dados completamente aleatórios, em média, metade dos bits contidos neles coincide. E de fato, entre as possíveis combinações para cada par ('00, 01, 10, 11') exatamente metade tem valores coincidentes, isso é simples.
Mas, claro, se simplesmente pegarmos dois arquivos e ajustarmos um ao outro, perderemos um deles. Se formos salvar as mudanças, estamos apenas reinventando , que já existe muito bem sem nós, embora normalmente não seja usada para esses fins. Pode-se tentar embutir uma sequência menor em uma maior, mas mesmo assim corremos o risco de perder segmentos críticos de dados ao usar imprudentemente com tudo.
Entre o que e o que podemos eliminar a diferença? Ou seja, o novo arquivo gravado pelo usuário é apenas uma sequência de bits, com a qual não podemos fazer nada por conta própria. Então, temos que simplesmente encontrar no disco rígido esses bits para que possam ser alterados sem a necessidade de armazenar a diferença, permitindo que possamos suportar sua perda sem consequências sérias. E faz sentido mudar, não apenas o próprio arquivo no sistema de arquivos, mas alguma informação menos sensível dentro dele. Mas qual e como?
Métodos de ajuste
Os arquivos compactados com perda vêm em socorro. Todos esses jpeg, mp3 e outros, embora sejam compressões com perda, contêm uma quantidade de bits disponíveis para modificação segura. É possível usar técnicas avançadas que modificam discretamente seus componentes em várias partes da codificação. Espera. Técnicas avançadas... modificação discreta... alguns bits em outros... isso é quase !
De fato, embutir uma informação em outra lembra muito seus métodos. A discreção das alterações feitas para os sentidos humanos também é impressionante. Aqui, porém, os caminhos se separam — a nossa tarefa se resume a adicionar informação ao disco rígido do usuário, o que só lhe trará problemas. Ele acabará esquecendo.
Portanto, embora possamos usá-las, algumas modificações precisam ser feitas. E a seguir, eu vou explicar e demonstrar isso com um exemplo de um dos métodos existentes e de um formato de arquivo amplamente utilizado.
Sobre chacais
Se vamos comprimir, que seja o mais comprimível do mundo. Estamos falando, claro, dos arquivos JPEG. Não só existe uma tonelada de ferramentas e métodos existentes para embutir dados nele, como também é o formato gráfico mais popular deste planeta.
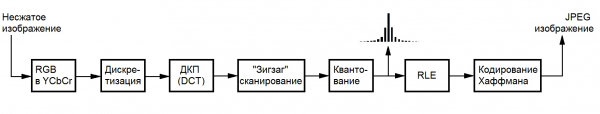
Entretanto, para não nos distrairmos, precisamos limitar nosso campo de atuação aos arquivos deste formato. Ninguém gosta de quadrados monocromáticos que aparecem devido à compressão excessiva, então devemos nos restringir a trabalhar com arquivos já comprimidos, evitando recodificação. Mais especificamente — com coeficientes inteiros, que permanecem após operações que causam perda de dados — DCT e quantização, o que é perfeitamente ilustrado no diagrama de codificação (obrigado à wikipédia da biblioteca nacional Bauman):
Existem muitos métodos possíveis para otimização de arquivos jpeg. Tem otimização sem perda (jpegtran), tem otimização “”, que na verdade ainda introduzem mudanças, mas isso não nos concerne. Afinal, se o usuário está disposto a embutir uma informação na outra para aumentar o espaço livre no disco, significa que ele já otimizou suas imagens faz tempo, ou não quer fazer isso por medo de perda de qualidade.
F5
Para essas condições, uma gama inteira de algoritmos é adequada, com os quais você pode se familiarizar . O mais avançado deles é o algoritmo sob a autoria de Andreas Westfeld, que trabalha com coeficientes de componentes de luminância, uma vez que o olho humano é menos sensível exatamente às suas mudanças. Além disso, ele utiliza uma técnica de incorporação baseada na codificação de matriz, permitindo assim realizar menos alterações ao incorporar a mesma quantidade de informação, quanto maior for o tamanho do contêiner utilizado.
As próprias mudanças se resumem à redução do valor absoluto dos coeficientes em uma unidade sob certas condições (ou seja, nem sempre), o que permite usar o F5 para otimizar o armazenamento de dados no disco rígido. A questão é que o coeficiente após essa alteração, provavelmente, ocupará um número menor de bits após a codificação de Huffman, devido à distribuição estatística dos valores em JPEG, e novos zeros terão vantagem ao serem codificados por RLE.
As modificações necessárias se concentram na eliminação da parte responsável pela confidencialidade (disposição de senha), que economiza recursos e tempo de execução, e na adição de um mecanismo para trabalhar com vários arquivos ao invés de apenas um por vez. O processo de modificação provavelmente não interessará muito ao leitor, então, vamos para a descrição da implementação.
Tecnologia avançada
Para demonstrar o funcionamento dessa abordagem, implementei um método em C puro e realizei uma série de otimizações, tanto em termos de velocidade de execução quanto de memória (você não imagina quanto esses arquivos de imagem pesam sem compressão, mesmo até DCT). A portabilidade foi alcançada utilizando uma combinação de bibliotecas , e , e aos quais sou grato. Tudo isso é compilado com 'make', portanto, os usuários do Windows que desejam avaliar, precisam instalar o Cygwin ou se familiarizar com o Visual Studio e as bibliotecas por conta própria.
A implementação está disponível na forma de uma utilidade de linha de comando e como biblioteca. Mais informações sobre o uso desta última podem ser encontradas no README do repositório no GitHub, cujo link vou fornecer no final do post.
Como usar?
Com cuidado. As imagens usadas para embalagem são selecionadas através de uma pesquisa por expressões regulares no diretório raiz especificado. Após a conclusão, os arquivos podem ser movidos, renomeados e copiados à vontade dentro dele, mudando sistemas operacionais e assim por diante. No entanto, é preciso ser extremamente cauteloso e não alterar o conteúdo direto. A perda de valor de até mesmo um único bit pode impossibilitar a recuperação das informações.
Após a conclusão do trabalho, a ferramenta deixa um arquivo de arquivo especial, contendo todas as informações necessárias para a descompactação, incluindo dados sobre as imagens utilizadas. O arquivo em si pesa cerca de alguns kilobytes e não tem um impacto significativo no espaço em disco ocupado.
É possível analisar a capacidade potencial usando a flag ‘-a’: ‘./f5ar -a [pasta de busca] [expressão regular compatível com Perl]’. A embalagem é realizada com o comando ‘./f5ar -p [pasta de busca] [expressão regular compatível com Perl] [arquivo a ser compactado] [nome do arquivo de arquivo]’, e a descompactação usando ‘./f5ar -u [arquivo de arquivo] [nome do arquivo recuperado]’.
Demonstração do funcionamento
Para mostrar a eficácia do método, carreguei uma coleção de 225 fotografias de cães completamente gratuitas do serviço e encontrei um grande PDF de 45 metros do segundo volume nos documentos de Knuth.
A sequência é bastante simples:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Lendo o arquivo de compressão... ok
Inicializando o arquivo... ok
Analisando a capacidade da biblioteca... feito em 17,0s
Capacidade garantida detectada de 48439359 bytes
Capacidade possível detectada de até 102618787 bytes
Comprimindo... feito em 39,4s
Salvando o arquivo... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Inicializando o arquivo... ok
Lendo o arquivo de arquivo... ok
Preenchendo o arquivo com arquivos... feito em 1,4s
Descomprimindo... feito em 21,0s
Escrevendo dados extraídos... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Capturas de tela para os aficionados
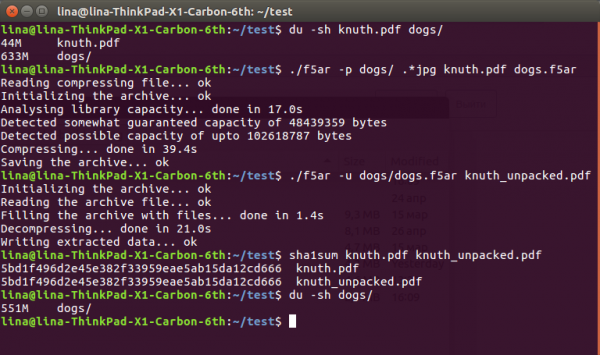
O arquivo descompactado ainda pode e deve ser lido:
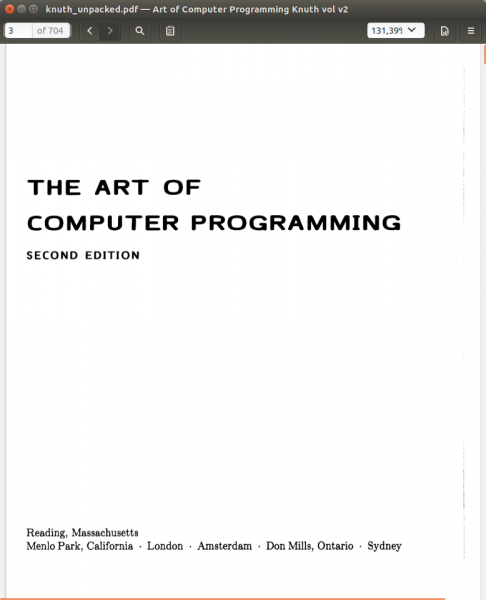
Como pode ser visto, partindo dos 633 + 36 == 669 megabytes de dados no disco rígido, chegamos a agradáveis 551. Essa diferença radical é explicada pela redução dos valores dos coeficientes que influenciam sua subsequente compressão sem perdas: a diminuição de apenas um pode facilmente "cortar" alguns bytes do arquivo final. No entanto, isso ainda representa perda de dados, mesmo que muito pequena, com a qual precisaremos lidar.
Felizmente, para o olho, eles não são absolutamente visíveis. Sob o spoiler (já que o habrastorage não suporta arquivos grandes), o leitor pode avaliar a diferença tanto visualmente quanto a intensidade, obtida subtraindo os valores do componente alterado do original: , , (quanto mais apagada a cor, menor a diferença no bloco).
Em conclusão
Diante de todas essas complicações, comprar um disco rígido ou armazenar tudo na nuvem pode parecer uma solução muito mais simples. Mas mesmo vivendo em tempos tão maravilhosos, não há garantias de que amanhã ainda será possível acessar a internet e carregar todos os seus dados excedentes em algum lugar. Ou ir a uma loja e comprar mais um disco rígido de mil terabytes. Já usar os que estão parados em casa é sempre uma opção.
->
Fonte: habr.com
