

O processo de atualização para o seu cluster Kubernetes
Em algum momento, ao usar um cluster Kubernetes, surge a necessidade de atualizar os nós em funcionamento. Isso pode incluir atualizações de pacotes, atualização do núcleo ou implantação de novas imagens de máquinas virtuais. Na terminologia do Kubernetes, isso é chamado de .
Este post é parte de um ciclo de 4 posts:
- Este post.
- Finalização correta dos pods em um cluster Kubernetes
- Finalização adiada do pod ao removê-lo
- Como evitar downtime em um cluster Kubernetes usando PodDisruptionBudgets
(Nota do tradutor: as traduções dos outros artigos do ciclo estarão disponíveis em breve)
Neste artigo, descreveremos todas as ferramentas que o Kubernetes oferece para alcançar zero downtime para os nós em seu cluster.
Definição do problema
A princípio, usaremos uma abordagem ingênua, identificando problemas e avaliando os riscos potenciais dessa abordagem, acumulando conhecimento para resolver cada um dos problemas que encontrarmos ao longo do ciclo. Como resultado, teremos uma configuração que utiliza hooks de ciclo de vida, probes de prontidão e orçamentos de interrupção de pods para alcançar nosso objetivo de zero downtime.
Para começar nossa jornada, vamos pegar um exemplo específico. Suponha que temos um cluster Kubernetes com dois nós, onde está sendo executado um aplicativo com dois pods, localizados atrás de Service:
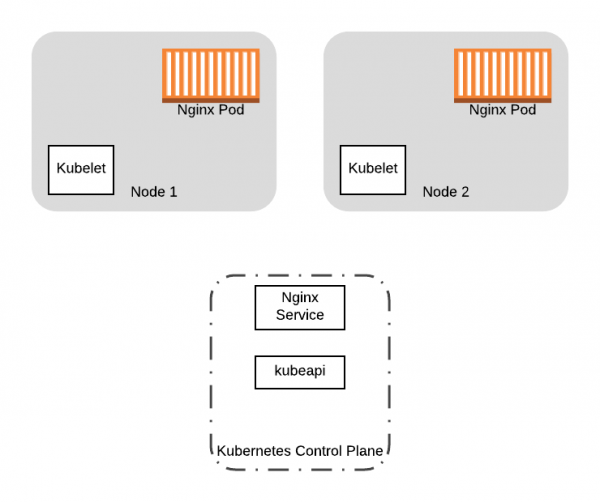
Começaremos com dois pods com Nginx e um Service sendo executados em nossos dois nós do cluster Kubernetes.
Queremos atualizar a versão do núcleo dos dois nós de trabalho em nosso cluster. Como faremos isso? Uma solução simples seria inicializar novos nós com a configuração atualizada e, em seguida, desligar os nós antigos, enquanto ligamos os novos. Embora isso funcione, haverá alguns problemas com essa abordagem:
- Quando você desligar os nós antigos, os pods em execução neles também serão desligados. E se os pods precisarem ser limpos para uma desconexão adequada? O sistema de virtualização que você está usando pode não aguardar o término do processo de limpeza.
- E se você desligar todos os nós ao mesmo tempo? Você terá um downtime considerável enquanto os pods são realocados para os novos nós.
Precisamos de uma maneira adequada de migrar pods de nós antigos e, ao mesmo tempo, garantir que nenhum dos nossos processos de trabalho esteja em execução enquanto fazemos alterações no nó. Ou, quando fazemos uma substituição completa do cluster, como no exemplo (ou seja, substituindo imagens de VM), queremos transferir aplicativos em funcionamento de nós antigos para novos. Em ambos os casos, queremos evitar o agendamento de novos pods em nós antigos e, em seguida, desalojar todos os pods em execução deles. Para alcançar esses objetivos, podemos usar o comando kubectl drain.
Redistribuição de todos os pods do nó
A operação drain permite redistribuir todos os pods do nó. Durante a execução do drain, o nó é marcado como não agendável (flag NoSchedule). Isso impede que novos pods sejam agendados nele. Em seguida, o drain começa a desalojar os pods do nó, finalizando os contêineres que estão em execução no nó atualmente, enviando o sinal TERM para os contêineres no pod.
Embora kubectl drain Embora se saia bem ao desalojar pods, há mais dois fatores que podem causar falhas na operação drain:
- Seu aplicativo deve ser capaz de finalizar corretamente ao receber
TERMo sinal. Quando os pods são desalojados, o Kubernetes envia um sinalTERMpara os contêineres e aguarda sua parada por um determinado período, após o qual, se não tiverem parado, finaliza-os forçosamente. De qualquer forma, se seu contêiner não atender ao sinal corretamente, você ainda pode desligar pods de maneira inadequada se eles estiverem em funcionamento naquele momento específico (por exemplo, se uma transação estiver sendo realizada no BD). - Você perde todos os pods que contêm seu aplicativo. Ele pode estar indisponível no momento do início de novos contêineres em novos nós ou, se seus pods estiverem implantados sem controladores, eles podem não reiniciar de forma alguma.
Evitando o tempo de inatividade
Para minimizar o tempo de inatividade de interrupções voluntárias, como a operação drain para o nó, o Kubernetes oferece as seguintes opções para lidar com falhas:
Nas demais partes do ciclo, usaremos essas funções do Kubernetes para atenuar os efeitos da migração de pods. Para facilitar o acompanhamento da ideia principal, utilizaremos nosso exemplo acima com a seguinte configuração de recursos:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Esta configuração é um exemplo mínimo Deployment, que gerencia pods nginx no cluster. Além disso, a configuração descreve o recurso Service, que pode ser utilizado para acessar os pods nginx no cluster.
Ao longo de todo o ciclo, expandiremos iterativamente esta configuração, de modo que, ao final, ela inclua todas as capacidades fornecidas pelo Kubernetes para reduzir o tempo de inatividade.
Para obter uma versão completamente implementada e testada de atualizações do cluster Kubernetes com tempo de inatividade zero na AWS e outros recursos, visite .
Leia também outros artigos em nosso blog:
Fonte: habr.com
