

Desenvolver um armazém é um trabalho demorado e sério.
Muito na vida de um projeto depende de quão bem elaborada está a modelagem de objetos e a estrutura do banco desde o início.
A abordagem comum sempre foi e permanece sendo várias combinações do esquema “estrela” com a terceira forma normal. Geralmente, pelo princípio: dados brutos — 3NF, vitrines — estrela. Essa abordagem, comprovada pelo tempo e respaldada por uma quantidade considerável de pesquisas, é a primeira (e às vezes a única) que vem à mente de um experiente especialista em DWH ao pensar em como deve ser um armazém analítico.
Por outro lado, os negócios em geral e os requisitos do cliente em particular tendem a mudar rapidamente, e os dados a crescer tanto em “profundidade” quanto em “largura”. E é aqui que se revela a principal desvantagem da estrela — sua limitação. flexibilidade.
E se na sua vida tranquila e confortável de desenvolvedor de DWH, de repente:
- surgiu a tarefa de “fazer rapidamente algo, e depois veremos”;
- apareceu um projeto em rápida expansão, com a inclusão de novas fontes e a reformulação do modelo de negócios pelo menos uma vez por semana;
- surgiu um cliente que não tem ideia de como o sistema deve parecer e quais funções deve desempenhar no final, mas que está aberto a experimentos e ajustes sucessivos dos resultados desejados, aproximando-se deles gradualmente;
- um gerente de projetos apareceu com a feliz notícia: “E agora temos ágil!”.
Ou se você está apenas curioso para saber de que outras maneiras os armazéns podem ser construídos — bem-vindo ao post!
O que significa “flexibilidade”?
Para começar, vamos definir quais propriedades um sistema deve ter para ser considerado “flexível”.
Vale a pena ressaltar que as propriedades descritas devem se referir especificamente a o sistema, e não a processo de seu desenvolvimento. Portanto, se você queria ler sobre Agile como metodologia de desenvolvimento, é melhor consultar outros artigos. Por exemplo, aqui mesmo, no Habr, existem muitos materiais interessantes (como e , quanto o ).
Isso não significa que o processo de desenvolvimento e a estrutura de um Data Warehouse (DW) não estejam de forma alguma interligados. De modo geral, desenvolver um armazém com uma arquitetura flexível utilizando Agile deve ser significativamente mais fácil. No entanto, na prática, é mais comum encontrar implementações com desenvolvimento Agile de um DW clássico pelo método Kimball ou DataVault — seguindo o waterfall, do que coincidir com a flexibilidade em suas duas formas em um único projeto.
Assim, quais características um armazém flexível deve ter? Podemos destacar três pontos:
- Entrega antecipada e rápida adaptação — isso significa que, idealmente, o primeiro resultado comercial (por exemplo, os primeiros relatórios funcionais) deve ser obtido o mais rápido possível, ou seja, antes de todo o sistema ser completamente projetado e implementado. Além disso, cada adaptação subsequente também deve levar o menor tempo possível.
- Revisão iterativa — isso significa que cada adaptação subsequente não deve, idealmente, afetar as funcionalidades já operacionais. Este aspecto frequentemente se torna o maior pesadelo em grandes projetos — cedo ou tarde, objetos individuais começam a acumular tantas interconexões que se torna mais simples duplicar completamente a lógica em uma cópia ao lado do que adicionar um campo à tabela existente. E se você se surpreende ao descobrir que a análise do impacto da adaptação nos objetos existentes pode levar mais tempo do que a própria adaptação — provavelmente você ainda não trabalhou com grandes DWs em setores bancário ou de telecomunicações.
- Adaptação contínua às mudanças nos requisitos de negócios — a estrutura geral dos objetos deve ser projetada não apenas considerando a possibilidade de expansão, mas com a previsão de que a direção dessa expansão poderia nunca ter sido imaginada na fase de design.
E sim, atender a todos esses requisitos em um único sistema é possível (claro, em certos casos e com algumas ressalvas).
Abaixo, eu revisarei duas das metodologias mais populares para projetos flexíveis de DW — Modelo Anchor e Data Vault. Há técnicas maravilhosas que ficam de fora, como EAV, 6NF (na sua forma pura) e tudo que se refere a soluções NoSQL - não porque sejam de alguma forma piores, e nem porque o artigo correria o risco de se tornar o tamanho de uma dissertação média. Simplesmente, tudo isso se relaciona a soluções de uma classe um pouco diferente - ou a técnicas que você pode aplicar em casos específicos, independentemente da arquitetura geral do seu projeto (como EAV), ou a paradigmas de armazenamento de informações totalmente diferentes (como, por exemplo, bancos de dados de grafos e outras opções NoSQL).
Problemas da abordagem “clássica” e suas soluções em metodologias ágeis
Com a abordagem “clássica”, refiro-me ao velho conhecido (independentemente da implementação específica das camadas subjacentes, que os adeptos de Kimball, Inmon e CDM me perdoem).
1. Cardinalidade rígida dos relacionamentos
Nesta modelagem, há uma clara separação de dados em dimensões (Dimension) e fatos (Fact). E isso, veja bem, faz sentido - pois a análise de dados na esmagadora maioria dos casos se resume à análise de indicadores numéricos específicos (fatos) em determinadas perspectivas (dimensões).
Além disso, os relacionamentos entre os objetos são estabelecidos na forma de ligações entre tabelas por chaves estrangeiras. Isso parece bastante natural, mas leva imediatamente à primeira limitação da flexibilidade - definição rígida da cardinalidade dos relacionamentos..
Isso significa que, na fase de design das tabelas, você deve definir com precisão para cada par de objetos relacionados se eles podem se relacionar como muitos-para-muitos, ou apenas um-para-muitos, e “em que direção”. Isso afeta diretamente em qual tabela estará a chave primária e em qual estará a chave estrangeira. Alterar esse relacionamento ao receber novos requisitos provavelmente resultará em uma reestruturação do banco de dados.
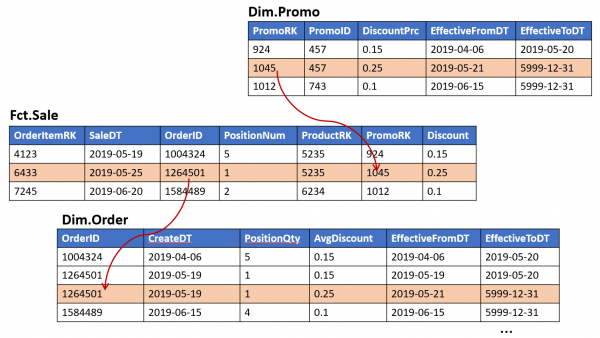
Por exemplo, ao projetar um objeto “comprovante de pagamento”, você, baseando-se nas promessas feitas pelo departamento de vendas, planejou a possibilidade de uma promoção se aplicar a várias linhas do comprovante mas não o contrário:
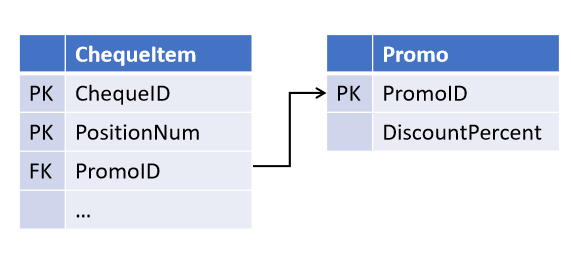
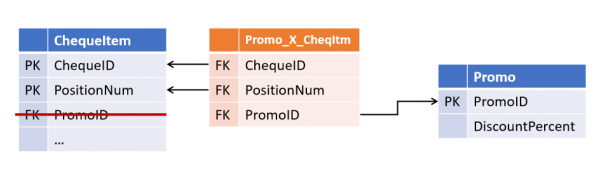
E depois de um tempo, os colegas introduziram uma nova estratégia de marketing, na qual várias promoções podem ser aplicadas simultaneamente à mesma linha. Agora você precisa revisar as tabelas, destacando o relacionamento como um objeto separado..
(Todos os objetos derivados no qual ocorre o join na promoção também precisam ser ajustados agora).
Relações no Data Vault e no Modelo Anchor
Evitar tal situação foi bastante simples: não se deve confiar no departamento de vendas para isso. Manter todas as relações inicialmente em tabelas separadas. E processá-las como muitos-para-muitos.
Essa abordagem foi proposta por Dan Linstedt como parte da paradigmática Data Vault e totalmente apoiada por Lars Rönnbäck em do Modelo Anchor.
No final, obtemos a primeira característica distintiva das metodologias ágeis:
As relações entre os objetos não são armazenadas nos atributos das entidades pai, mas constituem um tipo separado de objetos.
Em Data Vault Essas tabelas de junção são chamadas Ligação, e no Modelo Anchor — Tie. À primeira vista, elas parecem muito semelhantes, embora suas diferenças não se limitem ao nome (sobre isso falaremos mais abaixo). Em ambas as arquiteturas, as tabelas de junção podem conectar qualquer número de entidades (não necessariamente 2).
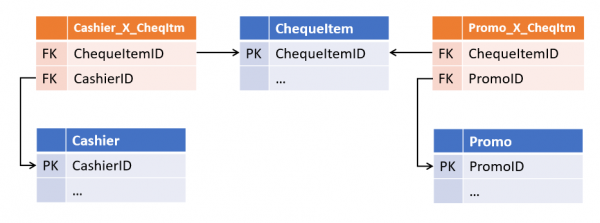
Essa aparente redundância proporciona uma flexibilidade significativa em ajustes. Essa estrutura torna-se tolerante não apenas às mudanças nas cardinalidades das relações existentes, mas também à adição de novas — se agora uma posição de cheque tiver uma referência ao caixa que a processou, o surgimento de tal junção será apenas uma extensão das tabelas existentes sem impactar quaisquer objetos e processos existentes.
2. Duplicação de dados
O segundo problema abordado por arquiteturas flexíveis é menos óbvio e é característico principalmente de medidas do tipo SCD2 (medidas lentamente mudando do segundo tipo), embora não apenas para elas.
Em um armazém de dados clássico, a medida geralmente é uma tabela que contém uma chave substituta (como PK) e também um conjunto de chaves e atributos de negócio em colunas separadas.
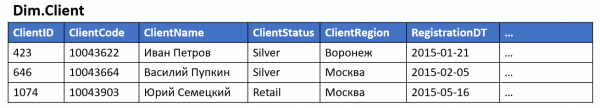
Se a medida suporta versionamento, ao conjunto padrão de campos são adicionados limites de tempo de validade da versão, e na fonte uma linha aparece com várias versões no armazém (uma para cada alteração dos atributos de versão).
Se a medição contiver pelo menos um atributo de versão que muda com frequência, o número de versões dessa medição será considerável (mesmo que os outros atributos não sejam versionados ou nunca mudem) e, se houver vários desses atributos, o número de versões pode crescer em progressão geométrica de acordo com sua quantidade. Essa medição pode ocupar um espaço significativo em disco, embora a maior parte dos dados armazenados sejam apenas cópias de valores de atributos imutáveis de outras linhas.
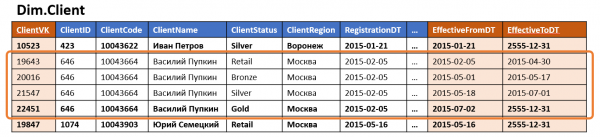
Nesse contexto, é muito comum também aplicar a desnormalização — parte dos atributos é intencionalmente armazenada como valor, e não como referência a um dicionário ou outra medição. Essa abordagem acelera o acesso aos dados, reduzindo o número de joins ao acessar a medição.
Geralmente, isso resulta no fato de que a mesma informação é armazenada simultaneamente em vários locais. Por exemplo, informações sobre a região de residência e a categoria do cliente podem ser armazenadas simultaneamente nas medições "Cliente" e nos fatos "Compra", "Entrega" e "Chamadas ao centro de atendimento", além da tabela de vínculo "Cliente — Gerente de Cliente".
De modo geral, o que foi descrito acima também se aplica a medições normais (não versionadas), mas em medições versionadas pode ter uma escala diferente: a aparição de uma nova versão de um objeto (especialmente retroativamente) resulta não apenas na atualização de todas as tabelas relacionadas, mas na cascata de novas versões de objetos relacionados — quando a Tabela 1 é usada na construção da Tabela 2, e a Tabela 2 é usada na construção da Tabela 3, e assim por diante. Mesmo que nenhum atributo da Tabela 1 participe da construção da Tabela 3 (mas outros atributos da Tabela 2, obtidos de outras fontes, participem), a atualização versionada dessa construção resultará, no mínimo, em custos adicionais, e no máximo — em versões desnecessárias na Tabela 3, que aqui está completamente "fora da questão", e assim por diante ao longo da cadeia.
3. Complexidade não linear de ajustes
Nesse contexto, cada nova vitrine que é construída com base em outra aumenta o número de locais onde os dados podem "divergir" ao se fazer alterações no ETL. Isso, por sua vez, leva a um aumento da complexidade (e duração) de cada ajuste subsequente.
Se o descrito acima se aplica a sistemas com processos ETL que raramente são modificados, é possível viver nessa paradigma — basta garantir que novas modificações sejam corretamente aplicadas a todos os objetos relacionados. No entanto, se as modificações ocorrem com frequência, a probabilidade de acidentalmente "perder" várias conexões aumenta significativamente.
Além disso, se considerarmos que o ETL "versionado" é substancialmente mais complexo do que o "não versionado", evitar erros durante a modificação frequente de todo esse conjunto se torna bastante difícil.
Armazenamento de objetos e atributos no Data Vault e no Modelo Âncora
A abordagem proposta pelos autores de arquiteturas flexíveis pode ser formulada assim:
É necessário separar o que muda do que permanece inalterado. Ou seja, armazenar chaves separadamente dos atributos.
Ao mesmo tempo, não devemos confundir não versionado atributo com imutável: o primeiro não registra o histórico de suas alterações, mas pode mudar (por exemplo, ao corrigir um erro de entrada ou ao receber novos dados) o segundo — nunca muda.
As opiniões sobre o que pode ser considerado imutável no Data Vault e no Modelo Âncora divergem.
Do ponto de vista da arquitetura Data Vault, o que pode ser considerado imutável é todo o conjunto de chaves — naturais (CNPJ da empresa, código do produto no sistema de origem, etc.) e surrogate. Enquanto isso, os outros atributos podem ser divididos em grupos por origem e/ou frequência de mudanças e para cada grupo, manter uma tabela separada com um conjunto independente de versões.
Na paradigma do Modelo Âncora , considera-se imutável apenas a chave surrogate da entidade. Tudo o mais (incluindo chaves tradicionais) é apenas uma condição particular de seus atributos. Nesse contexto, todos os atributos, por padrão, são independentes uns dos outros, portanto, para cada atributo, deve ser criada uma tabela separada.
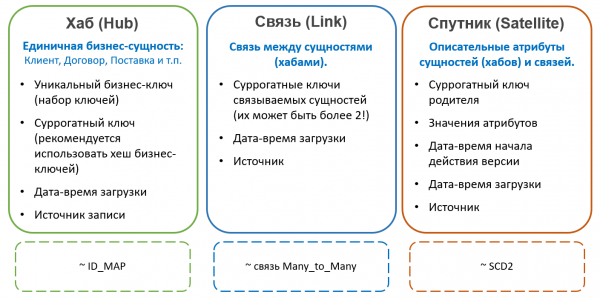
Em Data Vault as tabelas que contêm as chaves das entidades são chamadas de Hubs. Os Hubs sempre contêm um conjunto fixo de campos:
- Chaves naturais da entidade
- Chave surrogate
- Referência à fonte
- Tempo de adição do registro
Registros nos Hubs nunca são modificados e não têm versões.. Os hubs se parecem muito com tabelas do tipo ID-map, usadas em alguns sistemas para gerar substitutos, mas na prática do Data Vault, recomenda-se utilizar não um sequencial inteiro como substituto, mas um hash de um conjunto de chaves de negócios. Essa abordagem simplifica o carregamento de relacionamentos e atributos das fontes (não é necessário fazer join no hub para obter um substituto, basta calcular o hash da chave natural), mas pode causar outros problemas (como colisões, distinção de maiúsculas e minúsculas e caracteres não imprimíveis em chaves de string, etc.), portanto, não é uma prática comum.
Todos os outros atributos das entidades são armazenados em tabelas especiais chamadas Satélites (Satellit). Um hub pode ter vários satélites, armazenando diferentes conjuntos de atributos.
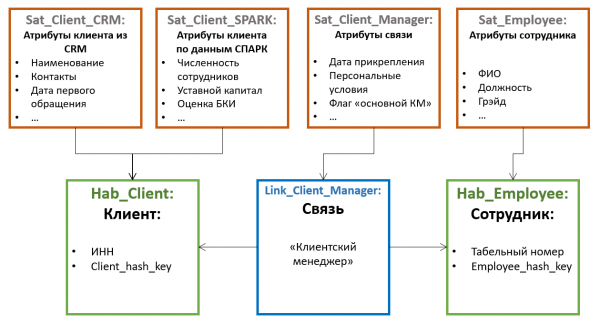
A distribuição de atributos entre os satélites segue o princípio de alteração conjunta — em um satélite podem ser armazenados atributos não versionados (por exemplo, data de nascimento e CPF para uma pessoa física), em outro, atributos versionados que mudam raramente (por exemplo, sobrenome e número do passaporte), e em um terceiro, atributos que mudam frequentemente (por exemplo, endereço de entrega, categoria, data do último pedido, etc.). A versionamento é gerido em nível de satélites individuais, e não da entidade como um todo, portanto, a distribuição dos atributos deve ser feita de maneira a minimizar a interseção de versões dentro de um único satélite (o que reduz o número total de versões armazenadas).
Além disso, para otimizar o processo de carregamento de dados, atributos obtidos de várias fontes são frequentemente colocados em satélites separados.
Os satélites são associados ao Hub por meio de uma chave estrangeira o que corresponde à cardinalidade 1-para-muitos. Isso significa que múltiplos valores de atributos (por exemplo, vários números de telefone de contato para um único cliente) são suportados por essa arquitetura 'por padrão'.
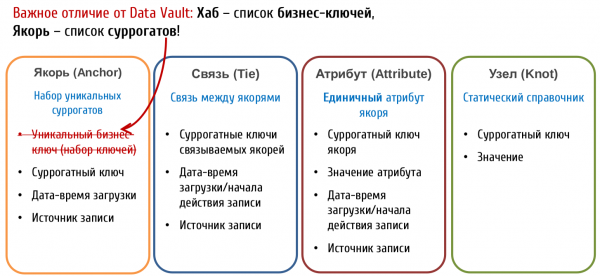
Em Modelo Âncora (Anchor Model) tabelas que armazenam chaves são chamadas de Âncoras (Anchor). E elas armazenam:
- Somente chaves substitutas
- Referência à fonte
- Tempo de adição do registro
Chaves naturais, do ponto de vista do Modelo Âncora, são consideradas atributos comuns. Essa variante pode parecer mais complexa de entender, mas oferece muito mais espaço para a identificação do objeto.
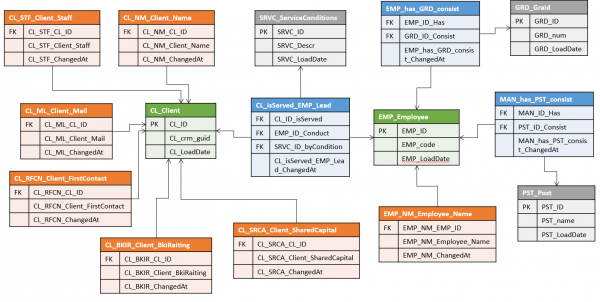
Por exemplo, se os dados sobre uma mesma entidade podem vir de diferentes sistemas, cada um utilizando sua própria chave natural. No Data Vault, isso pode levar a construções bastante complexas compostas por vários hubs (um para cada fonte + uma versão mestre unificadora), enquanto na Modelo Ancorado, a chave natural de cada fonte entra em seu próprio atributo e pode ser utilizada durante o carregamento independentemente dos demais.
Mas aqui há um detalhe traiçoeiro: se em uma entidade atributos de diferentes sistemas são combinados, provavelmente existem certas regras de 'união', segundo as quais o sistema deve entender que registros de diferentes fontes correspondem a uma única instância da entidade.
Em Data Vault Essas regras provavelmente definirão a formação do 'hub substituto' da entidade mestre e não afetarão os Hubs que armazenam as chaves naturais das fontes e seus atributos originais. Se em algum momento as regras de união mudarem (ou houver uma atualização dos atributos pelos quais isso é feito), será suficiente reformular os hubs substitutos.
Em O Modelo Ancorado por sua vez, armazenará essa entidade em um único âncora. Isso significa que todos os atributos, independentemente da fonte de onde foram obtidos, estarão vinculados ao mesmo substituto. Separar registros erroneamente unificados e acompanhar a relevância da união em um sistema assim pode ser consideravelmente mais difícil, especialmente se as regras forem complexas e mudarem frequentemente, e um mesmo atributo puder ser obtido a partir de diferentes fontes (embora isso seja definitivamente possível, pois cada versão do atributo mantém um link para sua fonte).
Em todo caso, se em seu sistema está prevista a implementação de funcionalidades de deduplicação, fusão de registros e outros elementos de MDM, vale a pena prestar atenção especial aos aspectos de armazenamento de chaves naturais em metodologias flexíveis. Provavelmente, a construção mais complexa do Data Vault acabará sendo mais segura em termos de erros de fusão.
O Modelo Ancorado também prevê um tipo adicional de objeto chamado Nó (Knot) na verdade, é uma espécie de forma degenerada de âncora, que pode conter apenas um atributo. Os nós são destinados a armazenar catálogos planos (por exemplo, gênero, estado civil, categoria de atendimento ao cliente, etc.). Diferente do Âncora, o Nó não possui tabelas de atributos relacionadas, e seu único atributo (nome) sempre é armazenado em uma tabela com a chave. Os nós se conectam com âncoras através de tabelas de relacionamento (Tie) da mesma forma que âncoras se conectam umas às outras.
Não há uma opinião unânime sobre o uso de Nós. Por exemplo, , que promove ativamente o uso do modelo de Âncora na Rússia, acredita (não sem fundamentos) que não se pode afirmar com certeza que qualquer catálogo sempre será estático e de um nível, portanto, para todos os objetos é melhor usar imediatamente uma Âncora completa.
Outra importante diferença entre o Data Vault e o modelo de Âncora reside na presença de atributos nas relações:
Em Data Vault As relações são objetos tão completos quanto os Hubs e podem ter atributos próprios. No O Modelo Ancorado As relações são utilizadas apenas para conectar Âncoras e não podem ter atributos próprios.Essa diferença leva a abordagens de modelagem substancialmente diferentes de fatos, sobre o que falaremos a seguir.
Armazenamento de fatos
Antes, falamos principalmente sobre a modelagem de dimensões. Com os fatos, a situação é um pouco menos clara.
Em Data Vault Um objeto típico para armazenamento de fatos é Relação (Link), cujos Satelites acumulam métricas reais.
Essa abordagem parece intuitivamente clara. Ela oferece acesso simples aos indicadores analisáveis e se assemelha a uma tabela de fatos tradicional (apenas os indicadores não são armazenados na própria tabela, mas sim em uma 'vizinhança'). Mas há armadilhas: uma das adequações típicas do modelo — a ampliação da chave do fato — exige a adição de uma nova chave estrangeira no Link. E isso 'desmonta' a modularidade e potencialmente causa a necessidade de ajustes em outros objetos.
Em O Modelo Ancorado A ligação não pode ter atributos próprios, portanto, essa abordagem não funcionará — absolutamente todos os atributos e métricas devem estar vinculados a uma âncora específica. A conclusão é simples — cada fato também precisa de sua própria âncora.Para parte do que costumamos perceber como fatos, isso pode parecer natural — por exemplo, o fato da compra se resume ao objeto 'pedido' ou 'recibo', a visita ao site — à sessão, etc. Mas existem também fatos para os quais encontrar um 'objeto-portador' natural não é tão simples — como os estoques de produtos no início de cada dia.
Consequentemente, não há problemas com a modularidade ao expandir a chave do fato no Modelo Âncora (basta adicionar uma nova Relação ao Âncora correspondente), mas o projeto do modelo para representar fatos é menos claro, podendo surgir Âncoras 'artificiais' que representam o modelo de negócio de forma não óbvia.
Como se alcança a flexibilidade
A construção resultante em ambos os casos contém substancialmente mais tabelas, do que uma medida tradicional. Mas pode ocupar substancialmente menos espaço em disco com o mesmo conjunto de atributos de versão que uma medida tradicional. Não há mágica, naturalmente — tudo se resume à normalização. Distribuindo atributos entre Sátelites (no Data Vault) ou tabelas separadas (Modelo Âncora), reduzimos (ou eliminamos completamente) a duplicação de valores de alguns atributos ao alterar outros.
Para Data Vault o ganho dependerá da distribuição dos atributos entre Sátelites, e para O Modelo Ancorado — é praticamente diretamente proporcional à média de versões por objeto de medida.
No entanto, a economia de espaço — é uma vantagem importante, mas não a principal do armazenamento separado de atributos. Junto com o armazenamento separado de relações, essa abordagem torna o repositório uma construção modular. Isso significa que a adição tanto de atributos individuais quanto de novas áreas temáticas em tal modelo parece uma superestrutura sobre o conjunto existente de objetos sem alterá-los. E é exatamente isso que torna as metodologias descritas flexíveis.
Isso também lembra a transição da produção individual para a produção em massa — se na abordagem tradicional cada tabela do modelo é única e requer atenção separada, nas metodologias flexíveis — é um conjunto de 'peças' típicas. Por um lado, o número de tabelas aumenta, e os processos de carregamento e extração de dados parecem mais complexos. Por outro lado — elas se tornam típicas. E isso significa que podem ser automatizados e geridos por metadados. A pergunta "como vamos organizar?", cuja resposta poderia ocupar uma parte significativa do trabalho de design de ajustes, agora simplesmente não se coloca (assim como a questão do impacto da mudança de modelo nos processos em andamento).
Isso não significa que os analistas em tal sistema sejam completamente desnecessários — alguém ainda precisa trabalhar no conjunto de objetos com atributos e entender de onde e como carregar tudo isso. Mas o volume de trabalho, bem como a probabilidade e o custo de erro, diminuem significativamente. Tanto na fase de análise quanto no desenvolvimento de ETL, que, em grande parte, pode se resumir à edição de metadados.
O lado oscuro
Tudo o que foi descrito acima torna ambas as abordagens realmente flexíveis, tecnológicas e adequadas para iterações. Claro que há também um "barril de alcatrão", sobre o qual você, eu acho, já suspeita.
A decomposição de dados, que está na base da modularidade das arquiteturas flexíveis, leva ao aumento do número de tabelas e, consequentemente, custos indiretos de joins durante a seleção. Para obter todos os atributos de uma medida, em um armazém clássico, basta um select, enquanto a arquitetura flexível exigirá uma série de joins. E se para relatórios todos esses joins podem ser escritos com antecedência, os analistas, acostumados a escrever SQL manualmente, sofrerão em dobro.
Existem alguns fatos que facilitam tal situação:
Ao trabalhar com grandes dimensões, quase nunca são usados todos os seus atributos ao mesmo tempo. Isso significa que pode haver menos joins do que parece à primeira vista no modelo. No Data Vault, também é possível considerar a frequência prevista de uso conjunto ao distribuir atributos entre satélites. Nesse contexto, os Hubs ou Ancoras são necessários principalmente para gerar e mapear substitutos na fase de carga e raramente são usados em consultas (especialmente no que diz respeito às Ancoras).
Todos os joins — por chave. Além disso, um método de armazenamento de dados mais "compacto" reduz a sobrecarga ao escanear tabelas onde necessário (como na filtragem por valor de atributo). Isso pode resultar em consultas a um banco de dados normalizado com muitos joins sendo até mais rápidas do que escanear uma única dimensão pesada com muitas versões por linha.
Por exemplo, aqui na artigo, há um teste comparativo detalhado de desempenho do Modelo Anchor com consulta de uma única tabela.
Muito depende do mecanismo. Muitas plataformas modernas têm mecanismos internos de otimização de joins. Por exemplo, o MS SQL e o Oracle conseguem "pular" joins em tabelas se seus dados não são utilizados em nenhum outro lugar além de outros joins e não afetam a consulta final (eliminação de tabela/join), enquanto o MPP Vertica, de acordo , se mostrou um ótimo mecanismo para o Modelo Anchor com alguma otimização manual do plano de consulta. Por outro lado, armazenar o Modelo Anchor, por exemplo, no Click House, que tem suporte limitado a joins, não parece uma boa ideia.
Além disso, existem técnicas especiais, que facilitam o acesso a dados (tanto do ponto de vista da performance das consultas quanto para os usuários finais). Por exemplo, tabelas Point-In-Time no Data Vault ou funções de tabela especiais no Modelo Anchor.
Total
A essência das arquiteturas flexíveis discutidas está na modularidade de sua "construção".
É essa propriedade que permite:
- Após alguma preparação inicial, ligada à implantação de metadados e à escrita de algoritmos básicos de ETL, fornecer rapidamente ao cliente o primeiro resultado na forma de alguns relatórios, contendo dados de apenas alguns objetos fonte. Não é necessário pensar completamente (mesmo em alto nível) em todo o modelo de objetos para isso.
- O modelo de dados pode começar a funcionar (e trazer benefícios) com apenas 2-3 objetos e depois crescer gradualmente (em relação ao Modelo Anchor, Nikolai uma bela comparação com uma micélio).
- A maioria das melhorias, incluindo a expansão do domínio e a adição de novas fontes não afeta a funcionalidade existente e não corre o risco de quebrar algo que já está funcionando..
- Graças à decomposição em elementos padrão, os processos ETL em tais sistemas apresentam uma aparência homogênea, sua escrita pode ser algoritmizada e, em última análise, automatizada.
O preço dessa flexibilidade é desempenho. Isso não significa que alcançar um desempenho aceitável em tais modelos seja impossível. Na maioria das vezes, pode apenas exigir mais esforços e atenção aos detalhes para atingir as métricas desejadas.
Aplicativos
Tipos de entidade Data Vault
Saiba mais sobre Data Vault:
Tipos de entidades Modelo Âncora
Saiba mais sobre o Modelo Anchor:
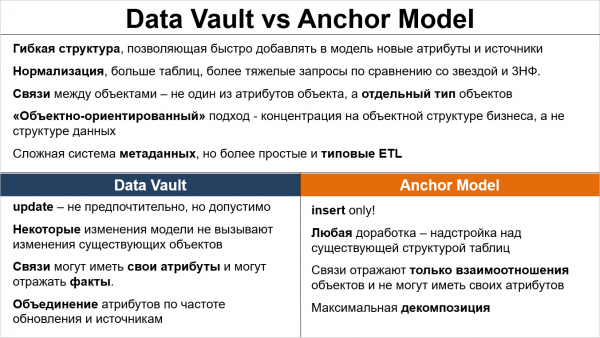
Tabela resumo com características comuns e diferenças entre os enfoques discutidos:
Fonte: habr.com
