

O navegador Chromium, um projeto de código aberto em desenvolvimento ativo que serve como base para o Google Chrome e o novo Microsoft Edge, chamou a atenção negativa por causa de uma função que foi concebida com boas intenções: ela verifica se o provedor não está 'roubando' resultados inexistentes de consultas de domínio do usuário.
, que cria consultas falsas para 'domínios' aleatórios, cuja existência é estatisticamente improvável, é responsável por cerca de metade do tráfego total recebido pelos servidores DNS raiz em todo o mundo. O engenheiro da Verisign, Matt Thomas, escreveu um post detalhado no blog da APNIC descrevendo o problema e avaliando sua magnitude.
Como normalmente ocorre a resolução DNS
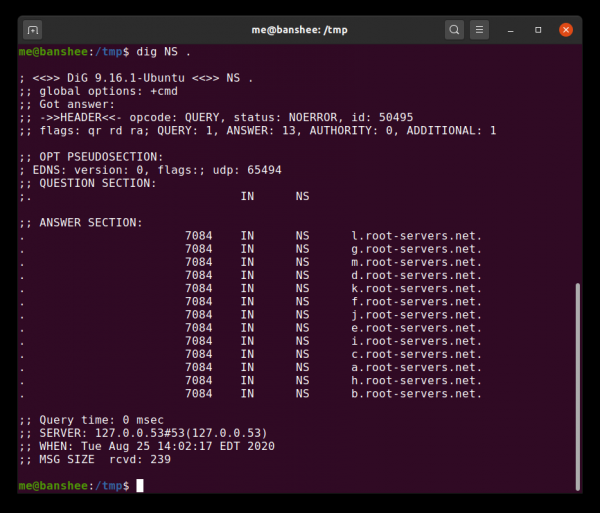
Esses servidores são a instância máxima a ser consultada para resolver .com, .net e assim por diante, para que eles informem que frglxrtmpuf não é um domínio de topo (TLD).
DNS, ou Sistema de Nomes de Domínio, é o sistema que permite que os computadores convertam nomes de domínio memoráveis como arstechnica.com em endereços IP muito menos amigáveis, como 3.128.236.93. Sem o DNS, a Internet não poderia existir de maneira utilizável para as pessoas, e, portanto, a carga indesejada na infraestrutura de nível superior é um problema real.
Para carregar uma única página da web moderna, pode ser necessário um número inconcebível de operações de busca DNS. Por exemplo, ao analisarmos a página inicial da ESPN, contamos 93 nomes de domínio separados, de a.espncdn.com até z.motads.com. Todos eles são necessários para o carregamento completo da página!
Para que o sistema de busca possa suportar essa carga, já que precisa atender todo o mundo, o DNS é projetado como uma hierarquia em múltiplos níveis. No topo dessa pirâmide estão os servidores raiz — cada domínio de topo, como .com, possui seu próprio conjunto de servidores que são a instância máxima para cada domínio abaixo deles. Um nível acima destes servidores estão os próprios servidores raiz, de a.root-servers.net até m.root-servers.net.
Com que frequência isso acontece?
Graças à hierarquia de cache em múltiplos níveis da infraestrutura DNS, uma pequena porcentagem das consultas DNS globais atinge os servidores raiz. A maioria das pessoas obtém informações do resolvedor DNS diretamente de seu provedor. Quando um dispositivo do usuário precisa descobrir como acessar um site específico, a consulta é enviada inicialmente a um servidor DNS gerenciado por esse provedor local. Se o servidor DNS local não souber a resposta, ele direciona a consulta para seus próprios "servidores de encaminhamento" (caso estejam especificados).
Se nem o servidor DNS do provedor local, nem os "servidores de encaminhamento" configurados em sua configuração tiverem uma resposta em cache, a consulta é levantada diretamente para o servidor autoritativo do domínio. acima aquele que você está tentando resolver. No caso de domínio.com isso significa que a consulta é enviada aos servidores autoritativos do próprio domínio com, que estão localizados em gtld-servers.net.
Sistema gtld-servers, a que foi feita a consulta, responde com uma lista de servidores de nomes autoritativos para o domínio domínio.com, bem como pelo menos um registro vinculante contendo o endereço IP de um desses servidores de nomes. Em seguida, as respostas descem pela cadeia — cada servidor de encaminhamento passa essas respostas para baixo para o servidor que as solicitou, até que a resposta finalmente chegue ao servidor do provedor local e ao computador do usuário. Todos eles armazenam em cache essa resposta, para não perturbar os sistemas de níveis superiores.
Na maioria dos casos, os registros dos servidores de nomes para domínio.com já estarão armazenados em cache em um desses servidores de encaminhamento, portanto, os servidores raiz não são contatados. No entanto, enquanto falamos sobre o tipo de URL que conhecemos — aquele que é resolvido em um website convencional. As consultas do Chrome referem-se ao nível acima disso, no nível dos próprios clusters root-servers.net.
Chromium e verificação de sequestro NXDomain
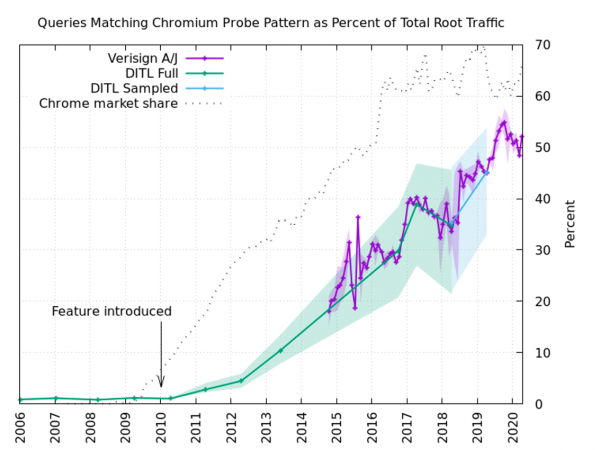
As verificações do Chromium "este servidor DNS não está me enganando?" representam quase metade de todo o tráfego que chega ao cluster dos servidores DNS raiz da Verisign.
O navegador Chromium, projeto-mãe do Google Chrome, do novo Microsoft Edge e de inúmeros navegadores menos conhecidos, deseja fornecer aos usuários uma maneira simples de buscar em um único campo, às vezes chamado de "Omnibox". Em outras palavras, o usuário insere tanto URLs reais quanto consultas de busca no mesmo campo de texto na parte superior da janela do navegador. Dando mais um passo em direção à simplificação, ele também não exige que o usuário insira parte da URL com http:// ou https://.
Por mais conveniente que seja, essa abordagem exige que o navegador entenda o que deve ser considerado como URL e o que é uma consulta de busca. Na maioria das vezes, isso é bastante óbvio — por exemplo, uma string com espaços não pode ser um URL. No entanto, a situação pode ser mais complicada quando se consideram intranets — redes privadas que também podem usar domínios de nível superior privados para resolver verdadeiros sites na web.
Se um usuário em sua intranet corporativa digitar "marketing", e houver um site interno na empresa com o mesmo nome, o Chromium mostrará uma janela informativa perguntando ao usuário se ele deseja buscar por "marketing" ou ir para https://marketing. Isso é tolerável, mas muitos provedores de internet e provedores de redes Wi-Fi públicas "capturam" cada URL digitado com erro, redirecionando o usuário para alguma página repleta de anúncios.
Geração aleatória
Os desenvolvedores do Chromium não queriam que usuários em redes comuns vissem uma janela informativa questionando o que eles queriam dizer a cada vez que buscassem uma única palavra, então implementaram um teste: ao iniciar o navegador ou mudar de rede, o Chromium executa buscas DNS de três "domínios" de nível superior gerados aleatoriamente, com entre sete e quinze caracteres. Se quaisquer dois desses pedidos retornarem com o mesmo endereço IP, o Chromium assume que a rede local está "capturando" erros NXDOMAIN, que ele deveria receber, portanto o navegador considera, até novo aviso, todas as consultas de uma única palavra como tentativas de busca.
Infelizmente, em redes que não capturam resultados de consultas DNS, essas três operações geralmente são direcionadas ao nível mais alto, até os próprios servidores raiz de nomes: o servidor local não sabe como transformar qwajuixk, por isso, redireciona esta solicitação para seu servidor de encaminhamento, que faz o mesmo até que, finalmente, a.root-servers.net ou um de seus 'irmãos' seja forçado a dizer 'Desculpe, mas este não é um domínio'.
Como existem aproximadamente 1,67*10^21 possíveis nomes de domínio falsos com comprimento de sete a quinze caracteres, na maioria das vezes cada um desses testes, realizados em uma rede 'honesta', chega ao servidor raiz. Isso representa até metade da carga total nos DNS raiz, se acreditarmos na estatística daquela parte dos clusters root-servers.net, que pertencem à empresa Verisign.
A história se repete
Este não é o primeiro caso em que um projeto criado com as melhores intenções ou quase atrapalhou um recurso público com tráfego desnecessário — isso imediatamente nos lembrou da longa e triste história da D-Link e do servidor NTP (Protocolo de Tempo de Rede) de Poul-Henning Kamp no meio dos anos 2000.
Em 2005, o desenvolvedor do FreeBSD, Poul-Henning, que também possuía o único servidor de NTP de nível Stratum 1 na Dinamarca, recebeu uma conta inesperada e alta pelo tráfego transmitido. Resumindo, a razão foi que os desenvolvedores da D-Link programaram os endereços dos servidores NTP de Stratum 1, incluindo o servidor de Kamp, no firmware de uma linha de switches, roteadores e pontos de acesso da empresa. Isso instantaneamente aumentou o tráfego do servidor de Kamp em nove vezes, fazendo com que a Danish Internet Exchange (ponto de troca de tráfego da Internet da Dinamarca) mudasse sua tarifa de 'Gratuita' para '9.000 dólares por ano'.
O problema não estava no número excessivo de roteadores D-Link, mas sim no fato de que eles 'quebraram a hierarquia'. Assim como o DNS, o NTP deve funcionar de forma hierárquica — servidores de nível Stratum 0 transmitem informações para servidores Stratum 1, que transmitem informações para servidores Stratum 2, e assim por diante, descendo a hierarquia. Um roteador doméstico comum, switch ou ponto de acesso, como aqueles em que a D-Link programou os endereços dos servidores NTP, deveria enviar solicitações ao servidor Stratum 2 ou Stratum 3.
O projeto Chromium, provavelmente com as melhores intenções, repetiu o problema do NTP no problema do DNS, sobrecarregando os servidores raiz da Internet com solicitações que nunca deveriam ter sido processadas.
Há esperança de uma solução rápida
No projeto Chromium, existe um , que requer a desativação do Intranet Redirect Detector por padrão para resolver este problema. É justo dar crédito ao projeto Chromium: o bug foi descoberto antes, como Matt Thomas da Verisign trouxe uma enorme atenção para ele com seu no blog da APNIC. O bug foi reportado em junho, mas permaneceu em esquecimento até o post de Thomas; após o post, começou a ser monitorado de perto.
Há esperança de que o problema seja resolvido em breve, e os servidores DNS raiz não precisem mais responder diariamente a cerca de 60 bilhões de solicitações falsas.
Em nome da publicidade
Servidores épicos seja ou Linux com poderosos processadores da família AMD EPYC e discos NVMe Intel extremamente rápidos. Apresse-se para fazer o pedido!
Fonte: habr.com
