

No relatório, Andrei Borodin falará sobre como eles consideraram a experiência de escalonamento do PgBouncer ao projetar o pooler de conexões , como foi implementado em produção. Além disso, discutiremos quais funções do pooler gostaríamos de ver nas novas versões: é importante para nós não apenas atender às nossas necessidades, mas também desenvolver a comunidade de usuários .
Vídeo:
Olá a todos! Meu nome é Andrei.
No Yandex, estou envolvido no desenvolvimento de bancos de dados open source. E hoje temos um tema sobre o pooler de conexões.
Se você souber como se chama pooler de conexões em russo, por favor, me avise. Estou ansioso para encontrar um bom termo técnico que deva se consolidar na literatura técnica.
O tema é bastante complicado, porque em muitos bancos de dados o pooler de conexões já está integrado e você nem precisa saber sobre ele. Algumas configurações, é claro, existem em todos os lugares, mas não funciona assim no Postgres. E, paralelamente (no HighLoad++ 2019), haverá uma apresentação de Nikolai Samokhvalov sobre a configuração de consultas no Postgres. E entendo que as pessoas que vieram aqui já configuraram consultas de maneira ideal, e são pessoas que enfrentam problemas sistêmicos mais raros, relacionados à rede e à utilização de recursos. E em alguns pontos isso pode ser bastante complicado, uma vez que os problemas não são óbvios.
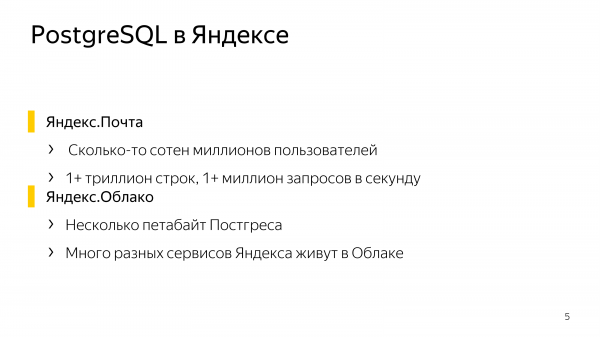
No Yandex, temos o Postgres. No Yandex.Cloud, vivem muitos serviços do Yandex. E temos vários petabytes de dados que geram não menos de um milhão de consultas por segundo no Postgres.
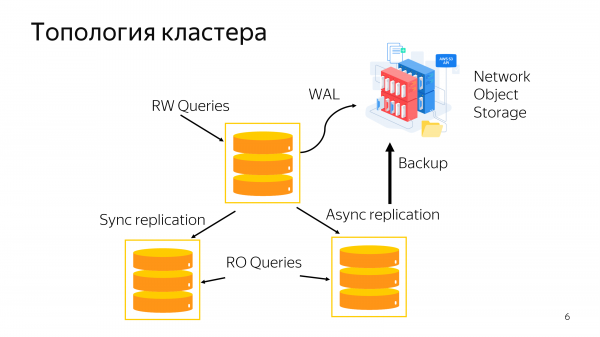
E fornecemos um cluster bastante padrão para todos os serviços - esta é a principal instância do nó, duas réplicas comuns (síncrona e assíncrona), backup e escalonamento de consultas de leitura na réplica.
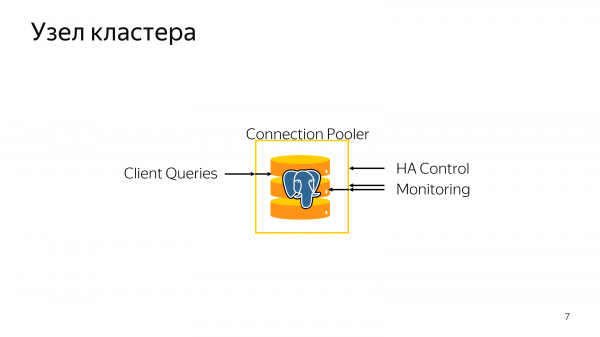
Cada nó do cluster é um Postgres, no qual, além do Postgres e dos sistemas de monitoramento, também está instalado o pooler de conexões. O pooler de conexões é utilizado para isolamento e para sua função principal.
Qual é a função principal do pooler de conexões?
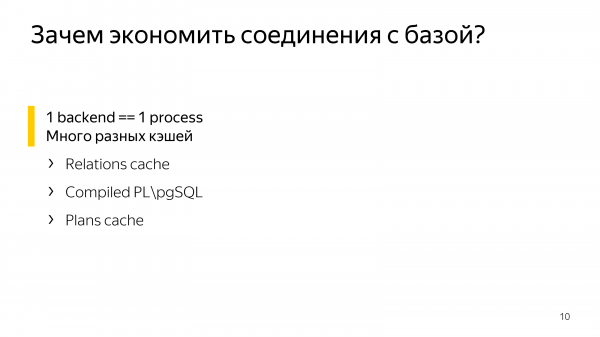
No Postgres, é adotado um modelo de processos ao trabalhar com o banco de dados. Isso significa que uma conexão é um processo, um backend do Postgres. E nesse backend existem muitos caches diferentes, que são bastante caros para serem feitos de maneira distinta para diferentes conexões.
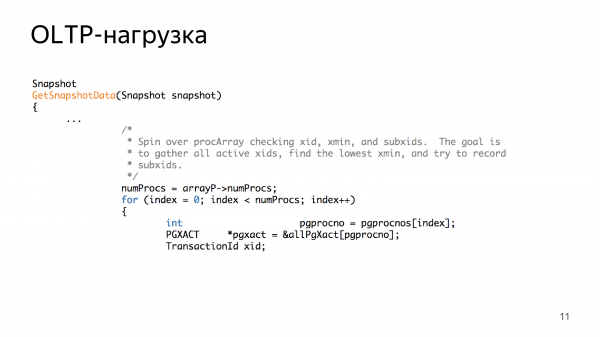
Além disso, no código Postgres existe um array chamado procArray. Ele contém os dados principais sobre conexões de rede. Quase todos os algoritmos de processamento do procArray têm complexidade linear, percorrendo todo o array de conexões de rede. Este é um ciclo bastante rápido, mas com um grande número de conexões de rede, tudo se torna um pouco mais caro. E quando tudo fica um pouco mais caro, no final, você pode pagar um preço muito alto por um grande número de conexões.
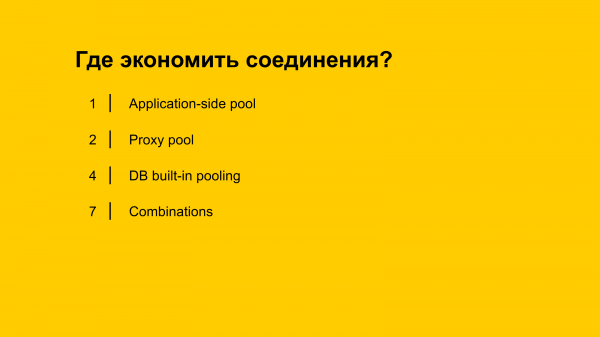
Existem 3 abordagens possíveis:
- Do lado do aplicativo.
- Do lado do banco de dados.
- E entre os dois, ou seja, diversas combinações possíveis.
Infelizmente, o pooler embutido está atualmente em desenvolvimento. Os amigos da empresa PostgreSQL Professional estão trabalhando principalmente nisso. Quando ele aparecer, é difícil prever. E, na verdade, temos duas soluções à escolha do arquiteto. É o pool de lado do aplicativo e o proxy pool.
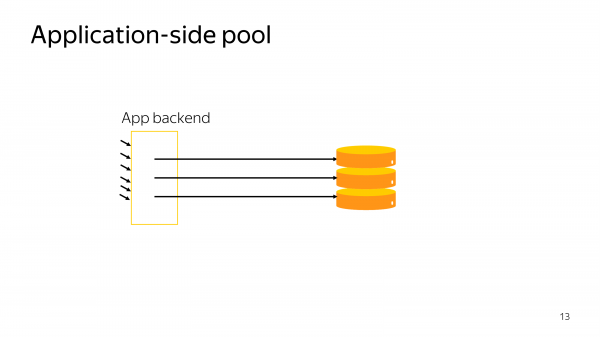
O pool de lado do aplicativo é a maneira mais simples. Quase todos os drivers de cliente oferecem uma maneira de representar milhões de suas conexões no código como algumas dezenas de conexões ao banco de dados.
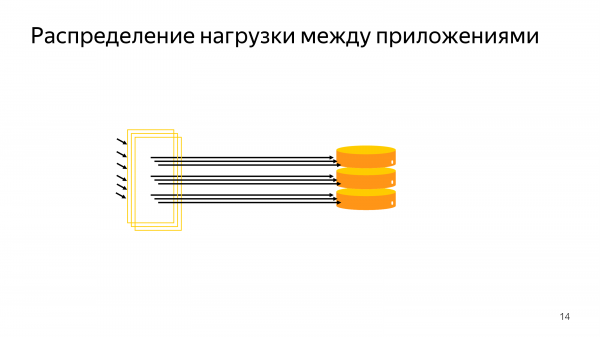
Surge o problema de que, em determinado momento, você quer escalar o backend, você deseja implantá-lo em várias máquinas virtuais.
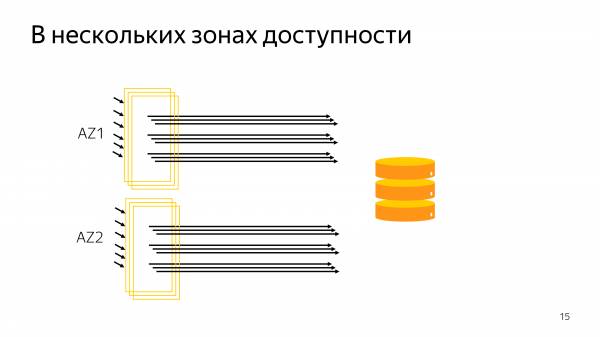
Depois você percebe que tem várias zonas de disponibilidade, vários data centers. E a abordagem com pooling do lado do cliente leva a números grandes. Grandes, cerca de 10.000 conexões. Esse é o limite que pode funcionar normalmente.
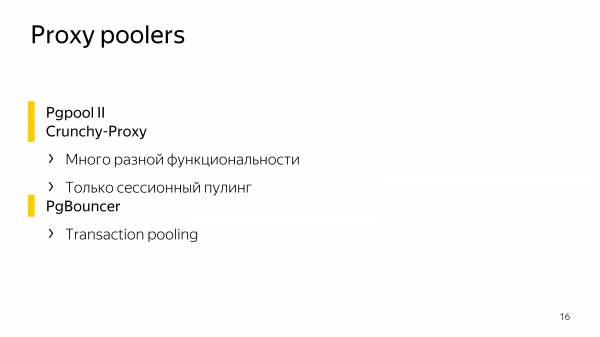
Falando sobre poolers proxy, existem dois poolers que fazem muitas coisas. Eles não são apenas poolers. São poolers + mais uma funcionalidade legal. Isso é e .
Mas, infelizmente, essa funcionalidade adicional não é necessária para todos. E isso leva ao fato de que os poolers suportam apenas o pooling de sessões, ou seja, um cliente de entrada, um cliente de saída no banco de dados.
Para nossas tarefas, isso não é muito adequado, portanto utilizamos o PgBouncer, que implementa o pooling de transações, ou seja, as conexões do servidor são mapeadas para as conexões do cliente apenas durante o tempo de transação.
E, sob nossa carga, isso é verdade. Mas existem alguns problemas..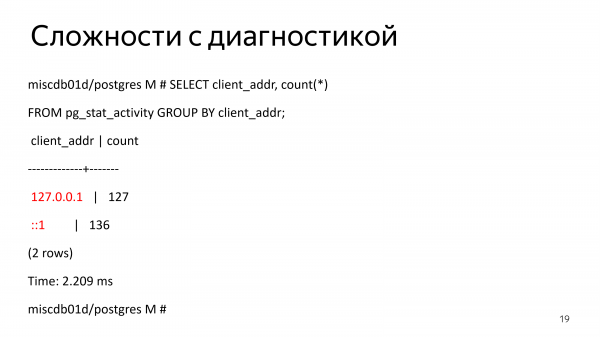
Os problemas começam quando você quer diagnosticar uma sessão, porque todas as conexões de entrada são locais. Todas vieram do loopback e traçar a sessão se torna complicado.
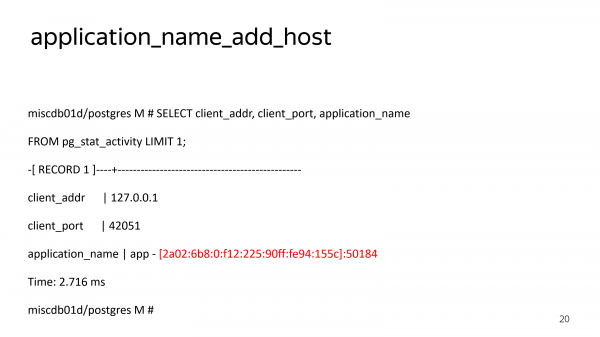
Claro, você pode usar application_name_add_host. Essa é uma maneira do lado do Bouncer adicionar um endereço IP ao application_name. Mas o application_name é estabelecido por uma conexão adicional.
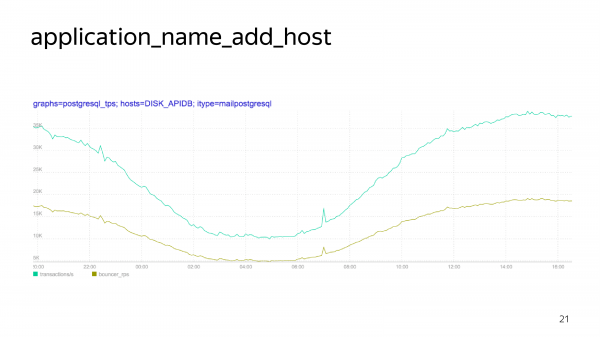
Neste gráfico, a linha amarela representa as solicitações reais, enquanto a linha azul representa as solicitações que entram na base. E essa diferença é exatamente a definição do application_name, que é necessário apenas para rastreamento, mas não é gratuito.
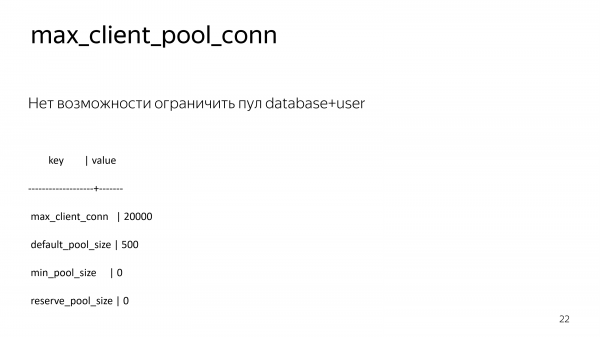
Além disso, no Bouncer não é possível limitar um pool, ou seja, o número de conexões ao banco de dados para um usuário específico em um banco de dados específico.
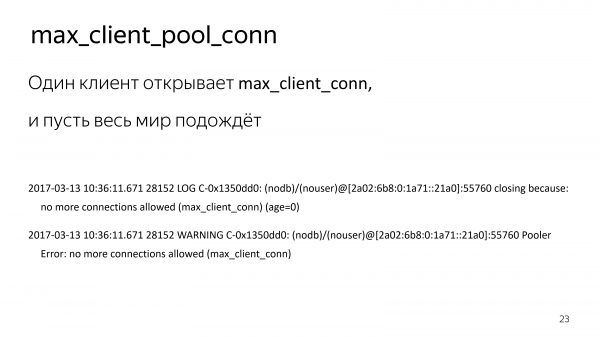
A que isso leva? Você tem um serviço sobrecarregado, escrito em C++, e ali perto um pequeno serviço em Node que não faz nada alarmante com o banco, mas seu driver enlouquece. Ele abre 20.000 conexões, e todo o resto terá que esperar. Seu código está normal.
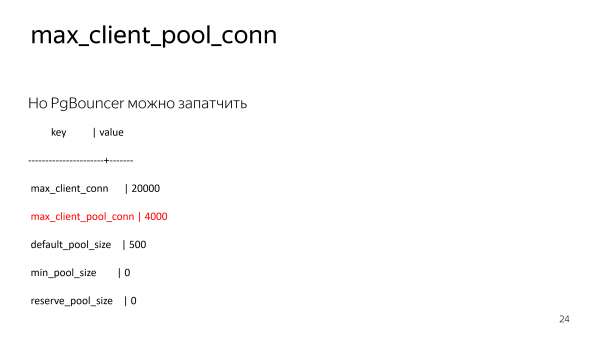
Claro, escrevemos um pequeno patch para o Bouncer que adicionou essa configuração, ou seja, limitando os clientes a um pool.
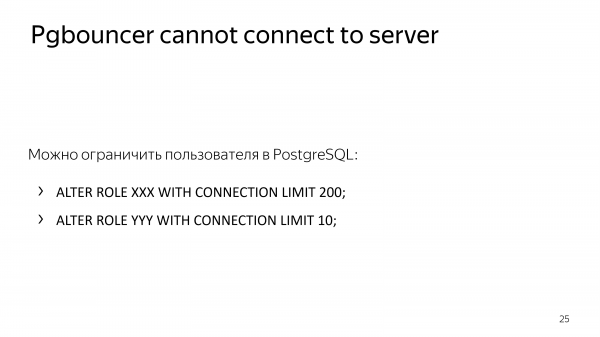
Isso poderia ser feito do lado do Postgres, ou seja, restringindo os papéis no banco de dados a um número específico de conexões.
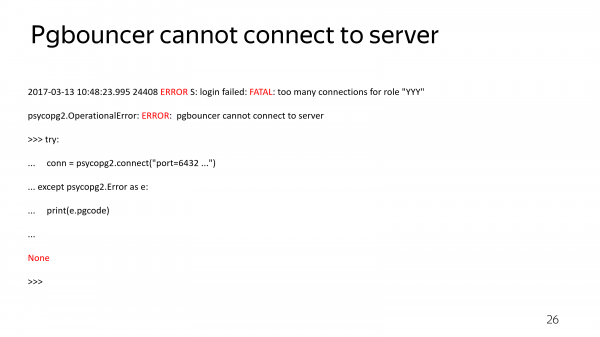
Mas então você perde a capacidade de entender por que não há conexões com o servidor. O PgBouncer não propaga o erro de conexão, ele sempre retorna a mesma informação. E você não pode entender: talvez sua senha tenha mudado, talvez o banco simplesmente tenha caído, ou talvez algo esteja errado. Mas não há diagnósticos. Se a sessão não pode ser estabelecida, você não saberá o motivo.
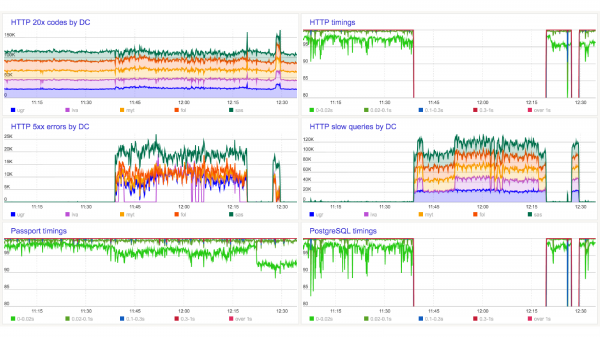
Em determinado momento, você olha os gráficos do aplicativo e vê que ele não está funcionando.
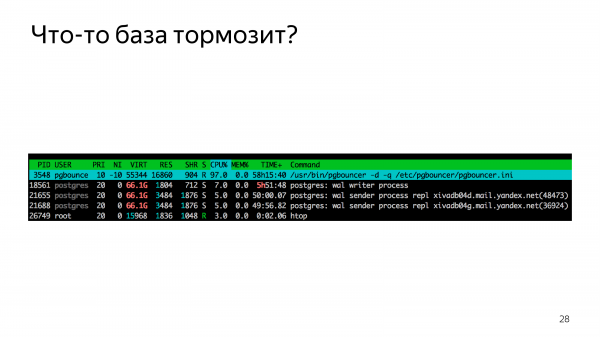
Você verifica o topo e vê que o Bouncer é de thread única. Este é um ponto de virada na vida do serviço. Você percebe que se preparou para escalar o banco de dados em um ano e meio, mas precisa escalar o pooler.
Chegamos à conclusão de que precisamos de mais PgBouncers.
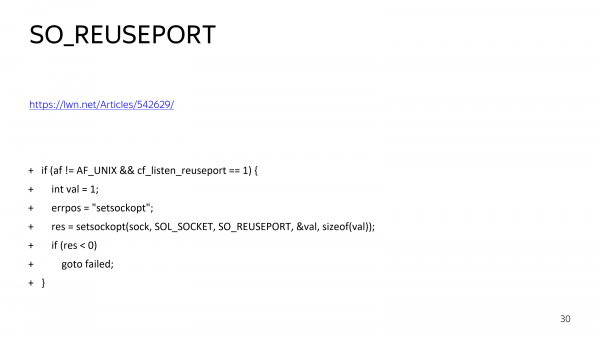
Um pouco de patching foi feito no Bouncer.
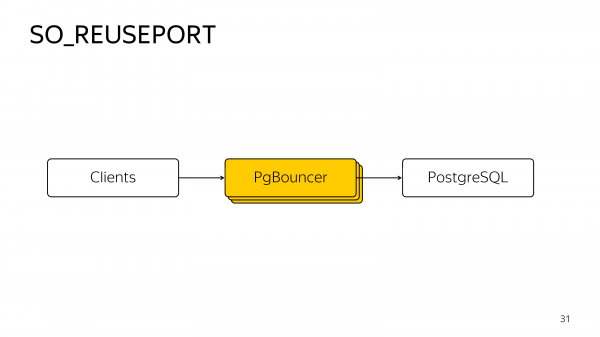
E configuramos para que vários Bouncers pudessem ser levantados reutilizando a porta TCP. E o sistema operacional automaticamente distribui as conexões TCP de entrada entre eles em round-robin.
Isso é transparente para os clientes, ou seja, tudo parece como se você tivesse um único Bouncer, mas você tem fragmentação de conexões idle entre os Bouncers em execução.
E em determinado momento, você pode perceber que estes 3 Bouncers estão consumindo 100% de cada um de seus núcleos. Você precisa de muitos Bouncers. Por quê?
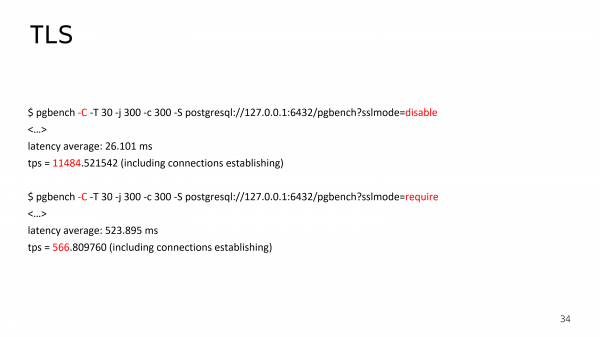
Porque você tem TLS. Você tem uma conexão criptografada. E se você comparar o Postgres com e sem TLS, descobrirá que o número de conexões estabelecidas cai quase em dois ordens de magnitude com a inclusão da criptografia, porque o handshake TLS consome recursos da CPU.
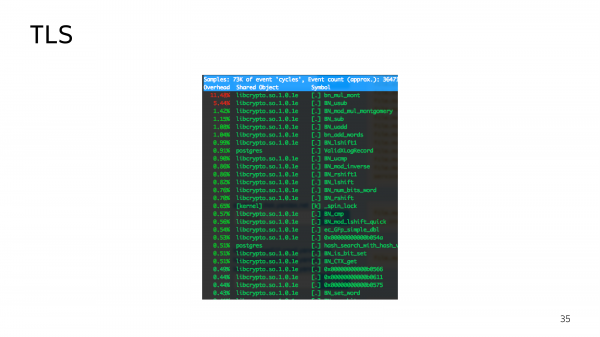
E no pico, você pode ver várias funções criptográficas sendo executadas durante o fluxo de conexões de entrada. Como nosso primary pode alternar entre zonas de disponibilidade, esse fluxo de conexões de entrada é uma situação bastante comum. Ou seja, por algum motivo, o antigo primary estava indisponível, e toda a carga foi enviada para outro datacenter. Eles chegarão todos ao mesmo tempo para se cumprimentar com TLS.
E um grande número de handshakes TLS pode não apenas cumprimentar o Bouncer, mas pressioná-lo. Devido ao timeout, o fluxo de conexões de entrada pode se tornar sem fim. Se você tiver um retry no banco de dados sem exponential backoff, as conexões voltarão repetidamente de forma não coerente.
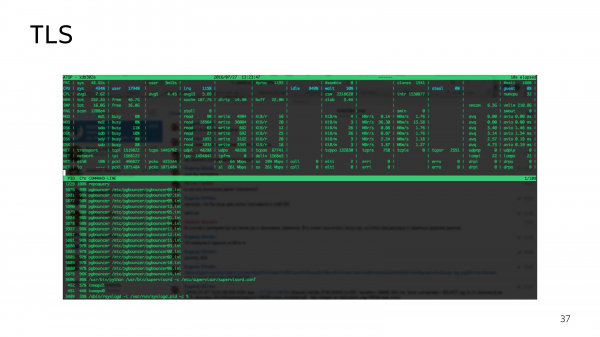
Aqui está um exemplo de 16 PgBouncers que carregam 16 núcleos a 100%.
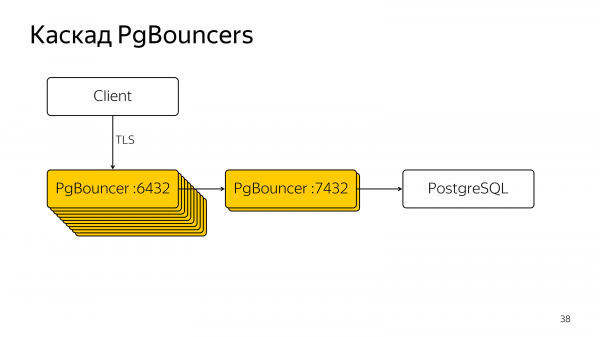
Chegamos ao PgBouncer em cascata. Esta é a melhor configuração que podemos alcançar em nossa carga com o Bouncer. Os Bouncers externos servem para o handshake TCP, enquanto os Bouncers internos servem para o verdadeiro pooling, para não fragmentar muito as conexões externas.
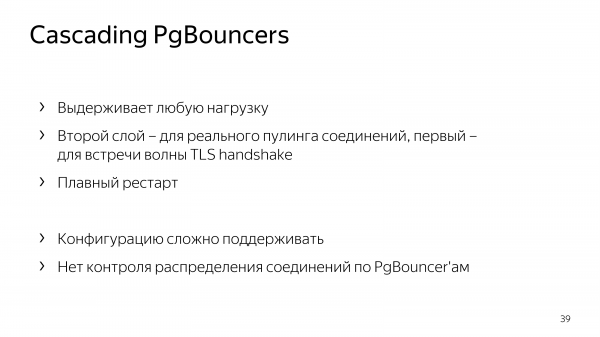
Com essa configuração, é possível realizar um reinício suave. Você pode reiniciar todos esses 18 Bouncers um por um. Mas manter essa configuração é bastante desafiador. Administradores de sistemas, DevOps e pessoas que realmente são responsáveis por esse servidor não ficarão muito felizes com esse esquema.
À primeira vista, poderia parecer que poderíamos promover todas as nossas melhorias como open source, mas o Bouncer não é muito bem suportado. Por exemplo, a capacidade de rodar vários PgBouncers na mesma porta foi commitada há um mês. E o pull request com essa funcionalidade foi feito há alguns anos.
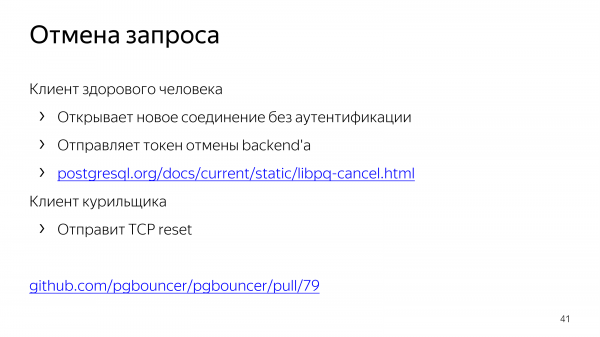
Ou outro exemplo. No Postgres, você pode cancelar uma consulta em execução enviando um segredo por outra conexão sem autenticação adicional. Mas alguns clientes enviam simplesmente um TCP-reset, ou seja, quebram a conexão de rede. O que o Bouncer fará nesse caso? Ele não fará nada. Ele continuará a executar a consulta. Se você tiver um grande número de conexões que, com pequenas consultas, sobrecarregaram o banco de dados, simplesmente desconectar o Bouncer não será suficiente; você também precisará finalizar as consultas que estão rodando no banco de dados.
Isso foi corrigido e esse problema ainda não foi integrado ao upstream do Bouncer.
E assim chegamos à necessidade de nosso próprio pool de conexões, que evoluirá, será corrigido, onde poderemos resolver problemas rapidamente e que, claro, deve ser multiprocessado.
Fizemos da multiprocessamento nossa principal tarefa. Precisamos lidar bem com a onda de conexões TLS que chegam.
Para isso, tivemos que desenvolver uma biblioteca separada chamada Machinarium, que é destinada a descrever os estados da máquina de uma conexão de rede como código sequencial. Se você olhar o código-fonte do libpq, verá chamadas bastante complexas, que podem retornar um resultado e dizer: "Me chame mais tarde. Por enquanto, estou ocupado com IO, mas quando o IO terminar, terei carga para o processador". E isso é um esquema multilayer. Interações de rede geralmente são descritas como máquinas de estados. Com muitas regras do tipo "Se eu recebi um cabeçalho de pacote de tamanho N antes, agora espero N bytes", "Se enviei um pacote SYNC, agora estou esperando um pacote com os metadados do resultado". O código resultante é bastante difícil de entender, como se um labirinto fosse transformado em uma linha de desenvolvimento. Fizemos de modo que, em vez de uma máquina de estados, o programador descreve o caminho principal de interação na forma de código imperativo comum. Apenas nesse código imperativo, é preciso inserir locais onde a sequência de execução deve ser interrompida, aguardando dados da rede, passando o contexto da execução para outra corrotina (green thread). Essa abordagem é semelhante à de gravar o caminho mais esperado em um labirinto sequencialmente e, em seguida, adicionar ramificações a ele.
Assim, temos um fluxo que faz o TCP accept e, através do round-robin, distribui várias conexões TPC para os workers.
Além disso, cada conexão do cliente sempre opera em um único processador, o que a torna otimizada em relação ao cache.
Além do mais, aprimoramos a coleta de pequenos pacotes em um grande pacote para aliviar a carga do TCP-stack do sistema.
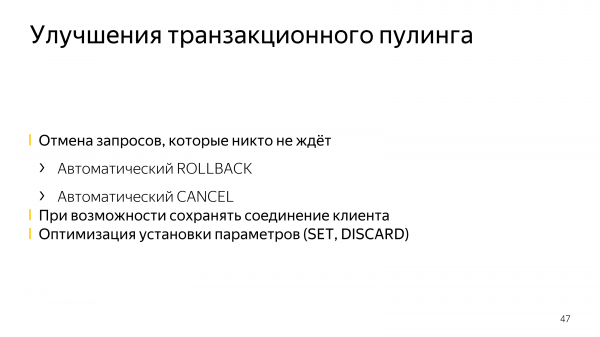
Também melhoramos o pooling transacional, de modo que o Odyssey, com a configuração adequada, pode enviar CANCEL e ROLLBACK em caso de interrupção da conexão de rede, ou seja, se ninguém estiver aguardando a solicitação, o Odyssey informa ao banco para não tentar executar aquele pedido que pode consumir recursos valiosos.
Sempre que possível, mantemos conexões com o mesmo cliente. Isso permite que não haja necessidade de reinstalação do application_name_add_host. Se viável, não teremos reconfigurações adicionais que são necessárias para diagnóstico.
Nós trabalhamos em prol do Yandex.Cloud. E se você utiliza o PostgreSQL gerenciado e possui um connection pooler instalado, você pode criar replicação lógica externa, ou seja, se desejar, poderá se desvincular de nós através da replicação lógica. O Bouncer não enviará o fluxo de replicação lógica para fora.
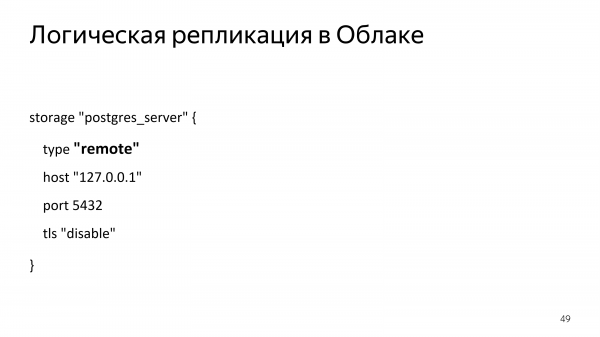
Este é um exemplo de configuração de replicação lógica.
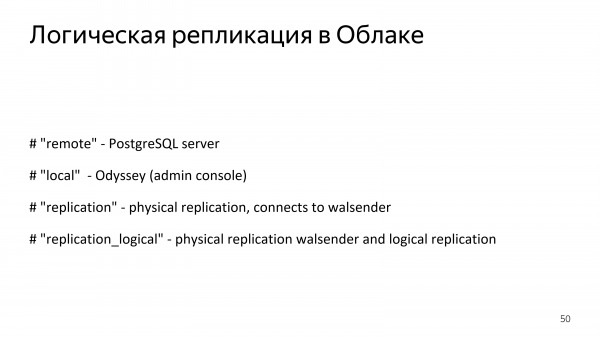
Além disso, temos suporte à replicação física externa. No Cloud, isso, claro, é impossível, pois o cluster estaria fornecendo informações em excesso sobre si mesmo. Mas nas suas instalações, se você precisar de replicação física através do connection pooler no Odyssey, isso é viável.
No Odyssey, o monitoramento é totalmente compatível com o PgBouncer. Temos um console semelhante que executa quase todos os mesmos comandos. Se faltar algo, envie um pull request ou, ao menos, crie uma issue no GitHub, e iremos adicionar os comandos necessários. Mas a funcionalidade principal do console PgBouncer já está disponível.
E, claro, temos o encaminhamento de erros. Retornaremos o erro que o banco informou. Você receberá informações sobre o motivo pelo qual não está acessando o banco, e não apenas que você não tem acesso.
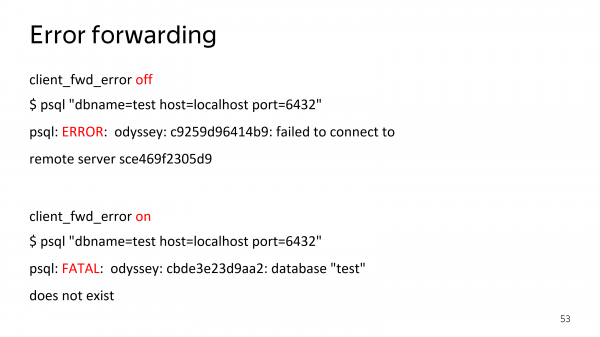
Essa funcionalidade pode ser desativada caso você precise de 100% de compatibilidade com o PgBouncer. Podemos nos comportar exatamente como o Bouncer, apenas por segurança.
Desenvolvimento
Algumas palavras sobre o código-fonte do Odyssey.
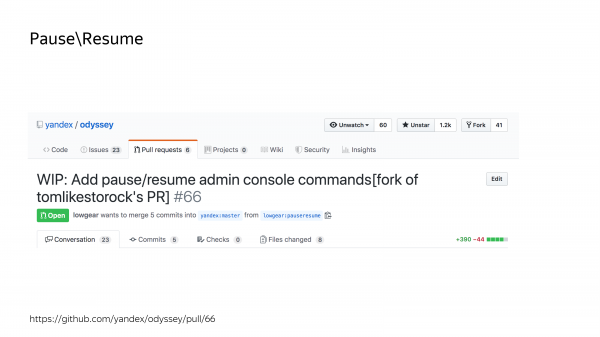
Por exemplo, existem os comandos "Pause / Resume". Eles são geralmente usados para atualizar o banco de dados. Se você precisar atualizar o Postgres, pode pausá-lo no connection pooler, fazer o pg_upgrade e, em seguida, retomar. E do lado do cliente, parecerá que o banco só estava lento. Essa funcionalidade nos foi trazida por pessoas da comunidade. Ainda não está mesclada, mas em breve tudo estará. (Já mesclada)
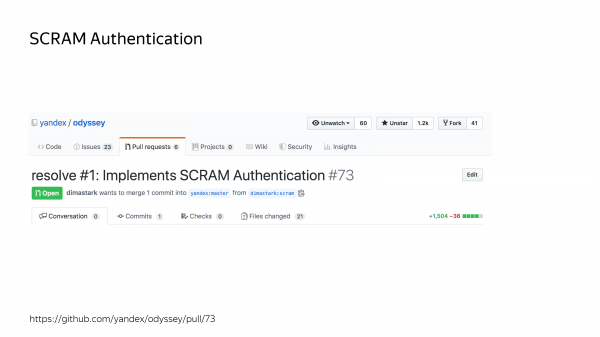
— já mesclada
Além disso, uma das novas funcionalidades no PgBouncer é o suporte à Autenticação SCRAM, que também nos foi trazida por uma pessoa que não trabalha na Yandex.Cloud. Ambas são funcionalidades complexas e importantes.
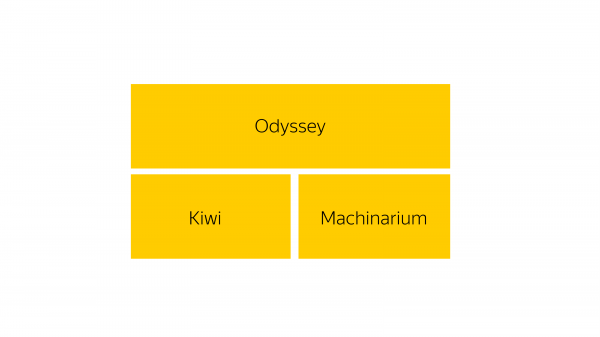
Portanto, gostaria de falar sobre como o Odyssey é feito, talvez você também esteja querendo escrever um pouco de código.
Você tem a base original do Odyssey, que se baseia em duas bibliotecas principais. A biblioteca Kiwi é a implementação do protocolo de mensagens do Postgres. Ou seja, o proto nativo 3 do Postgres são mensagens padrão que front-ends e back-ends podem trocar. Elas estão implementadas na biblioteca Kiwi.
A biblioteca Machinarium é uma biblioteca de implementação de threads. Um pequeno trecho deste Machinarium foi escrito em assembly. Mas não se preocupe, são apenas 15 linhas.
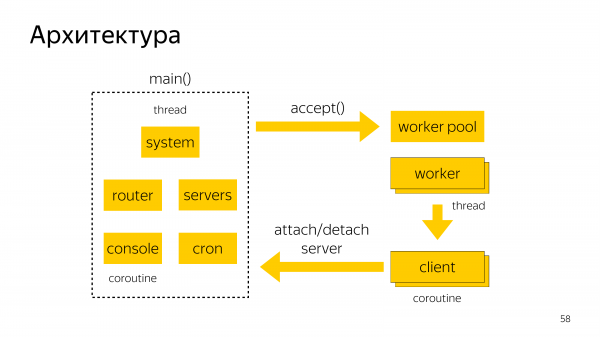
Arquitetura do Odyssey. Existe uma máquina principal, onde coroutines estão em execução. Nesta máquina, ocorre a aceitação de conexões TCP de entrada e a distribuição entre os workers.
Dentro de um worker, pode haver um manipulador de vários clientes. Além disso, no fluxo principal, estão a console e o processamento de tarefas crone para remover conexões que não são mais necessárias no pool.
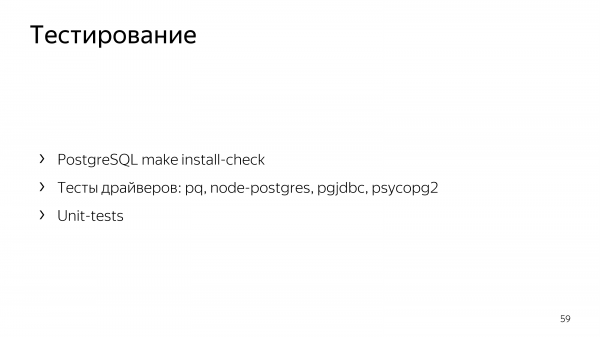
Para testar o Odyssey, usamos o conjunto padrão de testes do Postgres. Simplesmente executamos o install-check através do Bouncer e através do Odyssey, recebendo um div nulo. Existem vários testes relacionados à formatação de datas que não passam de forma idêntica no Bouncer e no Odyssey.
Além disso, há vários drivers que têm seus próprios testes. E utilizamos esses testes para testar o Odyssey.
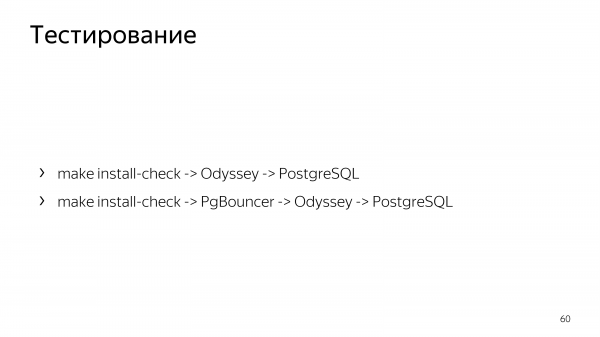
Além disso, devido à nossa configuração em cascata, temos que testar diferentes combinações: Postgres + Odyssey, PgBouncer + Odyssey, Odyssey + Odyssey, para termos certeza de que, se o Odyssey estiver em alguma parte da cascata, ele ainda funcionará como esperamos.
Truques
Estamos usando o Odyssey em produção. E não seria justo dizer que tudo funciona perfeitamente. Não, ou seja, sim, mas nem sempre. Por exemplo, em produção tudo simplesmente funcionou, depois nossos amigos da PostgreSQL Professional disseram que tínhamos um vazamento de memória. Eles realmente estavam certos, nós o corrigimos. Mas isso foi algo inesperado.
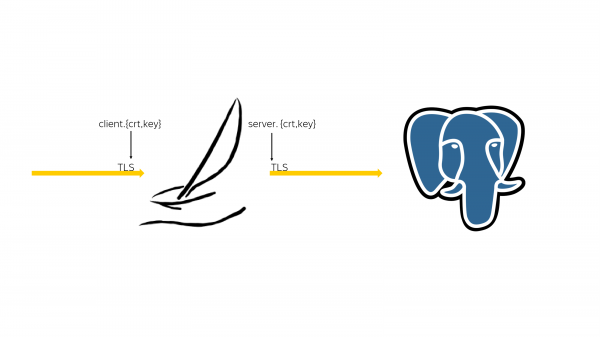
Depois descobrimos que no connection pooler existem conexões TLS de entrada e conexões TLS de saída. E nas conexões são necessários certificados de cliente e certificados de servidor.
Os certificados de servidor do Bouncer e do Odyssey leem seus pcache, mas os certificados de cliente não precisam ser lidos do pcache, porque nosso Odyssey escalável, no final, esbarra na performance de leitura desse certificado. Isso foi uma surpresa para nós, porque isso não aconteceu imediatamente. Inicialmente, ele escalou linearmente, mas após 20.000 conexões simultâneas de entrada, esse problema se manifestou.
O Método de Autenticação Pluggable é a possibilidade de se autenticar com os recursos integrados do Linux. No PgBouncer, isso é implementado de forma que há uma thread separada esperando a resposta do PAM e há a thread principal do PgBouncer, que gerencia a conexão atual e pode solicitar que elas aguardem na thread do PAM.
Nós não implementamos isso por uma razão simples. Temos muitas threads. Para que precisamos disso?
No final, isso pode criar problemas, pois, se você tem autenticação PAM e não PAM, uma grande onda de autenticações PAM pode atrasar significativamente a autenticação não PAM. Esta é uma das coisas que não corrigimos. Mas se você quiser corrigir, pode trabalhar nisso.
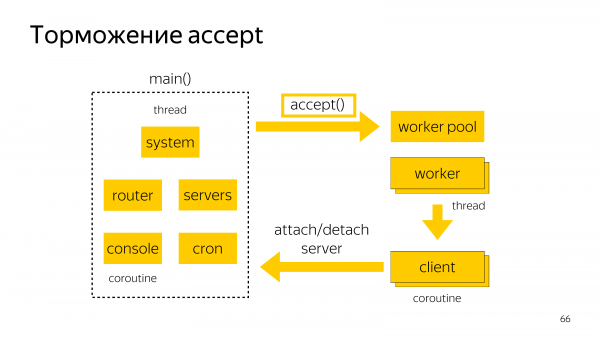
Outro desafio foi que temos uma thread que aceita todas as conexões de entrada. E então as passa para o pool de trabalhadores, onde ocorrerá o handshake TLS.
Portanto, se você tem uma onda coerente de 20.000 conexões de rede, todas elas serão aceitas. E do lado do cliente, o libpq começará a contar os timeouts. Por padrão, parece que é configurado para 3 segundos.
Se todas elas não podem acessar o banco de dados ao mesmo tempo, então elas não conseguem entrar no banco de dados, porque tudo isso pode ser coberto por uma tentativa de reconexão não exponencial.
Chegamos à conclusão de que copiamos aqui o esquema do PgBouncer com o que temos de throttling na quantidade de conexões TCP que aceitamos.
Se virmos que aceitamos conexões, mas elas não conseguem completar o handshake a tempo, as colocamos em uma fila para que não consumam recursos da CPU central. Isso leva ao fato de que o handshake simultâneo pode não ser realizado para todas as conexões recebidas. Mas pelo menos alguém conseguirá acessar o banco, mesmo que a carga seja bastante alta.
Roteiro
O que gostaríamos de ver no futuro no Odyssey? O que estamos prontos para desenvolver e o que esperamos da comunidade?
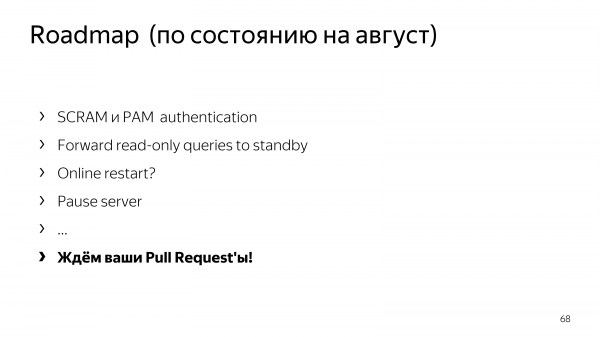
Em agosto de 2019.
Assim era o roteiro do Odyssey em agosto:
- Queríamos autenticação SCRAM e PAM.
- Queríamos redirecionar consultas de leitura para o standby.
- Gostaríamos de reinício online.
- E a possibilidade de fazer uma pausa no servidor.
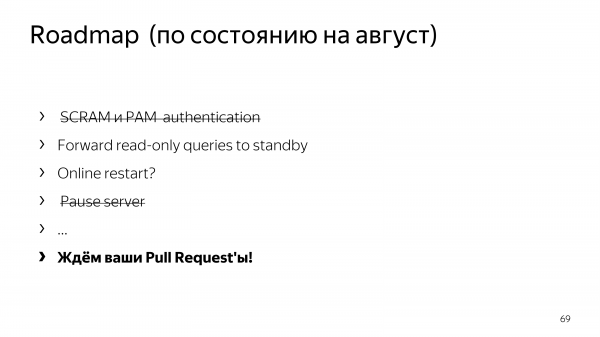
Metade deste roteiro foi cumprida, e não por nós. E isso é bom. Portanto, vamos discutir o que resta e adicionar mais.
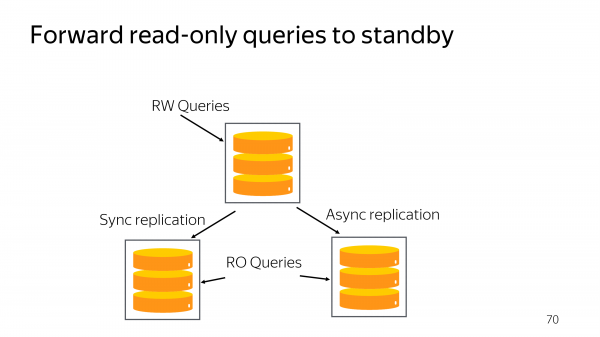
? У нас есть реплики, которые без выполнения запросов будут просто греть воздух. Они нам необходимы для обеспечения failover и switchover. В случае проблем в одном из дата-центре хотелось бы их занять какой-то полезной работой. Потому что те же самые центральные процессоры, ту же самую память мы не можем сконфигурировать по-другому, потому что иначе не будет работать репликация.
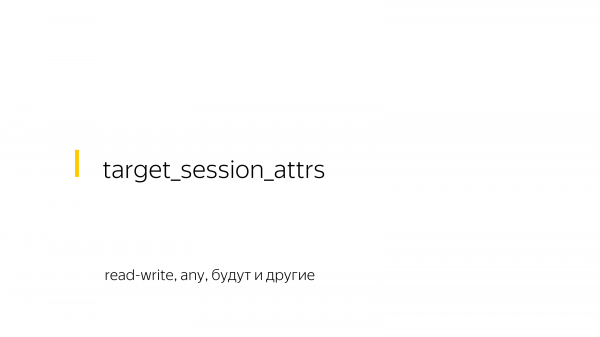
Basicamente, no Postgres, a partir da versão 10, existe a possibilidade de especificar também session_attrs na conexão. Você pode listar todos os hosts de banco de dados na conexão e dizer por que está acessando o banco de dados: para gravar ou apenas para ler. E o driver escolherá automaticamente o primeiro host da lista que mais gosta e que atende aos requisitos de session_attrs.
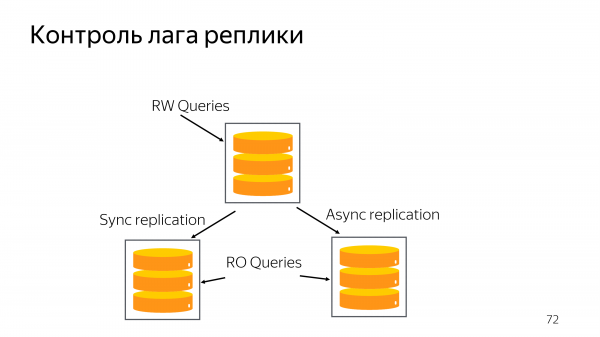
Mas o problema dessa abordagem é que ela não controla o atraso de replicação. Você pode ter uma réplica que esteja atrasada por um tempo inaceitável para o seu serviço. Para que possamos executar consultas de leitura na réplica de forma funcional, essencialmente precisamos garantir que o Odyssey não funcione quando a leitura não é possível.
O Odyssey deve periodicamente consultar o banco e verificar a distância de replicação em relação ao primário. E se ela atingir um valor limite, novas consultas ao banco não devem ser permitidas, informando ao cliente que é necessário reiniciar as conexões e, possivelmente, escolher outro host para executar as consultas. Isso permitirá que o banco se recupere mais rapidamente do atraso de replicação e volte a responder às consultas.
É difícil estipular um prazo para implementação, pois é open source. Mas espero que não leve 2,5 anos como para os colegas do PgBouncer. Essa é uma função que gostaria de ver no Odyssey.
Agora você pode criar uma declaração preparada de duas maneiras. Primeiro, você pode executar o comando SQL, que é "prepared". Para entender esse comando SQL, precisamos aprender a compreender o SQL do lado do Bouncer. Seria um exagero, pois precisaríamos de um parser completo. Não podemos parsear cada comando SQL.
Mas existe a declaração preparada no nível do protocolo de mensagens no proto3. E é nesse momento que a informação sobre a criação da declaração preparada chega de forma estruturada. E poderíamos manter a compreensão de que em alguma conexão de servidor o cliente pediu para criar declarações preparadas. E mesmo se a transação foi encerrada, ainda precisamos manter a consistência entre servidor e cliente.
Mas aqui surge um desvio no diálogo, porque alguém fala sobre a necessidade de entender qual declaração preparada foi criada pelo cliente e dividir a conexão do servidor entre todos os clientes que criaram essa conexão de servidor, isto é, que criaram tal declaração preparada.
Andres Freund disse que se um cliente vier a você que já criou tal declaração preparada em outra conexão de servidor, você deve criá-la por ele. Mas, parece meio errado fazer consultas no banco em vez do cliente, mas do ponto de vista do desenvolvedor que escreve o protocolo de interação com o banco, seria conveniente se ele simplesmente tivesse uma conexão de rede onde há essa consulta preparada.
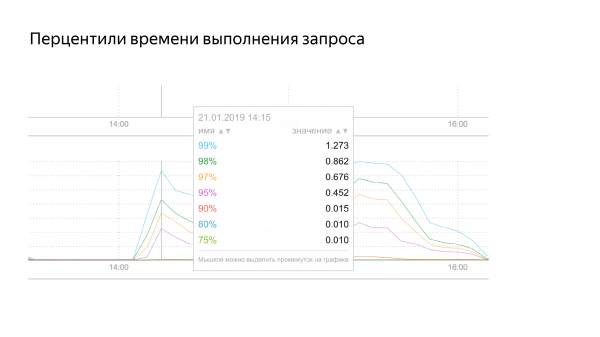
E mais uma funcionalidade que precisamos implementar. Atualmente temos monitoramento compatível com PgBouncer. Podemos retornar o tempo médio de execução da consulta. Mas o tempo médio é uma média, não reflete a realidade: alguns estão frios, alguns quentes - em média todos estão saudáveis. Isso não é verdade.
Precisamos implementar o suporte a percentis, que indicariam que existem consultas lentas que consomem recursos e tornariam o monitoramento mais aceitável.
O mais importante - gostaríamos da versão 1.0 (a versão 1.1 já foi lançada). O fato é que atualmente o Odyssey está na versão 1.0rc, ou seja, release candidate. E todos os problemas que mencionei foram corrigidos nesta versão, exceto o vazamento de memória.
O que a versão 1.0 significará para nós? Estamos lançando o Odyssey em nossas bases. Ele já está funcionando em nossas bases, mas quando alcançar 1.000.000 de consultas por segundo, podemos dizer que esta é a versão de lançamento e é a versão que podemos chamar de 1.0.
Na comunidade, algumas pessoas pediram que na versão 1.0 houvesse também pausa e SCRAM. Mas isso significaria que precisaríamos lançar a próxima versão em produção, porque nem SCRAM nem pausa estão integrados ainda. Mas, provavelmente, essa questão será resolvida rapidamente.
Estou aguardando suas solicitações de pull request. E também gostaria de saber quais problemas vocês têm com o Bouncer. Vamos discuti-los. Talvez possamos implementar algumas funções que são necessárias para vocês.
Com isso, minha parte termina, gostaria de ouvir vocês. Obrigado!
Perguntas
Se eu definir meu application_name, ele será corretamente transmitido, incluindo no transaction pooling no Odyssey?
No Odyssey ou no Bouncer?
No Odyssey. É feito no Bouncer.
Faremos o set.
E se minha conexão real estiver pulando entre outras conexões, ela será transmitida?
Faremos o set de todos os parâmetros que estão na lista. Não posso dizer se o application_name está nesta lista. Parece que o vi lá. Definiremos todos os mesmos parâmetros. Com uma solicitação, o set fará tudo o que foi definido pelo cliente na inicialização.
Obrigado, Andrey, pela apresentação! Boa apresentação! Fico feliz que o Odyssey esteja se desenvolvendo cada vez mais rápido a cada minuto. Desejo que continue assim. Já entramos em contato com vocês pedindo para ter a conexão multi data-source, para que o Odyssey possa se conectar simultaneamente a diferentes bancos de dados, ou seja, master-slave, e depois se reconectar automaticamente a um novo master após failover.
Sim, parece que me lembro dessa discussão. Atualmente, existem vários storages. Mas não há alternância entre eles. Precisamos monitorar o servidor do nosso lado, para saber se ele ainda está ativo e entender que ocorreu um failover, quem chamará o pg_recovery. Tenho um método padrão para entender que não estamos no master. E devemos entender de alguma forma por meio dos erros ou como? Ou seja, a ideia é interessante, está em discussão. Escrevam mais comentários. Se vocês tiverem mãos que conhecem C, isso seria ótimo.
A questão do dimensionamento por réplicas também nos interessa, porque queremos tornar a adoção de clusters replicados o mais simples possível para os desenvolvedores de aplicativos. Mas gostaria de mais comentários, ou seja, como exatamente fazer isso, como fazer bem.
A pergunta também é sobre réplicas. Então, vocês têm um mestre e várias réplicas. Fica claro que as conexões para a réplica ocorrem com menos frequência do que para o mestre, pois podem haver diferenças. Você mencionou que as diferenças nos dados podem ser tais que não atendem ao seu negócio e você não se conectará a elas até que estejam completamente replicadas. Além disso, se você não se conectar a elas por muito tempo e depois começar a se conectar, os dados necessários não estarão imediatamente disponíveis. Ou seja, se constantemente nos conectamos ao mestre, o cache estará aquecido, enquanto na réplica o cache pode estar um pouco atrasado.
Sim, isso é verdade. No pcache não haverá blocos de dados que você deseja, no cache real não haverá informações sobre as tabelas que você deseja, nos planos não haverá consultas analisadas, na verdade, nada haverá.
E quando você tem um cluster e adiciona uma nova réplica, enquanto ela está sendo iniciada, as coisas estão ruins, ou seja, ela está aumentando seu cache.
Entendi a ideia. A abordagem correta seria executar uma pequena porcentagem de consultas primeiro na réplica, para aquecer o cache. Grosso modo, temos a condição de que não devemos ficar mais do que 10 segundos atrás do mestre. E essa condição deve ser ativada não de uma só vez, mas gradualmente para alguns clientes.
Sim, aumentar o peso.
É uma boa ideia. Mas primeiro precisamos implementar esse desligamento. Primeiro, devemos desligar, e depois pensaremos em como reativar. É um ótimo recurso para ativar suavemente.
No nginx existe essa opção iniciar lentamente no cluster para o servidor. E ele gradualmente aumenta a carga.
Sim, ótima ideia, vamos tentar quando chegarmos lá.
Fonte: habr.com
