

Aloha, pessoal! Meu nome é Oleg Anastasev, trabalho no Odnoklassniki na equipe da Plataforma. Além de mim, há muitos equipamentos no Odnoklassniki. Temos quatro centros de dados, com cerca de 500 racks e mais de 8 mil servidores. Em determinado momento, percebemos que a implementação de um novo sistema de gerenciamento nos permitiria usar a tecnologia de forma mais eficiente, facilitar a gestão de acessos, automatizar a (re)distribuição de recursos computacionais, acelerar o lançamento de novos serviços e aumentar a velocidade de resposta a grandes falhas.
O que resultou disso?
Além de mim e de muitos equipamentos, há também pessoas que trabalham com esse hardware: engenheiros que estão diretamente nos data centers; especialistas em redes que configuram a infraestrutura de rede; administradores, ou SREs, que garantem a resiliência da infraestrutura; e equipes de desenvolvedores, cada uma responsável por uma parte das funcionalidades do portal. O software que eles desenvolvem funciona assim:
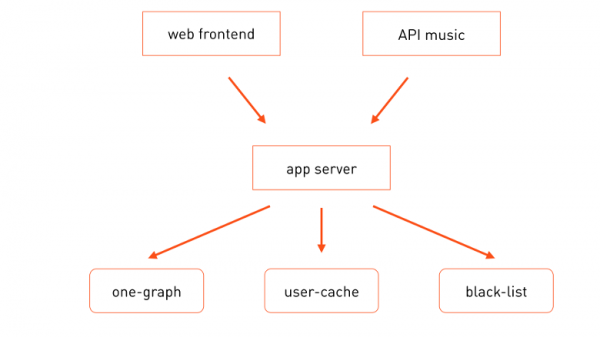
As solicitações dos usuários chegam tanto nas interfaces do portal principal , quanto em outras, por exemplo, nas interfaces da API de música. Para processar a lógica de negócios, elas chamam o servidor de aplicações, que ao processar a solicitação chama os microserviços especializados necessários — one-graph (rede de conexões sociais), user-cache (cache de perfis de usuários) e assim por diante.
Cada um desses serviços está implantado em várias máquinas, e cada um deles tem desenvolvedores responsáveis pelo funcionamento dos módulos, sua operação e desenvolvimento tecnológico. Todos esses serviços são executados em servidores físicos, e até recentemente, nós executávamos exatamente uma tarefa em cada servidor, ou seja, ele era especializado para uma tarefa específica.
Por que assim? Essa abordagem tinha algumas vantagens:
- Facilita a gestão em massa. Suponha que a tarefa exija certas bibliotecas e configurações. Então o servidor é atribuído a exatamente um determinado grupo, uma política cfengine é descrita para este grupo (ou já está descrita), e essa configuração é centralizada e automaticamente distribuída para todos os servidores desse grupo.
- Facilita o diagnóstico. Suponha que você esteja observando uma carga alta na CPU e entenda que essa carga só pode ter sido gerada pela tarefa que está sendo executada nesse processador específico. A busca pelo culpado termina muito rapidamente.
- Facilita monitoramento. Se algo está errado com o servidor, o monitor avisa e você sabe exatamente quem é o responsável.
Um serviço composto por várias réplicas é alocado em vários servidores — um para cada réplica. Assim, o recurso computacional para o serviço é alocado de forma muito simples: quantos servidores o serviço tem, essa é a quantidade máxima de recursos que pode consumir. O 'simples' aqui não significa que é fácil de usar, mas que a distribuição de recursos ocorre manualmente.
Essa abordagem também nos permitiu criar configurações de hardware especializadas para tarefas que são executadas nesse servidor. Se a tarefa armazena grandes volumes de dados, usamos um servidor 4U com chassi para 38 discos. Se a tarefa é puramente computacional, podemos adquirir um servidor 1U mais barato. Isso é eficiente em termos de recursos computacionais. Além disso, essa abordagem nos permite usar quatro vezes menos máquinas com uma carga comparável à de uma rede social que nos é favorável.
Essa eficiência na utilização dos recursos computacionais deve garantir também uma eficiência econômica, partindo do princípio de que o mais caro são os servidores. Durante muito tempo, o que mais custava era precisamente o hardware, e investimos muito esforço na redução de custos desse hardware, desenvolvendo algoritmos de tolerância a falhas para diminuir as exigências de confiabilidade do equipamento. E hoje chegamos a um ponto em que o preço do servidor deixou de ser o fator determinante. A menos que consideremos exóticos muito novos, a configuração específica dos servidores em um rack não tem importância. Agora, temos outro problema — o custo do espaço ocupado pelo servidor no data center, ou seja, o espaço no rack.
Percebendo isso, decidimos calcular o quão eficientemente estamos utilizando os racks.
Pegamos o preço do servidor mais potente que é economicamente viável, calculamos quantos desses servidores caberiam nos racks, quantas tarefas poderíamos executar com base no antigo modelo "um servidor = uma tarefa" e quão bem essas tarefas poderiam utilizar o equipamento. Calculamos e ficamos emocionados. A eficiência da utilização dos racks ficou em cerca de 11%. A conclusão é clara: precisamos aumentar a eficiência do uso dos data centers. Parece que a solução é óbvia: devemos executar várias tarefas em um único servidor. Mas aqui começam as dificuldades.
A configuração em massa se torna drasticamente mais complexa — agora não é possível atribuir um único grupo a um servidor. Afinal, várias tarefas de diferentes equipes podem ser executadas no mesmo servidor. Além disso, a configuração pode ser conflitante para diferentes aplicações. O diagnóstico também se complica: se você observa um consumo elevado de CPU ou disco em um servidor, não sabe qual tarefa está causando problemas.
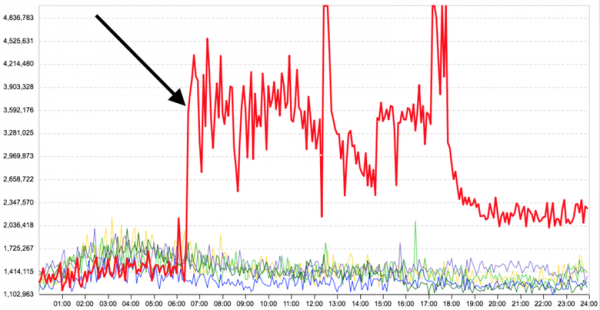
Mas o mais importante é que não há isolamento entre as tarefas executadas em uma única máquina. Por exemplo, o gráfico de tempo médio de resposta de uma tarefa no servidor antes e depois de executar outro aplicativo de cálculo não relacionado — o tempo de resposta da tarefa principal aumentou significativamente.
É claro que precisamos executar as tarefas em contêineres ou em máquinas virtuais. Como praticamente todas as tarefas são executadas sob um único sistema operacional (Linux) ou adaptadas a ele, não precisamos suportar uma variedade de sistemas operacionais diferentes. Portanto, a virtualização não é necessária; devido aos custos adicionais, será menos eficiente do que a conteinerização.
Como uma implementação de contêineres para executar tarefas diretamente nos servidores, o Docker é um bom candidato: as imagens de sistema de arquivos resolvem bem os problemas de configurações conflitantes. O fato de as imagens poderem ser compostas de várias camadas nos permite reduzir significativamente o volume de dados necessários para sua implantação na infraestrutura, destacando partes comuns em camadas básicas separadas. Assim, as camadas básicas (e mais volumosas) serão rapidamente armazenadas em cache em toda a infraestrutura, e para entregar muitos tipos diferentes de aplicativos e versões, será necessário transferir apenas camadas menores.
Além disso, o repositório pronto e a marcação de imagens no Docker nos fornecem primitivas prontas para versão e entrega de código em produção.
O Docker, assim como qualquer outra tecnologia semelhante, nos oferece um certo nível de isolamento de contêineres por padrão. Por exemplo, o isolamento de memória — cada contêiner recebe um limite de uso da memória da máquina, além do qual não consumirá mais. Também é possível isolar contêineres pelo uso de CPU. Para nós, contudo, o isolamento padrão foi insuficiente. Mas isso será abordado adiante.
Executar contêineres diretamente nos servidores é apenas parte dos problemas. A outra parte está relacionada ao posicionamento dos contêineres nos servidores. Precisamos entender qual contêiner pode ser colocado em qual servidor. Essa não é uma tarefa tão simples, pois os contêineres precisam ser posicionados nos servidores o mais densamente possível, sem reduzir a velocidade de funcionamento. Esse posicionamento pode ser complicado também em termos de tolerância a falhas. Frequentemente, queremos colocar réplicas do mesmo serviço em diferentes racks ou até mesmo em diferentes salas de datacenters, para que, em caso de falha de um rack ou sala, não percamos todas as réplicas do serviço de uma só vez.
Distribuir contêineres manualmente não é uma opção quando se tem 8 mil servidores e 8 a 16 mil contêineres.
Além disso, queríamos dar aos desenvolvedores mais autonomia na distribuição de recursos, para que eles pudessem colocar seus serviços em produção, sem a ajuda de um administrador. Ao mesmo tempo, queríamos manter o controle para que algum serviço secundário não consumisse todos os recursos dos nossos datacenters.
É evidente que precisamos de uma camada de gerenciamento que lide com isso automaticamente.
Finalmente chegamos a uma imagem simples e clara, que todos os arquitetos adoram: três quadrados.
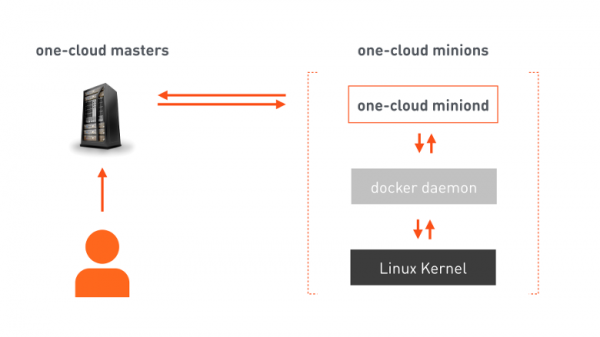
one-cloud masters — um cluster tolerante a falhas, responsável pela orquestração da nuvem. O desenvolvedor envia ao master um manifesto que contém todas as informações necessárias para a hospedagem do serviço. Com base nele, o master emite comandos para os minions selecionados (máquinas designadas para executar contêineres). Nos minions, temos nosso agente, que recebe as instruções, emite seus próprios comandos para o Docker, e o Docker configura o núcleo do Linux para executar o contêiner correspondente. Além de executar comandos, o agente informa continuamente o master sobre as mudanças de estado, tanto da máquina minion quanto dos contêineres em execução nela.
Distribuição de recursos
Agora vamos lidar com a tarefa mais complexa de distribuição de recursos para múltiplos minions.
O recurso computacional no one-cloud é:
- O poder de processamento do CPU consumido por uma tarefa específica.
- A quantidade de memória disponível para a tarefa.
- Tráfego de rede. Cada um dos minions possui uma interface de rede específica com largura de banda limitada, portanto, não é possível distribuir tarefas sem considerar o volume de dados que estão sendo transmitidos pela rede.
- Discos. Além, evidentemente, do espaço para os dados da tarefa, também alocamos o tipo de disco: HDD ou SSD. Os discos podem atender a um número final de solicitações por segundo — IOPS. Portanto, para tarefas que geram mais IOPS do que um único disco pode suportar, também alocamos "spindles" — ou seja, dispositivos de disco que devem ser exclusivamente reservados para a tarefa.
Assim, para um determinado serviço, por exemplo, para o user-cache, podemos registrar os recursos consumidos da seguinte forma: 400 núcleos de CPU, 2,5 TB de memória, 50 Gbps de tráfego em ambas as direções, 6 TB de espaço em HDD, alocados em 100 spindles. Ou de uma forma mais familiar para nós:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Os recursos do serviço user-cache consomem apenas parte de todos os recursos disponíveis na infraestrutura de produção. Portanto, é desejável evitar que, repentinamente, devido a um erro do operador ou não, o user-cache consuma mais recursos do que os atribuídos a ele. Ou seja, devemos limitar os recursos. Mas a que poderíamos vincular a cota?
Vamos voltar ao nosso esquema simplificado de interação entre componentes e redesenhar com mais detalhes — assim:
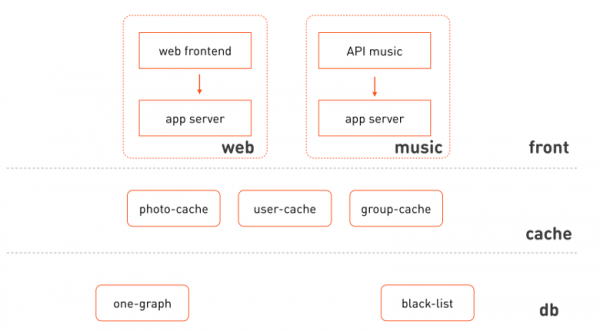
O que se destaca:
- O frontend da web e a música utilizam clusters isolados do mesmo servidor de aplicativos.
- Podemos identificar camadas lógicas, que incluem esses clusters: frontends, caches, camada de armazenamento e gestão de dados.
- O frontend é heterogêneo, consistindo em diferentes subsistemas funcionais.
- Os caches também podem ser distribuídos entre os subsistemas cujos dados eles armazenam.
Vamos redesenhar a imagem mais uma vez:
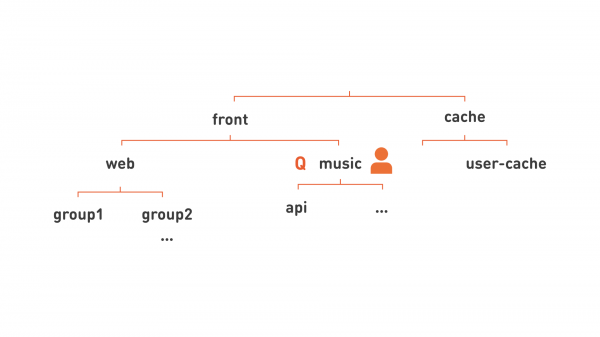
Uau! Estamos vendo uma hierarquia! Isso significa que podemos alocar recursos em porções maiores: designar um desenvolvedor responsável para um nó dessa hierarquia, correspondente ao subsistema funcional (como 'music' na imagem), e vincular uma cota a esse mesmo nível de hierarquia. Essa hierarquia também nos permite organizar serviços de maneira mais flexível para facilitar a gestão. Por exemplo, todo o web, sendo uma grande agrupação de servidores, dividimos em vários grupos menores, mostrados na imagem como group1, group2.
Removendo linhas desnecessárias, podemos escrever cada nó da nossa imagem de uma forma mais plana: group1.web.front, api.music.front, user-cache.cache.
Assim, chegamos ao conceito de 'fila hierárquica'. Ela possui um nome, como 'group1.web.front'. A ela é atribuída uma cota de recursos e direitos de usuários. Para uma pessoa da DevOps, daremos direitos para enviar serviços à fila, e esse colaborador pode iniciar algo na fila, enquanto uma pessoa da OpsDev terá direitos administrativos, podendo agora gerenciar a fila, designar pessoas a ela, conceder direitos e assim por diante. Os serviços iniciados nessa fila serão executados dentro da cota da fila. Se a cota computacional da fila não for suficiente para a execução simultânea de todos os serviços, eles serão executados sequencialmente, formando assim a fila propriamente dita.
Vamos analisar os serviços com mais detalhes. Um serviço tem um nome completo que sempre inclui o nome da fila. Então, o serviço web front terá o nome ok-web.group1.web.front. E o serviço do servidor de aplicativos ao qual ele se conecta será chamado de ok-app.group1.web.front. Cada serviço possui um manifesto que contém todas as informações necessárias para a alocação em máquinas específicas: quantos recursos essa tarefa consome, qual configuração é necessária, quantas réplicas devem existir, propriedades para o tratamento de falhas desse serviço. E, após a alocação do serviço diretamente nas máquinas, surgem suas instâncias. Elas também são nomeadas de forma única — como o número da instância e o nome do serviço: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Isso é muito conveniente: ao olhar apenas para o nome do contêiner em execução, podemos imediatamente descobrir muitas coisas.
Agora vamos conhecer melhor o que essas instâncias realmente executam: as tarefas.
Classes de isolamento de tarefas
Todas as tarefas em OK (e provavelmente em qualquer lugar) podem ser divididas em grupos:
- Tarefas com atraso curto — prod. Para essas tarefas e serviços, a latência (delay) é muito importante, ou seja, quão rapidamente cada uma das solicitações será processada pelo sistema. Exemplos de tarefas: front-end web, caches, servidores de aplicativos, armazenamentos OLTP, etc.
- Tarefas de cálculo — batch. Aqui, a velocidade de processamento de cada solicitação específica não é importante. O que importa é quantos cálculos totais essa tarefa realiza em um determinado (grande) intervalo de tempo (throughput). Isso inclui quaisquer tarefas MapReduce, Hadoop, aprendizado de máquina, estatística.
- Tarefas em segundo plano — idle. Para essas tarefas, nem a latência nem o throughput são muito importantes. Elas incluem vários testes, migrações, contagens, conversões de dados de um formato para outro. Por um lado, elas são semelhantes às tarefas de cálculo; por outro, não nos importa muito quão rápido elas são concluídas.
Vamos ver como essas tarefas consomem recursos, por exemplo, o processador central.
Tarefas com atraso curto. Para tal tarefa, o padrão de consumo de CPU será semelhante a este:
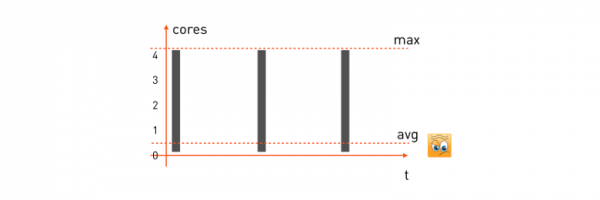
Uma solicitação do usuário é recebida, a tarefa começa a usar todos os núcleos de CPU disponíveis, processa, retorna uma resposta, aguarda a próxima solicitação e permanece ociosa. Uma nova solicitação chega — novamente, utiliza tudo o que estava disponível, processa, e aguarda a próxima.
Para garantir uma latência mínima para essa tarefa, devemos pegar o máximo de recursos que ela consome e reservar o número necessário de núcleos na minion (máquina que irá executar a tarefa). Assim, a fórmula de reserva para a nossa tarefa será:
alloc: cpu = 4 (max)E se tivermos uma máquina minion com 16 núcleos, podemos alocar exatamente quatro dessas tarefas. É importante destacar que o consumo médio de CPU para essas tarefas é frequentemente muito baixo — o que é evidente, uma vez que grande parte do tempo a tarefa está aguardando uma solicitação e não está fazendo nada.
Tarefas de cálculo. O padrão delas será um pouco diferente:
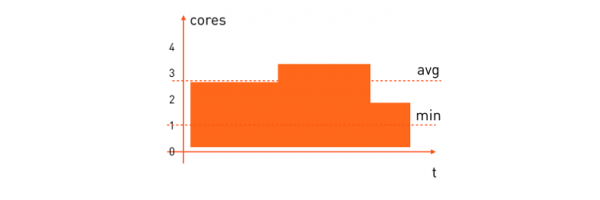
O consumo médio de recursos de CPU para essas tarefas é bastante alto. Frequentemente, queremos que a tarefa de cálculo seja concluída dentro de um determinado tempo, por isso é necessário reservar a quantidade mínima de processadores que ela precisa para que todo o cálculo seja finalizado dentro de um tempo aceitável. A fórmula de reserva será assim:
alloc: cpu = [1,*)“Por favor, aloque em um minion onde há pelo menos um núcleo livre, e quantos mais puder, levará tudo.”
Aqui a eficiência de uso já é significativamente melhor do que nas tarefas com atraso curto. Mas o ganho será muito maior se combinarmos ambos os tipos de tarefas em uma única máquina minion e distribuirmos seus recursos em tempo real. Quando uma tarefa com atraso curto requer CPU — ela a recebe imediatamente, e quando os recursos não são mais necessários — eles são transferidos para a tarefa de cálculo, ou seja, em resumo:
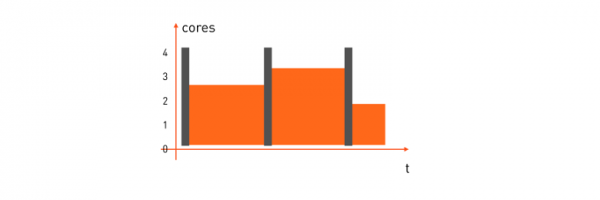
Mas como fazer isso?
Primeiro, vamos entender com prod e seu alloc: cpu = 4. Precisamos reservar quatro núcleos. No Docker run, isso pode ser feito de duas maneiras:
- Com a opção
--cpuset=1-4, ou seja, alocar quatro núcleos específicos para a tarefa na máquina. - Usar
--cpuquota=400_000 --cpuperiod=100_000, designar uma cota de tempo de CPU, ou seja, especificar que a cada 100 ms de tempo real, a tarefa consome no máximo 400 ms de tempo de CPU. Isso resulta nos mesmos quatro núcleos.
Mas qual desses métodos é o mais adequado?
O cpuset parece bastante atraente. A tarefa tem quatro núcleos dedicados, o que significa que os caches do processador funcionarão de forma mais eficaz. No entanto, isso tem um lado negativo: teríamos que assumir a responsabilidade de distribuir os cálculos pelos núcleos não carregados da máquina em vez do sistema operacional, e isso é uma tarefa bastante não trivial, especialmente se tentarmos alocar tarefas em lote nessa máquina. Os testes mostraram que a opção com cota é a mais adequada: assim, o sistema operacional tem mais liberdade para escolher o núcleo em que executar a tarefa no momento e o tempo de processador é distribuído de forma mais eficiente.
Vamos entender como fazer a reserva do número mínimo de núcleos no Docker. A cota para tarefas em lote já não é aplicável, porque não é necessário limitar um máximo, basta garantir um mínimo. E aqui se encaixa bem a opção docker run --cpushares.
Nós acordamos que se o lote requer uma garantia mínima em um núcleo, então devemos especificar --cpushares=1024, e se o mínimo for dois núcleos, especificamos --cpushares=2048. As cpu shares não interferem na distribuição do tempo de processador até que haja o suficiente. Assim, se o prod não estiver usando todos os seus quatro núcleos no momento — nada limita as tarefas em lote, e elas podem usar tempo de processador adicional. Mas na situação em que há falta de processador, se o prod consumiu todos os seus quatro núcleos e atingiu o limite — o tempo de processador restante será dividido proporcionalmente entre as cpu shares, ou seja, na situação de três núcleos livres, uma receberá a tarefa com 1024 cpu shares, e as outras duas — a tarefa com 2048 cpu shares.
Mas usar quota e shares não é suficiente. Precisamos garantir que a tarefa com baixa latência tenha prioridade sobre a tarefa em lote na distribuição do tempo de processador. Sem tal priorização, a tarefa em lote consumirá todo o tempo de processador no momento em que ele é necessário para o prod. No Docker run, não há opções de priorização de contêineres, mas as políticas do escalonador de CPU no Linux vêm em nosso auxílio. Detalhes sobre isso podem ser lidos , mas neste artigo, vamos abordá-las brevemente:
- SCHED_OTHER
Por padrão, todos os processos de usuário comuns em uma máquina Linux recebem essa opção. - SCHED_BATCH
Destinada a processos intensivos em recursos. Ao alocar uma tarefa no processador, aplica-se uma chamada penalidade de ativação: essa tarefa tem menor probabilidade de receber os recursos do processador se, no momento, uma tarefa com SCHED_OTHER estiver utilizando esses recursos. - SCHED_IDLE
Processo em segundo plano com prioridade muito baixa, ainda mais baixa do que o nice –19. Usamos nossa biblioteca de código aberto , para definir a política necessária ao iniciar o contêiner através da chamada
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Mas mesmo que você não esteja programando em Java, o mesmo pode ser feito com o comando chrt:
chrt -i 0 $pidVamos consolidar todos os nossos níveis de isolamento em uma tabela para facilitar a visualização:
Classe de isolamento
Exemplo alloc
Opções Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Se você executar chrt de dentro do contêiner, pode precisar da capability sys_nice, porque por padrão o Docker remove essa capability ao iniciar o contêiner.
Mas as tarefas consomem não apenas CPU, mas também tráfego, o que afeta ainda mais a latência da tarefa de rede do que a distribuição incorreta de recursos do processador. Portanto, queremos obter exatamente a mesma visão para o tráfego. Ou seja, quando uma tarefa prod envia alguns pacotes para a rede, limitamos a velocidade máxima (fórmula alloc: lan=[*,500mbps) ), com a qual o prod pode fazer isso. E para os batch, garantimos apenas o throughput mínimo, mas não limitamos o máximo (fórmula alloc: lan=[10Mbps,*) ) Nesse caso, o tráfego prod deve ter prioridade sobre as tarefas batch.
Aqui, o Docker não possui primitivas que poderíamos usar. Mas temos a ajuda do . Conseguimos alcançar o resultado desejado usando a disciplina . Com isso, separamos duas classes de tráfego: de alto-prioridade prod e de baixa-prioridade batch/idle. Assim, a configuração para o tráfego de saída fica assim:
aqui 1:0 — «qdisc raiz» da disciplina hsfc; 1:1 — classe filha hsfc com limite de largura de banda total de 8 Gbit/s, sob a qual estão todas as classes filhas de todos os contêineres; 1:2 — classe filha hsfc comum para todas as tarefas batch e idle com limite «dinâmico», sobre o qual falaremos abaixo. As outras classes filhas hsfc são classes dedicadas para os contêineres prod ativos com limites que correspondem aos seus manifests, — 450 e 400 Mbit/s. Cada classe hsfc recebe a fila qdisc fq ou fq_codel, dependendo da versão do kernel linux, para evitar perdas de pacotes durante picos de tráfego.
Normalmente, as disciplinas tc servem apenas para priorizar o tráfego de saída. Mas queremos priorizar também o tráfego de entrada — já que alguma tarefa batch pode facilmente consumir toda a largura de banda de entrada, recebendo, por exemplo, um grande pacote de dados de entrada para map&reduce. Para isso, usamos o módulo , que cria uma interface virtual ifbX para cada interface de rede e redireciona o tráfego de entrada da interface para a saída em ifbX. Em seguida, para ifbX funcionam todas as mesmas disciplinas de controle de tráfego de saída, para as quais a configuração hsfc será muito semelhante:
Durante os experimentos, descobrimos que os melhores resultados do hsfc são alcançados quando a classe 1:2 do tráfego batch/idle não prioritário é limitada nas máquinas-minion a não mais do que uma largura de banda livre determinada. Caso contrário, o tráfego não prioritário afeta muito a latência das tarefas prod. O valor atual da largura de banda livre é determinado a cada segundo pelo miniond, medindo o consumo médio de tráfego de todas as tarefas prod desse minion  e subtraindo isso da largura de banda da interface de rede
 com uma pequena margem, ou seja,

As larguras são definidas para o tráfego de entrada e saída de forma independente. E de acordo com os novos valores, o miniond reconfigura o limite da classe não prioritária 1:2.
Assim, implementamos todas as três classes de isolamento: prod, batch e idle. Essas classes afetam fortemente o desempenho das tarefas. Portanto, decidimos colocar esse recurso no topo da hierarquia, para que ao olhar para o nome da fila hierárquica, fique claro imediatamente com o que estamos lidando:
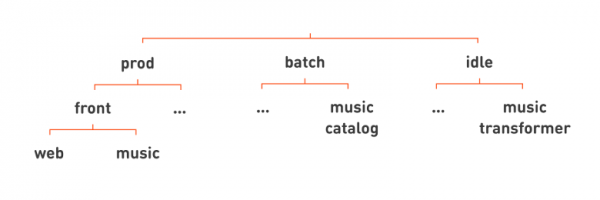
Todos os nossos conhecidos web e music front-end são então colocados na hierarquia sob prod. Para exemplo, sob batch vamos colocar o serviço catálogo de músicas, que periodicamente compila um catálogo de faixas a partir de um conjunto de arquivos mp3 carregados no "Odnoklassniki". Um exemplo de serviço em idle pode ser transformador de música, que normaliza o nível de volume da música.
Removendo novamente as linhas desnecessárias, podemos escrever os nomes de nossos serviços de forma mais plana, adicionando a classe de isolamento da tarefa ao final do nome completo do serviço: web.front.prod, catalog.music.batch, transformer.music.idle.
E agora, olhando para o nome do serviço, entendemos não apenas qual função ele desempenha, mas também sua classe de isolamento, e, portanto, sua criticidade etc.
Tudo é maravilhoso, mas há uma amarga verdade. É impossível isolar completamente as tarefas que operam em uma única máquina.
O que conseguimos alcançar: se o batch consome intensivamente apenas recursos da CPU, o agendador embutido do Linux gerencia muito bem sua tarefa, e a influência sobre a tarefa prod é praticamente inexistente. Mas se essa tarefa de batch começa a trabalhar ativamente com a memória, então a influência mútua já aparece. Isso acontece porque os caches de CPU da tarefa prod são "esvaziados" — no final, aumentam os misses no cache e o processador processa a tarefa prod mais lentamente. Tal tarefa de batch pode aumentar em 10% as latências do nosso típico container prod.
Isolar o tráfego é ainda mais difícil devido ao fato de que as modernas placas de rede possuem uma fila interna de pacotes. Se um pacote da tarefa de batch foi o primeiro a entrar, ele será o primeiro a ser transmitido pelo cabo, e isso não pode ser alterado.
Além disso, até agora conseguimos resolver apenas a tarefa de priorização do tráfego TCP: para o UDP, a abordagem com hsfc não funciona. E mesmo no caso do tráfego TCP, se a tarefa de batch gerar muito tráfego, isso também resulta em um aumento de aproximadamente 10% na latência da tarefa prod.
Resiliência
Um dos objetivos ao desenvolver o one-cloud foi melhorar a resistência a falhas do Odnoklassniki. Portanto, a seguir, gostaria de examinar mais detalhadamente possíveis cenários de falhas e emergências. Vamos começar com um cenário simples — a falha de um container.
Um contêiner pode falhar de várias maneiras. Pode ser um experimento, um bug ou um erro no manifesto que faz com que a tarefa de produção comece a consumir mais recursos do que especificado. Tínhamos um caso em que um desenvolvedor implementou um algoritmo complexo e, ao recriá-lo várias vezes, se confundiu tanto que, no final, a tarefa entrou em um loop que não era trivial. E como a tarefa de produção tem prioridade sobre todas as outras nas mesmas máquinas, ela começou a consumir todos os recursos disponíveis da CPU. Nesta situação, a isolação ajudou, mais especificamente, uma cota de tempo de CPU. Se uma tarefa tiver uma cota atribuída, ela não consumirá mais que isso. Portanto, as tarefas em lote e outras tarefas de produção que estavam na mesma máquina não notaram nada.
O segundo problema possível é a falha do contêiner. E aqui as políticas de reinício nos salvam, todos conhecem isso, o Docker se sai muito bem. Quase todas as tarefas de produção têm a política de reinício sempre. Às vezes usamos on_failure para tarefas em lote ou para depuração de contêineres de produção.
E o que pode ser feito quando um minion inteiro fica indisponível?
Obviamente, executar o contêiner em outra máquina. O mais interessante aqui é o que acontece com o endereço IP atribuído ao contêiner.
Podemos atribuir aos contêineres os mesmos endereços IP que as máquinas minions nas quais esses contêineres estão sendo executados. Assim, ao executar um contêiner em outra máquina, seu endereço IP muda e todos os clientes devem entender que o contêiner foi movido, agora é necessário acessar outro endereço, o que requer um serviço separado de Descoberta de Serviço.
A Descoberta de Serviço é conveniente. Há muitas soluções no mercado com diferentes graus de tolerância a falhas para organizar o registro de serviços. Muitas vezes, essas soluções implementam a lógica do balanceador de carga, armazenam configurações adicionais na forma de um armazenamento KV, etc.
No entanto, gostaríamos de evitar a necessidade de implementar um registro separado, pois isso significaria a introdução de um sistema crítico que é usado por todos os serviços em produção. Isso representa um ponto de falha potencial, e é necessário escolher ou desenvolver uma solução muito resiliente, o que, obviamente, é bastante complicado, demorado e caro.
E mais uma grande desvantagem: para que nossa antiga infraestrutura funcionasse com a nova, seria necessário reescrever absolutamente todas as tarefas para utilizar algum sistema de Service Discovery. O trabalho é MUITO, e em alguns pontos chega a ser impossível, principalmente quando se trata de dispositivos de baixo nível que operam no núcleo do sistema operacional ou diretamente com o hardware. A implementação dessa funcionalidade por meio de padrões de soluções estabelecidas, como por exemplo terminaria significando, em alguns casos, uma carga adicional, e em outros — uma complexidade na operação e novos cenários de falha. Não queríamos complicar as coisas, então decidimos tornar o uso do Service Discovery opcional.
No one-cloud, o IP segue o contêiner, ou seja, cada instância da tarefa tem seu próprio endereço IP. Esse endereço é "estático": ele é atribuído a cada instância no momento do primeiro envio do serviço para a nuvem. Se durante a vida do serviço houver um número diferente de instâncias, no final, serão atribuídos tantos endereços IP quantas foram as instâncias máximas.
Posteriormente, esses endereços não mudam: são atribuídos uma vez e continuam existindo durante toda a vida do serviço em produção. Os endereços IP seguem os contêineres pela rede. Se um contêiner for movido para outro minion, o endereço também seguirá sua transferência.
Assim, a correspondência entre o nome do serviço e a lista de seus endereços IP muda raramente. Se olharmos novamente para os nomes das instâncias de serviços que mencionamos no início do artigo (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), então perceberemos que eles lembram FQDNs usados no DNS. E realmente, para exibir os nomes das instâncias de serviços em seus endereços IP, utilizamos o protocolo DNS. Aliás, esse DNS retorna todos os endereços IP reservados de todos os contêineres — tanto os em funcionamento quanto os parados (digamos que são usadas três réplicas e temos cinco endereços reservados — todos os cinco serão retornados). Os clientes, ao receber essas informações, tentarão estabelecer conexão com todas as cinco réplicas — e assim determinarão aquelas que estão ativas. Esse método de verificação de disponibilidade é significativamente mais confiável, pois não envolve nem DNS, nem Service Discovery, o que significa que não há tarefas difíceis relacionadas à atualização das informações e à resiliência desses sistemas. Além disso, em serviços críticos dos quais depende o funcionamento de todo o portal, podemos até não utilizar DNS, mas simplesmente inserir na configuração os endereços IP.
A implementação dessa transferência de IP para os contêineres pode ser não trivial — e pararemos para ver como isso funciona no próximo exemplo:
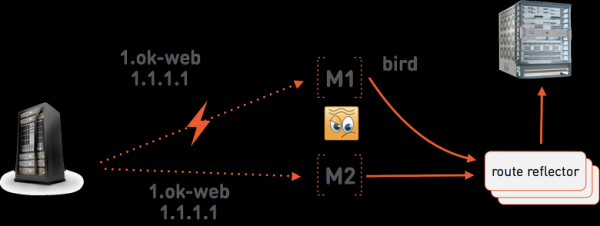
Suponhamos que o mestre one-cloud dê a ordem para o minion M1 iniciar 1.ok-web.group1.web.front.prod com o endereço 1.1.1.1. No minion, está em execução , que anuncia esse endereço para servidores especiais . Estes últimos têm uma sessão BGP com o equipamento de rede, para o qual se transmite a rota do endereço 1.1.1.1 para o M1. O M1 roteia os pacotes para dentro do contêiner utilizando os recursos do Linux. Existem três servidores route reflector, pois essa é uma parte muito crítica da infraestrutura one-cloud — sem eles, a rede do one-cloud não funcionará. Nós os colocamos em diferentes racks, se possível localizados em diferentes salas do data center, para reduzir a probabilidade de falha simultânea de todos os três.
Agora, vamos supor que a conexão entre o mestre one-cloud e o minion M1 foi perdida. O mestre one-cloud agora atuará sob a suposição de que o M1 falhou completamente. Ou seja, dará a ordem para o minion M2 iniciar web.group1.web.front.prod com o mesmo endereço 1.1.1.1. Agora temos duas rotas conflitantes na rede para 1.1.1.1: em M1 e em M2. Para resolver esses conflitos, utilizamos o Multi Exit Discriminator, que é especificado no anúncio BGP. Esse número indica o peso da rota anunciada. A rota com o menor valor de MED será escolhida entre as conflitantes. O mestre one-cloud suporta MED como parte integral dos endereços IP dos contêineres. Na primeira vez, o endereço é anunciado com um MED bastante alto = 1.000.000. Na situação de um deslocamento emergencial do contêiner, o mestre reduz o MED, e M2 receberá então a ordem de anunciar o endereço 1.1.1.1 com MED = 999.999. O exemplar que está atuando em M1 ficará sem conexão até que a conexão com o mestre seja restabelecida, momento em que será desativado como um antigo duplicado.
Acidentes
Todos os sistemas de gerenciamento de data centers gerenciam adequadamente pequenas falhas. A queda de um contêiner é normal em praticamente qualquer lugar.
Vamos considerar como tratamos um acidente, por exemplo, uma falha de energia em uma ou mais salas do data center.
O que significa um acidente para o sistema de gerenciamento do data center? Em primeiro lugar, é uma falha massiva e simultânea de várias máquinas, e o sistema de gerenciamento precisa migrar ao mesmo tempo muitos contêineres. Mas se o acidente for muito grande, pode acontecer que todas as tarefas não consigam ser redistribuídas para outros minions, porque a capacidade do data center cai abaixo de 100% de carga.
Frequentemente, os acidentes são acompanhados pela falha da camada de gerenciamento. Isso pode ocorrer devido à falha do equipamento, mas mais frequentemente acontece porque os acidentes não são testados, e a camada de gerenciamento falha devido à carga elevada.
O que pode ser feito a respeito?
Migrações em massa significam que há um grande número de ações, migrações e alocações na infraestrutura. Cada migração pode levar algum tempo necessário para a entrega e descompactação das imagens dos contêineres para os minions, start e inicialização dos contêineres, etc. Portanto, é desejável que as tarefas mais importantes sejam iniciadas antes das menos importantes.
Vamos olhar novamente para a hierarquia de serviços que já conhecemos e tentar decidir quais tarefas queremos iniciar primeiro.
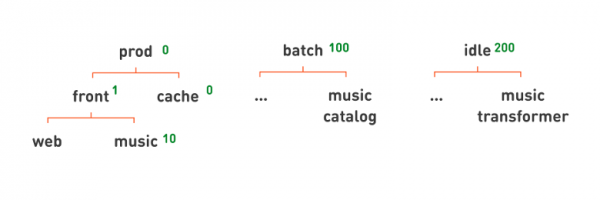
Claro, esses são os processos que estão diretamente envolvidos no processamento de solicitações dos usuários, ou seja, prod. Nós indicamos isso por meio de prioridade de alocação — um número que pode ser atribuído a uma fila. Se uma fila tiver uma prioridade mais alta, seus serviços são alocados primeiro.
No prod, atribuímos prioridades mais altas, 0; no batch — um pouco mais baixas, 100; no idle — ainda mais baixas, 200. As prioridades são aplicadas de forma hierárquica. Todas as tarefas de uma hierarquia inferior terão a prioridade correspondente. Se quisermos que os caches dentro do prod sejam executados antes dos frontends, então atribuiremos prioridades ao cache = 0 e aos frontends de subordinação = 1. Se, por exemplo, quisermos que dentro dos frontends o portal principal seja executado primeiro, e o frontend de música depois, podemos atribuir à última uma prioridade mais baixa — 10.
O próximo problema é a falta de recursos. Portanto, tivemos uma grande falha em vários equipamentos, salas inteiras do data center, e nós iniciamos serviços suficientes para que agora não haja recursos para todos. Precisamos decidir quais tarefas sacrificar para que os principais serviços críticos funcionem.
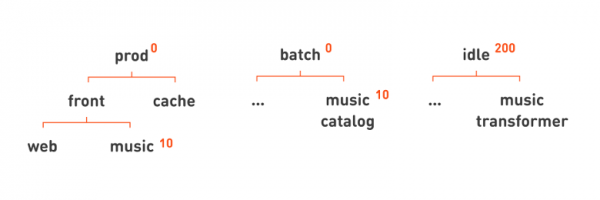
Diferente da prioridade de alocação, não podemos simplesmente sacrificar todas as tarefas de batch, algumas delas são importantes para o funcionamento do portal. Por isso, destacamos separadamente prioridade de despejo tarefa. Ao alocar, uma tarefa com prioridade mais alta pode despejar, ou seja, parar uma tarefa com prioridade mais baixa, se não houver mais minions disponíveis. Nesse caso, a tarefa com prioridade mais baixa provavelmente permanecerá não alocada, ou seja, não haverá mais um minion adequado com recursos livres suficientes.
Em nossa hierarquia, é muito simples indicar tal prioridade de despejo, para que tarefas prod e batch despejem ou parem tarefas idle, mas não umas às outras, definindo a prioridade para idle como 200. Assim como no caso da prioridade de alocação, podemos usar nossa hierarquia para descrever regras mais complexas. Por exemplo, podemos indicar que sacrificamos a função de música se não tivermos recursos para o portal web principal, estabelecendo uma prioridade mais baixa para os nós correspondentes: 10.
Falhas completas do Data Center
Por que todo o data center pode falhar? Fenômenos naturais. Houve um bom post sobre como . Pode-se considerar o fator humano, como aqueles que queimaram um cabo de fibra óptica em um poço de acesso, fazendo com que todo o data center perdesse a conexão com outras localizações. A falha pode ser causada por humanos: um operador pode emitir um comando que faz todo o data center parar. Isso pode ocorrer devido a um grande bug. Em geral, data centers caem — isso não é raro. Isso acontece conosco a cada poucos meses.
E é isso que fazemos para garantir que ninguém #okviva poste no Twitter.
A primeira estratégia é a isolação. Cada instância one-cloud é isolada e pode gerenciar máquinas apenas de um único data center. Ou seja, a perda da nuvem devido a bugs ou a um comando incorreto do operador resulta apenas na perda de um data center. Estamos preparados para isso: temos uma política de reserva, onde as réplicas de aplicativos e dados são hospedadas em todos os data centers. Utilizamos bancos de dados tolerantes a falhas e testamos falhas periodicamente.
Como hoje temos quatro data centers, também temos quatro instâncias one-cloud separadas e completamente isoladas.
Essa abordagem não só protege contra falhas físicas, mas também pode proteger contra erros de operadores.
E o que mais podemos fazer sobre o fator humano? Quando um operador emite um comando estranho ou potencialmente perigoso para a nuvem, pode-se exigir que ele resolva uma pequena tarefa para verificar o quão bem ele pensou. Por exemplo, se for uma parada em massa de muitas réplicas ou apenas um comando estranho — redução no número de réplicas ou alteração do nome da imagem, e não apenas o número da versão em um novo manifesto.
Resultados
Características distintivas do one-cloud:
- Um esquema de nomeação hierárquica e claro para serviços e contêineres, que permite saber rapidamente qual é a tarefa, a que se refere e como funciona, e quem é responsável por ela.
- Aplicamos a nossa técnica de mesclagem de tarefas prod- e batch-em minions para aumentar a eficiência do compartilhamento de máquinas. Em vez de cpuset, utilizamos cotas de CPU, shares, políticas de escalonamento de CPU e QoS do Linux.
- Não conseguimos isolar completamente os contêineres que rodam em uma mesma máquina, mas sua influência mútua permanece dentro de 20%.
- A organização dos serviços em uma hierarquia ajuda na eliminação automática de falhas usando prioridades de alocação e exclusão..
PERGUNTAS FREQUENTES
Por que não adotamos uma solução pronta.
- Diferentes classes de isolamento de tarefas exigem lógicas variadas ao serem alocadas em minions. Enquanto tarefas de produção podem ser alocadas simplesmente por meio da reserva de recursos, tarefas em lote e ociosas precisam ser alocadas monitorando a real utilização dos recursos nas máquinas-minions.
- A necessidade de contabilizar recursos consumidos pelas tarefas, como:
- largura de banda da rede;
- tipos e ‘spindles’ de discos.
- A necessidade de definir prioridades de serviços durante a resolução de falhas, direitos e cotas de equipes sobre recursos, o que é resolvido através de filas hierárquicas na one-cloud.
- A necessidade de ter nomes humanos para contêineres a fim de reduzir o tempo de resposta a falhas e incidentes.
- A impossibilidade de uma implementação geral simultânea do Service Discovery; a necessidade de coexistir por um longo tempo com tarefas alocadas em hosts físicos — o que é resolvido com endereços IP ‘estáticos’ que acompanham os contêineres, e, como consequência, a necessidade de uma integração única com uma grande infraestrutura de rede.
Todas essas funções exigiriam significativas adaptações das soluções existentes, e, ao avaliarmos a quantidade de trabalho, percebemos que conseguiríamos desenvolver nossa própria solução com aproximadamente o mesmo esforço. Porém, nossa solução será significativamente mais fácil de operar e desenvolver — nela não há abstrações desnecessárias que suportam funcionalidades que não precisamos.
Agradeço a todos que leram até as últimas linhas pela paciência e atenção!
Fonte: habr.com
