

Introdução aos sistemas operacionais
Olá, Habr! Quero apresentar a vocês uma série de artigos traduzidos de uma literatura que considero interessante — OSTEP. Este material explora a fundo o funcionamento dos sistemas operacionais semelhantes ao Unix, particularmente — o trabalho com processos, vários escalonadores, memória e outros componentes que compõem um sistema operacional moderno. Você pode olhar o original de todo o material aqui . Peço que considerem que a tradução foi feita de forma não profissional (de maneira bastante livre), mas espero ter mantido o sentido geral.
Os trabalhos de laboratório sobre este assunto podem ser encontrados aqui:
Partes adicionais:
E você também pode acessar meu canal em =)
Alerta! há um laboratório para esta aula! veja
API do Processo
Vamos analisar um exemplo de criação de um processo no sistema UNIX. Isso ocorre por meio de duas chamadas de sistema fork() e exec().
Chamando fork()
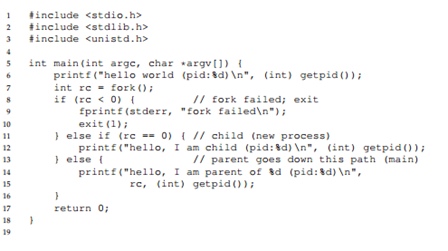
Vamos considerar um programa que executa a chamada fork(). O resultado da sua execução será o seguinte.
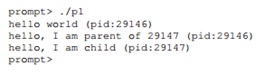
Em primeiro lugar, entramos na função main() e realizamos a exibição de uma string na tela. A string contém o identificador do processo, que originalmente é chamado PID ou identificador do processo. Este identificador é utilizado no UNIX para referenciar o processo. A próxima instrução será a chamada de fork(). Nesse momento, uma cópia quase exata do processo é criada. Para o sistema operacional, parece que duas cópias do mesmo programa estão em execução, que, por sua vez, sairão da execução da função fork(). O processo-filho criado (em relação ao processo-pai que o criou) não será mais executado a partir da função main(). É importante lembrar que o processo-filho não é uma cópia exata do processo-pai, pois ele tem seu próprio espaço de endereço, seus próprios registradores, seu próprio ponteiro para instruções executáveis e assim por diante. Assim, o valor retornado para o chamador da função fork() será diferente. O processo-pai receberá como retorno o valor PID do processo filho, enquanto o filho receberá um valor igual a 0. Esses códigos de retorno poderão ser usados posteriormente para diferenciar os processos e fazer com que cada um execute seu trabalho. Vale lembrar que a execução deste programa não é estritamente definida. Após a separação em 2 processos, o sistema operacional começa a monitorá-los e a planejar seu funcionamento. No caso de execução em um processador de um único núcleo, um dos processos continuará a execução, neste caso — o pai, e então o controle será passado para o processo-filho. Em uma nova execução, a situação pode ser diferente.
Chamando wait()
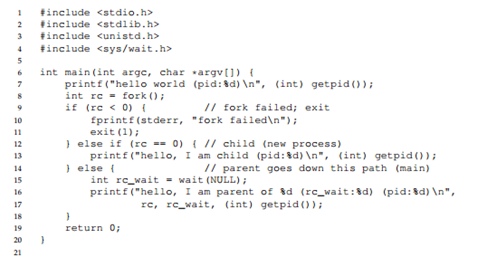
Vamos considerar o seguinte programa. Neste programa, devido à presença da chamada wait() o processo-pai sempre esperará a conclusão do trabalho do processo-filho. Nesse caso, teremos uma saída de texto estritamente definida na tela.

Chamando exec()
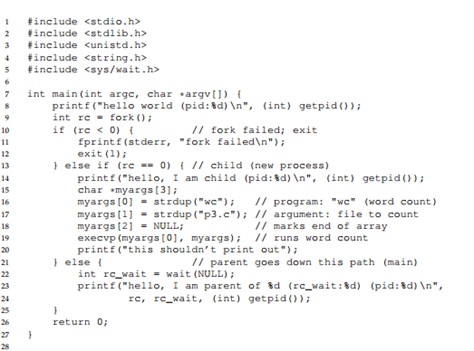
Vamos analisar a chamada exec(). Esta chamada de sistema é útil quando queremos iniciar um programa completamente diferente. Aqui chamaremos execvp() para iniciar o programa wc, que é um programa de contagem de palavras. O que acontece durante a chamada de exec()? Este chamado recebe como argumentos o nome do arquivo executável e alguns parâmetros. Em seguida, o código e os dados estáticos desse arquivo executável são carregados e seu segmento de código é sobrescrito. As outras áreas de memória, como a pilha e o heap, são reinicializadas. Depois, o SO simplesmente executa o programa, passando a ele um conjunto de argumentos. Assim, não criamos um novo processo; simplesmente transformamos o programa atualmente em execução em outro programa em execução. Após a execução da chamada de exec(), o filho tem a impressão de que o programa original, na verdade, nunca foi iniciado.
Essa complexidade no início é absolutamente normal para o shell do Unix, e permite que esse shell execute código após a chamada fork(), mas antes da chamada exec(). Um exemplo desse código pode ser a adaptação do ambiente do shell para atender às necessidades do programa a ser iniciado, antes de seu lançamento imediato.
Shell — é apenas um programa de usuário. Ele exibe um prompt e aguarda até que você digite algo nele. Na maioria dos casos, se você digitar o nome de um programa, o shell encontrará sua localização, chamará o método fork(), e depois, para criar um novo processo, chamará algum dos tipos de exec() e aguardará sua execução com a chamada wait(). Quando o processo filho terminar, o shell retornará da chamada wait() e exibirá novamente o prompt, aguardando a entrada do próximo comando.
A separação entre fork() & exec() permite que o shell faça as seguintes coisas, por exemplo:
wc file > new_file.
Neste exemplo, a saída do programa wc é redirecionada para um arquivo. O método pelo qual o shell atinge isso é bastante simples — ao criar o processo filho antes da chamada exec(), o shell fecha o fluxo padrão de saída e abre o arquivo new_file, assim, toda a saída do programa que será iniciado a seguir wc será redirecionada para o arquivo em vez da tela.
O pipe do Unix é implementado de maneira semelhante, com a diferença de que eles usam a chamada pipe(). Nesse caso, o fluxo de saída do processo será conectado a uma fila pipe, situada no núcleo, que também será unida ao fluxo de entrada de outro processo.
Fonte: habr.com
