

Introdução aos sistemas operacionais
Olá, Habr! Quero apresentar a vocês uma série de artigos traduzidos de uma literatura que considero interessante — OSTEP. Este material explora a fundo o funcionamento dos sistemas operacionais semelhantes ao Unix, particularmente — o trabalho com processos, vários escalonadores, memória e outros componentes que compõem um sistema operacional moderno. Você pode olhar o original de todo o material aqui . Peço que considerem que a tradução foi feita de forma não profissional (de maneira bastante livre), mas espero ter mantido o sentido geral.
Os trabalhos de laboratório sobre este assunto podem ser encontrados aqui:
Partes adicionais:
E você também pode acessar meu canal em =)
Escalonamento: Multi-Level Feedback Queue
Nesta aula, falaremos sobre os problemas de desenvolvimento de uma das abordagens mais conhecidas para
escalonamento, chamada Multi-Level Feedback Queue (MLFQ). O escalonador MLFQ foi descrito pela primeira vez em 1962 por Fernando J. Corbató em um sistema chamado
Compatible Time-Sharing System (CTSS). Esses trabalhos (incluindo trabalhos posteriores sobre
Multics) foram posteriormente indicados ao Prêmio Turing. O escalonador foi
subsequentemente aprimorado e assumiu uma forma que pode ser encontrada em
alguns sistemas modernos.
O algoritmo MLFQ tenta resolver 2 problemas fundamentais interconectados.
Primeiro, ele tenta otimizar o tempo de turnaround, que, como discutimos na aula anterior, é otimizado ao executar no início da fila as tarefas mais
curtas. No entanto, o sistema operacional não sabe quanto tempo um processo vai levar, e essa é uma
informação necessária para o funcionamento dos algoritmos SJF, STCF. Em segundo lugar, MLFQ tenta
tornar o sistema responsivo para os usuários (por exemplo, para aqueles que ficam sentados e
observando a tela enquanto esperam a conclusão da tarefa) e, assim, minimizar o tempo
de resposta. Infelizmente, algoritmos como RR reduzem o tempo de resposta, mas têm um impacto muito
negativo nas métricas de tempo de turnaround. Daí surge o nosso problema: Como projetar um
escalonador que atenda às nossas necessidades e, ao mesmo tempo, não saiba nada sobre
a natureza do processo, em geral? Como o escalonador pode aprender as características das tarefas,
que ele executa e, assim, tomar melhores decisões sobre o planejamento?
A essência do problema: como planejar a definição de tarefas sem um conhecimento perfeito?
Como desenvolver um agendador que minimize ao mesmo tempo o tempo de resposta
para tarefas interativas e, ao mesmo tempo, minimize o tempo de turnaround sem um
conhecimento prévio do tempo de execução da tarefa?
Nota: aprendemos com eventos anteriores
A fila MLFQ é um excelente exemplo de um sistema que aprende com
eventos passados para prever o futuro. Abordagens semelhantes são frequentemente
encontradas em sistemas operacionais (e em muitos outros setores da computação, incluindo ramos
de predição em hardware e algoritmos de cache). Essas abordagens
funcionam bem quando as tarefas têm fases comportamentais e, assim, são previsíveis.
No entanto, com tal técnica, deve-se ter cautela, pois as previsões podem facilmente
estar erradas e levar o sistema a tomar decisões piores do que
seriam sem qualquer conhecimento.
MLFQ: Regras Básicas
Vamos considerar as regras básicas do algoritmo MLFQ. E embora haja várias
implementações desse algoritmo, as abordagens básicas são semelhantes.
Na implementação que iremos considerar, o MLFQ terá várias
filas separadas, cada uma com uma prioridade diferente. A qualquer momento,
uma tarefa pronta para execução reside em uma das filas. O MLFQ utiliza prioridades
para decidir qual tarefa executar, ou seja, a tarefa com maior
prioridade (tarefa da fila de maior prioridade) será executada primeiro.
Sem dúvida, pode haver mais de uma tarefa na fila específica, assim
elas terão a mesma prioridade. Neste caso, será utilizado o mecanismo
RR para agendar a execução entre essas tarefas.
Assim, chegamos a duas regras básicas para o MLFQ:
Regra 1: Se Prioridade(A) > Prioridade(B), será executada a tarefa A (B não será)
- Regra 2: Se Prioridade(A) = Prioridade(B), A e B serão executadas usando RR
- Com base no exposto, os elementos-chave para o planejamento MLFQ
são as prioridades. Em vez de atribuir uma prioridade fixa a cada
tarefa, o MLFQ altera sua prioridade com base no comportamento observado.
para a tarefa, o MLFQ altera sua prioridade com base no comportamento observado.
Por exemplo, se uma tarefa frequentemente usa a CPU aguardando entrada do teclado,
o MLFQ manterá a prioridade do processo em um nível alto, pois é assim que
um processo interativo deve funcionar. Se, pelo contrário, a tarefa utiliza a CPU de forma contínua e
intensa por um longo período, o MLFQ reduzirá sua
prioridade. Assim, o MLFQ aprenderá o comportamento dos processos enquanto eles estão em operação
e usará esse comportamento.
Vamos desenhar um exemplo de como as filas poderiam parecer em um determinado momento
no tempo e então teremos algo assim:
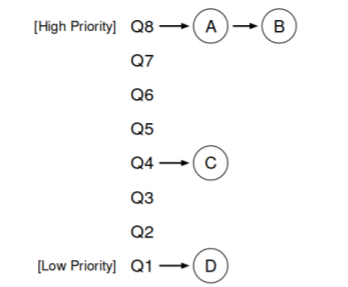
Neste esquema, 2 processos A e B estão na fila com a mais alta prioridade. O processo
C está em algum lugar no meio, e o processo D no final da fila. De acordo com as descrições acima
do algoritmo MLFQ, o escalonador executará tarefas apenas com a mais alta
prioridade de acordo com o RR, enquanto as tarefas C e D estarão sem uso.
Naturalmente, uma captura estática não fornecerá uma imagem completa de como o MLFQ opera.
É importante entender como a situação muda ao longo do tempo.
Tentativa 1: Como alterar a prioridade
Neste momento, é necessário decidir como o MLFQ irá alterar o nível de prioridade
da tarefa (e assim sua posição na fila) ao longo de seu ciclo de vida. Para
isso, é preciso considerar o fluxo de trabalho: um certo número de
tarefas interativas com tempos de execução curtos (e, portanto, frequente liberação da
CPU) e algumas tarefas longas que usam a CPU durante todo o seu tempo de operação, enquanto
o tempo de resposta para essas tarefas não é importante. E assim, pode-se fazer a primeira tentativa
de implementar o algoritmo MLFQ com as seguintes regras:
- Regra 3: Quando uma tarefa chega ao sistema, ela é colocada na fila com a mais alta
- prioridade.
- Regra 4a: Se a tarefa utiliza todo o tempo alocado, sua
- prioridade é reduzida.
- Regra 4b: Se a tarefa libera a CPU antes de esgotar seu tempo, ela
- mantém sua prioridade anterior.
Exemplo 1: Uma única tarefa de longa duração
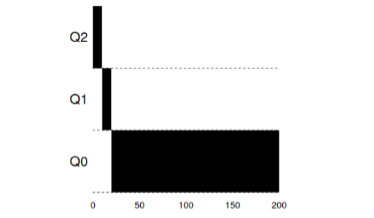
Como pode ser visto neste exemplo, a tarefa ao entrar é atribuída com a mais alta
prioridade. Após um intervalo de 10 ms, o processo é reduzido em prioridade
pelo escalonador. Após o próximo intervalo de tempo, a tarefa finalmente é reduzida para
a prioridade mais baixa no sistema, onde permanece.
Exemplo 2: Uma tarefa curta chegou
Agora vamos ver um exemplo de como o MLFQ tentará se aproximar do SJF. Nele
há duas tarefas: A, que é uma tarefa de longa duração constantemente
ocupando a CPU e B, que é uma tarefa interativa curta. Suponha que
A já tenha trabalhado por algum tempo quando a tarefa B chegou.
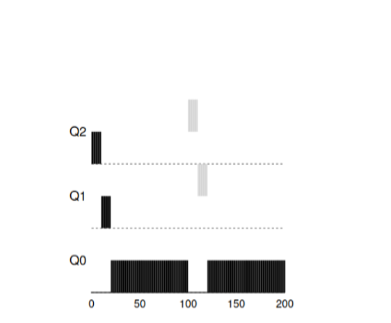
Neste gráfico, os resultados do cenário são visíveis. A tarefa A, assim como qualquer tarefa
que utiliza a CPU, aparece na parte inferior. A tarefa B chegará no tempo T=100 e será
colocada na fila com a mais alta prioridade. Como seu tempo de execução é curto,
ela será concluída antes de alcançar a última fila.
Desse exemplo, podemos entender o principal objetivo do algoritmo: como o algoritmo não
sabe se a tarefa é longa ou curta, ele primeiro supõe que a tarefa
é curta e lhe dá a mais alta prioridade. Se realmente for uma tarefa curta, ela
será concluída rapidamente, caso contrário, se for uma tarefa longa, ela se moverá lentamente
para baixo na prioridade e em breve provará que realmente é uma tarefa longa, que não
requer resposta.
Exemplo 3: E quanto à entrada e saída?
Agora vamos olhar para um exemplo com entrada e saída. Como foi afirmado na regra 4b,
se um processo libera a CPU sem usar todo o seu tempo de CPU,
ele permanece no mesmo nível de prioridade. As intenções dessa regra são bastante simples —
se uma tarefa interativa realiza muitas operações de entrada e saída, por exemplo, esperando
por pressionamentos de tecla ou clique do mouse do usuário, essa tarefa liberará a CPU
antes do tempo alocado. Não gostaríamos de rebaixar essa tarefa na prioridade,
portanto, ela permanecerá no mesmo nível.
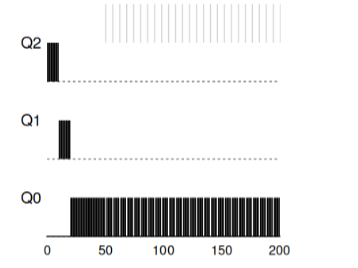
Este exemplo mostra como o algoritmo funcionará com esses processos — a tarefa interativa B, que precisa da CPU apenas por 1 ms antes de executar
o processo de entrada e saída e a longa tarefa A, que utiliza toda sua CPU.
MLFQ mantém a tarefa B com a mais alta prioridade, pois ela continuamente libera
a CPU. Se B for uma tarefa interativa, o algoritmo nesse caso atingiu
seu objetivo de executar tarefas interativas rapidamente.
Problemas com o algoritmo MLFQ atual
Nos exemplos anteriores, construímos uma versão básica do MLFQ. E parece que ele
executa seu trabalho bem e com honestidade, distribuindo o tempo de CPU de forma justa entre
tarefas longas e permitindo que tarefas curtas ou tarefas que exigem intensivamente
entrada e saída sejam processadas rapidamente. Infelizmente, essa abordagem apresenta várias
problemas sérios.
Primeiro, o problema da fome: se houver muitas tarefas interativas no sistema, elas consumirã
todo o tempo de CPU, e assim nenhuma tarefa longa
terá a oportunidade de ser executada (elas ficam famintas).
Em segundo lugar, usuários inteligentes poderiam programar suas aplicações de maneira a
enganar o escalonador. O truque está em fazer algo que force
o escalonador a conceder mais tempo de CPU. O algoritmo que
foi descrito acima é bastante vulnerável a esse tipo de ataque: antes que a janela de tempo esteja praticamente
acabando, é necessário realizar uma operação de entrada e saída (para qualquer arquivo, não importa qual)
e assim liberar o CPU. Esse comportamento permitirá permanecer na mesma
fila e novamente obter uma maior porcentagem de tempo de CPU. Se feito
corretamente (por exemplo, sendo executado 99% do tempo da janela antes de liberar o CPU),
essa tarefa pode simplesmente monopolizar o processador.
Finalmente, o programa pode mudar seu comportamento ao longo do tempo. Aqueles
que usaram o CPU podem se tornar interativos. Em nosso exemplo, tais
tarefas não receberão o tratamento adequado do escalonador, como teriam outras
(as originais) tarefas interativas.
Pergunta ao público: que tipos de ataques ao escalonador poderiam ser realizados no mundo moderno?
Tentativa 2: Aumento de prioridade
Vamos tentar mudar as regras e ver se conseguimos evitar problemas com
fome. O que poderíamos fazer para garantir que as tarefas relacionadas
ao CPU obtenham seu tempo (mesmo que não seja muito).
Como uma solução simples para o problema, podemos sugerir periodicamente
aumentar a prioridade de todas essas tarefas no sistema. Existem várias maneiras
de alcançar isso, vamos tentar implementar como exemplo algo simples: elevar
imediatamente todas as tarefas à prioridade mais alta, daí a nova regra:
- Regra5: Após um determinado período S, elevar todas as tarefas no sistema à fila mais alta.
Nossa nova regra resolve dois problemas ao mesmo tempo. Em primeiro lugar, os processos
garantidamente não ficam sem recursos: as tarefas que estão na fila de prioridade alta dividirão
o tempo de CPU de acordo com o algoritmo RR, e assim todos os processos receberão
tempo de CPU. Em segundo lugar, se algum processo que anteriormente usava
apenas o CPU se tornar interativo, ele permanecerá na fila com a mais alta
prioridade depois de receber uma elevação de prioridade para o mais alto uma vez.
Vamos considerar um exemplo. Neste cenário, consideramos um processo que utiliza
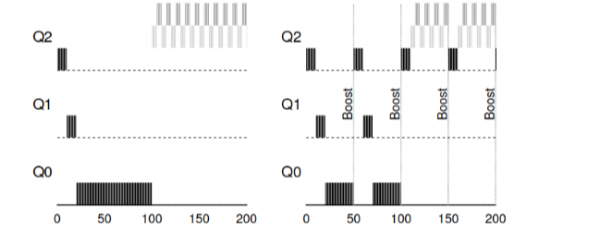
CPU e dois processos interativos curtos. À esquerda, a imagem ilustra o comportamento sem a elevação de prioridade, e assim uma tarefa longa começa a ficar sem recursos após a chegada de dois processos interativos ao sistema. Na imagem à direita, a cada 50ms ocorre uma elevação de prioridade, garantindo que todos os processos recebam tempo de CPU e sejam executados periodicamente. 50ms aqui é apenas um exemplo, na prática esse número é um pouco maior.
É evidente que adicionar um tempo de elevação periódica S leva à
pergunta inevitável: qual deve ser o valor configurado? Um dos respeitados
engenheiros de sistema, John Ousterhout, chamava tais valores em sistemas de constante voo-doo
porque, de certa forma, exigiam um pouco de magia negra para serem ajustados corretamente.
E, infelizmente, S tem esse caráter. Se o valor for configurado muito
alto — tarefas longas começarão a ficar sem recursos. E se for configurado um valor muito baixo,
as tarefas interativas não receberão o devido tempo de CPU.
Tentativa 3: Melhor controle
Agora temos um novo problema que precisa ser resolvido: como não
deixar que nosso escalonador seja enganado? Os culpados por essa possibilidade são
as regras 4a, 4b, que permitem que a tarefa mantenha a prioridade, liberando o CPU
antes da expiração do tempo alocado. Como lidamos com isso?
A solução neste caso pode ser considerada como a melhor contagem do tempo de CPU em cada
nível MLFQ. Em vez de esquecer o tempo que o programa utilizou
o CPU durante um intervalo de tempo designado, deve-se contar e manter esse tempo. Após
o processo ter utilizado seu tempo alocado, deve-se rebaixá-lo para o próximo.
nível de prioridade. Agora não importa como o processo usará seu tempo — seja
constantemente computando no processador ou como uma série de chamadas. Assim,
deve-se reescrever a regra 4 da seguinte forma:
- Regra4: Após a tarefa gastar o tempo alocado na fila atual (independentemente de quantas vezes liberou a CPU), a prioridade dessa tarefa é reduzida (ela desce na fila).
Vamos dar uma olhada no exemplo:
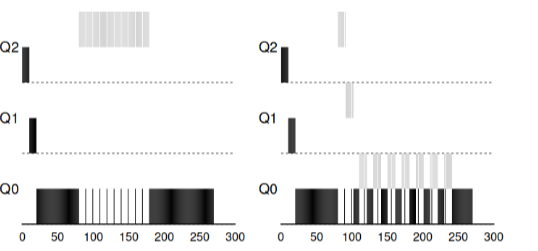 »
A figura mostra o que acontece se tentarmos enganar o escalonador, como
se fosse com as regras anteriores 4a, 4b resultaria no lado esquerdo. Com a nova
regra — o resultado fica à direita. Antes da proteção, qualquer processo poderia chamar I/O até a conclusão e
assim dominar a CPU; após a introdução da proteção, independentemente do comportamento
do I/O, ele ainda assim descerá na fila e, portanto, não poderá apropriar-se desonestamente
dos recursos da CPU.
Melhorando o MLFQ e outros problemas
Com as melhorias mencionadas acima surgem novos problemas: uma das principais
questões é como parametrizar um escalonador desse tipo? Ou seja, quantas devem ser
as filas? Qual deve ser o tamanho da janela de execução do programa dentro da fila? Com que
frequência deve-se aumentar a prioridade do programa para evitar a faminto e
considerar a mudança no comportamento do programa? Não há uma resposta simples para essas perguntas,
e apenas experimentos com cargas e subsequente configuração
do escalonador podem levar a um certo equilíbrio satisfatório.
Por exemplo, a maioria das implementações de MLFQ permite atribuir diferentes
intervalos de tempo a diferentes filas. Filas de alta prioridade geralmente
recebem intervalos curtos. Essas filas consistem em tarefas interativas,
cujo tempo de troca é bastante sensível e deve levar 10 milissegundos ou menos.
Em contrapartida, filas de baixa prioridade consistem em tarefas longas que usam
a CPU. E neste caso, longos intervalos de tempo se encaixam muito bem (100 ms).
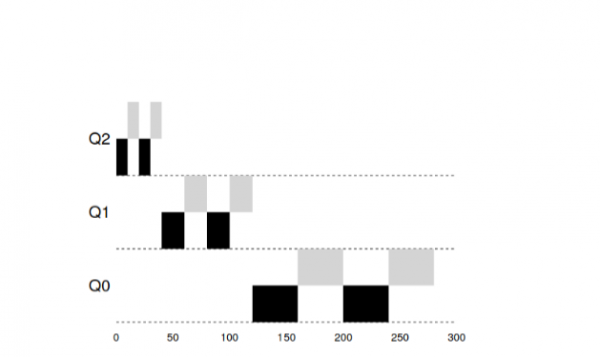
Neste exemplo, há 2 tarefas que trabalharam na fila de alta prioridade por 20
ms, divididas em janelas de 10 ms. 40 ms na fila média (janela de 20 ms) e na fila de baixa prioridade
a janela de tempo tornou-se 40 ms, onde as tarefas completaram seu trabalho.
A implementação do MLFQ no sistema operacional Solaris é uma classe de planejadores que dividem o tempo.
O planejador fornece um conjunto de tabelas que definem exatamente como deve
mudar a prioridade de um processo ao longo de sua vida, qual deve ser o tamanho
da janela alocada e com que frequência as prioridades da tarefa devem ser elevadas. O administrador
do sistema pode interagir com esta tabela e forçar o planejador a se comportar
de maneira diferente. Por padrão, esta tabela tem 60 filas com um aumento gradual do
tamanho da janela de 20ms (alta prioridade) até várias centenas de ms (baixa prioridade), além
de um impulso para todas as tarefas uma vez por segundo.
Outros planejadores MLFQ não utilizam tabelas ou regras específicas
como as descritas nesta aula, ao contrário, eles calculam prioridades usando
fórmulas matemáticas. Por exemplo, o planejador do FreeBSD utiliza uma fórmula para
calcular a prioridade atual da tarefa, com base em quanto o processo
usou a CPU. Além disso, o uso da CPU se deteriora com o tempo, e assim
a elevação de prioridades ocorre de maneira um pouco diferente do que foi descrito. Esses são os
chamados algoritmos de decay. A partir da versão 7.1 do FreeBSD, é utilizado o planejador ULE.
Por fim, muitos planejadores têm outras características. Por exemplo, alguns
planejadores reservam os níveis mais altos para o funcionamento do sistema operacional e, assim, nenhum processo do usuário conseguirá obter a prioridade mais alta no
sistema. Alguns sistemas permitem dar dicas para ajudar
o planejador a definir prioridades corretamente. Por exemplo, com o comando
nice nice
é possível aumentar ou diminuir a prioridade de uma tarefa e, assim, elevar ou
reduzir as chances do programa obter tempo de CPU.
MLFQ: Resumo
Descrevemos uma abordagem de agendamento chamada MLFQ. Seu nome
reflete o princípio de funcionamento — ele possui várias filas e utiliza feedback
para determinar a prioridade da tarefa.
A versão final das regras será a seguinte:
- Regra1: Se a prioridade(A) > Prioridade(B), a tarefa A será executada (B não será)
- Regra2: Se a prioridade(A) = Prioridade(B), A e B são executadas utilizando RR
- Regra3: Quando uma tarefa é inserida no sistema, ela é colocada na fila de maior prioridade.
- Regra4: Após a tarefa gastar o tempo alocado na fila atual (independentemente de quantas vezes liberou a CPU), a prioridade dessa tarefa é reduzida (ela desce na fila).
- Regra5: Após um determinado período S, elevar todas as tarefas no sistema à fila mais alta.
O MLFQ é interessante pela seguinte razão: em vez de exigir conhecimento prévio sobre
a natureza da tarefa, o algoritmo estuda o comportamento passado da tarefa e estabelece
prioridades de acordo. Assim, ele tenta equilibrar o desempenho para tarefas pequenas (SJF, STCF) e executar adequadamente tarefas longas,
que consomem CPU. Por isso, muitos sistemas, incluindo BSD e seus derivados,
Solaris, Windows, Mac, utilizam alguma forma do algoritmo
MLFQ como base do escalonador.
Materiais adicionais:
- (computação)
Fonte: habr.com
