

O banco de dados analítico ClickHouse processa muitas strings diferentes, consumindo recursos. Para acelerar o funcionamento do sistema, novas otimizações estão constantemente sendo adicionadas. O desenvolvedor do ClickHouse, Nikolai Kochetov, fala sobre o tipo de dado string, incluindo um novo tipo, LowCardinality, e explica como é possível acelerar o trabalho com strings.
— Primeiro, vamos entender como podemos armazenar strings.
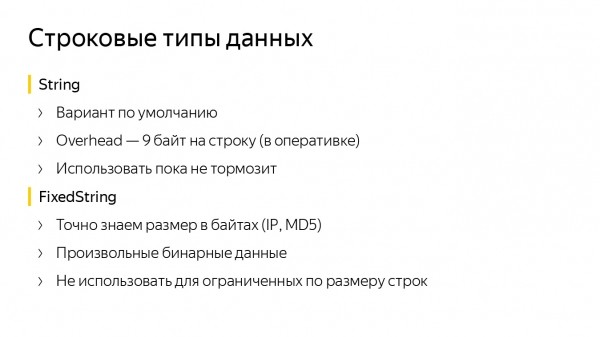
Temos tipos de dados string. String é uma boa opção por padrão, e deve ser usado quase sempre. Ele tem uma sobrecarga pequena — 9 bytes por string. Se quisermos que o tamanho das strings seja fixo e conhecido previamente, é melhor usar FixedString. Com ele, podemos estabelecer o número exato de bytes que precisamos, sendo conveniente para dados como endereços IP ou funções de hash.
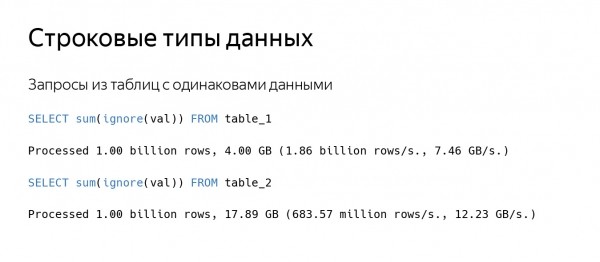
Claro, às vezes algo pode ficar lento. Suponha que você esteja fazendo uma consulta a uma tabela. O ClickHouse lê uma quantidade considerável de dados, digamos, a uma velocidade de 100 GB/s, mas processa poucas strings. Temos duas tabelas que armazenam dados quase idênticos. A partir da segunda tabela, o ClickHouse lê os dados com mais rapidez, mas as strings por segundo lidas são três vezes menores.
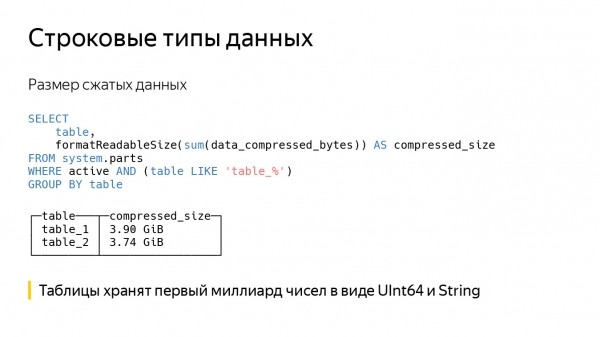
Se olharmos para o tamanho dos dados comprimidos, ele será quase igual. Na verdade, as mesmas informações estão gravadas nas tabelas — o primeiro bilhão de números — apenas que na primeira coluna estão armazenados como UInt64, enquanto na segunda como String. Por causa disso, a segunda consulta leva mais tempo para ler os dados do disco e descompri-los.
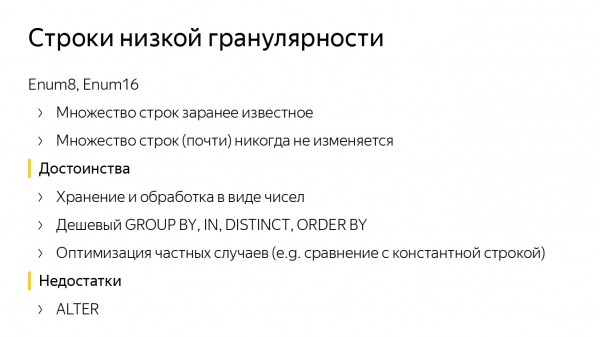
Aqui está outro exemplo. Suponha que exista um conjunto de strings previamente conhecido, que é limitado a uma constante de 1000 ou 10.000 e praticamente nunca muda. Para esse caso, o tipo de dado Enum é apropriado, e no ClickHouse existem dois — Enum8 e Enum16. Graças ao armazenamento em Enum, conseguimos processar consultas rapidamente.
No ClickHouse, existem melhorias para GROUP BY, IN, DISTINCT e otimizações para algumas funções, como a comparação com uma string constante. É claro que números em strings não são convertidos, mas, ao contrário, a string constante é convertida em um valor Enum. Após isso, todas as comparações são feitas rapidamente.
Mas há desvantagens. Mesmo que conheçamos o conjunto exato de strings, às vezes ele precisa ser expandido. Se uma nova string aparecer, precisamos realizar um ALTER.
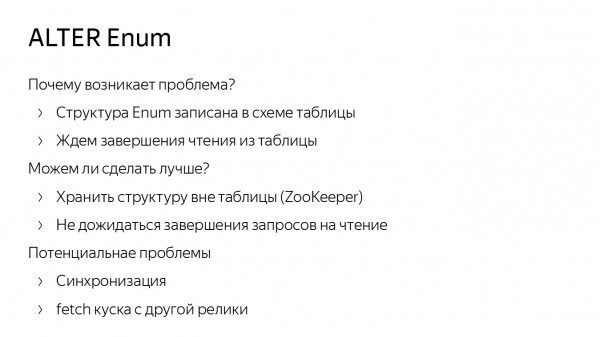
O ALTER para Enum no ClickHouse é implementado de forma otimizada. Não reescrevemos os dados no disco, mas o ALTER pode atrasar devido ao fato de que as estruturas Enum são armazenadas no esquema da própria tabela. Portanto, precisamos esperar as consultas de leitura da tabela, por exemplo.
Surge a questão, é possível fazer melhor? Provavelmente, sim. É possível armazenar a estrutura Enum não no esquema da tabela, mas no ZooKeeper. No entanto, podem surgir problemas relacionados à sincronização. Por exemplo, uma réplica recebeu os dados, a outra não, e se ela tiver um Enum antigo, algo pode quebrar. (No ClickHouse, quase terminamos as consultas ALTER não bloqueantes. Quando terminarmos completamente, não será necessário esperar pelas consultas de leitura.)
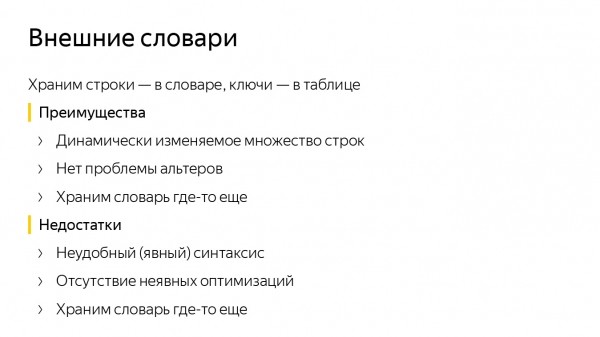
Para evitar complicações com o ALTER Enum, podemos usar dicionários externos do ClickHouse. Lembro que isso é uma estrutura de dados key-value dentro do ClickHouse, através da qual é possível obter dados de fontes externas, como tabelas MySQL.
No dicionário ClickHouse, armazenamos várias strings diferentes, enquanto que na tabela guardamos seus identificadores como números. Se for necessário obter uma string, chamamos a função dictGet e trabalhamos com ela. Depois disso, não precisamos fazer ALTER. Para adicionar algo ao Enum, inserimos isso na mesma tabela MySQL.
Mas surgem outros problemas. Primeiro, a sintaxe pouco conveniente. Se queremos obter uma string, precisamos chamar dictGet. Em segundo lugar, falta de algumas otimizações. Comparar com uma string constante para dicionários não é tão rápido.
Ainda podem haver problemas com atualizações. Suponha que requisitamos uma string no dicionário cache e ela não foi para o cache. Então, precisamos esperar que os dados sejam carregados de uma fonte externa.
Uma desvantagem comum de ambos os métodos é que armazenamos todas as chaves em um só lugar e as sincronizamos. Então, por que não armazenar dicionários localmente? Sem sincronização, sem problemas. Podemos armazenar o dicionário localmente em um pedaço no disco. Ou seja, fizemos um Insert, gravamos o dicionário. Se trabalhamos com dados na memória, podemos gravar o dicionário em um bloco de dados, ou em um pedaço da coluna, ou em algum cache, para acelerar os cálculos.
Codificação de strings em dicionário
Assim, chegamos à criação de um novo tipo de dado no ClickHouse — LowCardinality. Este é um formato de armazenamento de dados: como eles são gravados no disco e lidos, como são representados na memória e o esquema de seu processamento.
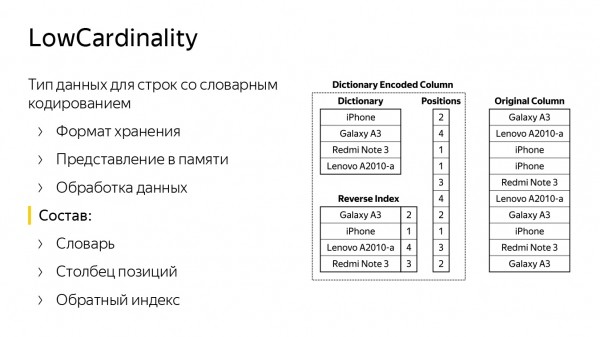
No slide, existem duas colunas. À direita, as linhas são armazenadas de forma padrão, no tipo String. É visível que se tratam de modelos de telefones móveis. À esquerda, há exatamente a mesma coluna, apenas no tipo LowCardinality. Ela consiste em um dicionário com várias strings diferentes (as strings da coluna à direita) e uma lista de posições (números das linhas).
Com essas duas estruturas, podemos recuperar a coluna original. Também existe um índice inverso - uma tabela hash, que ajuda a encontrar a posição no dicionário a partir da string. Isso é necessário para acelerar algumas consultas. Por exemplo, se quisermos comparar, buscar uma string em nossa coluna ou mesclá-las.
LowCardinality é um tipo de dado paramétrico. Ele pode ser um número, ou algo que é armazenado como número, ou uma string, ou Nullable desses.
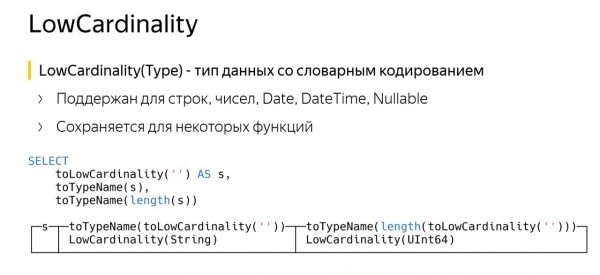
A característica do LowCardinality é que ele pode ser salvo para algumas funções. No slide, podemos ver um exemplo de consulta. Na primeira linha, criei uma coluna do tipo LowCardinality de String, chamada S. Em seguida, perguntei seu nome - o ClickHouse disse que é LowCardinality de String. Tudo certo.
A terceira linha é quase igual, exceto que chamamos a função length. No ClickHouse, a função length retorna o tipo de dado UInt64. Mas agora temos LowCardinality de UInt64. Qual é o sentido?
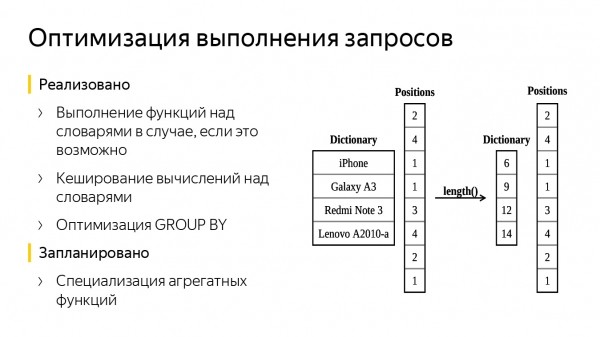
No dicionário estavam os nomes dos telefones móveis, aplicamos a função length. Agora temos um dicionário semelhante, consistindo apenas de números - são os comprimentos das strings. A coluna com posições não se alterou. No final, processamos menos dados, economizamos tempo de consulta.
Podem haver outras otimizações, por exemplo, a adição de um cache simples. Ao calcular o valor de uma função, podemos memorizar e criar o mesmo, sem recalculá-lo.
Também pode ser feita uma otimização de GROUP BY, pois nossa coluna com o dicionário já está parcialmente agregada - podemos calcular mais rapidamente os valores das funções hash e encontrar aproximadamente o bucket onde colocar a próxima linha. Além disso, algumas funções agregadas podem ser especializadas, como uniq, pois para ela só pode ser enviado o dicionário, enquanto as posições permanecem intactas - assim, tudo funcionará mais rápido. As duas primeiras otimizações já foram adicionadas ao ClickHouse.
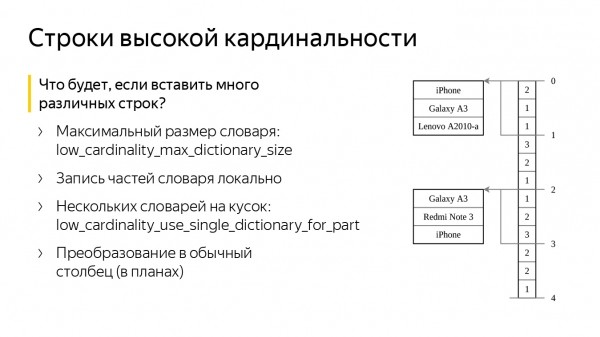
E se criarmos uma coluna com nosso tipo de dados e inserirmos muitas strings ruins diferentes? Nossa memória vai ficar cheia? Não, para isso o ClickHouse tem duas configurações especiais. A primeira é low_cardinality_max_dictionary_size. Este é o tamanho máximo do dicionário que pode ser gravado no disco. A inserção acontece da seguinte forma: quando inserimos dados, recebemos um fluxo de strings das quais formamos um grande dicionário comum. Se o dicionário se torna maior que o valor da configuração, gravamos o dicionário atual no disco, e as outras strings ficam ‘de lado’, próximas aos índices. No final, nunca recalcularemos um grande dicionário e não teremos problemas de memória.
A segunda configuração é chamada low_cardinality_use_single_dictionary_for_part. Imagine que, na esquema anterior, quando inserimos dados, nosso dicionário ficou cheio e o gravamos no disco. Surge a questão, por que não formar outro dicionário exatamente igual agora?
Quando ele ficar cheio, gravaremos novamente no disco e começaremos a formar um terceiro. Essa configuração basicamente desativa essa possibilidade por padrão.
Na verdade, muitos dicionários podem ser úteis se quisermos inserir um conjunto de strings, mas acidentalmente inserimos ‘lixo’. Digamos que primeiro inserimos strings ruins e depois inserimos boas. Assim, o dicionário se dividirá em muitos pequenos dicionários. Alguns deles conterão ‘lixo’, mas os últimos terão boas strings. E se lermos, por exemplo, apenas o último grânulo, tudo vai funcionar rapidamente.
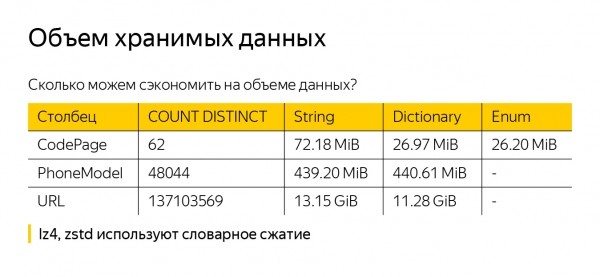
Antes de falar sobre as vantagens do LowCardinality, já aviso que provavelmente não conseguiremos uma redução nos dados no disco (embora isso possa acontecer), porque o ClickHouse comprime dados. Existe uma opção padrão — LZ4. Também é possível fazer compressão com ZSTD. Mas ambos os algoritmos já implementam compressão de dicionário, portanto, nosso dicionário externo do ClickHouse não ajudará muito.
Para não ficar na superficialidade, eu peguei alguns dados da métrica — String, LowCardinality(String) e Enum — e os salvei em diferentes tipos de dados. Surgiram três colunas, onde foi registrado um bilhão de linhas. Na primeira coluna, CodePage, há apenas 62 valores. E é visível que no LowCardinality(String) conseguimos uma compressão melhor. String é um pouco pior, mas isso provavelmente se deve ao fato de que as strings são curtas; armazenamos seus comprimentos, o que ocupa muito espaço e se comprime mal.
Se pegarmos PhoneModel, são 48 mil — já mais, e as diferenças entre String e LowCardinality(String) quase não existem. Para URLs, também economizamos apenas 2 GB — acho que não vale a pena contar com isso.
Avaliação da velocidade de operação
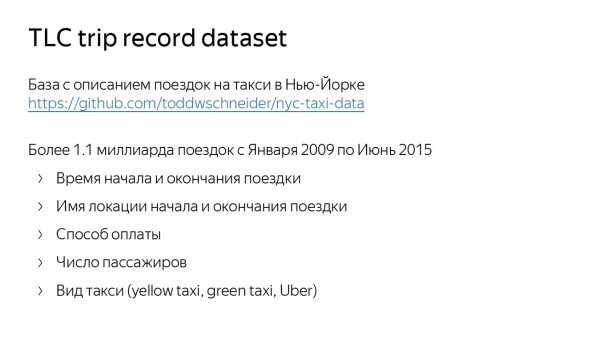
Agora vamos avaliar a velocidade de operação. Para isso, usei um conjunto de dados com a descrição das corridas de táxi em Nova York. Ele está no GitHub. Há pouco mais de um bilhão de corridas. Ele reflete a localização, o horário de início e término da corrida, o método de pagamento, o número de passageiros e até o tipo de táxi — verde, amarelo e Uber.
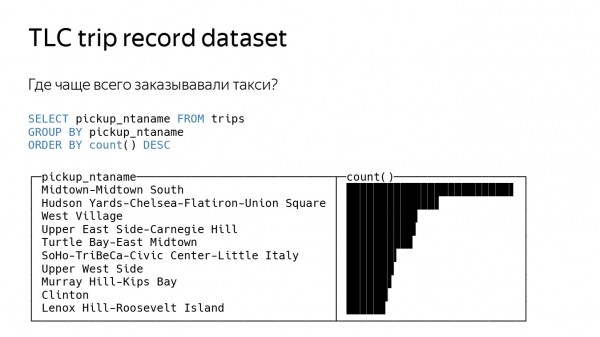
O primeiro pedido que fiz foi bastante simples — perguntei onde as pessoas mais costumam chamar táxi. Para isso, é necessário pegar a localização de onde foram feitas as chamadas, agrupar por essa localização e contar a função count. Aqui o ClickHouse apresenta algo.
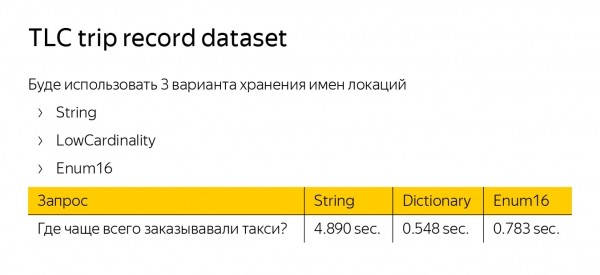
Para medir a velocidade de processamento da consulta, criei três tabelas com os mesmos dados, mas utilizei três tipos de dados diferentes para a nossa localização inicial — String, LowCardinality e Enum. LowCardinality e Enum se mostraram cinco vezes mais rápidos que String. Enum é mais rápido porque trabalha com números. LowCardinality é mais rápido devido à sua otimização para GROUP BY.
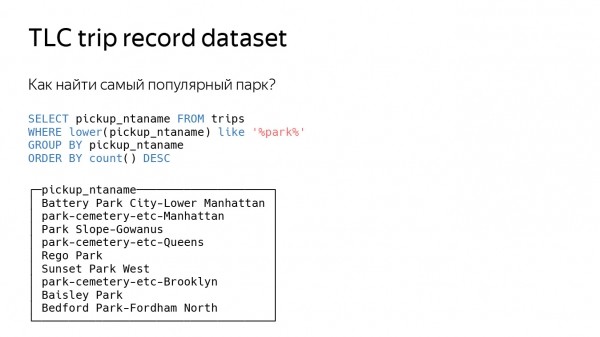
Vamos complicar ainda mais a consulta — vamos perguntar onde fica o parque mais popular em Nova York. Novamente, mediremos isso com base nos locais onde as pessoas mais costumam chamar táxi, mas filtraremos apenas aquelas localizações que contêm a palavra "parque". Também adicionaremos a função like.
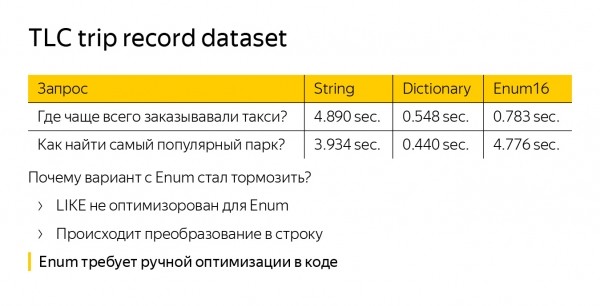
Olhamos para o tempo — vemos que o Enum de repente começou a desacelerar. Além disso, ele está funcionando ainda mais lentamente que o tipo de dado padrão String. Isso acontece porque a função like não é otimizada para Enum. Precisamos converter nossas strings de Enum em strings normais — fazemos mais trabalho. LowCardinality(String) também não é otimizado por padrão, mas a função like funciona sobre o dicionário, portanto a consulta é mais rápida em comparação com String.
Ao trabalhar com Enum, há um problema mais global. Se quisermos otimizá-lo, precisamos fazer isso em cada parte do código. Suponhamos que escrevemos uma nova função — é necessário pensar em uma otimização para o Enum. Já no LowCardinality, tudo é otimizado por padrão.
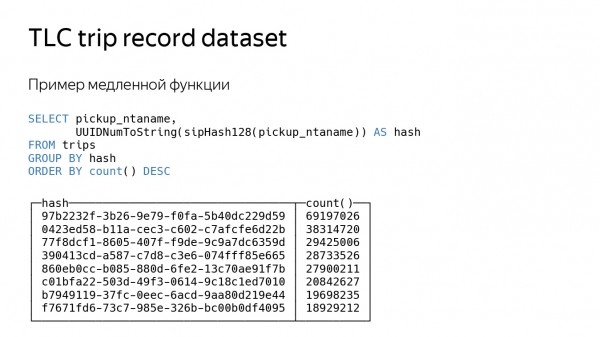
Vamos olhar para a última consulta, um pouco artificial. Vamos simplesmente calcular a função hash da nossa localização. A função hash é uma consulta bastante lenta, leva tempo para ser calculada, portanto, tudo fica mais lento em até três vezes.
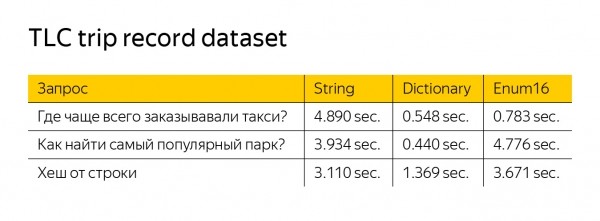
O LowCardinality ainda funciona mais rápido, embora não haja filtragem aqui. Isso ocorre porque nossas funções operam apenas sobre o dicionário. A função de cálculo do hash tem um argumento — ela pode processar menos dados e também pode retornar LowCardinality.
Nosso plano global é alcançar uma velocidade de operação não inferior à do String em qualquer caso e manter as acelerações. E, quem sabe, talvez algum dia substituamos o String pelo LowCardinality, você atualiza o ClickHouse e tudo funcionará um pouco mais rápido.
Fonte: habr.com
