

Como crescer 10 vezes na quantidade de consultas ao banco de dados sem mudar para um servidor mais poderoso e mantendo a funcionalidade do sistema? Vou explicar como lutamos contra a queda de desempenho do nosso banco de dados, como otimizamos as consultas SQL para atender o maior número possível de usuários e não aumentar os custos com recursos computacionais.
Estou desenvolvendo um serviço para gerenciar processos de negócios em empresas de construção. Trabalhamos com cerca de 3.000 empresas. Mais de 10.000 pessoas utilizam nosso sistema todos os dias por 4-10 horas. Ele resolve diversas tarefas de planejamento, notificação, alerta, validação... Usamos PostgreSQL 9.6. Em nosso banco de dados, temos cerca de 300 tabelas e a cada dia recebemos até 200 milhões de consultas (10.000 diferentes). Em média, temos de 3-4 mil consultas por segundo, e nos momentos mais ativos, mais de 10.000 consultas por segundo. A maior parte das consultas é OLAP. Adições, modificações e remoções são muito menores, ou seja, a carga OLTP é relativamente pequena. Todos esses números que citei servem para que você possa avaliar a escala do nosso projeto e entender quão útil nossa experiência pode ser para você.
Cena um. Lírica
Quando começamos o desenvolvimento, não pensamos muito sobre a carga que recairia sobre o banco de dados e o que faríamos se o servidor parasse de suportar. Ao projetar o banco de dados, seguimos as recomendações gerais e tentamos não nos prejudicar, mas não fomos além de conselhos gerais como "não use o padrão ," não exploramos. Projetamos com base nos princípios de normalização, evitando a redundância de dados e não nos preocupamos em acelerar certas consultas. Assim que os primeiros usuários chegaram, nos deparamos com problemas de desempenho. Como de costume, estávamos absolutamente despreparados para isso. Os primeiros problemas eram simples. Geralmente, tudo se resolvia com a adição de um novo índice. Mas chegou um momento em que as soluções simples deixaram de funcionar. Percebendo que nos faltava experiência e que era cada vez mais difícil entender a causa dos problemas, contratamos especialistas que nos ajudaram a configurar corretamente o servidor, ativar o monitoramento e nos mostraram onde olhar para obter .
Cena dois. Estatística
Temos cerca de 10 mil consultas diferentes que são executadas em nosso banco de dados diariamente. Destas 10 mil, existem monstros que são executados de 2 a 3 milhões de vezes, com um tempo médio de execução de 0,1 a 0,3 ms, e há consultas com um tempo médio de execução de 30 segundos, que são chamadas 100 vezes por dia.
Otimizar todas as 10 mil consultas não era viável, então decidimos entender onde direcionar nossos esforços para aumentar a performance do banco de dados corretamente. Após várias iterações, começamos a classificar as consultas por tipos.
CONSULTAS TOP
Estas são as consultas mais pesadas, que consomem mais tempo (tempo total). São consultas que ou são muito frequentemente chamadas ou que demoram muito para serem executadas (consultas longas e frequentes já foram otimizadas nas primeiras iterações de busca por velocidade). No total, o servidor gasta mais tempo na execução dessas consultas. É importante separar as consultas top por tempo total de execução e separadamente por tempo de I/O. As formas de otimização para essas consultas são um pouco diferentes.
A prática comum de todas as empresas é trabalhar com as CONSULTAS TOP. Elas são poucas e a otimização de mesmo uma única consulta pode liberar de 5 a 10% dos recursos. No entanto, à medida que o projeto "amadurece", a otimização das CONSULTAS TOP se torna uma tarefa cada vez mais não trivial. Todos os métodos simples já foram explorados e a consulta mais “pesada” consome “apenas” 3 a 5% dos recursos. Se as consultas TOP, em soma, ocupam menos de 30 a 40% do tempo, é provável que você já tenha se esforçado para que funcionem rapidamente e é hora de passar para a otimização das consultas do próximo grupo.
Resta responder à pergunta de quantas consultas superiores incluir neste grupo. Eu geralmente considero não menos de 10, mas não mais de 20. Procuro garantir que o tempo do primeiro e do último na lista TOP não difira mais do que 10 vezes. Ou seja, se o tempo de execução das consultas cai abruptamente do 1º para o 10º lugar, eu pego o TOP-10; se a queda for mais gradual, aumento o tamanho do grupo para 15 ou 20.
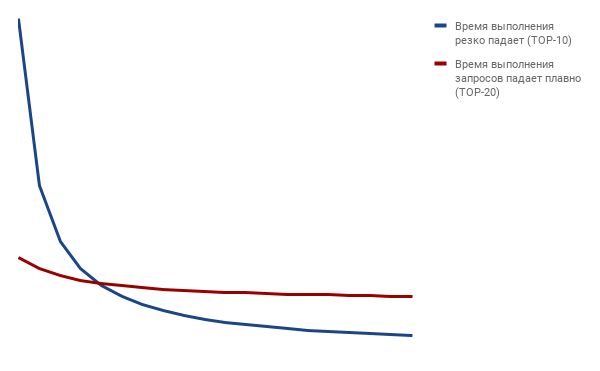
CONSULTAS MÉDIAS
Estas são todas as consultas que vêm imediatamente após as TOP, exceto as últimas 5-10%. Normalmente, a otimização exatamente dessas consultas é onde se encontra a possibilidade de aumentar significativamente a performance do servidor. Essas consultas podem “pesar” até 80%. Mas mesmo que sua participação ultrapasse 50%, é hora de olhá-las com mais atenção.
CAUDA
Como foi mencionado, essas consultas ocorrem no final e consomem de 5 a 10% do tempo. Você pode esquecê-las, a menos que utilize ferramentas automáticas de análise de consultas, pois a otimização também pode sair barata.
Como avaliar cada grupo?
Eu uso uma consulta SQL que ajuda a fazer essa avaliação para PostgreSQL (tenho certeza de que para muitos outros SGBDs é possível escrever uma consulta semelhante).
Consulta SQL para avaliar o tamanho dos grupos TOP-MEDIUM-TAIL
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail) AS sum_tail
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800              THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
O resultado da consulta é três colunas, cada uma contendo a porcentagem do tempo gasto no processamento das consultas desse grupo. Dentro da consulta, há dois números (neste caso, 20 e 800), que separam as consultas de um grupo das do outro.
Assim, aproximadamente, as proporções das consultas no início do trabalho de otimização em comparação com agora.
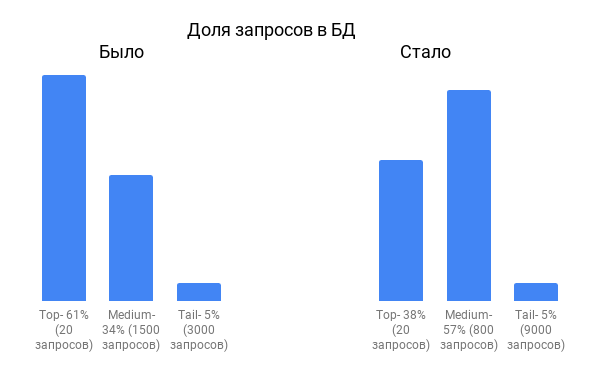
Do gráfico, fica evidente que a participação das consultas TOP diminuiu acentuadamente, enquanto os 'intermediários' cresceram.
Inicialmente, as consultas TOP incluíam erros grosseiros. Com o tempo, as doenças infantis desapareceram, a participação das consultas TOP foi reduzida e esforços cada vez maiores foram necessários para acelerar as consultas mais pesadas.
Para obter o texto das consultas, usamos a seguinte consulta:
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Aqui está uma lista das técnicas mais frequentemente utilizadas que nos ajudaram a acelerar as consultas TOP:
- Redesenho do sistema, por exemplo, reformulação da lógica de notificações usando um message broker em vez de consultas periódicas ao banco de dados.
- Adição ou alteração de índices.
- Reescrita de consultas ORM para SQL puro.
- Reescrita da lógica de carregamento preguiçoso de dados.
- Cache através da desnormalização dos dados. Por exemplo, temos uma relação entre tabelas Entrega -> Fatura -> Consulta -> Solicitação. Ou seja, cada entrega está relacionada a uma solicitação através de outras tabelas. Para não conectar todas as tabelas em cada consulta, duplicamos a referência à solicitação na tabela Entrega.
- O cache de tabelas estáticas com diretórios e tabelas que mudam raramente na memória do programa.
Às vezes, as mudanças levavam a uma reformulação significativa, mas proporcionavam uma redução de 5 a 10% na carga do sistema e eram justificadas. Com o tempo, o retorno diminuía cada vez mais, e a reformulação exigia um esforço maior.
Então, começamos a prestar atenção ao segundo grupo de consultas - o grupo intermediário. Havia muito mais consultas nele e parecia que a análise de todo o grupo levaria muito tempo. No entanto, a maioria das consultas se revelou muito simples para otimização, e muitos problemas se repetiam dezenas de vezes em diferentes variações. Aqui estão exemplos de algumas otimizações típicas que aplicamos a dezenas de consultas semelhantes e cada grupo de consultas otimizadas aliviou o banco de dados em 3-5%.
- Em vez de verificar a existência de registros usando COUNT e fazer uma varredura completa na tabela, começamos a usar EXISTS.
- Eliminamos o DISTINCT (não há uma receita geral, mas às vezes é fácil se livrar dele, acelerando a consulta de 10 a 100 vezes).
Por exemplo, em vez de uma consulta para selecionar todos os motoristas de uma grande tabela de entregas (DELIVERY),
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
fizemos uma consulta em uma tabela relativamente pequena, PERSON.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Embora parecesse que estávamos usando uma subconsulta correlacionada, ela proporcionava um aumento de desempenho de mais de 10 vezes.
- Em muitos casos, até abandonamos o COUNT e
- em vez de
UPPER(s) LIKE JOHN%usamos
s ILIKE "John%"
Cada consulta particular conseguiu ser acelerada de 3 a 1000 vezes. Apesar dos resultados impressionantes, no início parecia não haver sentido na otimização de uma consulta que leva 10 ms, entra na terceira centena de consultas mais pesadas e no tempo total de carga do banco de dados ocupa frações de porcentagem. Mas, aplicando a mesma receita a um grupo de consultas semelhantes, conseguimos recuperar alguns porcentuais. Para não perder tempo revisando manualmente todas as centenas de consultas, escrevemos alguns scripts simples que, usando expressões regulares, encontravam consultas semelhantes. Como resultado, a busca automática por grupos de consultas nos permitiu melhorar ainda mais nosso desempenho com esforço modesto.
No final, já estamos há três anos trabalhando com o mesmo hardware. A carga média diária é de cerca de 30%, chegando a 70% em picos. O número de solicitações e usuários cresceu cerca de 10 vezes. E tudo isso graças ao monitoramento constante desses grupos de solicitações TOP-MEDIUM. Assim que um novo pedido aparece no grupo TOP, o analisamos imediatamente e tentamos acelerá-lo. O grupo MEDIUM é revisado semanalmente com scripts de análise de solicitações. Se surgem novos pedidos que já sabemos como otimizar, fazemos as mudanças rapidamente. Às vezes, encontramos novas maneiras de otimizar que podem ser aplicadas imediatamente a várias solicitações.
De acordo com nossas previsões, o servidor atual suportará um aumento no número de usuários de 3 a 5 vezes. No entanto, temos outra carta na manga - ainda não migramos as consultas SELECT para o espelho, como é recomendado. Mas não estamos fazendo isso intencionalmente, pois queremos primeiro explorar ao máximo as possibilidades de otimização 'inteligente', antes de ativar a 'artilharia pesada'.
Um olhar crítico sobre o trabalho realizado pode sugerir o uso da escalabilidade vertical. Comprar um servidor mais potente em vez de gastar o tempo dos especialistas. Um servidor pode não custar tanto, especialmente considerando que os limites da escalabilidade vertical ainda não foram atingidos. No entanto, o número de solicitações cresceu apenas 10 vezes. Ao longo de alguns anos, a funcionalidade do sistema aumentou e agora existem mais variedades de solicitações. A funcionalidade que existia, graças ao cache, é executada com um menor número de solicitações, além de serem mais eficazes. Portanto, pode-se multiplicar por 5 para obter um verdadeiro fator de aceleração. Assim, com os cálculos mais modestos, pode-se dizer que a aceleração foi de 50 vezes ou mais. Fazer a escalabilidade vertical do servidor em 50 vezes custaria mais. Especialmente considerando que uma otimização realizada uma vez funciona continuamente, enquanto a conta pelo servidor alugado chega todo mês.
Fonte: habr.com
