

Todo grande projeto começou com alguns servidores. Primeiro havia um servidor DB, depois foram adicionados escravos para escalar a leitura. E então — pare! O mestre é único, mas há muitos escravos; se um dos escravos falhar, tudo ficará bem, mas se o mestre falhar — será um problema: tempo de inatividade, administradores se esforçando para levantar o servidor. O que fazer? Reservar o mestre. Meu colega Pavel já escreveu sobre isso. , não vou repetir. Em vez disso, vou contar por que você precisa urgentemente do Orchestrator para MySQL!
Comecemos pela questão principal: "Como iremos alternar o código para a nova máquina quando o mestre falhar?".
- O esquema com VIP (Virtual IP) é o que eu mais gosto, e é sobre isso que falaremos abaixo. É o mais simples e óbvio, embora tenha uma limitação clara: o mestre que vamos reservar deve estar no segmento L2 com a nova máquina, ou seja, esqueça o segundo DC. E, na verdade, se seguirmos a regra de que um grande L2 é um mal, porque L2 é apenas para o rack, e entre os racks é L3, esse esquema tem ainda mais limitações.
- Você pode registrar o nome DNS no código e resolvê-lo através do /etc/hosts. Na verdade, não haverá resolução. A vantagem do esquema: não há a limitação característica do primeiro método, ou seja, podemos organizar até mesmo cross-DC. Mas então surge a questão óbvia, como vamos atualizar rapidamente a mudança em /etc/hosts através do Puppet-Ansible.
- Podemos modificar um pouco o segundo método: em todos os servidores web, instalamos um DNS em cache, pelo qual o código irá consultar a base mestre. Podemos definir TTL 60 para esse registro no DNS. Parece que, se implementado corretamente, é uma boa solução.
- O esquema com descoberta de serviço, que envolve o uso de Consul e etcd.
- Uma opção interessante com . Precisamos redirecionar todo o tráfego para MySQL através do ProxySQL, que sabe determinar quem é o mestre no momento. A propósito, sobre uma das maneiras de usar esse produto, você pode ler em meu .
Autor do Orchestrator, enquanto trabalhava no Github, implementou primeiro o esquema com VIP e depois alterou para o esquema com Consul.
Esquema típico de infraestrutura:
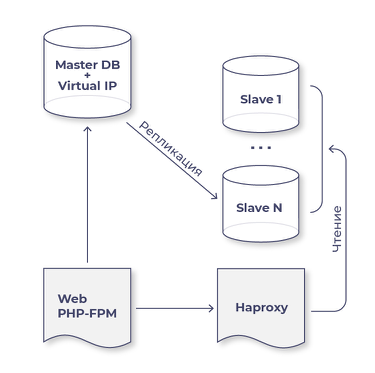
Vou descrever imediatamente as situações óbvias que devem ser consideradas:
- O endereço VIP não deve estar configurado em nenhum dos servidores. Vamos imaginar a situação: o mestre foi reiniciado, e enquanto ele está carregando, o Orchestrator entrou em modo failover e fez um dos escravos o novo mestre; então o antigo mestre foi levantado, e agora o VIP está em duas máquinas. Isso é ruim.
- Para o orquestrador, será necessário escrever um script que se conecte ao mestre antigo e ao novo mestre. No antigo, deve-se executar ifdown, enquanto no novo mestre — ifup vip. Seria bom também incluir neste script que, em caso de failover, a porta no switch do mestre antigo seja simplesmente desativada, para evitar qualquer split-brain.
- Depois que o Orchestrator chamar seu script para primeiro remover o VIP e/ou desativar a porta no switch, e então no novo mestre chamar o script para ativar o VIP, não se esqueça de avisar a todos com o comando arping que o novo VIP está agora aqui.
- Todos os slaves devem ter read_only=1, e assim que você promover um slave a mestre, ele deve ter read_only=0.
- Não se esqueça de que qualquer slave que escolhermos pode se tornar mestre (o Orchestrator tem um mecanismo inteiro de preferência sobre qual slave considerar candidato ao novo mestre em primeiro lugar, qual em segundo, e qual slave não deve ser escolhido como mestre de forma alguma). Se um slave se tornar mestre, ele manterá a carga do slave e terá a carga do mestre adicionada, isso deve ser considerado.
Por que você definitivamente precisa do Orchestrator se não o tem?
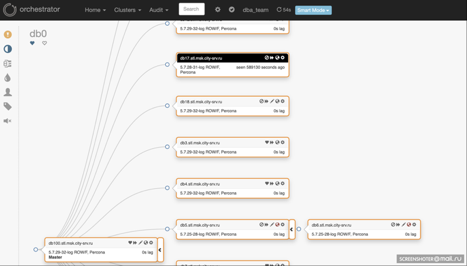
- O Orchestrator tem uma interface gráfica muito conveniente que exibe toda a topologia (veja a captura de tela abaixo).
- O Orchestrator pode monitorar quais slaves estão atrasados e onde a replicação quebrou completamente (temos scripts anexados ao Orchestrator para enviar SMS).
- O Orchestrator informa quais slaves têm erro GTID errant.
Interface do Orchestrator:
O que é GTID errant?
Existem dois requisitos principais para o funcionamento do Orchestrator:
- É necessário que em todas as máquinas do cluster MySQL esteja ativado o pseudo GTID, nós temos GTID ativado.
- É necessário que todos tenham um tipo de binlog, pode ser statement. Tivemos uma configuração em que no mestre e na maioria dos slaves era Row, e em dois historicamente ficou o modo Mixed. Como resultado, o Orchestrator simplesmente não quis conectar esses slaves ao novo mestre.
Lembre-se de que o mais importante em um slave de produção é sua consistência com o mestre! Se tanto no mestre quanto no slave o Global Transaction ID (GTID) estiver ativado, então através da função gtid_subset é possível verificar se realmente as mesmas solicitações de modificação de dados foram executadas nessas máquinas. Você pode ler mais sobre isso. .
Assim, o Orchestrator mostra a você através do erro GTID errante que existem transações no slave que não estão no master. Por que isso acontece?
- O read_only=1 não está ativado no slave, alguém se conectou e executou uma solicitação para alterar dados.
- O super_read_only=1 não está ativado no slave, então o administrador, confundindo o servidor, acessou e executou uma solicitação lá.
- Se você levou em conta os dois pontos anteriores, há um truque adicional: na MySQL, a solicitação de flush dos binlogs também é registrada no binlog, portanto, ao primeiro flush no master e em todos os slaves, aparecerá o GTID errante. Como evitar isso? Na versão perona-5.7.25-28, foi adicionada a configuração binlog_skip_flush_commands=1, que proíbe a gravação de flush nos binlogs. Há um registro no site mysql.com. .
Resumindo tudo o que foi dito. Se você ainda não deseja usar o Orchestrator no modo failover, defina-o no modo de monitoramento. Assim, você sempre terá em vista um mapa de interação das máquinas MySQL e informações visuais sobre que tipo de replicação há em cada máquina, se os slaves estão atrasados e, o mais importante, quão consistentes eles estão com o master!
Uma pergunta óbvia: "Como o Orchestrator deve funcionar?" Ele deve escolher um novo master entre os atuais slaves e, em seguida, reconectar todos os slaves a ele (é para isso que o GTID é necessário; se usar o mecanismo antigo com binlog_name e binlog_pos, a mudança do slave do master atual para o novo simplesmente não é possível!). Antes de termos o Orchestrator, uma vez tive que fazer tudo isso manualmente. O master antigo travou devido a um controlador Adaptec com defeito, e havia cerca de 10 slaves. Eu precisava transferir o VIP do master para um dos slaves e reconectar todos os outros slaves a ele. Quantos consoles eu tive que abrir, quantos comandos simultâneos tive que digitar… Tive que esperar até às 3 da manhã, descarregar a carga de todos os slaves, exceto dois, fazer da primeira máquina uma master, conectar imediatamente a segunda máquina a ela, em seguida, conectar todos os outros slaves ao novo master e devolver a carga. Em resumo, um horror…
Como o Orchestrator funciona ao entrar no modo failover? É mais fácil demonstrar com um exemplo de situação em que queremos tornar uma máquina mais poderosa e moderna o master em vez da que está atualmente.
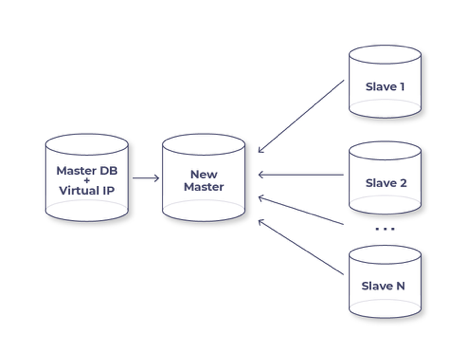
A imagem mostra o meio do processo. O que já foi feito até este momento? Nós dissemos que queríamos fazer um determinado slave se tornar o novo master, o Orchestrator começou simplesmente a reconectar todos os outros slaves a ele, enquanto o novo master atua como uma máquina de trânsito. Com esse esquema, não ocorrem erros, todos os slaves funcionam, o Orchestrator retira o VIP do antigo master, transfere para o novo, define read_only=0 e esquece do antigo master. Isso! O downtime do nosso serviço é o tempo de transferência do VIP, que leva de 2 a 3 segundos.
Por hoje é isso, muito obrigado a todos. Em breve haverá um segundo artigo sobre o Orchestrator. Em um famoso filme soviético chamado "Garagem", um personagem disse: "Eu não iria com ele para a missão de reconhecimento!" Então, Orchestrator, eu iria com você para a missão de reconhecimento!
Fonte: habr.com
