

Na Sitimobil, usamos o banco de dados MySQL como nosso principal repositório de dados persistentes. Temos vários clusters de banco de dados para diferentes serviços e finalidades.
A disponibilidade contínua do mestre é um indicador crítico de desempenho de todo o sistema e suas partes individuais. A recuperação automática do cluster em caso de falha do mestre reduz significativamente o tempo de resposta a incidentes e o tempo de inatividade do sistema. Neste artigo, abordarei o esquema de alta disponibilidade (HA) do cluster MySQL com base em e endereços IP virtuais (VIP).
Solução de HA baseada em VIP
Primeiro, falarei brevemente sobre o que é o nosso sistema de armazenamento de dados.
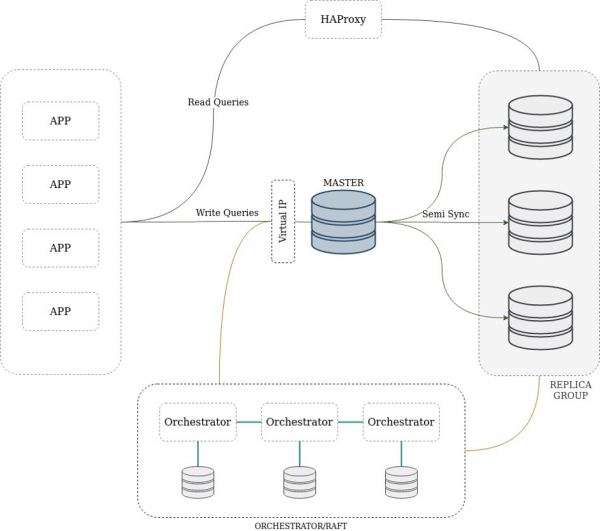
Usamos um esquema clássico de replicação com um único mestre disponível para gravação e várias réplicas que são usadas apenas para leitura. O cluster pode conter um mestre intermediário — um nó que é simultaneamente uma réplica e um mestre para outros. Os clientes acessam as réplicas através do HAProxy, o que permite distribuir a carga uniformemente e escalar facilmente. O uso do HAProxy é devido a razões históricas, e agora estamos em processo de migração para ProxySQL.
A replicação é realizada em modo semissíncrono com base em GTID. Isso significa que pelo menos uma réplica deve gravar a transação no log antes que ela seja considerada bem-sucedida. Esse modo de replicação garante um equilíbrio otimizado entre desempenho e integridade dos dados em caso de falha do nó principal. Na maioria das vezes, todas as alterações são transmitidas do mestre para as réplicas por meio de Row Based Replication (RBR), mas alguns nós podem ter mixed binlog format.
O Orchestrador atualiza periodicamente o estado da topologia do cluster, analisa as informações recebidas e, em caso de problemas, pode iniciar o processo de recuperação automática. O próprio processo é responsabilidade do desenvolvedor, uma vez que pode ser implementado de várias maneiras: com base em VIP, DNS, utilizando serviços de descoberta (service discovery) ou mecanismos feitos sob medida.
Uma das maneiras simples de recuperar o mestre em caso de falha é utilizar endereços VIP flutuantes.
O que você precisa saber sobre esta solução antes de prosseguir:
- VIP é um endereço IP que não está vinculado a uma interface de rede física específica. Quando um nó falha ou durante manutenções programadas, podemos transferir o VIP para outro recurso com tempo de inatividade mínimo.
- Liberar e fornecer um endereço IP virtual são operações baratas e rápidas.
- Para trabalhar com VIP, é necessário ter acesso ao servidor via SSH ou usar utilitários especiais, como
keepalived.
Vamos considerar os possíveis problemas com nosso mestre e mostrar como o mecanismo de recuperação automática deve funcionar.
A conectividade de rede com o mestre está perdida, ou houve um problema no nível de hardware e o servidor está indisponível.
- O orquestrador atualiza a topologia do cluster, cada réplica informa sobre a indisponibilidade do mestre. O orquestrador inicia o processo de eleição de uma réplica adequada para assumir o papel de novo mestre e começa a recuperação.
- Tentamos remover o VIP do antigo mestre — sem sucesso.
- A réplica muda para o papel de mestre. A topologia é reconstruída.
- Adicionamos uma nova interface de rede com VIP. Como não foi possível remover o VIP, em segundo plano iniciamos o envio periódico de solicitações gratuitous ARP. Este tipo de solicitação/resposta permite atualizar a tabela de correspondência de endereços IP e MAC nos switches conectados, notificando assim sobre a mudança do nosso VIP. Isso minimiza a probabilidade de
split brainao reverter para o antigo mestre. - Todas as novas conexões são imediatamente redirecionadas para o novo mestre. Conexões antigas falham, e são feitas novas tentativas ao banco de dados no nível do aplicativo.
O servidor está funcionando normalmente, houve uma falha no nível do SGBD.
O algoritmo é semelhante ao caso anterior: atualização da topologia e início do processo de recuperação. Como o servidor está acessível, liberamos com sucesso o VIP do antigo mestre, transferimos para o novo e enviamos várias solicitações ARP. Um possível retorno do antigo mestre não deve afetar o cluster reestruturado e o funcionamento do aplicativo.
Outros problemas
Falha de réplicas ou mestres intermediários não leva a ações automáticas e requer intervenção manual.
A interface de rede virtual é sempre adicionada temporariamente, ou seja, após a reinicialização do servidor, o VIP não é atribuído automaticamente. Cada instância do banco de dados inicia por padrão no modo somente leitura, e o orquestrador muda automaticamente o novo mestre para gravação e tenta estabelecer somente leitura no antigo mestre. Essas ações visam reduzir a probabilidade split brain.
Durante o processo de recuperação, podem surgir problemas que também devem ser notificados através da interface do usuário do orquestrador, além dos métodos de monitoramento padrão. Expandimos a REST API, adicionando essa possibilidade ( está atualmente em revisão).
O esquema geral da solução HA é apresentado abaixo.
Escolhendo um novo mestre
O orquestrador é suficientemente inteligente e tenta escolher como o novo mestre com base nos seguintes critérios:
- atraso da réplica em relação ao mestre;
- versão do MySQL do mestre e da réplica;
- tipo de replicação (RBR, SBR ou mixed);
- localização em um ou diferentes data centers;
- a existência
GTID problemático— transações que foram executadas na réplica e estão ausentes no mestre; - também são considerados regras de seleção do usuário.
Nem toda réplica é um candidato ideal para o papel de mestre. Por exemplo, a réplica pode ser usada para backup de dados ou o servidor pode ter uma configuração de hardware mais fraca. O orquestrador regras manuais, através das quais você pode personalizar suas preferências para a escolha do candidato, desde os mais preferenciais até os ignorados.
Tempo de resposta e recuperação
No caso de um incidente, é importante minimizar o tempo de inatividade do sistema, portanto, vamos considerar os parâmetros do MySQL que afetam a construção e atualização da topologia do cluster pelo orquestrador:
- — número de segundos que a réplica espera pela chegada de novos dados ou um sinal heartbeat do mestre, antes que a conexão seja considerada perdida e uma reconexão seja realizada. Quanto menor o valor, mais rápido a réplica poderá determinar que a conexão com o mestre foi interrompida. Definimos esse valor como 5 segundos.
- — o número de segundos entre as tentativas de reconexão. Em caso de problemas de rede, um valor baixo para esse parâmetro permitirá uma rápida reconexão e evitará o início do processo de recuperação do cluster. O valor recomendado é de 1 segundo.
MASTER_RETRY_COUNT— o número máximo de tentativas de reconexão.MASTER_HEARTBEAT_PERIOD— o intervalo em segundos após o qual o mestre envia um sinal de heartbeat. Por padrão, é igual à metade do valorslave_net_timeout.
Parâmetros do orquestrador:
DelayMasterPromotionIfSQLThreadNotUpToDate— se igual averdadeiro, o papel de mestre não será aplicado ao replicador candidato até que o fluxo SQL do replicador tenha processado todas as transações não aplicadas do Relay Log. Usamos essa opção para evitar a perda de transações em condições de atrasos de todos os replicadores candidatos.InstancePollSeconds— a frequência de construção e atualização da topologia.RecoveryPollSeconds— a frequência de análise da topologia. Ao detectar um problema, a recuperação da topologia é iniciada. Essa, igual a 1 segundo.
Cada nó do cluster é consultado pelo orquestrador uma vez a cada InstancePollSeconds segundos. Ao detectar um problema, o estado do cluster é forçosamente, e então uma decisão final é tomada sobre a execução da recuperação. Ao experimentar vários parâmetros de DB e do orquestrador, conseguimos reduzir o tempo de resposta e recuperação para 30 segundos.
Bancada de Testes
Começamos o teste do esquema de HA com o desenvolvimento de uma e posterior implementação em ambientes de teste e produção. A banda local é totalmente automatizada com base em Docker e permite experimentar com a configuração do orquestrador e da rede, escalar o cluster de 2-3 servidores para várias dezenas e realizar simulações em um ambiente seguro.
Durante os exercícios, escolhemos um dos métodos de simulação de problemas: eliminar rapidamente o mestre usando kill -9, encerrar o processo suavemente e parar o servidor (docker-compose stop), simular problemas de rede usando iptables -j REJECT ou iptables -j DROP. Esperamos os seguintes resultados:
- o orquestrador detectará problemas com o mestre e atualizará a topologia em no máximo 10 segundos;
- o processo de recuperação será iniciado automaticamente: a configuração de rede será alterada, o papel de mestre será transferido para o replicador, e a topologia será reconstruída;
- o novo mestre estará disponível para gravação, as réplicas ao vivo não serão perdidas durante o processo de reconstrução;
- os dados começarão a ser gravados no novo mestre e replicados;
- o tempo total de recuperação não excederá 30 segundos.
Como você sabe, o sistema pode se comportar de maneira diferente em ambientes de teste e produção devido à configuração diferente do hardware e da rede, diferenças na carga sintética e real, etc. Por isso, periodicamente realizamos exercícios em condições reais, verificando como o sistema se comporta em caso de perda de conectividade de rede ou degradação de suas partes. No futuro, queremos construir uma infraestrutura completamente idêntica para ambos os ambientes e automatizar seus testes.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
A funcionalidade do nó principal do sistema de armazenamento de dados é uma das principais tarefas da equipe SRE e de operação. A implementação de um orquestrador e de uma solução de HA baseada em VIP permitiu alcançar os seguintes resultados:
- detecção confiável de problemas de topologia do cluster de BD;
- resposta automática e rápida a incidentes relacionados ao mestre, o que reduz o tempo de inatividade do sistema.
No entanto, a solução tem suas limitações e desvantagens:
- a escalabilidade do esquema de HA para vários data centers exigirá a existência de uma rede L2 unificada entre eles;
- antes de atribuir VIP ao novo mestre, precisamos liberá-lo no antigo. O processo é sequencial, o que aumenta o tempo de recuperação;
- liberar VIP requer acesso SSH ao servidor, ou qualquer outro meio de invocar procedimentos remotos. Como o servidor ou o BD está enfrentando problemas que acionaram o processo de recuperação, não podemos ter certeza de que a remoção do VIP será bem-sucedida. Isso pode levar à ocorrência de dois servidores com o mesmo endereço IP virtual e a um problema
split brain.
Para evitar split brain, pode-se usar o método ('Shoot The Other Node In The Head'), que isola ou desliga completamente o nó problemático. Existem outros métodos para implementar alta disponibilidade no cluster: combinação de VIP e DNS, descoberta de serviços e serviços proxy, replicação síncrona e outros métodos, que têm suas desvantagens e vantagens.
Falei sobre nossa abordagem para criar um cluster MySQL tolerante a falhas. É simples de implementar e proporciona um nível aceitável de confiabilidade nas condições atuais. À medida que todo o sistema como um todo e a infraestrutura em particular evoluírem, essa abordagem certamente também evoluirá.
Fonte: habr.com
