

Convido você a conferir a transcrição da palestra de Alexey Lesovskiy da Data Egret "Fundamentos do monitoramento PostgreSQL"
Nesta palestra, Alexey Lesovskiy discutirá os pontos-chave da estatística do PostgreSQL, o que eles significam e por que devem estar presentes no monitoramento; quais gráficos devem ser incluídos no monitoramento, como adicioná-los e como interpretá-los. A palestra será útil para administradores de banco de dados, administradores de sistemas e desenvolvedores que estão interessados na solução de problemas do PostgreSQL.
Meu nome é Alexey Lesovskiy, represento a empresa Data Egret.
Um pouco sobre mim. Eu comecei, há muito tempo atrás, como administrador de sistemas.
Administrei várias distribuições Linux, envolvi-me em diversas atividades relacionadas ao Linux, ou seja, virtualização, monitoramento, trabalhei com proxies etc. Mas em determinado momento, comecei a me dedicar mais a bancos de dados, especificamente ao PostgreSQL. Eu gostei muito disso. E em algum momento, passei a trabalhar com PostgreSQL a maior parte do meu tempo. Gradualmente, me tornei um DBA de PostgreSQL.
E ao longo de toda a minha carreira, sempre tive interesse em temas como estatística, monitoramento e coleta de telemetria. Quando era administrador de sistemas, me envolvi intensamente com o Zabbix. E escrevi um pequeno conjunto de scripts como . Ele foi bastante popular na sua época. E lá era possível monitorar diversas coisas importantes, não apenas Linux, mas também vários outros componentes.
Atualmente, estou focado no PostgreSQL. Estou escrevendo outra ferramenta que permite trabalhar com estatísticas do PostgreSQL. Ela se chama (artigo no Habré — ).
Uma breve introdução. Quais são as situações que nossos clientes enfrentam? Acontece algum tipo de falha relacionada ao banco de dados. E quando o banco de dados é recuperado, o chefe do departamento ou o gerente de desenvolvimento diz: "Pessoal, precisamos monitorar o banco de dados, porque algo ruim aconteceu e precisamos evitar que isso ocorra novamente no futuro". E aqui começa um interessante processo de escolha de um sistema de monitoramento ou a adaptação de um sistema de monitoramento existente para que possamos monitorar nosso banco de dados – PostgreSQL, MySQL ou outros. E os colegas começam a sugerir: "Ouvi dizer que existe tal banco de dados. Vamos usá-lo". Os colegas começam a discutir entre si. E, no final, acabamos escolhendo algum banco de dados, mas o monitoramento do PostgreSQL nele é bastante fraco e sempre precisamos ajustar algo. Precisamos pegar alguns repositórios do GitHub, cloná-los, adaptar scripts, reconfigurar de alguma forma. E, no final, isso se torna uma tarefa manual.
Portanto, nesta apresentação, tentarei fornecer a vocês alguns conhecimentos sobre como escolher monitoramento não apenas para PostgreSQL, mas também para bancos de dados em geral. E fornecer o conhecimento que permitirá que vocês aprimorem seu monitoramento, a fim de obter alguma utilidade com isso, permitindo monitorar seu banco de dados de maneira eficaz, prevenindo possíveis situações de falha que possam surgir.
As ideias que serão apresentadas nesta palestra podem ser diretamente adaptadas a qualquer banco de dados, seja um SGBD ou noSQL. Portanto, não se trata apenas de PostgreSQL, mas haverá muitas dicas sobre como fazer isso no PostgreSQL. Haverá exemplos de consultas, exemplos de entidades existentes no PostgreSQL para monitoramento. E se seu SGBD tiver elementos semelhantes que permitam integrá-los no monitoramento, você também pode adaptá-los, adicioná-los e ficará ótimo.
 Na apresentação, não irei
falar sobre como coletar e armazenar métricas. Não falarei sobre pós-processamento de dados e sua apresentação ao usuário. E não falarei sobre alertas.
Mas ao longo da narrativa, eu vou mostrar várias capturas de tela de monitoramentos existentes, e irei criticá-los de alguma forma. Contudo, tentarei não mencionar marcas para evitar promover ou desconvidar esses produtos. Portanto, todas as coincidências são aleatórias e ficam à sua imaginação.
Para começar, vamos entender o que é monitoramento. Monitoramento é uma coisa muito importante que precisamos ter. Todos sabem disso. Mas, ao mesmo tempo, o monitoramento não é um produto comercial e não afeta diretamente o lucro da empresa, por isso, geralmente, o monitoramento recebe atenção apenas como um recurso secundário. Se tivermos tempo, fazemos monitoramento; se não tivermos, tudo bem, colocamos no backlog e voltamos a essas tarefas mais tarde.
Portanto, pela nossa experiência, quando chegamos aos clientes, o monitoramento muitas vezes não está bem desenvolvido e carece de funcionalidades interessantes que nos ajudariam a trabalhar melhor com o banco de dados. Por isso, o monitoramento sempre precisa ser aprimorado.
Os bancos de dados são sistemas complexos que também precisam ser monitorados, porque eles são depósitos de informações. E a informação é muito importante para a empresa, não pode ser perdida de forma alguma. Mas, ao mesmo tempo, os bancos de dados são pedaços muito complexos de software. Eles consistem em muitos componentes. E muitos desses componentes precisam ser monitorados.
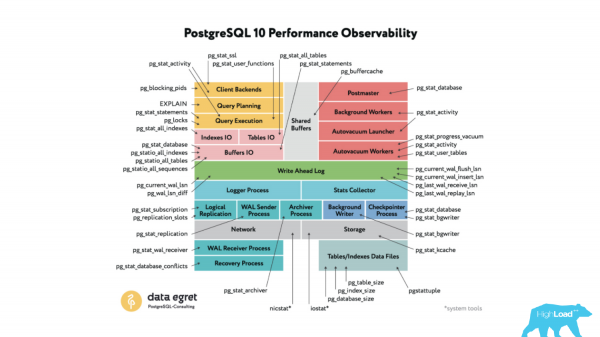 Se falamos especificamente sobre o PostgreSQL, ele pode ser representado como um esquema que consiste em muitos componentes. Esses componentes interagem entre si. E, ao mesmo tempo, no PostgreSQL existe uma subsistema chamada Stats Collector, que permite coletar estatísticas sobre o funcionamento desses subsistemas e fornecer uma interface para o administrador ou usuário, para que ele possa visualizar essas estatísticas.
Essas estatísticas são apresentadas na forma de um conjunto de funções e visões (view). Elas também podem ser chamadas de tabelas. Ou seja, com um cliente psql comum, você pode se conectar ao banco de dados, fazer um select nessas funções e visões, e obter alguns números concretos sobre o funcionamento dos subsistemas do PostgreSQL.
Você pode adicionar esses números ao seu sistema de monitoramento favorito, criar gráficos, adicionar funções e obter análises a longo prazo.
Mas neste relatório, não vou abordar todas essas funções, porque isso poderia levar um dia inteiro. Vou me limitar a duas, três ou quatro coisas e irei explicar como elas ajudam a melhorar a monitoração.
E quando se fala em monitorar um banco de dados, o que precisa ser monitorado? Primeiramente, é crucial monitorar a disponibilidade, pois o banco é um serviço que fornece acesso a dados aos clientes, e precisamos monitorar a disponibilidade, bem como algumas características qualitativas e quantitativas.
Também é necessário monitorar os clientes que se conectam ao nosso banco, pois eles podem ser tanto clientes normais quanto clientes maliciosos que podem prejudicar o banco de dados. É importante monitorá-los e acompanhar suas atividades.
Quando os clientes se conectam ao banco de dados, é evidente que começam a trabalhar com nossos dados, portanto, precisamos monitorar também como os clientes interagem com os dados: com quais tabelas, e em menor grau, com quais índices. Ou seja, precisamos avaliar a carga de trabalho (workload) que nossos clientes geram.
Mas a carga de trabalho também é composta, claro, por consultas. Aplicativos se conectam ao banco e acessam dados por meio de consultas, por isso é importante avaliar quais consultas temos em nosso banco de dados, acompanhar sua adequação, garantir que não estejam mal formuladas, e que algumas opções precisem ser reescritas para funcionar mais rapidamente e com melhor desempenho.
E já que falamos sobre bancos de dados, eles são sempre acompanhados de processos em segundo plano. Os processos em segundo plano permitem que o desempenho do banco de dados se mantenha em um bom nível, portanto, para seu funcionamento, eles exigem uma certa quantidade de recursos. Ao mesmo tempo, podem competir com os recursos das solicitações dos clientes, por isso, um consumo excessivo de recursos pelos processos em segundo plano pode impactar diretamente o desempenho das solicitações dos clientes. Assim, também é necessário monitorá-los e garantir que não haja desequilíbrios em relação aos processos em segundo plano.
E isso tudo no plano de monitoramento de banco de dados permanece na métrica do sistema. Mas considerando que, na maior parte do tempo, toda a nossa infraestrutura está indo para a nuvem, as métricas do sistema de um host específico sempre ficam em segundo plano. No entanto, nos bancos de dados, elas ainda são relevantes e monitorar as métricas do sistema, é claro, também é necessário.
Com as métricas do sistema mais ou menos tudo vai bem, todos os sistemas modernos de monitoramento já suportam essas métricas, mas, no geral, ainda faltam alguns componentes e precisamos adicionar algumas coisas. Sobre isso, também falarei, haverá alguns slides sobre eles.
O primeiro ponto do plano é a disponibilidade. O que é disponibilidade? Disponibilidade, na minha compreensão, é a capacidade do banco de atender conexões, ou seja, o banco está ativo, ele, como um serviço, aceita conexões de clientes. E essa disponibilidade pode ser avaliada por algumas características. Essas características são muito convenientes de serem exibidas nos painéis de controle.
Todos sabem o que são painéis de controle. É quando você dá uma olhada na tela onde as informações necessárias estão resumidas. E você já pode imediatamente determinar se há um problema no banco ou não.
Portanto, a disponibilidade do banco de dados e outras características-chave sempre precisam ser exibidas nos painéis de controle, para que essa informação esteja à mão, sempre ao seu lado. Alguns detalhes adicionais, que ajudam na investigação de incidentes ou em situações de emergência, devem ser exibidos em painéis secundários ou escondidos em links de drilldown, que levam a sistemas de monitoramento externos.
Um exemplo de um conhecido sistema de monitoramento. É um sistema de monitoramento muito bom. Ele coleta muitos dados, mas, na minha opinião, ele tem uma noção estranha de painéis de controle. Há um link "criar painel de controle". Mas quando você cria um painel, você cria uma lista, composta por duas colunas, uma lista de gráficos. E quando você precisa ver algo, você começa a clicar com o mouse, rolar, procurar o gráfico necessário. E isso leva tempo, ou seja, não há painéis de controle propriamente ditos. Há apenas listas de gráficos.
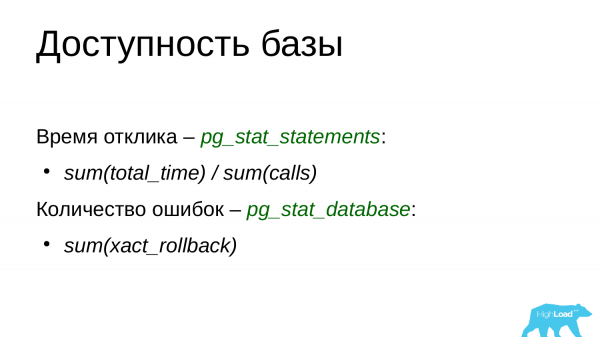
O que deve ser adicionado nesses painéis? Podemos começar com uma métrica como o tempo de resposta. No PostgreSQL, existe a view pg_stat_statements. Por padrão, ela está desativada, mas é uma das views do sistema mais importantes que devem sempre ser ativadas e utilizadas. Ela armazena informações sobre todas as consultas executadas que foram realizadas no banco de dados.
Consequentemente, podemos nos basear no tempo total de execução de todas as consultas e dividi-lo pelo número de consultas utilizando os campos mencionados. Mas isso é apenas uma média geral. Podemos considerar outros campos – o tempo mínimo de execução das consultas, máximo e a mediana. E até mesmo podemos construir percentis, já que o PostgreSQL possui funções correspondentes para isso. Assim, podemos obter números que caracterizam o tempo de resposta do nosso banco de dados com base nas consultas já executadas, ou seja, não estamos executando uma consulta fictícia 'select 1' para observar o tempo de resposta, mas analisamos os tempos de resposta das consultas já executadas e apresentamos isso como um único número ou construímos um gráfico com base nos dados.
Também é importante monitorar a quantidade de erros que o sistema está gerando no momento. Para isso, podemos usar a view pg_stat_database. Nós nos baseamos no campo xact_rollback. Esse campo mostra não apenas o número de rollbacks que ocorrem no banco, mas também contabiliza a quantidade de erros. Em outras palavras, podemos exibir esse número no nosso painel e monitorar quantos erros temos no momento. Se houver muitos erros, esse é um bom motivo para verificar os logs e ver que tipo de erros são esses e por que estão ocorrendo, e depois investigar e resolvê-los.
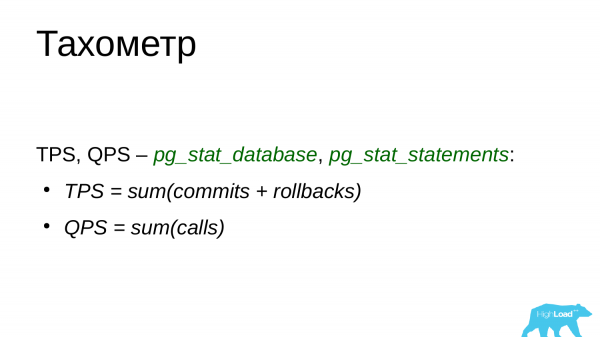
Pode-se adicionar algo como um Tacômetro. Isso é o número de transações por segundo e a quantidade de consultas por segundo. Em outras palavras, você pode usar esses números como um indicador de desempenho atual do seu banco de dados e observar se há picos de consultas, picos de transações ou, ao contrário, se o banco não está sobrecarregado, porque algum backend falhou. Esse número é algo que deve ser sempre monitorado, e lembrar que para o nosso projeto, esse desempenho é considerado normal, enquanto valores acima ou abaixo já são problemáticos e desconhecidos, e, portanto, é necessário investigar por que esses números estão assim.
Para avaliar o número de transações, podemos novamente nos referir à visão pg_stat_database. Podemos somar o número de commits e o número de rollbacks e obter o número de transações por segundo.
Todos entendem que várias consultas podem estar incluídas em uma única transação? Por isso, TPS e QPS são um pouco diferentes.
O número de consultas por segundo pode ser obtido pelo pg_stat_statements e basta calcular a soma de todas as consultas executadas. É claro que comparamos o valor atual com o anterior, subtraímos, obtemos a delta e chegamos à quantidade.
Podemos adicionar métricas adicionais conforme desejado, que também ajudam a avaliar a disponibilidade do nosso banco e monitorar se houve algum tempo de inatividade.
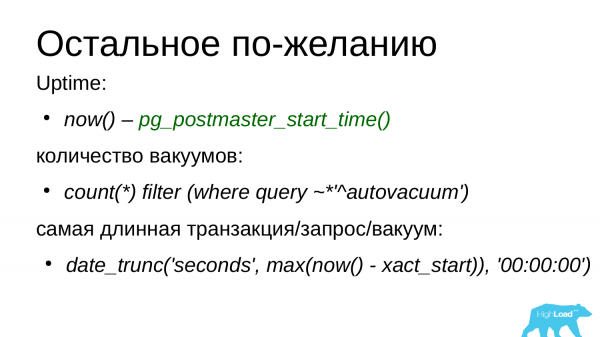
Uma dessas métricas é o uptime. Mas o uptime no PostgreSQL é uma coisa um pouco complicada. Vou explicar por quê. Quando o PostgreSQL é iniciado, o uptime começa a ser contabilizado. Mas se em determinado momento, por exemplo, à noite, uma tarefa foi executada e o OOM-killer forçou o encerramento de um processo filho do PostgreSQL, nesse caso, o PostgreSQL encerra as conexões de todos os clientes, libera a área de memória shardada e começa a recuperação a partir do último ponto de verificação. E enquanto essa recuperação a partir do ponto de verificação dura, o banco não aceita conexões, ou seja, essa situação pode ser avaliada como um tempo de inatividade. No entanto, o contador de uptime não será zerado, pois ele considera o tempo desde o primeiro momento em que o postmaster foi iniciado. Portanto, tais situações podem ser ignoradas.
Também é importante monitorar o número de workers do autovacuum. Todos sabem o que é o autovacuum no PostgreSQL? É um subsistema interessante no PostgreSQL. Muitas matérias foram escritas sobre ele, várias palestras foram feitas. Houve muitas discussões sobre o vacuum e como ele deve funcionar. Muitos o consideram um mal inevitável. Mas é isso mesmo. É uma espécie de coletor de lixo que limpa versões obsoletas de linhas que não são necessárias para nenhuma transação e libera espaço nas tabelas e índices para novas linhas.
Por que é necessário monitorá-lo? Porque o vacuum às vezes causa sérios problemas. Ele consome um grande número de recursos e as consultas dos clientes começam a sofrer por isso.
E devemos monitorar isso através da visão pg_stat_activity, sobre a qual falarei na seção seguinte. Essa visão mostra a atividade atual no banco de dados. Através dessa atividade, podemos rastrear o número de vácuos que estão funcionando no momento. Podemos acompanhar os vácuos e ver que, se o nosso limite for ultrapassado, isso é um motivo para revisar as configurações do PostgreSQL e otimizar o funcionamento do vácuo.
Outra característica do PostgreSQL é que ele sofre muito com transações longas. Especialmente, com transações que ficam pendentes por muito tempo e não fazem nada. Essas são as chamadas transações idle-in-transaction. Tal transação mantém bloqueios, o que interfere no funcionamento do vácuo. Como consequência, as tabelas aumentam, o seu tamanho cresce. E as consultas que trabalham com essas tabelas começam a ficar mais lentas, porque é necessário mover todas as versões antigas das linhas da memória para o disco e vice-versa. Portanto, é necessário monitorar o tempo, a duração das transações mais longas, e as mais longas consultas do vácuo também. Se vemos alguns processos que estão funcionando há muito tempo, mais de 10-20-30 minutos para a carga OLTP, devemos prestar atenção e finalizá-los à força, ou otimizar o aplicativo para que não sejam chamados e não fiquem pendentes tanto tempo. Para carga analítica, 10-20-30 minutos é normal; às vezes até mais longas ocorrem.
A seguir, temos a opção com clientes conectados. Quando já formamos o painel, exibimos nele as métricas chave de disponibilidade, também podemos adicionar informações adicionais sobre os clientes conectados.
As informações sobre os clientes conectados são importantes porque, do ponto de vista do PostgreSQL, os clientes podem ser diferentes. Existem bons clientes e clientes ruins.
Um exemplo simples. Por cliente, entendo o aplicativo. O aplicativo se conectou ao banco de dados e começa a enviar seus pedidos, o banco de dados os processa e executa, retornando os resultados ao cliente. Esses são clientes bons e corretos.
Existem situações em que o cliente se conectou, mantém a conexão, mas não faz nada. Ele está em estado idle.
Mas existem clientes problemáticos. Por exemplo, um cliente se conecta, abre uma transação, faz alguma coisa no banco de dados e depois vai para o código, digamos, para acessar uma fonte externa ou para processar os dados recebidos. No entanto, ele não fecha a transação. E a transação fica pendurada no banco e mantém um bloqueio na linha. Isso é uma situação ruim. E se, de repente, o aplicativo falhar em algum ponto devido a uma exceção (Exception), a transação pode permanecer aberta por muito tempo. E isso afeta diretamente o desempenho do PostgreSQL. O PostgreSQL funcionará mais lentamente. Portanto, é importante monitorar esses clientes e forçá-los a encerrar suas atividades. Além disso, é necessário otimizar seu aplicativo para evitar tais situações.
Outros clientes problemáticos são os clientes em espera. Mas eles se tornam problemáticos por causa das circunstâncias. Por exemplo, uma transação simples em espera: pode abrir uma transação, obter bloqueios em algumas linhas e depois falhar em algum ponto do código, deixando uma transação pendurada. Um outro cliente chega e tenta solicitar os mesmos dados, mas ele encontrará bloqueio, pois aquela transação pendurada já mantém bloqueios em algumas linhas necessárias. Assim, a segunda transação ficará em espera até que a primeira seja concluída ou seu administrador a feche forçadamente. Dessa forma, transações em espera podem se acumular e superar o limite de conexões ao banco de dados. E quando o limite é excedido, o aplicativo não consegue mais trabalhar com o banco. Essa já é uma situação de emergência para o projeto. Portanto, é necessário monitorar os clientes problemáticos e reagir a eles de forma oportuna.
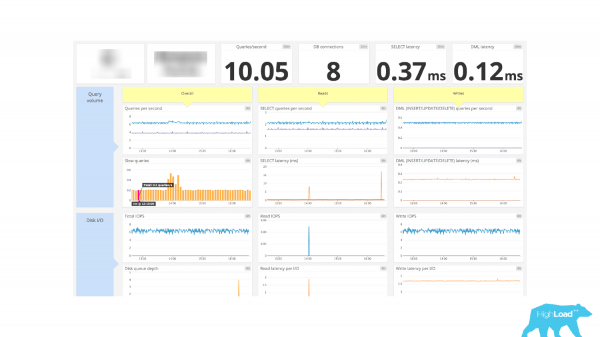
Outro exemplo de monitoramento. E aqui já temos um painel decente. Há informações sobre as conexões no topo. Conexão DB – 8 unidades. E só isso. Não temos informações sobre quais clientes estão ativos, quais clientes estão apenas ociosos, sem fazer nada. Não há informações sobre transações penduradas e sobre conexões em espera, ou seja, é apenas um número que mostra a quantidade de conexões e nada mais. Quanto ao restante, adivinhe você mesmo.
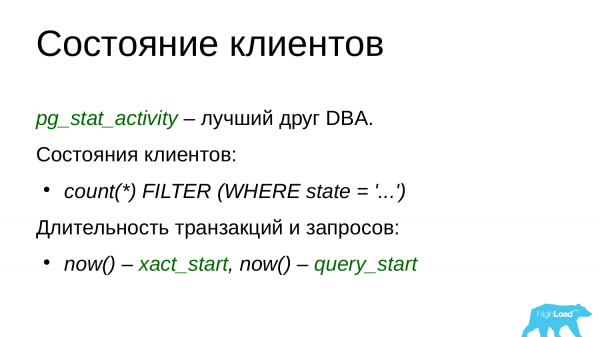
Portanto, para adicionar essas informações ao monitoramento, é necessário consultar a visão do sistema pg_stat_activity. Se você passa muito tempo no PostgreSQL, essa é uma visão muito útil que deve se tornar sua aliada, pois mostra a atividade atual no PostgreSQL, ou seja, o que está acontecendo nele. Para cada processo, há uma linha separada que informa sobre esse processo: de qual host a conexão foi realizada, sob qual usuário, qual nome, quando a transação foi iniciada, qual consulta está sendo executada no momento, qual consulta foi executada por último. E, assim, podemos avaliar o estado do cliente pelo campo stat. Podemos, por exemplo, agrupar por esse campo e obter as stats que existem atualmente no banco de dados e o número de conexões associadas a esse stat no banco de dados. E então, os números obtidos podem ser enviados ao nosso monitoramento para criar gráficos a partir deles.
Também é importante avaliar a duração da transação. Já mencionei que é essencial medir a duração dos vacuums, mas as transações são avaliadas da mesma forma. Existem os campos xact_start e query_start. Eles, por assim dizer, mostram o momento de início da transação e o momento de início da consulta. Pegamos a função now(), que mostra o timestamp atual, e subtraímos o timestamp da transação e da consulta. E obtemos a duração da transação e a duração da consulta.
Se observarmos transações longas, devemos finalizá-las. Para carga OLTP, transações longas são aquelas que duram mais de 1-2-3 minutos.. Para carga OLAP, transações longas são normais, mas se elas duram mais de duas horas, isso também é um sinal de que há algum desvio.
Quando os clientes se conectam ao banco de dados, eles começam a trabalhar com nossos dados. Eles acessam tabelas, consultam índices para obter dados da tabela. E é importante avaliar como os clientes interagem com esses dados.
Isso é necessário para avaliar nossa carga de trabalho e entender aproximadamente quais tabelas são as mais "quentes". Por exemplo, isso é útil em situações em que queremos colocar tabelas "quentes" em algum armazenamento SSD rápido. Por outro lado, tabelas de arquivo que não usamos há muito tempo podem ser movidas para um "frio" arquivo, em discos SATA, e elas podem lá permanecer, sendo acessadas conforme a necessidade.
Isso também é útil para detectar anomalias após lançamentos e implantações. Suponha que o projeto tenha lançado um novo recurso. Por exemplo, adicionamos uma nova funcionalidade para trabalhar com o banco de dados. Se construirmos gráficos de uso das tabelas, conseguiremos facilmente identificar essas anomalias nesses gráficos. Por exemplo, picos de atualização ou picos de exclusão. Isso será muito evidente.
Além disso, é possível detectar anomalias em estatísticas "desviadas". O que isso significa? O PostgreSQL possui um planejador de consultas muito forte e eficiente. E os desenvolvedores dedicam muito tempo ao seu aprimoramento. Como ele funciona? Para construir bons planos, o PostgreSQL coleta estatísticas sobre a distribuição de dados nas tabelas em intervalos de tempo regulares. Esses dados incluem os valores mais frequentes: a quantidade de valores únicos, informações sobre NULL nas tabelas, e muitas outras informações.
Com base nessas estatísticas, o planejador constrói várias consultas, escolhe a mais otimizada e utiliza esse plano de consulta para realizar a consulta e retornar os dados.
E às vezes, as estatísticas "desviam-se". A qualidade e a quantidade de dados mudaram de alguma forma na tabela, mas as estatísticas não foram coletadas. E os planos formados podem acabar sendo não otimizados. E se nossos planos forem não otimizados com base no monitoramento coletado sobre as tabelas, conseguiremos ver essas anomalias. Por exemplo, onde os dados mudaram qualitativamente e, em vez de usar índices, um acesso sequencial à tabela foi adotado. Ou seja, se a consulta precisa retornar apenas 100 linhas (com uma limitação de limit 100), será realizado um percurso completo. E isso sempre impacta negativamente na performance.
E podemos ver isso no monitoramento. E já olhar para essa consulta, executar um explain para ela, coletar estatísticas, construir um novo índice adicional. E então reagir a esse problema. Por isso, isso é importante.
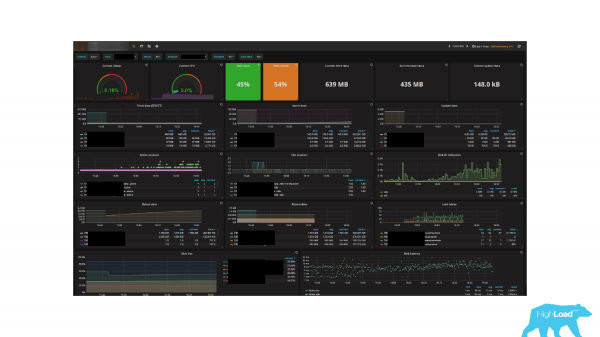
Outro exemplo de monitoramento. Acho que muitos o reconheceram, porque é muito popular. Quem usa em seus projetos ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Mas há um detalhe negativo.
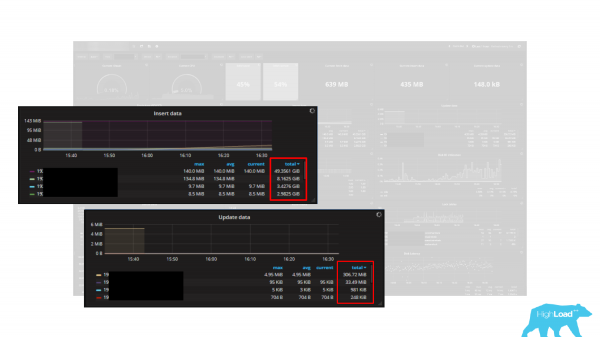
Existem vários gráficos. E em como unidade são indicados bytes, ou seja, há 5 gráficos. Esses são Insert data, Update data, Delete data, Fetch data e Return data. Como unidade de medida, estão indicados bytes. Mas o fato é que as estatísticas no PostgreSQL retornam dados em tuples (linhas). E, consequentemente, esses gráficos são uma maneira muito boa de subestimar seu workload várias vezes, dezenas de vezes, porque uma tuple não é um byte, uma tuple é uma linha, são muitos bytes e sempre tem tamanho variável. Ou seja, calcular o workload em bytes usando tuples é uma tarefa irreal ou muito complexa. Portanto, ao usar um dashboard ou monitoramento incorporado, é sempre importante entender que ele funciona corretamente e retorna dados avaliados de forma precisa.
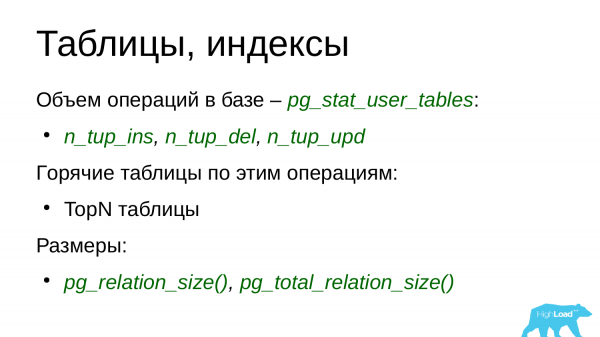
Como obter estatísticas dessas tabelas? Para isso, no PostgreSQL há uma certa família de views. E a view principal é . User_tables significa que as tabelas foram criadas em nome do usuário. Em contraste, existem views sistêmicas que são utilizadas pelo próprio PostgreSQL. E há uma tabela resumida Alltables, que inclui tanto as sistêmicas quanto as de usuários. Você pode se basear em qualquer uma delas, que você preferir.
Com base nos campos mencionados, é possível avaliar a quantidade de inserts, updates e deletes. O exemplo de dashboard que eu usei utiliza exatamente esses campos para avaliar as características do workload. Por isso, também podemos nos basear neles. Mas é importante lembrar que são tuples, não bytes, portanto não podemos simplesmente fazer isso em bytes.
Com base nesses dados, podemos construir as chamadas tabelas TopN. Por exemplo, Top-5, Top-10. E podemos monitorar aquelas tabelas quentes que são processadas mais do que as outras. Por exemplo, as 5 tabelas 'quentes' em inserção. E com essas tabelas TopN avaliamos nosso workload e podemos avaliar picos de workload após diversos lançamentos, atualizações e implantações.
Também é importante avaliar o tamanho das tabelas, pois às vezes os desenvolvedores lançam um novo recurso e nossas tabelas começam a aumentar de tamanho, porque decidem adicionar um volume extra de dados, mas não preveem como isso impactará o tamanho do banco de dados. Esses casos também nos pegam de surpresa.
E agora uma pergunta pequena para você. Qual é a primeira dúvida que surge quando você percebe uma carga no servidor com o banco de dados? Qual é a próxima pergunta que você se faz?
Mas na verdade, a pergunta que surge é a seguinte. Quais consultas estão gerando a carga? Ou seja, não é interessante olhar para os processos que geram a carga. É claro que se o host contém o banco de dados, ele está executando o banco de dados e, portanto, serão apenas os bancos de dados a utilizá-lo. Se abrirmos o Top, veremos uma lista de processos no PostgreSQL que estão fazendo algo. Pelo Top, não será claro o que eles estão fazendo.
Portanto, é necessário identificar aquelas consultas que geram a maior carga, porque o ajuste de consultas, geralmente, traz um retorno maior do que o ajuste da configuração do PostgreSQL, do sistema operacional ou até mesmo do hardware. Na minha avaliação, isso é cerca de 80-85-90%. E isso é feito muito mais rapidamente. É mais rápido corrigir uma consulta do que ajustar a configuração, planejar uma reinicialização, especialmente se não for possível reiniciar o banco ou adicionar hardware. É mais simples reescrever uma consulta ou adicionar um índice para obter um resultado melhor dessa consulta.
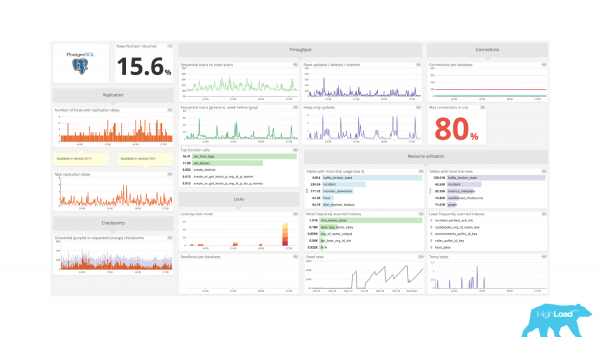
Portanto, é necessário monitorar as consultas e sua adequação. Vamos pegar outro exemplo de monitoramento. E aqui também parece um ótimo monitoramento. Há informações sobre replicação, informações sobre largura de banda, bloqueios, utilização de recursos. Tudo perfeito, mas não há informações sobre as consultas. Não está claro quais consultas estão sendo executadas em nosso banco de dados, quanto tempo elas levam para ser executadas, quantas dessas consultas existem. Precisamos sempre ter essas informações disponíveis no monitoramento.
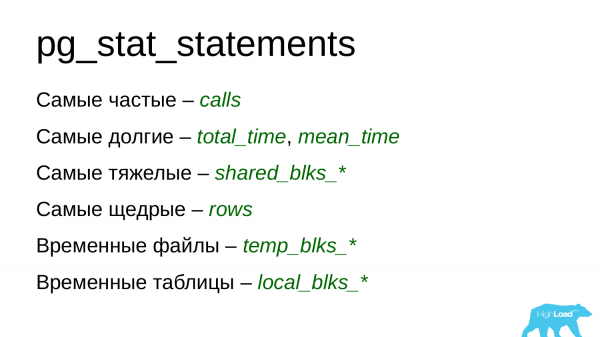
E para obter essas informações, podemos usar o módulo pg_stat_statements. Com base nele, podemos construir diversos gráficos. Por exemplo, podemos obter informações sobre as consultas mais frequentes, ou seja, aquelas que são executadas com mais frequência. Sim, após implantações, é muito útil analisá-lo e entender se houve algum pico nas consultas.
Podemos monitorar as consultas mais longas, ou seja, aquelas que levam mais tempo para serem executadas. Elas utilizam a CPU e consomem I/O. Também podemos avaliar isso pelos campos total_time, mean_time, blk_write_time e blk_read_time.
Podemos avaliar e monitorar as consultas mais pesadas em termos de uso de recursos, aquelas que leem do disco, que trabalham com memória ou, ao contrário, criam alguma carga de escrita.
Podemos avaliar as consultas mais generosas. Estas são aquelas que retornam um grande número de linhas. Por exemplo, pode ser uma consulta onde alguém esqueceu de definir um limite. E ela simplesmente retorna todo o conteúdo da tabela ou das tabelas solicitadas.
E também podemos monitorar as consultas que utilizam arquivos temporários ou tabelas temporárias.
E temos os processos em segundo plano. Processos em segundo plano são, antes de tudo, checkpoints, ou como também são chamados, pontos de controle, autovacuum e replicação.
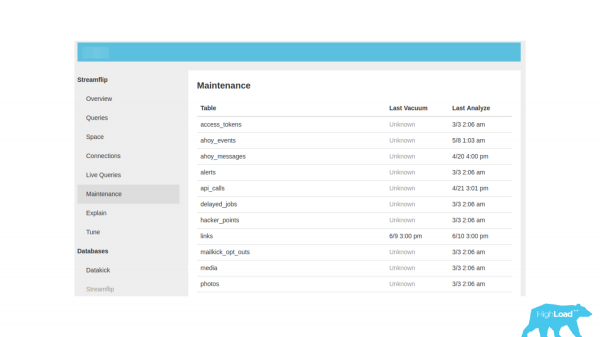
Outro exemplo de monitoramento. Há uma aba chamada Manutenção à esquerda, vamos para ela e esperamos ver algo útil. Mas aqui só aparece o tempo de execução do vacuum e da coleta de estatísticas, nada mais. Esta é uma informação muito escassa, por isso é sempre necessário ter informações sobre como os processos em segundo plano estão funcionando em nosso banco de dados e se há problemas decorrentes de seu funcionamento.
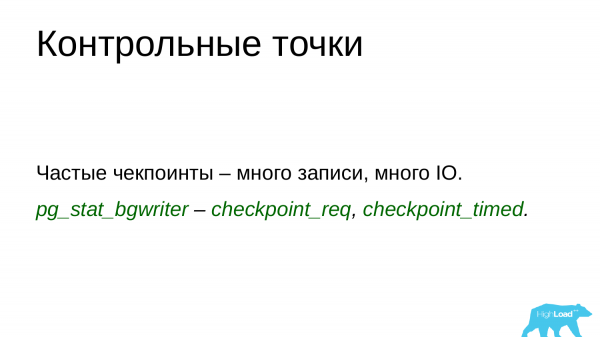
Ao considerarmos os pontos de controle, devemos lembrar que os pontos de controle descartam páginas "sujas" da área de memória fragmentada para o disco, e em seguida criam um ponto de controle. E esse ponto de controle pode ser utilizado como um local para recuperação, caso o PostgreSQL tenha sido encerrado de forma abrupta.
Portanto, para descarregar todas as páginas 'sujas' para o disco, é necessário realizar um certo volume de gravação. E, como regra geral, em sistemas com grande volume de memória, isso representa uma quantidade imensa. E se tivermos checkpoints realizados com muita frequência em um curto intervalo, o desempenho do disco será seriamente afetado. As solicitações dos clientes sofrerão com a falta de recursos. Eles irão competir por recursos e terão dificuldades de desempenho.
Assim, através do pg_stat_bgwriter, podemos monitorar o número de checkpoints que ocorrem pelos campos especificados. E se em um determinado intervalo de tempo (10-15-20 minutos ou meia hora) tivermos muitos checkpoints, por exemplo, 3-4-5, isso já pode ser um problema. É necessário verificar o banco de dados e a configuração para descobrir o que está causando essa abundância de checkpoints. Pode ser que haja uma grande gravação em andamento. Com a carga de trabalho, já podemos avaliar, uma vez que temos gráficos de carga de trabalho disponíveis. Podemos ajustar os parâmetros dos checkpoints para que não impactem tanto o desempenho das consultas.
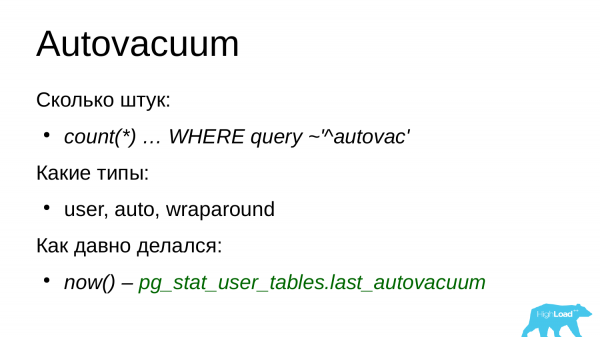
Estou retornando ao autovacuum, porque, como já mencionei, é uma coisa que pode facilmente comprometer o desempenho tanto dos discos quanto das consultas. Portanto, é sempre importante avaliar a quantidade de autovacuum.
O número de trabalhadores autovacuum no banco de dados é limitado. Por padrão, são três; portanto, se tivermos sempre três trabalhadores ativos no banco, isso significa que nosso autovacuum não está configurado corretamente. Precisamos aumentar os limites, revisar as configurações do autovacuum e ajustar a configuração.
É importante avaliar quais trabalhadores do vacuum estão ativos. Pode ser que um vacuum tenha sido iniciado manualmente por um usuário, um DBA que acionou algum vacuum, gerando carga. Assim, aparece um problema. Ou trata-se da quantidade de vacuums que reduzem o contador de transações. Para algumas versões do PostgreSQL, esses são vacuums muito pesados. E eles podem, facilmente, comprometer o desempenho, pois leem toda a tabela inteiramente, escaneando todos os blocos dessa tabela.
E, claro, a duração dos vacuums. Se tivermos vacuums longos que funcionam por muito tempo, isso significa que devemos prestar atenção na configuração do vacuum e, possivelmente, revisar suas definições. Porque pode surgir uma situação em que o vacuum funciona em uma tabela por um longo período (3-4 horas), mas durante esse tempo, um grande volume de linhas mortas se acumulou novamente na tabela. E assim que o vacuum termina, ele precisa novamente fazer o vacuum nessa tabela. E chegamos à situação de um vacuum infinito. Nesses casos, o vacuum não consegue fazer seu trabalho, e as tabelas começam a aumentar gradualmente de tamanho, embora o volume de dados úteis nelas permaneça o mesmo. Portanto, em vacuums longos, sempre olhamos para a configuração e tentamos otimizá-la, sem que isso prejudique o desempenho das consultas dos clientes.
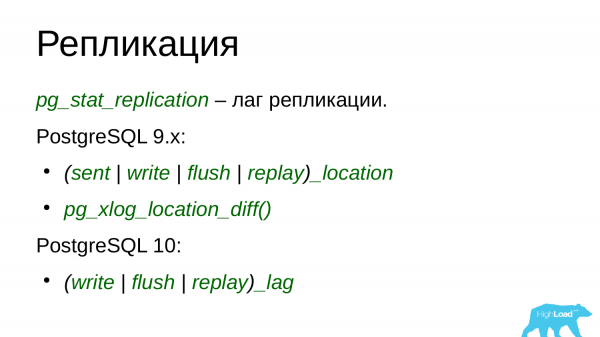
Atualmente, praticamente não existe uma instalação do PostgreSQL sem replicação em fluxo. Replicação é o processo de transferência de dados do mestre para a réplica.
A replicação no PostgreSQL é estruturada através do log de transações. O mestre gera um log de transações. O log de transações é enviado para a réplica através da conexão de rede e, em seguida, é reproduzido na réplica. É simples.
Assim, para monitorar o lag da replicação, usamos a visualização pg_stat_replication. Mas com ela não é tudo tão simples. Na versão 10, a visualização passou por algumas mudanças. Primeiro, parte dos campos foi renomeada. E parte dos campos foi adicionada. Na versão 10 surgiram campos que permitem avaliar o lag da replicação em segundos. Isso é muito conveniente. Antes da versão 10, havia a possibilidade de avaliar o lag da replicação em bytes. Essa possibilidade foi mantida na versão 10, ou seja, você pode escolher o que for mais conveniente – avaliar o lag em bytes ou em segundos. Muitos fazem ambos.
Mas, para avaliar o lag da replicação, é necessário saber a posição do log na transação. E essas posições do log de transação estão precisamente na visualização pg_stat_replication. De forma simplificada, podemos usar a função pg_xlog_location_diff() para pegar dois pontos no log de transações. Calcular a diferença entre eles e obter o lag da replicação em bytes. Isso é muito conveniente e simples.
Na 10ª versão, essa função foi renomeada para pg_wal_lsn_diff(). De modo geral, em todas as funções, visões e utilitários onde a palavra “xlog” aparecia, ela foi substituída pelo valor “wal”. Isso se aplica tanto nas visões quanto nas funções. Essa é uma nova implementação.
Além disso, na 10ª versão, foram adicionadas linhas que mostram especificamente o atraso. Esses são write lag, flush lag e replay lag. Ou seja, é importante monitorar essas métricas. Se observarmos que há atraso na replicação, precisamos investigar por que ele ocorreu, de onde veio e solucionar o problema.
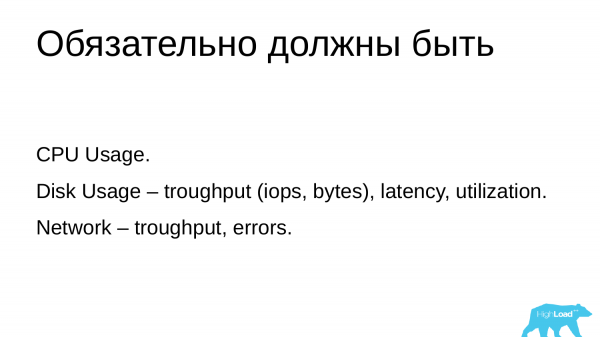
Em relação às métricas do sistema, praticamente está tudo em ordem. Quando qualquer monitoramento é iniciado, ele começa com as métricas do sistema. Isso inclui a utilização de CPU, memória, swap, rede e disco. No entanto, muitos parâmetros não estão presentes por padrão.
Se a utilização do processo está em ordem, existem problemas com a utilização do disco. Geralmente, os desenvolvedores de monitoramentos adicionam informações sobre a largura de banda. Isso pode ser em iops ou bytes. Mas eles esquecem sobre a latência e a utilização dos dispositivos de disco. Esses são parâmetros mais importantes, que permitem avaliar o quão carregados estão os discos e quão lentos estão. Se temos alta latência, isso significa que há problemas com os discos. Se a nossa utilização é alta, isto indica que os discos não estão lidando com a carga. Essas são características de maior qualidade do que a largura de banda.
Embora essa estatística possa ser obtida também do sistema de arquivos /proc, como feito para a utilização da CPU, não sei por que essa informação não é adicionada aos monitoramentos. No entanto, é importante ter isso no seu monitoramento.
O mesmo se aplica aos interfaces de rede. Há informações sobre a largura de banda da rede em pacotes, em bytes, mas não há informações sobre latência e nem sobre utilização, embora essas também sejam informações úteis.
Todo monitoramento tem suas desvantagens. E não importa qual monitoramento você escolha, sempre haverá algo que não atende a alguns critérios. No entanto, eles estão se desenvolvendo, novas funcionalidades estão sendo adicionadas, portanto escolha algo e faça as melhorias necessárias.
E para efetuar essas melhorias, é necessário sempre entender o que significa a estatística fornecida e como utilizá-la para resolver problemas.
E alguns pontos chave:
- É sempre necessário monitorar a disponibilidade, ter painéis de controle para que você possa avaliar rapidamente se a base de dados está em ordem.
- É sempre importante ter uma noção de quais clientes estão trabalhando com sua base de dados, a fim de filtrar clientes problemáticos e afastá-los.
- É fundamental avaliar como esses clientes interagem com os dados. É preciso ter uma compreensão da sua carga de trabalho.
- É importante avaliar como essa carga de trabalho é formada e quais consultas são utilizadas. Você pode avaliar as consultas, otimizá-las, refatorá-las e construir índices para elas. Isso é extremamente importante.
- Processos em segundo plano podem impactar negativamente as consultas dos clientes, por isso é importante monitorar para garantir que eles não utilizem recursos excessivos.
- Métricas de sistema permitem que você faça planos de escalabilidade e ampliação da capacidade dos seus servidores, por isso é importante também monitorá-las e avaliá-las.
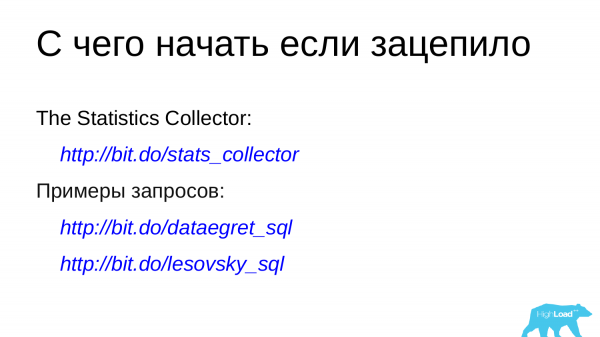
Se você se interessou por este tema, pode seguir esses links.
— é a documentação oficial do coletor de estatísticas. Lá você encontrará a descrição de todas as views estatísticas e todos os campos. Você pode lê-las, entendê-las e analisá-las. E a partir disso, construir seus gráficos e adicionar em seus monitoramentos.
Exemplo de consultas:
Este é nosso repositório corporativo e o meu próprio. Eles contêm exemplos de consultas. Não há consultas do tipo select * from algo. São consultas já preparadas com joins, aplicando funções interessantes que transformam números crus em valores legíveis e úteis, como bytes e tempo. Você pode manipulá-las, examiná-las, analisá-las e adicioná-las a seus monitoramentos, construindo seus próprios a partir delas.
Perguntas
Pergunta: Você mencionou que não vai promover marcas, mas ainda assim estou curioso – quais painéis você usa em seus projetos?
Resposta: De diversas maneiras. Às vezes chegamos ao cliente e ele já tem seu próprio monitoramento. E nós aconselhamos o cliente sobre o que precisa ser adicionado ao seu monitoramento. A situação é pior com o Zabbiх, porque ele não tem a capacidade de construir gráficos TopN. Pessoalmente, usamos , porque nós consultamos esses caras sobre monitoramento. Eles desenvolveram um monitoramento para PostgreSQL baseado em nossas especificações. Estou escrevendo meu projeto pessoal, que coleta dados através do Prometheus e os visualiza em . Tenho a tarefa de criar meu próprio exportador no Prometheus e depois fazer a visualização no Grafana.
Pergunta: Existem análogos dos relatórios AWR ou ... agregações? Você sabe de algo assim?
Resposta: Sim, eu sei o que é AWR, é muito bom. Atualmente, há várias soluções que implementam um modelo semelhante. Em intervalos de tempo específicos, algumas bases de dados são escritas no mesmo PostgreSQL ou em um repositório separado. Você pode encontrá-las na internet, elas existem. Um dos desenvolvedores de uma dessas soluções está no fórum sql.ru na seção do PostgreSQL. Você pode encontrá-lo lá. Sim, essas soluções existem e podem ser utilizadas. Além disso, estou também desenvolvendo algo que permite fazer o mesmo.
P.S.1 Se você usa o postgres_exporter, qual painel você utiliza? Há vários disponíveis. Eles estão um pouco desatualizados. Talvez a comunidade possa criar um modelo atualizado?
P.S.2 Removi o pganalyze, pois é uma oferta SaaS proprietária que foca em monitoramento de desempenho e sugestões automatizadas de ajuste.
Apenas usuários registrados podem participar da pesquisa. , por favor.
Qual monitoramento auto-hospedado para PostgreSQL (com painel) você considera o melhor?
30,0%Zabbix + complementos de Alexey Lesovsky ou zabbix 4.4 ou libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze é uma SaaS proprietária — não posso remover
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
10 usuários votaram. 26 usuários se abstiveram.
Fonte: habr.com
