

Olá, amigos. Antes de nos despedirmos para a segunda parte do feriado de maio, estamos compartilhando com vocês um material que traduzimos em antecipação ao lançamento de uma nova turma do curso .
Desenvolvedores de aplicações gastam muito tempo comparando vários bancos de dados operacionais para escolher aquele que melhor se adapta à carga de trabalho prevista. As necessidades podem incluir modelagem de dados simplificada, garantias transacionais, desempenho de leitura/gravação, escalabilidade horizontal e resistência a falhas. Tradicionalmente, a escolha começa pela categoria do banco de dados, SQL ou NoSQL, uma vez que cada categoria apresenta um conjunto claro de compromissos. Alto desempenho em termos de baixa latência e alta capacidade geralmente é considerado uma exigência não negociável, sendo portanto essencial para qualquer banco de dados da amostra.
O objetivo deste artigo é ajudar os desenvolvedores de aplicações a fazer a escolha certa entre SQL e NoSQL no contexto da modelagem de dados da aplicação. Analisaremos um banco de dados SQL, especificamente o PostgreSQL, e dois bancos de dados NoSQL – Cassandra e MongoDB, para discutir os fundamentos do design de bancos de dados, como criação de tabelas, preenchimento, leitura de dados de uma tabela e exclusão. No próximo artigo, abordaremos certamente índices, transações, JOINs, diretrizes TTL e design de bancos de dados baseados em JSON.
Qual é a diferença entre SQL e NoSQL?
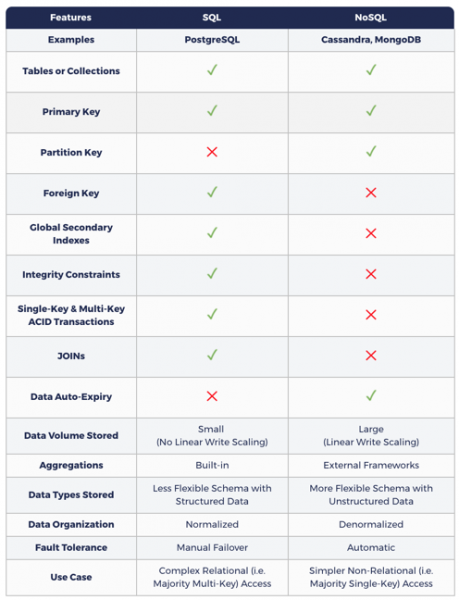
Bancos de dados SQL aumentam a flexibilidade da aplicação graças às garantias transacionais ACID e à sua capacidade de consultar dados com JOINs de maneiras inesperadas em cima dos modelos normalizados existentes dos bancos de dados relacionais.
Considerando sua arquitetura monolítica/uninodal e o uso do modelo de replicação master-slave para redundância, os bancos de dados SQL tradicionais carecem de duas características importantes: escalabilidade linear de gravação (ou seja, o particionamento automático em vários nós) e perda zero automática de dados. Isso significa que o volume de dados processados não pode ultrapassar a capacidade máxima de gravação de um único nó. Além disso, alguma perda temporária de dados deve ser considerada em situações de resistência a falhas (em uma arquitetura sem particionamento de recursos). É preciso ter em mente que os commits recentes ainda não foram refletidos na cópia escrava. Atualizações sem downtime também são difíceis de alcançar em bancos de dados SQL.
Bancos de dados NoSQL são, por natureza, geralmente distribuídos, ou seja, os dados são divididos em seções e distribuídos por vários nós. Eles requerem desnormalização. Isso significa que os dados inseridos também devem ser copiados várias vezes para atender a consultas específicas que você envia. O objetivo geral é obter alto desempenho ao reduzir o número de shards disponíveis durante a leitura. Daí decorre a afirmação de que NoSQL exige que você modele suas consultas, enquanto SQL exige que você modele seus dados.
NoSQL enfoca a obtenção de alto desempenho em um cluster distribuído, e isso é a principal justificativa para muitos compromissos de design de bancos de dados, incluindo a perda das garantias de transação ACID, JOINs e índices secundários globais consistentes.
Há quem diga que, embora os bancos de dados NoSQL ofereçam escalabilidade linear de gravação e alta resistência a falhas, a perda das garantias transacionais os torna inadequados para dados críticos.
A tabela a seguir mostra como a modelagem de dados em NoSQL difere de SQL.
SQL e NoSQL: Por que ambos são necessários?
Em aplicações reais com um grande número de usuários, como Amazon.com, Netflix, Uber e Airbnb, a execução de tarefas variadas e complexas é necessária. Por exemplo, uma aplicação de e-commerce como a Amazon.com precisa armazenar dados leves e altamente críticos, como informações sobre usuários, produtos, pedidos e faturas, juntamente com dados pesados, mas menos sensíveis, como análises de produtos, mensagens do serviço de suporte, atividade dos usuários, feedback e recomendações. Naturalmente, essas aplicações dependem de pelo menos um banco de dados SQL juntamente com no mínimo um banco de dados NoSQL. Em sistemas inter-regionais e globais, o banco de dados NoSQL atua como um cache geograficamente distribuído para dados armazenados em uma fonte confiável, o banco de dados SQL, que opera em uma única região.
Como o YugaByte DB combina SQL e NoSQL?
Construído em um motor de armazenamento híbrido orientado a logs com auto-sharding, replicação de consenso distribuído e transações ACID (inspiradas no Google Spanner), o YugaByte DB é o primeiro banco de dados de código aberto do mundo que é compatível com NoSQL (Cassandra & Redis) e SQL (PostgreSQL). Como mostrado na tabela abaixo, o YCQL, API do YugaByte DB compatível com Cassandra, adiciona o conceito de transações ACID de uma e múltiplas chaves e índices secundários globais à API NoSQL, abrindo assim a era dos bancos de dados NoSQL transacionais. Além disso, o YCQL, API do YugaByte DB compatível com PostgreSQL, acrescenta conceitos de escalabilidade linear de gravação e tolerância a falhas automática à API SQL, apresentando ao mundo os bancos de dados SQL distribuídos. Como o banco de dados YugaByte DB é essencialmente transacional, a API NoSQL pode agora ser usada no contexto de dados críticos.
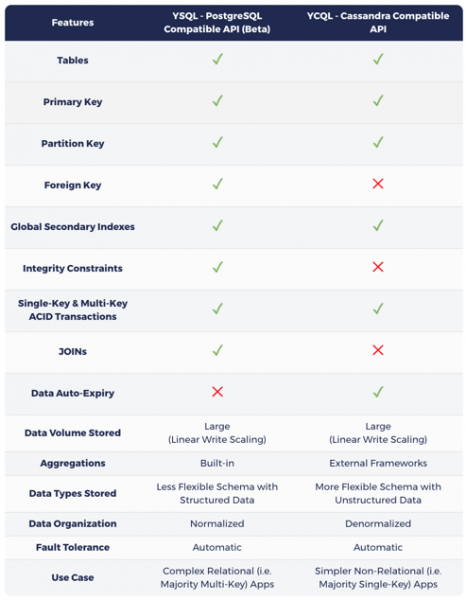
Como mencionado anteriormente no artigo , a escolha entre SQL ou NoSQL no YugaByte DB depende totalmente das características da carga de trabalho principal:
- Se a carga de trabalho principal consiste em operações de múltiplas chaves com JOINs, ao escolher o YSQL, é importante entender que suas chaves podem estar distribuídas em vários nós, o que resultará em maior latência e/ou diminuição da largura de banda em comparação com o NoSQL.
- Caso contrário, escolha qualquer uma das duas APIs NoSQL, lembrando que você obterá melhor desempenho devido a consultas atendidas de um único nó por vez. O YugaByte DB pode servir como um único banco de dados operacional para aplicativos complexos em tempo real, onde é necessário gerenciar várias cargas de trabalho simultaneamente.
A base do laboratório de modelagem de dados no próximo segmento consiste em bancos de dados YugaByte DB compatíveis com PostgreSQL e Cassandra, em vez de bancos de dados fonte. Essa abordagem enfatiza a simplicidade de interação com duas APIs diferentes (em duas portas diferentes) do mesmo cluster de bancos de dados, em vez de usar clusters completamente independentes de dois bancos de dados diferentes.
Nas seções a seguir, vamos explorar o laboratório de modelagem de dados para ilustrar as diferenças e algumas semelhanças entre os bancos de dados considerados.
Laboratório de Modelagem de Dados
Instalação de Bancos de Dados
Tendo em vista o foco no design da modelagem de dados (não em arquiteturas de implantação complexas), vamos instalar os bancos de dados em contêineres Docker em um computador local e depois interagir com eles usando suas respectivas interfaces de linha de comando.
Banco de dados YugaByte DB compatível com PostgreSQL & Cassandra
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestAcesso pela Linha de Comando
Vamos nos conectar aos bancos de dados por meio da interface de linha de comando para as respectivas APIs.
PostgreSQL
— é a interface de linha de comando para interagir com o PostgreSQL. Para facilitar, o YugaByte DB vem com o psql diretamente na pasta bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— é a interface de linha de comando para interagir com o Cassandra e seus bancos de dados compatíveis através do CQL (Cassandra Query Language). Para conveniência, o YugaByte DB vem com cqlsh no diretório bin.
Observe que o CQL foi inspirado no SQL e possui conceitos semelhantes de tabelas, linhas, colunas e índices. No entanto, como uma linguagem NoSQL, ele adiciona um conjunto específico de restrições, a maioria das quais também abordaremos em outros artigos.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– é uma interface de linha de comando para interagir com o MongoDB. Pode ser encontrada no diretório bin da instalação do MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Criação de tabela
Agora podemos interagir com o banco de dados para realizar diversas operações através da linha de comando. Vamos começar com a criação de uma tabela que armazena informações sobre músicas escritas por diferentes artistas. Essas músicas podem fazer parte de um álbum. Além disso, atributos opcionais para a música incluem ano de lançamento, preço, gênero e classificação. Precisamos considerar atributos adicionais que podem ser necessários no futuro, através do campo "tags". Este pode armazenar dados semiestruturados na forma de pares chave-valor.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
A criação de tabela no Cassandra é muito semelhante à do PostgreSQL. Uma das principais diferenças é a ausência de restrições de integridade (por exemplo, NOT NULL), mas isso fica sob a responsabilidade da aplicação, e não do banco de dados NoSQL.. A chave primária consiste na chave de partição (coluna Artist no exemplo abaixo) e em um conjunto de colunas de clustering (coluna SongTitle no exemplo a seguir). A chave de partição determina em qual partição/shard a linha deve ser colocada, enquanto as colunas de clustering indicam como os dados devem ser organizados dentro do shard atual.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
O MongoDB organiza os dados em bancos de dados (Database) (semelhante ao Keyspace no Cassandra), onde existem coleções (Collections) (semelhantes às tabelas), que contêm documentos (Documents) (semelhantes às linhas na tabela). No MongoDB, essencialmente, não é necessário definir um esquema inicial. O comando "use database", mostrado abaixo, cria uma instância do banco de dados na primeira chamada e muda o contexto para o novo banco de dados criado. Mesmo as coleções não precisam ser criadas explicitamente, elas são criadas automaticamente assim que o primeiro documento é adicionado a uma nova coleção. Note que o MongoDB, por padrão, usa uma base de dados de teste, portanto, qualquer operação ao nível de coleções sem especificar um banco específico será executada nela por padrão.
use myNewDatabase;Obtendo informações sobre a tabela
PostgreSQL
d Música
Tabela "public.music"
    Coluna      |         Tipo           | Colação | Nullable | Padrão
--------------+-----------------------+-----------+----------+--------
 artista       | caracter variável(20)  |           | não nulo |
 titulo da canção | caracter variável(30) |           | não nulo |
 titulo do álbum  | caracter variável(25) |           |          |
 ano          | inteiro               |           |          |
 preço        | precisão dupla        |           |          |
 gênero       | caracter variável(10) |           |          |
 classificação do crítico | precisão dupla |           |          |
 tags         | texto                 |           |          |
Índices:
    "music_pkey" CHAVE PRIMÁRIA, btree (artista, titulo da canção)
Cassandra
DESCREVER TABELA MÚSICA;
CRIAR TABELA myapp.music (
    artista texto,
    titulo_da_canção texto,
    titulo_do_album texto,
    ano int,
    preço float,
    gênero texto,
    tags texto,
    CHAVE PRIMÁRIA (artista, titulo_da_canção)
) COM ORDEM DE AGRUPAMENTO POR (titulo_da_canção ASC)
    E default_time_to_live = 0
    E transações = {'enabled': 'false'};
MongoDB
usar myNewDatabase;
mostrar coleções;
Inserção de dados na tabela
PostgreSQL
INSERIR EM Música
    (Artista, TituloDaCanção, TituloDoAlbum,
    Ano, Preço, Gênero, ClassificaçãoDoCrítico,
    Tags)
VALORES(
    'Ninguém que você conhece', 'Me Chame Hoje', 'Um Pouco Famoso',
    2015, 2.14, 'Country', 7.8,
    '{"Compositores": ["Smith", "Jones", "Davis"],"DuraçãoEmSegundos": 214}'
);
INSERIR EM Música
    (Artista, TituloDaCanção, TituloDoAlbum,
    Preço, Gênero, ClassificaçãoDoCrítico)
VALORES(
    'Ninguém que você conhece', 'Meu Cão Spot', 'Ei Agora',
    1.98, 'Country', 8.4
);
INSERIR EM Música
    (Artista, TituloDaCanção, TituloDoAlbum,
    Preço, Gênero)
VALORES(
    'A Banda Acme', 'Cuidado, Mundo', 'O Dinheiro Começa Aqui',
    0.99, 'Rock'
);
INSERIR EM Música
    (Artista, TituloDaCanção, TituloDoAlbum,
    Preço, Gênero,
    Tags)
VALORES(
    'A Banda Acme', 'Ainda Apaixonado', 'O Dinheiro Começa Aqui',
    2.47, 'Rock',
    '{"estaçõesDeRádioTocando": ["KHCR", "KBQX", "WTNR", "WJJH"], "datasDeTurnê": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotação": Pesada}'
);
Cassandra
No geral, a expressão INSERT em Cassandra parece muito semelhante à equivalente em PostgreSQL. No entanto, há uma grande diferença na semântica. Em Cassandra INSERT é na verdade uma operação UPSERT, onde os últimos valores são adicionados à linha, caso a linha já exista.
A entrada de dados ocorre de forma semelhante ao PostgreSQL
INSERTacima
.
MongoDB
Embora o MongoDB seja um banco de dados NoSQL, similar ao Cassandra, sua operação de inserção de dados não tem nada a ver com o comportamento semântico em Cassandra. Em MongoDB não possui funcionalidades UPSERT, o que o torna semelhante ao PostgreSQL. A adição de dados por padrão sem _idspecified resultará na adição de um novo documento à coleção.
db.music.insert( {
 artist: "Ninguém que você conhece",
 songTitle: "Ligue-me Hoje",
 albumTitle: "Um Pouco Famoso",
 year: 2015,
 price: 2.14,
 genre: "Country",
 tags: {
 Composers: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "Ninguém que você conhece",
 songTitle: "Meu Cão Spot",
 albumTitle: "Hey Now",
 price: 1.98,
 genre: "Country",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "A Banda Acme",
 songTitle: "Cuidado, Mundo",
 albumTitle:"O Dinheiro Começa Aqui",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "A Banda Acme",
 songTitle: "Ainda Apaixonado",
 albumTitle:"O Dinheiro Começa Aqui",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Pesada"
 }
 }
 );
Consulta à tabela
Talvez a diferença mais significativa entre SQL e NoSQL em termos de construção de consultas seja o uso de formulações FROM e WHERE. SQL permite, após a expressão FROM selecionar várias tabelas, enquanto a expressão com WHERE pode ser de qualquer complexidade (incluindo operações JOIN entre tabelas). No entanto, NoSQL tende a impor uma rígida limitação sobre FROM, e trabalhar apenas com uma tabela especificada. WHERE, deve sempre ser especificada a chave primária. Isso está relacionado ao objetivo de aumentar o desempenho do NoSQL, sobre o qual já discutimos. Esse objetivo resulta em uma redução de qualquer interação entre tabelas e chaves. Pode resultar em uma grande latência na comunicação entre nós ao responder a uma consulta e, portanto, é melhor evitá-lo em princípio. Por exemplo, Cassandra requer que as consultas sejam limitadas a certos operadores (somente permitidos =, IN, , =>, <=) nas chaves de partição, exceto em casos de consulta de índice secundário (onde apenas o operador = é permitido).
PostgreSQL
A seguir, serão apresentados três exemplos de consultas que podem ser facilmente executadas por um banco de dados SQL.
- Selecione todas as músicas do artista;
- Selecione todas as músicas do artista que correspondem à primeira parte do título;
- Selecione todas as músicas do artista que têm uma palavra específica no título e têm um preço inferior a 1,00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Dentre as consultas listadas acima, apenas a primeira funcionará em Cassandra sem alterações, pois o operador LIKE não pode ser aplicado a colunas de clustering, como SongTitle. Nesse caso, apenas os operadores = e IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Como mostrado nos exemplos anteriores, o principal método para construir consultas no MongoDB é . Este método contém explicitamente o nome da coleção (music no exemplo abaixo), portanto, a consulta em várias coleções é proibida.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Lendo todas as linhas da tabela
Ler todas as linhas é apenas um caso específico do padrão de consulta que discutimos anteriormente.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Semelhante ao exemplo acima em PostgreSQL.
MongoDB
db.music.find( {} );Editando dados na tabela
PostgreSQL
O PostgreSQL fornece uma instrução ATUALIZAÇÃO para modificar dados. Ele não tem funcionalidades UPSERT, portanto, a execução desta instrução resultará em um erro se as linhas não estiverem mais no banco de dados.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
Em Cassandra, existe ATUALIZAÇÃO um equivalente ao PostgreSQL. ATUALIZAÇÃO tem a mesma semântica UPSERT, semelhante INSERT.
Semelhante ao exemplo acima em PostgreSQL.
MongoDB
Operação No MongoDB, é possível atualizar completamente um documento existente ou apenas campos específicos. Por padrão, ele atualiza apenas um documento com semântica desativada. UPSERT. A atualização de vários documentos e o comportamento são semelhantes. UPSERT Pode ser aplicada definindo flags adicionais para a operação. Como no exemplo abaixo, ocorre a atualização do gênero de um artista específico baseado em sua música.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Remoção de dados da tabela
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Semelhante ao exemplo acima em PostgreSQL.
MongoDB
No MongoDB, existem dois tipos de operações para remover documentos — e . Ambos os tipos removem documentos, mas retornam resultados diferentes.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Remoção da tabela
PostgreSQL
DROP TABLE Music;Cassandra
Semelhante ao exemplo acima em PostgreSQL.
MongoDB
db.music.drop();Conclusão
As disputas sobre a escolha entre SQL e NoSQL já ocorrem há mais de 10 anos. Existem dois aspectos principais dessa disputa: a arquitetura do núcleo do banco de dados (SQL monolítico e transacional contra NoSQL distribuído e não transacional) e a abordagem de modelagem de dados (modelagem em SQL contra modelagem de suas consultas em NoSQL).
Com um banco de dados transacional distribuído, como o YugaByte DB, os debates sobre a arquitetura do banco de dados podem ser facilmente dissipados. À medida que os volumes de dados superam a capacidade de um único nó, uma arquitetura totalmente distribuída que suporte escalabilidade linear de gravação com sharding/rebalanceamento automático se torna necessária.
Além do que foi dito em um dos artigos , arquiteturas transacionais e rigorosamente consistentes agora são mais amplamente aplicadas para oferecer melhor flexibilidade no desenvolvimento do que arquiteturas não transacionais, eventualmente consistentes.
Voltando à discussão sobre o projeto de bancos de dados, é justo dizer que ambas as abordagens de design (SQL e NoSQL) são essenciais para qualquer aplicativo real complexo. A abordagem SQL de "modelagem de dados" permite que os desenvolvedores atendam mais facilmente às mudanças nas necessidades de negócios, enquanto a abordagem NoSQL de "modelagem de consultas" permite que os mesmos desenvolvedores lidem com grandes volumes de dados com baixa latência e alta capacidade de processamento. É por isso que o YugaByte DB oferece APIs SQL e NoSQL no núcleo comum, em vez de promover uma única abordagem. Além disso, ao garantir compatibilidade com linguagens populares de bancos de dados, incluindo PostgreSQL e Cassandra, o YugaByte DB assegura que os desenvolvedores não precisem aprender uma nova linguagem para trabalhar com o núcleo de banco de dados distribuído e estritamente consistente.
Neste artigo, exploramos como os fundamentos do design de bancos de dados diferem entre PostgreSQL, Cassandra e MongoDB. Em próximos artigos, vamos nos aprofundar em conceitos avançados de design, como índices, transações, JOINs, diretivas TTL e documentos JSON.
Desejamos a você um maravilhoso fim de semana e convidamos você para , que acontecerá em 14 de maio.
Fonte: habr.com
