

Introdução
 «É preciso correr o mais rápido possível apenas para se manter no lugar,
e para chegar a algum lugar, é preciso correr pelo menos duas vezes mais rápido!»
(c) Alice no País das Maravilhas
Há algum tempo, fui convidado a dar uma palestra para os analistas da nossa empresa sobre o design de modelos de dados, pois, ao passar muito tempo em projetos (às vezes por vários anos), perdemos de vista o que está acontecendo ao nosso redor no mundo da tecnologia da informação. Na nossa empresa (já que assim aconteceu), muitos projetos não utilizam bancos de dados NoSQL (pelo menos por enquanto), portanto, em minha palestra, dediquei uma atenção especial a eles usando o exemplo do HBase e tentei orientar a apresentação para aqueles que nunca trabalharam com eles. Em particular, ilustrei algumas características do design de modelos de dados com um exemplo que li alguns anos atrás . Ao discutir os exemplos, comparei várias opções para resolver a mesma tarefa, a fim de transmitir melhor as ideias principais aos ouvintes.
Recentemente, «sem nada para fazer», perguntei-me (os longos feriados de maio em modo de quarentena favorecem especialmente isso), quão compatíveis seriam as conclusões teóricas com a prática? De fato, foi assim que surgiu a ideia deste artigo. Um desenvolvedor que já trabalha há algum tempo com NoSQL, talvez não encontre nada de novo (e por isso pode pular toda a metade do artigo). Mas para analistas, que ainda não trabalharam de perto com NoSQL, acredito que será útil para obter uma compreensão básica das características do design de modelos de dados para o HBase.
Análise do exemplo
Na minha opinião, antes de começar a usar bancos de dados NoSQL, é necessário refletir bem e pesar os "prós" e "contras". Muitas vezes, a tarefa pode ser resolvida também com bancos de dados relacionais tradicionais. Portanto, é melhor não usar NoSQL sem boas razões. Se, no entanto, foi tomada a decisão de usar um banco de dados NoSQL, deve-se considerar que as abordagens de design aqui diferem um pouco. Especialmente algumas delas podem ser incomuns para quem lidou apenas com bancos de dados relacionais (segundo minhas observações). Assim, no mundo "relacional" normalmente partimos da modelagem do domínio e, se necessário, realizamos a desnormalização do modelo posteriormente. No NoSQL, devemos considerar imediatamente os cenários previstos de uso dos dados e desnormalizar os dados desde o início. Além disso, existem várias outras diferenças que serão abordadas a seguir.
Vamos considerar a seguinte tarefa "sintética", com a qual trabalharemos daqui em diante:
É necessário projetar a estrutura de armazenamento da lista de amigos de usuários de uma rede social abstrata. Para simplificar, vamos assumir que todas as conexões são direcionadas (como no Instagram, e não no LinkedIn). A estrutura deve permitir de forma eficaz:
- Responder à pergunta se o usuário A segue o usuário B (modelo de leitura)
- Permitir adicionar/remover conexões no caso de o usuário A seguir/deixar de seguir o usuário B (modelo de alteração de dados)
Certamente, há muitas maneiras de resolver essa tarefa. Em um banco de dados relacional convencional, provavelmente simplesmente criaríamos uma tabela de relações (possivelmente tipificada, se, por exemplo, é necessário armazenar grupos de usuários: família, trabalho etc., aos quais pertence este "amigo"), e para otimizar a velocidade de acesso, adicionaríamos índices/particionamento. Provavelmente, a tabela final ficaria assim:
user_id
friend_id
Vasya
Petya
Vasya
Olya
a partir daqui, e doravante, para melhor compreensão, em vez de IDs, indicarei nomes
No caso do HBase, sabemos que:
- a pesquisa eficiente que não leva a um full table scan é possível exclusivamente pela chave
- Na verdade, é por isso que escrever as consultas SQL habituais para bancos assim é uma má ideia; tecnicamente, você pode enviar uma consulta SQL com joins e outras lógicas do Impala para o HBase, mas quão eficiente isso será…
Portanto, somos obrigados a usar o ID do usuário como chave. A primeira ideia sobre "onde e como armazenar os IDs dos amigos?" pode ser guardá-los em colunas. Essa opção mais óbvia e "ingênua" seria mais ou menos assim (vamos chamá-la de Opção 1 (padrão), para referenciá-la posteriormente):
RowKey
Colunas
Vasya
1: Petya
2: Olya
3: Dasha
Petya
1: Masha
2: Vasya
Aqui, cada linha corresponde a um usuário da rede. As colunas têm nomes: 1, 2, … — de acordo com o número de amigos, e as colunas armazenam os IDs dos amigos. É importante notar que cada linha terá um número diferente de colunas. No exemplo acima, uma linha tem três colunas (1, 2 e 3), enquanto a outra tem apenas duas (1 e 2) – aqui utilizamos duas propriedades do HBase que não estão presentes nos bancos de dados relacionais:
- a capacidade de mudar dinamicamente a composição das colunas (adicionamos um amigo -> adicionamos uma coluna, removemos um amigo -> removemos uma coluna)
- linhas diferentes podem ter composições variadas de colunas
Vamos verificar se nossa estrutura atende aos requisitos da tarefa:
- Leitura de dados: para entender se Vasya está seguindo Olya, precisaremos ler toda a linha com a chave RowKey = "Vasya" e percorrer os valores das colunas até "encontrarmos" Olya nelas. Ou percorrer todos os valores das colunas, "não encontrar" Olya e retornar a resposta False;
- Alteração de dados: adição de um amigo: para essa tarefa, também precisaremos ler toda a linha com a chave RowKey = "Vasya", para contar o número total de amigos dele. Esse número total de amigos é necessário para determinar o número da coluna em que devemos gravar o ID do novo amigo.
- Alteração de dados: remoção de um amigo:
- Precisamos ler toda a linha com a chave RowKey = "Vasya" e percorrer as colunas para encontrar aquela em que está registrado o amigo a ser deletado;
- Depois, após a remoção do amigo, precisamos "mover" todos os dados uma coluna para evitar "lacunas" na numeração.
Agora vamos avaliar quão eficientes serão os algoritmos que precisaremos implementar do lado da "aplicação condicional", usando Vamos designar o tamanho da nossa hipotética rede social como n. Então, o número máximo de amigos para um usuário pode ser (n-1). Este (-1) podemos ignorar para nossos propósitos, já que no âmbito da utilização da notação O, é insignificante.
- Leitura de dados: é necessário ler toda a linha e percorrer, em limite, todas as suas colunas. Assim, a estimativa superior dos custos será de aproximadamente O(n)
- Alteração de dados: adição de um amigo: para determinar a quantidade de amigos, é necessário percorrer todas as colunas da linha, após o que uma nova coluna deve ser inserida => O(n)
- Alteração de dados: remoção de um amigo:
- De maneira similar à adição – é necessário, em limite, percorrer todas as colunas => O(n)
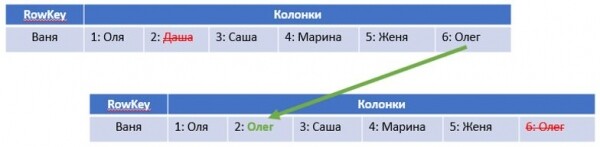
- Após a remoção das colunas, precisamos "deslocá-las". Se implementarmos isso de forma "direta", será necessário mais até (n-1) operações. No entanto, aqui e adiante, na parte prática, aplicaremos uma abordagem diferente que executará um "pseudo-deslocamento" em um número fixo de operações – ou seja, isso consumirá um tempo constante, independentemente de n. Esse tempo constante (sendo preciso, O(2)) em comparação com O(n) pode ser desprezado. A abordagem é ilustrada na figura abaixo: apenas copiamos os dados da "última" coluna para aquela da qual queremos remover os dados, após o que removemos a última coluna:

Assim, em todos os cenários, obtivemos uma complexidade computacional assintótica O(n).
Provavelmente, você já notou que quase sempre precisamos ler toda a linha da base de dados, e em dois de três casos, apenas para percorrer todas as colunas e contar o total de amigos. Portanto, como uma tentativa de otimização, podemos adicionar uma coluna "count", onde armazenamos o número total de amigos de cada usuário da rede. Dessa forma, podemos evitar ler toda a linha para contar o total de amigos, apenas lendo uma coluna "count". O principal é lembrar de atualizar a "count" ao manipular os dados. Assim, obtemos uma melhoria Opção 2 (count):
RowKey
Colunas
Vasya
1: Petya
2: Olya
3: Dasha
count: 3
Petya
1: Masha
2: Vasya
count: 2
Em comparação com a primeira opção:
- Leitura de dados: para obter a resposta à pergunta "Vasya lê Olya?" nada mudou => O(n)
- Alteração de dados: adição de um amigo: Simplificamos a inserção de um novo amigo, pois agora não precisamos ler toda a linha e percorrer suas colunas; podemos obter apenas o valor da coluna "count" e, assim, determinar imediatamente o número da coluna para inserir o novo amigo. Isso leva à redução da complexidade computacional para O(1)
- Alteração de dados: remoção de um amigo: Ao remover um amigo, também podemos usar essa coluna para reduzir o número de operações de entrada e saída ao "mover" os dados uma célula para a esquerda. No entanto, a necessidade de percorrer as colunas para encontrar aquela que deve ser removida ainda permanece, portanto => O(n)
- Por outro lado, agora, ao atualizar os dados, precisamos atualizar sempre a coluna "count", mas isso consome um tempo constante, que no contexto da notação O pode ser desconsiderado
No geral, a opção 2 parece um pouco mais otimizada, mas isso é mais uma "evolução em vez de uma revolução". Para realizar a "revolução", precisaremos Opção 3 (col).
Inverteremos tudo de "cabeça para baixo": designaremos o nome da coluna como identificador do usuário! O que será gravado na própria coluna – para nós já não importa, pode ser o número 1 (na verdade, algo útil que pode ser armazenado é, por exemplo, o grupo "família/amigos/e assim por diante"). Essa abordagem pode surpreender o "cidadão comum" despreparado, que não teve experiência anterior com bancos NoSQL, mas é exatamente isso que permite utilizar o potencial do HBase de forma muito mais eficaz nesta tarefa:
RowKey
Colunas
Vasya
Petr: 1
Olga: 1
Dasha: 1
Petya
Masha: 1
Vasya: 1
Aqui obtemos várias vantagens imediatamente. Para compreendê-las, analisaremos a nova estrutura e avaliaremos a complexidade computacional:
- Leitura de dados: para responder à pergunta se Vasya está seguindo Olga, basta ler uma coluna "Olga": se ela existir, a resposta é True; se não, é False => O(1)
- Alteração de dados: adição de um amigo: Adicionar um amigo: basta adicionar uma nova coluna "ID do amigo" => O(1)
- Alteração de dados: remoção de um amigo: basta excluir a coluna "ID do amigo" => O(1)
Como podemos ver, uma vantagem significativa desse modelo de armazenamento é que, em todos os cenários necessários, operamos apenas com uma coluna, evitando a leitura da linha inteira no banco de dados e, muito menos, o percurso de todas as colunas dessa linha. Poderíamos parar aqui, mas...
Pode-se pensar e ir um pouco mais longe no caminho da otimização de desempenho e redução das operações de entrada e saída ao acessar o banco de dados. E se armazenássemos todas as informações de conexão diretamente na chave da linha? Ou seja, fazer a chave composta do tipo userID.friendID? Nesse caso, nem precisaríamos ler as colunas da linha.Opção 4 (linha)):
RowKey
Colunas
Vasya.Petya
Petr: 1
Vasya.Olya
Olga: 1
Vasya.Dasha
Dasha: 1
Petya.Masha
Masha: 1
Petya.Vasya
Vasya: 1
É evidente que a avaliação de todos os cenários de manipulação de dados nessa estrutura, assim como na opção anterior, será O(1). A diferença em relação à opção 3 será exclusivamente na eficiência das operações de entrada e saída no banco de dados.
E o último "laço". É fácil notar que na opção 4, a chave da linha terá um comprimento variável, o que pode afetar o desempenho (lembramos que o HBase armazena dados como um conjunto de bytes e as linhas nas tabelas são ordenadas pela chave). Além disso, temos um separador que em alguns cenários pode precisar ser tratado. Para excluir essa influência, pode-se usar hashes de userID e friendID, e como ambos os hashes terão comprimento constante, pode-se simplesmente concatená-los, sem separador. Assim, os dados na tabela seriam assim:Opção 5 (hash)):
RowKey
Colunas
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petr: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olga: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasya: 1
É evidente que a complexidade algorítmica de trabalhar com tal estrutura nos cenários discutidos será a mesma da opção 4 – ou seja, O(1).
Portanto, vamos resumir todas as nossas estimativas de complexidade computacional em uma tabela:
Adicionar amigo
Verificar amigo
Remover amigo
Opção 1 (padrão)
O(n)
O(n)
O(n)
Opção 2 (contar)
O(1)
O(n)
O(n)
Opção 3 (coluna)
O(1)
O(1)
O(1)
Opção 4 (linha)
O(1)
O(1)
O(1)
Opção 5 (hash)
O(1)
O(1)
O(1)
Como pode ser visto, as opções 3-5 parecem as mais preferíveis e teoricamente garantem a execução de todos os cenários necessários de manipulação de dados em tempo constante. No contexto do nosso problema, não há um requisito explícito para obter a lista de todos os amigos do usuário, mas na prática, como bons analistas, seria prudente "prever" que essa tarefa pode surgir e "preparar-se" para isso. Portanto, minha preferência está do lado da opção 3. No entanto, é bem provável que em um projeto real essa solicitação já tenha sido resolvida por outros meios, portanto, sem uma visão geral de toda a tarefa, é melhor não tirar conclusões definitivas.
Preparação do experimento
Gostaríamos de testar as teorias acima na prática – esse era o objetivo da ideia que surgiu durante um longo fim de semana. Para isso, é necessário avaliar a velocidade de operação do nosso "aplicativo condicional" em todos os cenários de uso do banco de dados, bem como o aumento desse tempo com o crescimento do tamanho da rede social (n). O parâmetro-alvo que nos interessa e que vamos medir durante o experimento é o tempo gasto pelo "aplicativo condicional" para executar uma "operação de negócios". Por "operação de negócios", entendemos uma das seguintes:
- Adicionar um novo amigo
- Verificar se o usuário A é amigo do usuário B
- Remover um amigo
Assim, levando em conta os requisitos estabelecidos na formulação inicial, o cenário de verificação se apresenta da seguinte forma:
- Gravar dados. Gerar aleatoriamente uma rede inicial de tamanho n. Para uma maior aproximação ao "mundo real", o número de amigos de cada usuário também deve ser uma variável aleatória. Medir o tempo que o nosso "aplicativo condicional" levará para gravar todos os dados gerados no HBase. Em seguida, dividir o tempo obtido pelo total de amigos adicionados – assim obteremos o tempo médio para uma "operação de negócios".
- Leitura de dados. Para cada usuário, elaborar uma lista de "identidades" para as quais deve-se verificar se o usuário está ou não inscrito. O comprimento da lista deve ser aproximadamente igual ao número de amigos do usuário, onde metade dos amigos verificados deve resultar em "Sim" e a outra metade em "Não". A verificação deve ser feita em uma ordem que alterne as respostas "Sim" e "Não" (ou seja, em cada segundo caso, teremos que percorrer todas as colunas da linha para as opções 1 e 2). O tempo total de verificação deve ser dividido pelo número de amigos verificados para obter o tempo médio para checar um único sujeito.
- Remoção de dados. Remover todos os amigos do usuário. A ordem de remoção deve ser aleatória (ou seja, "embaralhar" a lista original utilizada para gravar os dados). O tempo total de verificação deve ser dividido pelo número de amigos removidos para obter o tempo médio para uma verificação.
Os cenários devem ser executados para cada um dos 5 modelos de dados e para diferentes tamanhos de redes sociais, para observar como o tempo muda conforme cresce. Dentro de uma conexão de n na rede, a lista de usuários para verificação deve ser, naturalmente, a mesma para todas as 5 variantes.
Para melhor compreensão, abaixo está um exemplo de dados gerados para n= 5. O "gerador" escrito fornece três dicionários de IDs:
- o primeiro – para inserção
- o segundo – para verificação
- o terceiro – para remoção
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # total de 15 amigos

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # total de 18 sujeitos verificados

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # total de 15 amigos
Como pode ser observado, todos os IDs maiores que 10.000 no dicionário para verificação são justamente aqueles que, por definição, darão uma resposta Falsa. A inserção, verificação e remoção de "amigos" são realizadas exatamente na sequência indicada no dicionário.
O experimento foi realizado em um notebook rodando Windows 10, onde uma instância do HBase estava em um contêiner Docker e Python com Jupyter Notebook em outro. O Docker recebeu 2 núcleos de CPU e 2 GB de memória RAM. Toda a lógica, tanto para emular a operação de um "aplicativo condicional", quanto a "interface" para gerar dados de teste e medir o tempo, foi escrita em Python. Para trabalhar com HBase, foi utilizada a biblioteca , para o cálculo de hashes (MD5) para a variante 5 — hashlib
Considerando a potência de cálculo do laptop específico, foi escolhido experimentalmente um teste para n = 10, 30, … 170 – quando o tempo total de execução de todo o ciclo de testes (todos os cenários para todas as variantes para todos os n) ainda era mais ou menos razoável e cabia no tempo de um intervalo para o chá (em média 15 minutos).
Aqui é necessário fazer uma observação de que neste experimento, primeiramente, não estamos avaliando os números absolutos de desempenho. Mesmo a comparação relativa entre duas variantes pode não ser totalmente precisa. Atualmente, estamos interessados precisamente na natureza da mudança do tempo em função de n, pois, considerando a configuração do 'banco de testes' mencionado acima, obter estimativas de tempo que sejam 'limpas' da influência de fatores aleatórios e outros é muito difícil (e tal tarefa não foi proposta).
Resultado do experimento
O primeiro teste – como muda o tempo gasto para preencher a lista de amigos. O resultado – no gráfico abaixo.
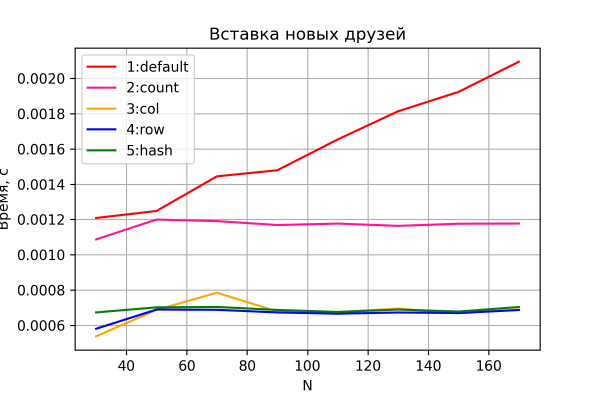
As variantes 3-5 mostram, como era esperado, um tempo praticamente constante para a 'operação comercial', que não depende do aumento do tamanho da rede e uma diferença de desempenho indistinguível.
A variante 2 também mostra um desempenho constante, mas um pouco pior, sendo praticamente exatamente 2 vezes em relação às variantes 3-5. E isso não pode deixar de ser encorajador, pois corresponde à teoria – nesta variante, o número de operações de entrada e saída em/para o HBase é exatamente 2 vezes maior. Isso pode servir como uma indicação indireta de que nosso banco de testes, em princípio, fornece uma boa precisão.
A variante 1, como era esperado, se revela a mais lenta e demonstra um aumento linear do tempo gasto para adicionar um amigo em função do tamanho da rede.
Agora vamos analisar os resultados do segundo teste.
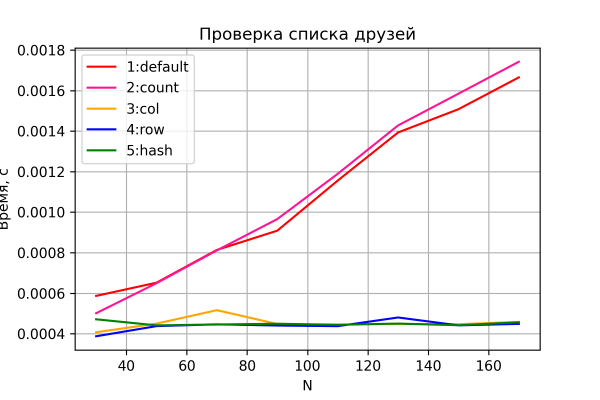
As opções 3-5, novamente, se comportam como esperado - tempo constante, não dependente do tamanho da rede. As opções 1 e 2 demonstram um aumento linear no tempo à medida que o tamanho da rede cresce e apresentam desempenho semelhante. Notavelmente, a opção 2 se mostra um pouco mais lenta - aparentemente devido à necessidade de ler e processar a coluna adicional "count", o que se torna mais perceptível com o aumento de n. No entanto, ainda me absterei de qualquer conclusão, uma vez que a precisão desta comparação relativamente é baixa. Além disso, essas relações (qual opção, 1 ou 2, é mais rápida) mudaram de execução para execução (mantendo, no entanto, a natureza da dependência e "indo lado a lado").
E o último gráfico - o resultado do teste de exclusão.
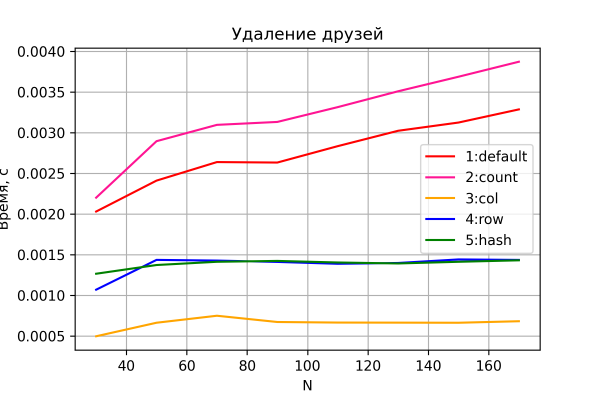
Aqui, novamente, sem surpresas. As opções 3-5 realizam a exclusão em tempo constante.
O interessante é que as opções 4 e 5, ao contrário dos cenários anteriores, mostram um desempenho um pouco pior do que a opção 3. Aparentemente, a operação de exclusão de linha é mais custosa do que a operação de exclusão de coluna, o que é logicamente compreensível.
As opções 1 e 2, como esperado, demonstram um aumento linear no tempo. Neste caso, a opção 2 é consistentemente mais lenta que a opção 1 - devido à operação de entrada/saída adicional para "manter" a coluna count.
Conclusões gerais do experimento:
- As opções 3-5 demonstram maior eficiência, pois aproveitam as vantagens do HBase; além disso, seu desempenho varia entre si em uma constante e não depende do tamanho da rede.
- A diferença entre as opções 4 e 5 não foi registrada. Mas isso não significa que a opção 5 não deva ser utilizada. É bem possível que o cenário experimental usado, levando em consideração as especificações do banco de testes, não tenha permitido identificá-la.
- O padrão de crescimento do tempo necessário para realizar "operações de negócios" com os dados confirmou, em geral, as conclusões teóricas obtidas anteriormente para todas as opções.
Epílogo
Experimentos rudimentares não devem ser considerados como verdade absoluta. Existem muitos fatores que não foram levados em conta e que distorceram os resultados (especialmente visíveis nos gráficos com um tamanho de rede pequeno). Por exemplo, a velocidade de operação do thrift, que é usado pelo happybase, o volume e a forma de implementação da lógica que eu escrevi em Python (não posso afirmar que o código foi otimizado e utilizou eficientemente todas as capacidades dos componentes), e talvez as particularidades do cache do HBase, a atividade em segundo plano do Windows 10 no meu notebook, etc. Em geral, pode-se afirmar que todas as deduções teóricas mostraram experimentalmente sua validade. Ou, pelo menos, não foi possível refutá-las com um ataque direto.
Em conclusão — recomendações para todos que estão começando a projetar modelos de dados no HBase: abstraia-se da experiência anterior com bancos de dados relacionais e lembre-se dos "mandamentos":
- Ao projetar, parta da tarefa e dos padrões de manipulação de dados, e não do modelo do domínio.
- Acesso eficiente (sem varredura total da tabela) – apenas pela chave.
- Desnormalização.
- Linhas diferentes podem conter colunas diferentes.
- Composição dinâmica de colunas.
Fonte: habr.com
