

No Linux, há uma grande quantidade de ferramentas para depuração do núcleo e de aplicativos. A maioria delas impacta negativamente o desempenho dos aplicativos e não pode ser usada em produção.
Há alguns anos, — eBPF. Ele permite rastrear o núcleo e aplicativos de usuário com baixa sobrecarga e sem a necessidade de recompilar programas ou carregar módulos de terceiros no núcleo.
Atualmente, já existem várias utilidades que usam eBPF, e neste artigo vamos explorar como escrever nossa própria utilidade para perfilamento baseada na biblioteca . O artigo é baseado em eventos reais. Seguiremos desde o surgimento do problema até a sua resolução para mostrar como as utilidades já existentes podem ser usadas em situações específicas.
Ceph É Lento
Foi adicionado um novo host ao cluster Ceph. Após a migração de parte dos dados para ele, notamos que a velocidade de processamento das solicitações de gravação era bem mais baixa do que nos outros servidores.
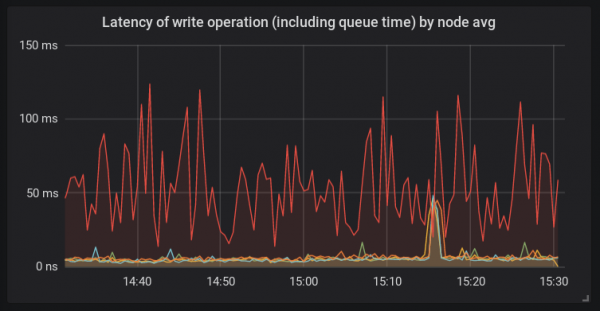
Ao contrário de outras plataformas, neste host foi utilizado bcache e um novo núcleo Linux 4.15. Um host dessa configuração foi utilizado aqui pela primeira vez. E, naquele momento, estava claro que a raiz do problema poderia teoricamente ser qualquer coisa.
Investigando o Host
Começaremos verificando o que acontece dentro do processo ceph-osd. Para isso, utilizaremos e (sobre o qual você pode ler mais ):
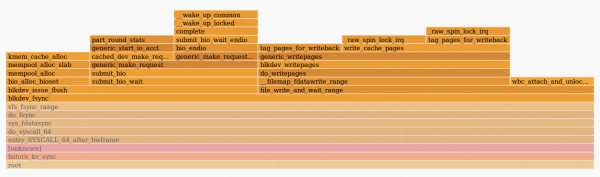
A imagem nos diz que a função fdatasync() demorou muito tempo ao enviar uma solicitação na função generic_make_request(). Isso significa que, provavelmente, a causa dos problemas está fora do próprio demônio osd. Isso pode ser tanto o núcleo quanto os discos. A saída do iostat mostrava alta latência no processamento das solicitações pelos discos bcache.
Ao verificar o host, descobrimos que o demônio systemd-udevd estava consumindo uma quantidade significativa de tempo de CPU — cerca de 20% em vários núcleos. Esse comportamento é estranho, então precisamos descobrir sua causa. Como o Systemd-udevd trabalha com eventos de uevent, decidimos observar esses eventos através de udevadm monitor. Aparentemente, estava sendo gerado um grande número de eventos de mudança para cada dispositivo de bloco no sistema. Isso é bastante incomum, então precisaremos investigar o que está gerando todos esses eventos.
Usando o BCC Toolkit
Como já descobrimos, o núcleo (e o demônio ceph na chamada do sistema) está gastando muito tempo em generic_make_request(). Vamos tentar medir a velocidade desta função. Em já existe uma ótima ferramenta — funclatency. Vamos rastrear o demon pelo seu PID com um intervalo de saída de informações de 1 segundo e mostrar o resultado em milissegundos.
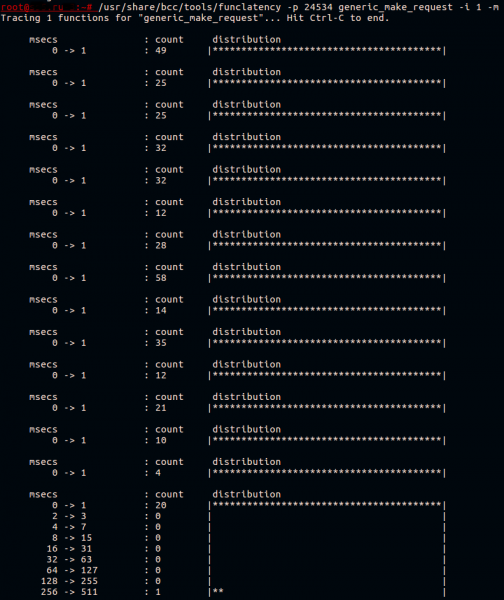
Normalmente, essa função funciona rapidamente. Tudo o que ela faz é passar a solicitação para a fila do driver do dispositivo.
Bcache é um dispositivo complexo que na verdade consiste em três discos:
- dispositivo de apoio (disco em cache), neste caso um HDD lento;
- dispositivo de cache (disco de cache), aqui é uma partição do dispositivo NVMe;
- dispositivo virtual bcache, com o qual o aplicativo trabalha.
Sabemos que a transmissão da solicitação está lenta, mas para qual desses dispositivos? Vamos entender isso mais tarde.
Agora sabemos que os ueventos provavelmente estão causando problemas. Descobrir o que exatamente os gera não é tão fácil. Vamos supor que seja algum software que é executado periodicamente. Vamos ver quais programas estão sendo executados no sistema, usando o script execsnoop do mesmo . Vamos executá-lo e direcionar a saída para um arquivo.
Por exemplo, assim:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Não vamos fornecer aqui a saída completa do execsnoop, mas uma linha que nos interessou se parecia assim:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
A terceira coluna é o PPID (PID pai) do processo. O processo com PID 5802 era uma das threads do nosso sistema de monitoramento. Ao verificar a configuração do sistema de monitoramento, foram encontrados parâmetros incorretamente definidos. A temperatura do adaptador HBA estava sendo registrada a cada 30 segundos, o que era muito mais frequente do que o necessário. Após alterar o intervalo de verificação para um mais longo, descobrimos que o atraso no processamento das solicitações neste host deixou de se destacar em relação aos outros hosts.
Mas ainda não é claro por que o dispositivo bcache estava tão lento. Preparamos uma plataforma de teste com configuração idêntica e tentamos reproduzir o problema, executando fio no bcache, acionando periodicamente o udevadm trigger para gerar uevents.
Escrevendo Ferramentas Baseadas em BCC
Vamos tentar escrever uma utilidade simples para rastrear e exibir na tela as chamadas mais lentas generic_make_request(). Também nos interessa o nome do disco para o qual essa função foi chamada.
O plano é simples:
- Registramos kprobe para generic_make_request():
- Armazenamos em memória o nome do disco, disponível através do argumento da função;
- Armazenamos a marca de tempo.
- Registramos kretprobe no retorno de generic_make_request():
- Obtemos o timestamp atual;
- Buscamos o timestamp salvo e comparamos com o atual;
- Se o resultado for maior que o especificado, encontramos o nome do disco salvo e exibimos no terminal.
Kprobes e kretprobes usam o mecanismo de pontos de interrupção para modificar o código das funções em tempo real. Você pode ler e artigo sobre o assunto. Se olharmos o código de várias utilidades em , podemos notar que elas têm uma estrutura idêntica. Portanto, neste artigo, pularemos a análise dos argumentos do script e iremos diretamente ao programa BPF.
O texto eBPF dentro do script Python é o seguinte:
bpf_text = “”” # Aqui estará o código do programa bpf “””
Para a troca de dados entre funções, os programas eBPF utilizam . Faremos o mesmo. Usaremos o PID do processo como chave e definiremos a estrutura como valor:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Aqui registramos a tabela hash, chamada p, com chave do tipo u64 e valor do tipo struct data_t. A tabela estará disponível no contexto do nosso programa BPF. O macro BPF_PERF_OUTPUT registra outra tabela, chamada events, que é usada para para o espaço do usuário.
Ao medir atrasos entre a chamada de uma função e seu retorno, ou entre chamadas de diferentes funções, é preciso levar em conta que os dados obtidos devem pertencer a um único contexto. Em outras palavras, é importante estar ciente da possível execução paralela de funções. Temos a possibilidade de medir o atraso entre a chamada de uma função no contexto de um processo e o retorno dessa função no contexto de outro processo, mas isso provavelmente será inútil. Um bom exemplo aqui pode ser , onde como chave da tabela hash é definido um ponteiro para struct request, que reflete uma única solicitação ao disco.
Em seguida, precisamos escrever um código que será executado ao chamar a função em análise:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Aqui, como segundo argumento, será substituído o primeiro argumento da função chamada. . Depois disso, obtemos o PID do processo no contexto do qual estamos trabalhando e o timestamp atual em nanosegundos. Registramos tudo isso em uma estrutura recém-alocada struct data_t data. O nome do disco é obtido da estrutura bio, que é passada na chamada generic_make_request(), e o salvamos na mesma estrutura data. O último passo é adicionar a entrada na tabela hash mencionada anteriormente.
A próxima função será chamada ao retornar de generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Esta função é semelhante à anterior: obtemos o PID do processo e o timestamp, mas não alocamos memória para uma nova estrutura data. Em vez disso, procuramos na tabela hash uma estrutura existente pela chave == PID atual. Se a estrutura for encontrada, obtemos o nome do processo em execução e o adicionamos a ela.
O deslocamento binário que usamos aqui serve para obter o GID da thread, ou seja, o PID do processo principal que iniciou a thread, no contexto do qual estamos trabalhando. A função que chamamos retorna tanto o GID da thread como o seu PID em um único valor de 64 bits.
Ao imprimir no terminal, agora não estamos interessados na thread, mas sim no processo principal. Após comparar a latência obtida com o limiar definido, passamos nossa estrutura data para o espaço do usuário através da tabela events, e então removemos a entrada de p.
No script Python que vai carregar este código, precisamos substituir MIN_US e FACTOR pelos limiares de latência e unidade de tempo que passaremos como argumentos:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Agora precisamos preparar o programa BPF através do e registrar os probes:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request", fn_name="start")
b.attach_kretprobe(event="generic_make_request", fn_name="stop")
Também precisaremos definir struct data_t no nosso script, caso contrário nada será lido:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk", ct.c_char * DISK_NAME_LEN)]
A última etapa é a saída dos dados no terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# formatação da saída
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
O próprio script está disponível em . Vamos tentar executá-lo em uma plataforma de teste que executa fio, gravando em bcache, e chamar udevadm monitor:
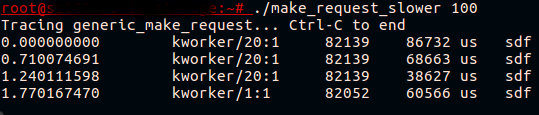
Finalmente! Agora vemos que o que parecia ser um dispositivo bcache lento, na verdade é uma chamada lenta generic_make_request() para o disco em cache.
Aprofunde-se no Kernel
O que está realmente causando a lentidão durante a transmissão da solicitação? Vemos que a latência ocorre mesmo antes do início da contagem da solicitação, ou seja, o registro de uma solicitação específica para estatísticas posteriores (proc/diskstats ou iostat) ainda não começou. Isso pode ser facilmente verificado ao executar iostat durante a reprodução do problema, ou , que se baseia no início e no fim da contagem das solicitações. Nenhuma dessas utilidades mostrará problemas nas solicitações para o disco em cache.
Se olharmos para a função generic_make_request(), veremos que antes do início da contagem da solicitação, duas outras funções são chamadas. A primeira é generic_make_request_checks(), que realiza verificações de legitimidade da solicitação em relação às configurações do disco. A segunda é , que possui uma chamada interessante :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Nela, o kernel aguarda a descongelamento da fila. Vamos medir a latência blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Rastreando 1 funções para "blk_queue_enter"... Pressione Ctrl-C para encerrar.

 	msecs           	: contagem 	distribuição
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: contagem 	distribuição
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: contagem 	distribuição
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Parece que estamos perto da solução. As funções utilizadas para "congelar/descongelar" a fila são e . Elas são usadas quando há necessidade de modificar as configurações da fila de solicitações, potencialmente perigosas para as solicitações presentes nessa fila. Ao chamar blk_mq_freeze_queue() pela função o contador é incrementado. q->mq_freeze_depth. Depois disso, o núcleo espera até que a fila seja esvaziada em .
O tempo de espera para limpar esta fila é equivalente ao atraso do disco, pois o núcleo aguarda a conclusão de todas as operações enfileiradas. Assim que a fila é esvaziada, as alterações de configuração são aplicadas. Depois disso, é chamado , que decrementa o contador freeze_depth.
Agora sabemos o suficiente para corrigir a situação. O comando udevadm trigger resulta na aplicação de configurações ao dispositivo de bloco. Essas configurações estão descritas nas regras do udev. Podemos descobrir quais configurações 'congelam' a fila, tentando alterá-las através do sysfs ou examinando o código-fonte do núcleo. Além disso, podemos tentar a ferramenta BCC , que exibirá no terminal as trilhas da pilha do núcleo e do espaço do usuário para cada chamada de blk_freeze_queue, por exemplo:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
As regras do udev mudam raramente e geralmente isso acontece sob controle. Portanto, vemos que até a aplicação de valores já definidos causa um aumento na latência de envio de solicitações do aplicativo para o disco. Claro, gerar eventos udev quando não há mudanças na configuração dos discos (por exemplo, se o dispositivo não está conectado/desconectado) não é uma boa prática. No entanto, podemos ajudar o núcleo a não fazer trabalho desnecessário e não 'congelar' a fila de solicitações, a menos que haja realmente a necessidade. corrigem a situação.
Conclusão
eBPF é uma ferramenta muito flexível e poderosa. Neste artigo, examinamos um caso prático e demonstramos uma pequena parte do que é possível fazer. Se você está interessado no desenvolvimento de utilitários BCC, vale a pena dar uma olhada no , que descreve bem os fundamentos do funcionamento.
Existem também outras ferramentas interessantes para depuração e profilamento baseadas em eBPF. Uma delas é , que permite escrever potentes one-liners e pequenos programas em uma linguagem semelhante ao awk. Outra é , que permite coletar métricas de baixo nível de alta resolução diretamente em seu servidor prometheus, com a possibilidade de obter visualizações agradáveis e até alertas posteriormente.
Fonte: habr.com
