

Meu trabalho principal é, na maior parte, o despacho de sistemas de software, ou seja, passo muito tempo tentando responder a perguntas como estas:
- O software funciona para o desenvolvedor, mas não para mim. Por quê?
- Ontem o software funcionava para mim, mas hoje não. Por quê?
Isso é uma espécie de depuração que difere um pouco da depuração convencional de software. A depuração convencional trata da lógica do código, enquanto a depuração de despacho envolve a interação entre o código e o ambiente. Mesmo que a raiz do problema seja um erro lógico, o fato de que em uma máquina tudo funciona, mas em outra não, significa que o problema está, de alguma forma, no ambiente.
Portanto, em vez de ferramentas comuns de depuração, como gdb tenho um conjunto diferente de ferramentas para depuração de despacho. E minha ferramenta favorita para resolver o problema do tipo "Por que este software não funciona para mim?" chama-se strace.
O que é strace?
— é uma ferramenta para "rastrear chamadas de sistema". Foi criada originalmente para o Linux, mas as mesmas funcionalidades de depuração podem ser aplicadas com ferramentas para outros sistemas ( ou ).
A aplicação principal é muito simples. Basta executar o strace com qualquer comando e ele enviará um dump de todas as chamadas de sistema (embora, provavelmente, você precise instalar o próprio strace):
$ strace echo Hello
...Recorte de muitas informações...
write(1, "Hellon", 6)                  = 6
close(1)                                = 0
close(2)                                = 0
exit_group(0)                           = ?
+++ saiu com 0 +++
O que são essas chamadas de sistema? Elas são algo como uma API para o núcleo do sistema operacional. Há muito tempo, os softwares tinham acesso direto ao "hardware" sobre o qual operavam. Se, por exemplo, era necessário exibir algo na tela, ele interagia com as portas e/ou registradores de vídeo mapeados na memória. Quando os sistemas de computação multitarefa se tornaram populares, reinou o caos, pois diferentes aplicativos competiam pelo "hardware". Erros em um aplicativo poderiam derrubar o funcionamento dos outros, se não do sistema inteiro. Então, modos de privilégio (ou "proteção em anel") foram introduzidos no CPU. O núcleo se tornou o mais privilegiado: ele obtinha acesso total ao "hardware", criando aplicativos menos privilegiados que precisavam solicitar acesso ao núcleo para interagir com o "hardware" — através de chamadas de sistema.
No nível binário, a chamada do sistema é um pouco diferente da simples chamada de função, no entanto, a maioria dos programas utiliza uma camada na biblioteca padrão. Ou seja, a biblioteca padrão POSIX C contém a chamada de função write(), que contém todo o código dependente da arquitetura para a chamada do sistema exit.
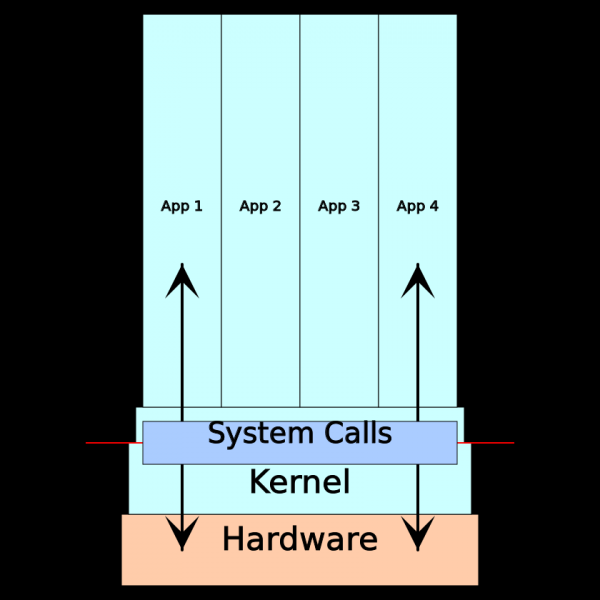
Em resumo, qualquer interação de um aplicativo com seu ambiente (sistemas de computador) é realizada por meio de chamadas de sistema. Portanto, quando o software funciona em uma máquina, mas não em outra, é bom olhar os resultados do rastreamento das chamadas de sistema. Se quisermos ser mais específicos, aqui está uma lista de momentos típicos que podem ser analisados com a ajuda do rastreamento de chamadas de sistema:
- Entrada e saída no console
- Entrada e saída de rede
- Acesso ao sistema de arquivos e entrada e saída de arquivos
- Gerenciamento do ciclo de vida do processo/threads
- Gerenciamento de memória de baixo nível
- Acesso a drivers de dispositivos especiais
Quando usar o strace?
Em teoria, strace é usado com qualquer programa em espaço do usuário, pois qualquer programa nesse espaço deve fazer chamadas de sistema. Ele funciona de forma mais eficiente com programas compiláveis e de baixo nível, mas também funciona com linguagens de alto nível como Python, se for possível superar o ruído adicional do ambiente de execução e do interpretador.
Todo o seu esplendor strace se manifesta durante a depuração de software que funciona bem em uma máquina, mas de repente para de funcionar em outra, apresentando mensagens confusas sobre arquivos, permissões ou tentativas fracassadas de executar alguns comandos ou algo assim... É uma pena, mas não combina tão bem com problemas de alto nível, como erros de validação de certificado. Normalmente, é necessário uma combinação strace, às vezes e ferramentas de nível superior (como uma ferramenta de linha de comando openssl para depuração de certificado).
Por exemplo, consideramos o trabalho em um servidor isolado, mas o rastreamento das chamadas de sistema pode muitas vezes ser realizado em plataformas de implantação mais complexas. Apenas é necessário escolher as ferramentas certas.
Exemplo de depuração simples
Digamos que você deseja iniciar um incrível aplicativo de servidor foo, mas o que você obtém é isso:
$ foo
Erro ao abrir o arquivo de configuração: Não existe tal arquivo ou diretório
É claro que ele não conseguiu encontrar o arquivo de configuração que você escreveu. Isso acontece porque, às vezes, quando os gerenciadores de pacotes estão compilando o aplicativo, eles redefinem o local esperado dos arquivos. E ao seguir o guia de instalação para uma distribuição, você encontra os arquivos em locais completamente diferentes do que esperava. O problema poderia ser resolvido em poucos segundos se a mensagem de erro indicasse onde procurar o arquivo de configuração, mas não faz isso. Então, onde procurar?
Se você tem acesso ao código-fonte, pode lê-lo e descobrir tudo. Um bom plano alternativo, mas não é a solução mais rápida. Você pode usar um depurador passo a passo como gdb e ver o que o programa está fazendo, mas é muito mais eficaz usar uma ferramenta projetada especificamente para mostrar a interação com o ambiente: strace.
Saída strace pode parecer excessivo, mas a boa notícia é que a maior parte pode ser ignorada. Muitas vezes, é útil usar o operador -o para salvar os resultados da rastreabilidade em um arquivo separado:
$ strace -o /tmp/trace foo
Erro ao abrir o arquivo de configuração: Arquivo ou diretório não encontrado
$ cat /tmp/trace
execve("foo", ["foo"], 0x7ffce98dc010 /* 16 vars */) = 0
brk(NULL)                               = 0x56363b3fb000
access("/etc/ld.so.preload", R_OK)      = -1 ENOENT (Arquivo ou diretório não encontrado)
openat(AT_FDCWD, "/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
fstat(3, {st_mode=S_IFREG|0644, st_size=25186, ...}) = 0
mmap(NULL, 25186, PROT_READ, MAP_PRIVATE, 3, 0) = 0x7f2f12cf1000
close(3)                                = 0
openat(AT_FDCWD, "/lib/x86_64-linux-gnu/libc.so.6", O_RDONLY|O_CLOEXEC) = 3
read(3, "177ELF2113 3 > 1 260A2 "..., 832) = 832
fstat(3, {st_mode=S_IFREG|0755, st_size=1824496, ...}) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f2f12cef000
mmap(NULL, 1837056, PROT_READ, MAP_PRIVATE|MAP_DENYWRITE, 3, 0) = 0x7f2f12b2e000
mprotect(0x7f2f12b50000, 1658880, PROT_NONE) = 0
mmap(0x7f2f12b50000, 1343488, PROT_READ|PROT_EXEC, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x22000) = 0x7f2f12b50000
mmap(0x7f2f12c98000, 311296, PROT_READ, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x16a000) = 0x7f2f12c98000
mmap(0x7f2f12ce5000, 24576, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x1b6000) = 0x7f2f12ce5000
mmap(0x7f2f12ceb000, 14336, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0) = 0x7f2f12ceb000
close(3)                                = 0
arch_prctl(ARCH_SET_FS, 0x7f2f12cf0500) = 0
mprotect(0x7f2f12ce5000, 16384, PROT_READ) = 0
mprotect(0x56363b08b000, 4096, PROT_READ) = 0
mprotect(0x7f2f12d1f000, 4096, PROT_READ) = 0
munmap(0x7f2f12cf1000, 25186)           = 0
openat(AT_FDCWD, "/etc/foo/config.json", O_RDONLY) = -1 ENOENT (Arquivo ou diretório não encontrado)
dup(2)                                  = 3
fcntl(3, F_GETFL)                       = 0x2 (flags O_RDWR)
brk(NULL)                               = 0x56363b3fb000
brk(0x56363b41c000)                     = 0x56363b41c000
fstat(3, {st_mode=S_IFCHR|0620, st_rdev=makedev(0x88, 0x8), ...}) = 0
write(3, "Erro ao abrir o arquivo de configuração"..., 60) = 60
close(3)                                = 0
exit_group(1)                           = ?
+++ saiu com 1 +++
Cerca de toda a primeira página da saída strace — isso geralmente é preparação de baixo nível para a execução. (Muitos chamados mmap, mprotect, brk para coisas como detecção de memória de baixo nível e mapeamento de bibliotecas dinâmicas.) Na verdade, durante a depuração, as saídas strace são melhor lidas do final para o começo. No fundo haverá uma chamada exit, que produz uma mensagem de erro. Olhando acima, vemos a primeira chamada de sistema com erro — a chamada openat, que gera um erro ENOENT ('arquivo ou diretório não encontrado'), tentando abrir /etc/foo/config.json. Aqui é onde o arquivo de configuração deve estar.
Isso foi apenas um exemplo, mas eu diria que 90% do tempo em que uso strace, nada muito mais complicado precisa ser feito. Abaixo está um guia passo a passo completo para depuração:
- Ficar frustrado com uma mensagem de erro vaga do sistema da aplicação
- Reiniciar a aplicação com strace
- Encontrar na saída da rastreação a mensagem de erro
- Ir para cima, até encontrar a primeira chamada de sistema com falha
É bem provável que a chamada de sistema na 4ª etapa mostre o que deu errado.
Dicas
Antes de mostrar um exemplo de depuração mais complexa, vou compartilhar algumas dicas para um uso eficaz. strace:
man — seu amigo
Em muitos sistemas *nix, você pode obter a lista completa das chamadas de sistema do núcleo executando man syscalls. Você verá coisas como brk(2), o que significa que mais informações podem ser obtidas executando man 2 brk.
Pequenas armadilhas: man 2 fork mostra para mim a página do shell fork() em GNU libc, que, por acaso, é implementado por meio da chamada clone(). A semântica da chamada fork permanecendo a mesma, se você escrever um programa que use fork(), e executar a rastreabilidade — eu não encontrarei chamadas fork, em vez disso, haverá clone(). Essas armadilhas simplesmente confundem se você começar a comparar a fonte com a saída. strace.
Use -o para salvar a saída em um arquivo
strace pode gerar uma saída extensa, então muitas vezes é útil armazenar os resultados da rastreabilidade em arquivos separados (como no exemplo acima). Isso também ajuda a não confundir a saída do programa com a saída strace no console.
Use -s para visualizar mais dados do argumento
Você provavelmente notou que a segunda metade da mensagem de erro não foi mostrada no exemplo de rastreabilidade acima. Isso ocorre porque strace por padrão, mostra apenas os primeiros 32 bytes do argumento da string. Se você quiser ver mais, adicione algo como -s 128 à chamada strace.
-u facilita o rastreamento de sockets de arquivo e outros.
"Tudo é um arquivo" significa que sistemas *nix realizam todas as entradas e saídas usando descritores de arquivo, seja aplicável a um arquivo ou rede, ou canais entre processos. Isso é conveniente para programação, mas dificulta acompanhar o que realmente está acontecendo quando você vê resultados gerais write e exit na rastreabilidade da chamada do sistema.
Ao adicionar o operador -u, você fará com que strace anote cada descritor de arquivo na saída com uma nota sobre para onde ele aponta.
Anexe a um processo já em execução com -p**
Como pode ser visto no exemplo abaixo, às vezes é necessário rastrear um programa que já está em execução. Se você souber que ele está em execução como o processo 1337 (digamos, a partir das saídas ps), você pode rastrear assim:
$ strace -p 1337
...saída da rastreabilidade da chamada do sistema...
Você pode precisar de privilégios de root.
Use -f para seguir processos filhos
strace Por padrão, traça apenas um processo. Se esse processo gera processos filhos, você pode ver a chamada do sistema para a criação do processo filho, mas as chamadas do sistema do processo filho não serão exibidas.
Se você achar que o erro está no processo filho, use o operador --follow, isso ativará sua rastreabilidade. O lado negativo disso é que a saída vai confundi-lo ainda mais. Quando strace rastreia um processo ou um ramo, ele mostra um único fluxo de eventos de chamadas. Quando rastreia vários processos ao mesmo tempo, você pode ver o início de uma chamada interrompida por uma mensagem <unfinished …>, então um monte de chamadas para outros ramos de execução, e só depois o término do primeiro com <… foocall resumed>. Ou divida todos os resultados do rastreamento em arquivos diferentes, usando também o operador -ff (detalhes em para strace).
Filtre o rastreio usando -e
Como você pode ver, o resultado do rastreio é uma verdadeira pilha de todas as possíveis chamadas de sistema. Com a flag -e é possível filtrar o rastreio (veja para strace). A principal vantagem é que executar um rastreio com filtragem é mais rápido do que fazer um rastreio completo e depois grep`á. Para ser honesto, eu quase sempre não me importo.
Nem todos os erros são ruins
Um exemplo simples e comum é um programa que procura um arquivo em vários lugares ao mesmo tempo, como um shell procurando onde o executável está armazenado na lixeira:
$ strace sh -c uname
...
stat("/home/user/bin/uname", 0x7ffceb817820) = -1 ENOENT (Arquivo ou diretório não encontrado)
stat("/usr/local/bin/uname", 0x7ffceb817820) = -1 ENOENT (Arquivo ou diretório não encontrado)
stat("/usr/bin/uname", {st_mode=S_IFREG|0755, st_size=39584, ...}) = 0
...
A heurística do tipo "última solicitação com falha antes da mensagem de erro" é boa para encontrar erros relevantes. De qualquer forma, é lógico começar pelo fim.
Os manuais de programação em C ajudam muito a entender chamadas de sistema.
As chamadas padrão para bibliotecas C não são chamadas de sistema, mas apenas uma fina camada superficial. Então, se você entender um pouco como e o que fazer em C, será mais fácil entender os resultados do rastreio de chamadas de sistema. Por exemplo, se você tiver problemas ao depurar chamadas a sistemas de rede, consulte o clássico .
Um exemplo de depuração mais complicado.
Já mencionei que um exemplo simples de depuração é algo com que lidei na maior parte do meu trabalho com strace. No entanto, às vezes é necessário um verdadeiro investigação, então aqui está um exemplo de depuração um pouco mais complicada.
— um agendador de tarefas, outra implementação de daemon *nix cron. Ele está instalado no servidor, mas quando alguém tenta editar a programação, isso é o que acontece:
# crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
Então, bcron ele tentou escrever um arquivo, mas não conseguiu e não admite o porquê. Vamos investigar strace:
# strace -o /tmp/trace crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
# cat /tmp/trace
...
openat(AT_FDCWD, "bcrontab.14779.1573691864.847933", O_RDONLY) = 3
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
read(3, "#Ansible: logsaggn20 14 * * * lo"..., 8192) = 150
read(3, "", 8192)                       = 0
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
socket(AF_UNIX, SOCK_STREAM, 0)         = 3
connect(3, {sa_family=AF_UNIX, sun_path="/var/run/bcron-spool"}, 110) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
write(3, "156:Slogs #Ansible: logsaggn20 1"..., 161) = 161
read(3, "32:ZCould not create temporary f"..., 8192) = 36
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
write(2, "bcrontab: Fatal: Could not creat"..., 49) = 49
unlink("bcrontab.14779.1573691864.847933") = 0
exit_group(111)                         = ?
+++ exited with 111 +++
No final, há uma mensagem de erro exit, mas desta vez algo é diferente. Primeiro, não há um erro relevante de chamada de sistema que normalmente ocorre antes disso. Em segundo lugar, parece que alguém já leu a mensagem de erro em algum lugar. Parece que o verdadeiro problema está em outro lugar, e bcrontab apenas reproduz a mensagem.
Se olharmos para man 2 read, podemos ver que o primeiro argumento (3) é o descritor de arquivo que *nix usa para toda a entrada e saída. Como descobrir o que representa o descritor de arquivo 3? Neste caso específico, podemos executar strace com o operador -u (veja acima), e ele explicará automaticamente, mas para calcular esse tipo de coisa, é útil saber como ler e analisar os resultados da rastreabilidade.
A fonte do descritor de arquivo pode ser uma das várias chamadas de sistema (tudo depende para o que o descritor é — para o console, socket de rede, um arquivo propriamente dito ou algo mais), mas de qualquer forma, estamos procurando chamadas que retornam 3 (ou seja, procuramos "= 3" nos resultados da rastreabilidade). Neste resultado, há 2: openat no topo e socket no meio. openat abre um arquivo, mas fecharapós isso mostrará que ele está sendo fechado novamente. (Dica: os descritores de arquivo podem ser reutilizados quando são abertos e fechados). A chamada socket() é relevante, pois é a última antes de read(), e parece que bcrontab está lidando com algo através de um socket. A próxima linha mostra que o descritor de arquivo está associado a socket de domínio unix no caminho /var/run/bcron-spool.
Então, precisamos encontrar o processo vinculado ao socket unix do outro lado. Para isso, existem alguns truques elegantes, e ambos serão úteis para depuração de implementações de servidores. O primeiro — usar netstat ou um mais novo ss (status do socket). Ambos os comandos mostram conexões de rede ativas do sistema e usam o operador --selector para descrever sockets em escuta, bem como o operador -p para exibir os programas conectados ao socket como cliente. (Existem muitas opções úteis, mas para esta tarefa, estas duas são suficientes.)
# ss -pl | grep /var/run/bcron-spool
u_str LISTEN 0   128   /var/run/bcron-spool 1466637   * 0   users:(("unixserver",pid=20629,fd=3))
Isso indica que escutar é o comando inixserver, que trabalha com o ID do processo 20629. (E, por coincidência, utiliza o descritor de arquivo 3 como socket.)
Uma segunda ferramenta realmente útil para encontrar a mesma informação é chamada lsof. Ela lista todos os arquivos abertos (ou descritores de arquivos) no sistema. Ou pode-se obter informação sobre um arquivo específico:
# lsof /var/run/bcron-spool
COMMAND   PID   USER  FD  TYPE  DEVICE              SIZE/OFF  NODE    NAME
unixserve 20629 cron  3u  unix  0x000000005ac4bd83  0t0       1466637 /var/run/bcron-spool type=STREAM
O processo 20629 é um servidor de longa duração, então pode-se anexá-lo strace usando algo como strace -o /tmp/trace -p 20629. Se editar a tarefa cron em outro terminal, obteremos a saída dos resultados da rastreação com um erro que surge. E aqui está o resultado:
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21181
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Para ser reiniciado se SA_RESTART estiver definido)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21181, si_uid=998, si_status=0, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 0}], WNOHANG|WSTOPPED, NULL) = 21181
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Nenhum processo filho)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21200
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Para ser reiniciado se SA_RESTART estiver definido)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21200, si_uid=998, si_status=111, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 111}], WNOHANG|WSTOPPED, NULL) = 21200
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Nenhum processo filho)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL
(O último accept() não será concluído durante a rastreação.) E novamente, infelizmente, este resultado não contém o erro que estamos procurando. Não vemos nenhuma mensagem que o bcrontag tenha enviado ou recebido do socket. Em vez disso, é apenas gerenciamento de processos (clone, wait4, SIGCHLD e outros.) Este processo gera um subprocesso que, como você pode imaginar, realiza o trabalho real. E se for necessário rastrear sua pista, adicione ao comando strace -f. É isso que encontraremos ao procurar a mensagem de erro no novo resultado com strace -f -o /tmp/trace -p 20629:
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Permissão negada)
21470 write(1, "32:ZNão foi possível criar f temporário f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Arquivo ou diretório não encontrado)
21470 exit_group(111)                   = ?
21470 +++ saiu com 111 +++
Veja, isso já é alguma coisa. O processo 21470 recebe um erro "permissão negada" ao tentar criar um arquivo no caminho tmp/spool.21470.1573692319.854640 (relativo ao diretório de trabalho atual). Se apenas soubéssemos qual é o diretório de trabalho atual, saberíamos o caminho completo e poderíamos descobrir por que o processo não consegue criar seu arquivo temporário. Infelizmente, o processo já saiu, então não será possível simplesmente usar lsof -p 21470 para encontrar o diretório atual, mas podemos trabalhar ao contrário — procurar as chamadas de sistema do PID 21470 que mudam de diretório. (Se não houver, o PID 21470 deve ter herdado-as do pai, e isso já através de lsof -p não podemos descobrir.) Esta chamada de sistema é chdir (o que não é difícil descobrir usando mecanismos de busca moderna). Aqui está o resultado da busca reversa com base nos resultados da trilha, até o próprio servidor PID 20629:
20629 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21470
...
21470 execve("/usr/sbin/bcron-spool", ["bcron-spool"], 0x55d2460807e0 /* 27 vars */) = 0
...
21470 chdir("/var/spool/cron")          = 0
...
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Permissão negada)
21470 write(1, "32:ZNão foi possível criar f temporário f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Arquivo ou diretório não encontrado)
21470 exit_group(111)                   = ?
21470 +++ saiu com 111 +++
(Se você estiver se perdendo, talvez seja uma boa ideia ler meu post anterior .) Então, o servidor PID 20629 não obteve permissão para criar um arquivo no caminho /var/spool/cron/tmp/spool.21470.1573692319.854640. A causa mais provável disso são as configurações clássicas de permissões do sistema de arquivos. Vamos verificar:
# ls -ld /var/spool/cron/tmp/
drwxr-xr-x 2 root root 4096 Nov  6 05:33 /var/spool/cron/tmp/
# ps u -p 20629
USER       PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
cron     20629  0.0  0.0   2276   752 ?        Ss   Nov14   0:00 unixserver -U /var/run/bcron-spool -- bcron-spool
Aqui está onde a questão está! O servidor está funcionando como cron do usuário, mas apenas o root tem permissão para gravar no diretório /var/spool/cron/tmp/. Um simples comando chown cron /var/spool/cron/tmp/ resolverá bcron funcionar corretamente. (Se o problema não estava nisso, o próximo suspeito mais provável é o módulo de segurança do núcleo, como SELinux ou AppArmor, então eu verificaria o log de mensagens do núcleo usando dmesg.)
Total
Para um iniciante, os resultados do rastreamento de chamadas de sistema podem ser confusos, mas eu espero ter demonstrado que eles são uma maneira rápida de depurar uma classe inteira de problemas comuns de implantação. Imagine tentar depurar um ambiente multiprocessual bcron, usando um depurador passo a passo.
Analisar os resultados do rastreamento ao longo da cadeia de chamadas de sistema exige habilidade, mas como mencionei, quase sempre, ao utilizar strace, eu simplesmente obtenho o resultado do rastreamento e procuro por erros, começando do final. De qualquer forma, strace isso me ajuda a economizar muito tempo na depuração. Espero que também seja útil para você.
Fonte: habr.com
