

Como ler este artigo: peço desculpas por o texto ter ficado tão longo e caótico. Para economizar seu tempo, começo cada capítulo com a introdução "O que aprendi", onde expresso em uma ou duas frases a essência do capítulo.
"Apenas mostre a solução!" Se você deseja apenas ver aonde cheguei, vá para o capítulo "Tornando-me mais engenhoso", mas considero mais interessante e útil ler sobre as falhas.
Recentemente, me foi encarregado configurar o processo de processamento de um grande volume de sequências de DNA (tecnicamente, isso é um chip SNP). Precisamos obter rapidamente dados sobre uma localização genética específica (chamada SNP) para modelagem subsequente e outras tarefas. Com R e AWK, consegui limpar e organizar os dados de maneira natural, acelerando significativamente o processamento das solicitações. Isso não foi fácil e exigiu inúmeras iterações. Este artigo ajudará você a evitar alguns dos meus erros e demonstrará o que no final consegui.
Para começar, algumas explicações introdutórias.
Dados
Nosso centro universitário de processamento de informações genéticas nos forneceu dados em formato TSV com um volume de 25 TB. Recebi-os divididos em 5 pacotes, compactados em Gzip, cada um contendo cerca de 240 arquivos de quatro gigabytes. Cada linha continha dados de um SNP de uma pessoa. No total, foram dados de cerca de 2,5 milhões de SNPs e aproximadamente 60 mil pessoas. Além das informações de SNP, os arquivos continham várias colunas com números refletindo diferentes características, como intensidade de leitura, frequência de vários alelos, etc. No total, havia cerca de 30 colunas com valores únicos.
O objetivo
Como em qualquer projeto de gestão de dados, o mais importante foi definir como os dados seriam utilizados. Neste caso nós, na maior parte, estaremos ajustando modelos e fluxos de trabalho para SNPs com base em SNPs. Ou seja, simultaneamente, precisaremos de dados apenas para um SNP. Eu precisava aprender a extrair todas as entradas relacionadas a um dos 2,5 milhões de SNPs da maneira mais simples, rápida e barata possível.
Como não fazer isso
Cito um clichê apropriado:
Eu não fracassei mil vezes, eu apenas descobri mil maneiras de não processar um monte de dados em um formato adequado para consultas.
Primeira tentativa
O que aprendi: não existe uma maneira barata de fazer o parsing de 25 Tb de uma vez.
Após ouvir a disciplina 'Métodos Avançados para Processamento de Grandes Dados' na Universidade Vanderbilt, eu estava confiante de que seria fácil. Provavelmente, levaria uma ou duas horas para configurar o servidor Hive, correr por todos os dados e relatar os resultados. Como nossos dados estão armazenados no AWS S3, utilizei o serviço , que permite aplicar consultas Hive SQL aos dados do S3. Não é necessário configurar/levantar um cluster Hive, e você só paga pelos dados que procura.
Depois que mostrei à Athena meus dados e seu formato, fiz alguns testes com consultas semelhantes:
select * from intensityData limit 10;E rapidamente obtive resultados bem estruturados. Pronto.
Até que tentamos usar os dados na prática...
Me pediram para extrair todas as informações sobre SNPs para testar um modelo. Executei a consulta:
select * from intensityData
where snp = 'rs123456';
...e esperei. Após oito minutos e mais de 4 Tb de dados requisitados, obtive o resultado. A Athena cobra pelo volume de dados encontrados, a $5 por terabyte. Portanto, essa única consulta custou $20 e oito minutos de espera. Para passar o modelo por todos os dados, seria necessário esperar 38 anos e pagar $50 milhões. É claro que isso não funcionaria para nós.
Precisávamos usar Parquet...
O que aprendi: tenha cuidado com o tamanho dos seus arquivos Parquet e sua organização.
Primeiro, tentei corrigir a situação, convertendo todos os TSV em . Eles são convenientes para trabalhar com grandes conjuntos de dados, pois a informação é armazenada em formato colunar: cada coluna está em seu próprio segmento de memória/disco, ao contrário dos arquivos de texto, onde as linhas contêm elementos de cada coluna. E se você precisa encontrar algo, basta ler a coluna necessária. Além disso, em cada arquivo na coluna, há um intervalo de valores, então se o valor procurado não estiver no intervalo da coluna, o Spark não perderá tempo escaneando todo o arquivo.
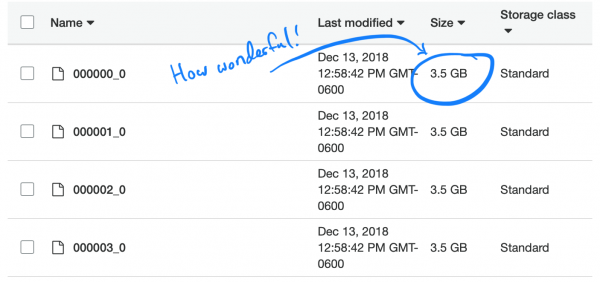
Eu executei uma tarefa simples Para converter nossos TSV em Parquet e carregar novos arquivos no Athena. Isso levou cerca de 5 horas. Mas quando executei a consulta, levou aproximadamente o mesmo tempo e um pouco menos de dinheiro. O fato é que o Spark, tentando otimizar a tarefa, simplesmente descompactou um bloco TSV e o colocou em seu próprio bloco Parquet. E como cada bloco era grande o suficiente para conter registros completos de muitas pessoas, cada arquivo continha todos os SNP, então o Spark precisou abrir todos os arquivos para extrair as informações necessárias.
Curiosamente, o tipo de compressão usado por padrão (e recomendado) no Parquet — snappy — não é divisível (splitable). Portanto, cada executor travava na tarefa de descompactação e carregamento do conjunto de dados completo de 3,5 GB.
Estamos investigando o problema
O que aprendi: é difícil classificar, especialmente se os dados estiverem distribuídos.
Parece que agora eu entendi a essência do problema. Eu só precisava classificar os dados pela coluna SNP, e não pelas pessoas. Assim, em um bloco separado de dados, haveria vários SNP, e a "inteligente" função do Parquet de "abrir apenas se o valor estiver no intervalo" se manifestaria plenamente. Infelizmente, classificar bilhões de linhas dispersas pelo cluster se revelou uma tarefa complexa.
Eu fazendo uma aula de algoritmos na faculdade: «Ugh, ninguém se importa com a complexidade computacional de todos esses algoritmos de ordenação»
Eu tentando classificar em uma coluna em um 20TB tabela: «Por que isso está levando tanto tempo?» dificuldades.
— Nick Strayer (@NicholasStrayer)
A AWS definitivamente não quer devolver o dinheiro por causa do "Eu sou um estudante distraído". Depois que eu executei a ordenação no Amazon Glue, ela rodou por 2 dias e falhou.
E quanto à partição?
O que aprendi: as partições no Spark devem ser equilibradas.
Então, eu tive a ideia de particionar os dados em cromossomos. Eles são 23 (e mais alguns, se considerarmos o DNA mitocondrial e áreas não mapeadas).
Isso permitirá dividir os dados em porções menores. Se adicionar à função de exportação do Spark no script Glue apenas uma linha partition_by = "chr", os dados devem ser organizados em baldes (buckets).
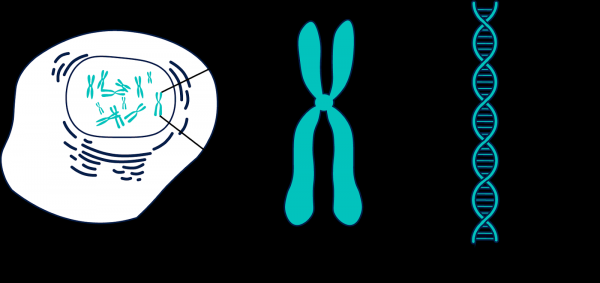
O genoma é composto por numerosos fragmentos chamados cromossomos.
Infelizmente, isso não funcionou. Os cromossomos têm tamanhos diferentes, o que significa uma quantidade de informações variada. Isso implica que as tarefas que o Spark enviou para os trabalhadores não estavam balanceadas e foram executadas lentamente, pois alguns nós terminavam antes e ficavam ociosos. No entanto, as tarefas foram concluídas. Mas ao solicitar um SNP, o desequilíbrio se tornou novamente a causa de problemas. O custo de processamento de SNP em cromossomos maiores (ou seja, de onde queremos obter os dados) diminuiu apenas cerca de 10 vezes. É muito, mas não o suficiente.
E se dividir em partições ainda menores?
O que aprendi: de forma alguma tente fazer 2,5 milhões de partições.
Decidi ir com tudo e particionei cada SNP. Isso garantiu tamanhos de partições iguais. FOI UMA IDEIA RUIM. Usei o Glue e adicionei uma linha inofensiva partition_by = 'snp'. A tarefa foi iniciada e começou a ser executada. Um dia depois, verifiquei e notei que nada havia sido gravado no S3 até então, então cancelei a tarefa. Parece que o Glue estava gravando arquivos intermediários em um local oculto no S3, e havia muitos arquivos, possivelmente alguns milhões. Como resultado, meu erro custou mais de mil dólares e não deixou meu mentor contente.
Particionamento + ordenação
O que aprendi: ainda é difícil ordenar, assim como configurar o Spark.
A última tentativa de particionamento foi quando particionei os cromossomos e, em seguida, ordenei cada partição. Em teoria, isso deveria acelerar cada consulta, pois os dados desejados sobre SNP deveriam estar dentro de alguns blocos Parquet em um intervalo especificado. Infelizmente, a ordenação de dados mesmo particionados provou ser uma tarefa difícil. Como resultado, migrei para o EMR para um cluster personalizado e usei oito instâncias poderosas (C5.4xl) e Sparklyr para criar um fluxo de trabalho mais flexível…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…no entanto, a tarefa ainda não foi concluída. Eu tentei de várias maneiras: aumentei a alocação de memória para cada executor de consultas, usei nós com mais memória, apliquei variáveis de difusão, mas cada vez eram apenas paliativos, e gradualmente os executores começaram a falhar até que tudo parou.
Atualização: assim começa.
— Nick Strayer (@NicholasStrayer)
Estou me tornando mais criativo
O que aprendi: às vezes, dados especiais exigem soluções especiais.
Cada SNP possui um valor de posição. Esse número corresponde à quantidade de bases ao longo de seu cromossomo. Essa é uma maneira boa e natural de organizar nossos dados. Inicialmente, eu queria particionar por regiões de cada cromossomo. Por exemplo, posições de 1 a 2000, de 2001 a 4000, e assim por diante. Mas o problema é que os SNPs estão distribuídos de maneira desigual pelos cromossomos, portanto, o tamanho dos grupos varia bastante.
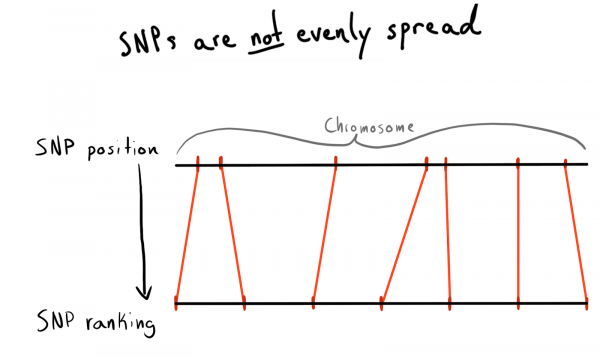
Como resultado, cheguei à divisão por categorias (rank) de posições. Com os dados já carregados, executei uma consulta para obter uma lista de SNPs únicos, suas posições e cromossomos. Em seguida, classifiquei os dados dentro de cada cromossomo e agrupei os SNPs em grupos (bin) de tamanho específico. Digamos, a cada 1000 SNPs. Isso me deu a correlação dos SNPs com o grupo em seu cromossomo.
No final, fiz grupos (bin) de 75 SNPs, cuja razão explicarei abaixo.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Primeira tentativa com o Spark
O que aprendi: a junção no Spark funciona rapidamente, mas o particionamento ainda é custoso.
Eu queria ler esse pequeno (2,5 milhões de linhas) dataframe no Spark, juntá-lo com os dados brutos e depois particionar pela nova coluna adicionada. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Eu utilizei sdf_broadcast(), assim o Spark sabe que precisa enviar o dataframe para todos os nós. Isso é útil se os dados forem de pequeno tamanho e necessários para todas as tarefas. Caso contrário, o Spark tenta ser inteligente e distribui os dados conforme necessário, o que pode causar lentidão.
E novamente minha ideia não funcionou: as tarefas funcionaram por um tempo, concluíram a junção e então, assim como os executores iniciados com o particionamento, começaram a falhar.
Adicionando AWK
O que aprendi: não durma quando lhe ensinam os fundamentos. Com certeza alguém já resolveu seu problema lá pelos anos 1980.
Até esse momento, a razão de todos os meus insucessos com o Spark foi a mistura de dados no cluster. É possível que a situação possa ser melhorada com um pré-processamento. Eu decidi tentar dividir os dados brutos em colunas de cromossomos, assim eu esperava fornecer ao Spark dados 'pré-particionados'.
Procurei no StackOverflow como dividir por valores de colunas e encontrei Com o AWK, você pode dividir um arquivo de texto pelos valores das colunas, gravando um script, ao invés de enviar os resultados para stdout.
Para experimentação, escrevi um script Bash. Baixei um dos arquivos TSV comprimidos e então o descompactei usando gzip e enviei para awk.
gzip -dc caminho/para/arquivo/chunk.gz |
awk -F 't'
'{print $1",..."$30" > "chunked/"$chr"_chr"$15".csv"}'
Isso funcionou!
Preenchendo núcleos
O que aprendi: gnu parallel é uma coisa mágica, todos deveriam usá-la.
A divisão estava ocorrendo muito devagar, e quando executei htop, para verificar o uso do poder do EC2 (e caro), percebi que estava utilizando apenas um núcleo e cerca de 200 MB de memória. Para resolver o problema e não perder muito dinheiro, precisei pensar em como paralelizar o trabalho. Felizmente, encontrei em um livro absolutamente incrível, de Jeroen Janssens, um capítulo dedicado à paralelização. Aprendi sobre gnu parallel, um método muito flexível para implementar multithreading no Unix.
Quando executei a divisão usando o novo processo, tudo estava ótimo, mas havia um ponto crítico — o download dos objetos S3 para o disco não estava muito rápido e não era totalmente paralelizado. Para corrigir isso, fiz o seguinte:
- Descobri que era possível implementar a etapa de download do S3 diretamente no pipeline, eliminando totalmente o armazenamento intermediário no disco. Isso significa que posso evitar a gravação de dados brutos no disco e usar um armazenamento ainda menor, e portanto mais barato, na AWS.
- Comando
aws configure set default.s3.max_concurrent_requests 50aumentou significativamente o número de threads que o AWS CLI utiliza (por padrão, são 10). - Mudei para uma instância EC2 otimizada para velocidade de rede, com a letra n no nome. Descobri que a perda de poder computacional ao usar instâncias n é mais que compensada pelo aumento na velocidade de upload. Para a maioria das tarefas, utilizei c5n.4xl.
- Troquei
gzippara , uma ferramenta gzip que consegue fazer coisas incríveis para paralelizar a tarefa de descompactação de arquivos que originalmente não era paralelizada (isso ajudou muito pouco).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Esses passos foram combinados uns com os outros, de modo que tudo funcionou muito rápido. Graças ao aumento da velocidade de download e à eliminação da gravação no disco, eu agora podia processar um pacote de 5 terabytes em apenas algumas horas.
Não há nada mais gratificante do que ver todos os núcleos pelos quais você está pagando na AWS sendo utilizados. Graças ao gnu-parallel, consigo descompactar e dividir um CSV de 19 gigas tão rápido quanto posso baixá-lo. Eu nem consegui fazer o Spark rodar isso.
— Nick Strayer (@NicholasStrayer)
Este tweet deveria mencionar 'TSV'. Infelizmente.
Uso de dados reprocessados
O que aprendi: O Spark adora dados não compactados e não gosta de combinar partições.
Agora os dados estavam no S3 em um formato não compactado (ou seja, separado) e semiordenado, e eu pude voltar ao Spark. Esperei uma surpresa: não consegui novamente atingir o que queria! Era muito difícil informar ao Spark como os dados estavam particionados. E mesmo quando o fiz, percebi que havia partições demais (95 mil), e quando usei coalesce para reduzir a quantidade para valores razoáveis, isso quebrou minha partição. Tenho certeza de que isso pode ser corrigido, mas após dois dias de busca, não consegui encontrar uma solução. No fim, completei todas as tarefas no Spark, embora tenha levado um tempo, e meus arquivos Parquet divididos não eram tão pequenos (~200 Kb). No entanto, os dados estavam onde precisavam estar.
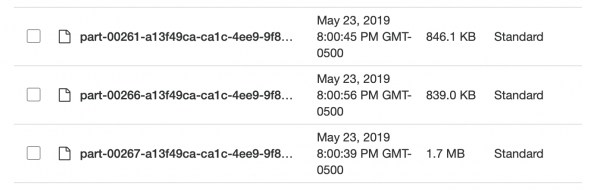
Muito pequenos e diferentes, maravilhoso!
Testando consultas locais do Spark
O que aprendi: No Spark, há muita sobrecarga ao lidar com tarefas simples.
Depois de carregar os dados em um formato bem pensado, consegui testar a velocidade. Configurei um script em R para iniciar um servidor Spark local e depois carreguei o dataframe do Spark do repositório Parquet especificado (bin). Tentei carregar todos os dados, mas não consegui fazer o Sparklyr reconhecer a partição.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Iniciar um cronômetro
start_time <- Sys.time()

# Carregar o bin desejado no Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Subconjunto bin para snp e depois coletar localmente
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
A execução levou 29,415 segundos. Muito melhor, mas ainda não muito bom para testes em massa de qualquer coisa. Além disso, não consegui acelerar o trabalho com cache, pois quando tentava fazer cache na memória do dataframe, o Spark sempre falhava, mesmo quando aloquei mais de 50 GB de memória para um conjunto de dados que pesava menos de 15.
Voltando ao AWK
O que aprendi: Arrays associativos em AWK são muito eficientes.
Eu percebi que poderia atingir uma velocidade maior. Lembrei que no excelente Li sobre uma incrível funcionalidade chamada "". Na verdade, são pares chave-valor que, por algum motivo, foram nomeados de forma diferente no AWK, e por isso eu não os lembrava muito. me lembrou que o termo "arrays associativos" é muito mais antigo do que o termo "par chave-valor". Mesmo que você , você não encontrará esse termo, mas sim os arrays associativos! Além disso, "par chave-valor" é mais frequentemente associado a bancos de dados, então faz mais sentido compará-los com hashmap. Eu percebi que poderia usar esses arrays associativos para ligar meus SNP a uma tabela de grupos (bin table) e dados brutos sem usar Spark.
Para isso, no script AWK, eu usei o bloco BEGIN. Este é um fragmento de código que é executado antes que a primeira linha de dados seja passada para o corpo principal do script.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Time while(getline...) carregou todas as linhas do CSV do grupo (bin), definiu a primeira coluna (nome do SNP) como chave do array associativo bin e o segundo valor (grupo) como valor. Depois, no bloco { }, que é executado para todas as linhas do arquivo principal, cada linha é enviada para o arquivo de saída, recebendo um nome único dependendo de seu grupo (bin): ..._bin_"bin[$1]"_....
Variáveis batch_num e chunk_id correspondem aos dados fornecidos pelo pipeline, o que evitou uma condição de corrida, e cada fluxo de execução iniciado parallel, escrevia em seu próprio arquivo único.
Como todos os dados brutos estavam distribuídos em pastas por cromossomos, resultado do meu experimento anterior com AWK, agora eu poderia escrever outro script Bash para processar um cromossomo de cada vez e enviar dados mais profundamente particionados para o S3.
DESIRED_CHR='13'

# Download chromosome data from s3 and split into bins
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'reading {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Combine all the parallel process chunks to single files and upload to rds using R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipping bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin{}.rds"
rm chunked/*
No script há duas seções parallel.
Na primeira seção, os dados são lidos de todos os arquivos que contêm informações sobre o cromossomo necessário, e esses dados são distribuídos entre as threads, que separam os arquivos em grupos correspondentes (bin). Para evitar condições de corrida, onde várias threads escrevem em um único arquivo, o AWK fornece os nomes dos arquivos para gravar dados em locais diferentes, por exemplo, chr_10_bin_52_batch_2_aa.csv. Como resultado, cria-se no disco uma multitude de pequenos arquivos (para isso usei volumes EBS de um terabyte).
O pipeline da segunda seção parallel percorre os grupos (bin) e combina seus arquivos individuais em CSVs comuns com cat, e depois os envia para exportação.
Transmissão em R?
O que aprendi: pode-se acessar stdin e stdout de um script R, e portanto utilizá-lo no pipeline.
No script Bash, você pode ter notado a seguinte linha: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Ela transmite todos os arquivos concatenados do grupo (bin) para o script R abaixo. {} é uma técnica especial parallel, que insere todos os dados enviados para o fluxo especificado diretamente no próprio comando. A opção {#} fornece um ID único para o fluxo de execução, e {%} representa o número do slot de tarefa (repete-se, mas nunca simultaneamente). A lista de todas as opções pode ser encontrada na
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Quando a variável file("stdin") é passada para readr::read_csv, os dados transmitidos para o script R são carregados em um dataframe, que depois é gravado como .rds-arquivo utilizando aws.s3 diretamente no S3.
RDS é como uma versão simplificada do Parquet, sem as sofisticações de um armazenamento em colunas.
Após a conclusão do script Bash, recebi uma pilha .rds-arquivos armazenados no S3, o que me permitiu utilizar compressão eficiente e tipos embutidos.
Apesar do R ser lento, tudo funcionou muito rápido. Não é surpresa que os trechos em R responsáveis pela leitura e gravação de dados sejam bem otimizados. Após testes em um cromossomo de tamanho médio, a tarefa foi concluída em uma instância C5n.4xl em cerca de duas horas.
Restrições do S3
O que aprendi: graças à implementação inteligente de caminhos, o S3 pode manipular muitos arquivos.
Eu estava preocupado se o S3 conseguiria processar o grande número de arquivos que lhe foram enviados. Eu poderia tornar os nomes dos arquivos significativos, mas como o S3 buscaria por eles?
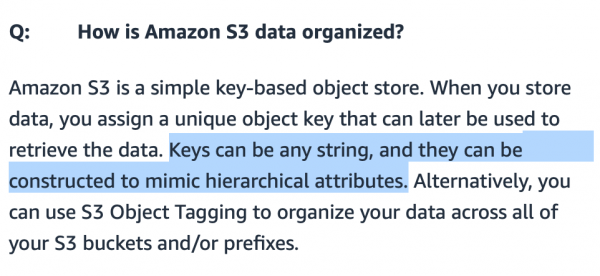
As pastas no S3 são apenas para a aparência, na verdade o sistema não se importa com o símbolo /.
Parece que o S3 apresenta o caminho até um arquivo específico como uma chave simples em uma espécie de tabela hash ou banco de dados baseado em documentos. O bucket pode ser considerado uma tabela, e os arquivos — registros nessa tabela.
Como a velocidade e a eficiência são importantes para obter lucros na Amazon, não é surpreendente que esse sistema de "chave-como-caminho-para-o-arquivo" seja altamente otimizado. Tentei encontrar um equilíbrio: para que não fosse necessário fazer inúmeras requisições get, mas ao mesmo tempo as requisições fossem rápidas. Descobri que o ideal é ter cerca de 20 mil arquivos binários. Acredito que, se continuar a otimizar, será possível aumentar a velocidade (por exemplo, criando um bucket especial apenas para os dados, assim reduzindo o tamanho da tabela de pesquisa). Mas não tive tempo e recursos para novos experimentos.
E quanto à compatibilidade cruzada?
O que aprendi: a principal razão para perder tempo é a otimização prematura do seu método de armazenamento.
Neste momento, é muito importante perguntar a si mesmo: "Por que usar um formato de arquivo proprietário?" A razão está na velocidade de carregamento (arquivos CSV compactados em gzip levavam 7 vezes mais para carregar) e na compatibilidade com nossos fluxos de trabalho. Posso reconsiderar minha decisão se o R conseguir carregar facilmente arquivos Parquet (ou Arrow) sem a sobrecarga do Spark. Em nosso laboratório, todos usam R, e se eu precisar converter os dados para outro formato, ainda tenho os dados textuais originais, então posso simplesmente reiniciar o pipeline.
Divisão do trabalho
O que aprendi: não tente otimizar tarefas manualmente, deixe isso para o computador.
Ajustei o fluxo de trabalho em um cromossomo, agora preciso processar todos os outros dados.
Queria subir várias instâncias EC2 para a conversão, mas ao mesmo tempo temia obter uma carga extremamente desequilibrada nas diferentes tarefas de processamento (assim como o Spark sofria com partições desequilibradas). Além disso, eu não queria subir uma instância para cada cromossomo, pois há um limite padrão de 10 instâncias para contas AWS.
Então decidi escrever um script em R para otimizar as tarefas de processamento.
Primeiro pedi ao S3 para calcular quanto espaço de armazenamento cada cromossomo ocupa.
biblioteca(aws.s3)
biblioteca(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Extrair o cromossomo do nome do arquivo
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Dividir para obter o valor em GB


# Um tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … com mais 17 linhas
Em seguida, escrevi uma função que pega o tamanho total, embaralha a ordem dos cromossomos e os divide em grupos num_jobs e informa o quão diferentes são os tamanhos de todos os trabalhos de processamento.
num_jobs <- 7
# Qual seria o tamanho de cada trabalho se fosse perfeitamente dividido?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# Um tibble: 1 x 2
     sd data

1  153.
Depois, executei mil embaralhamentos utilizando purrr e escolhi o melhor.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Assim, obtive um conjunto de trabalhos muito semelhantes em termos de tamanho. Depois, só restava envolver meu script Bash anterior em um grande ciclo para. Escrever essa otimização levou cerca de 10 minutos. E isso é muito menos do que eu teria gasto criando trabalhos manualmente em caso de desbalanceamento. Portanto, acredito que essa pré-otimização foi um acerto.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Código para processar um único cromossomo
fi
No final, adiciono o comando de desligamento:
sudo shutdown -h now … e funcionou! Com a AWS CLI, subi instâncias e por meio da opção user_data enviei meus scripts Bash para suas tarefas de processamento. Eles eram executados e desligados automaticamente, então não paguei por capacidade computacional desnecessária.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Vamos empacotar!
O que aprendi: A API deve ser simples por uma questão de simplicidade e flexibilidade de uso.
Finalmente, obtive os dados no local e formato desejados. Restava simplificar ao máximo o processo de uso dos dados, para que fosse mais fácil para meus colegas. Eu queria criar uma API simples para fazer solicitações. Se no futuro eu decidir migrar com .rds em arquivos Parquet, isso deveria ser um problema para mim, e não para os colegas. Para isso, eu decidi criar um pacote interno em R.
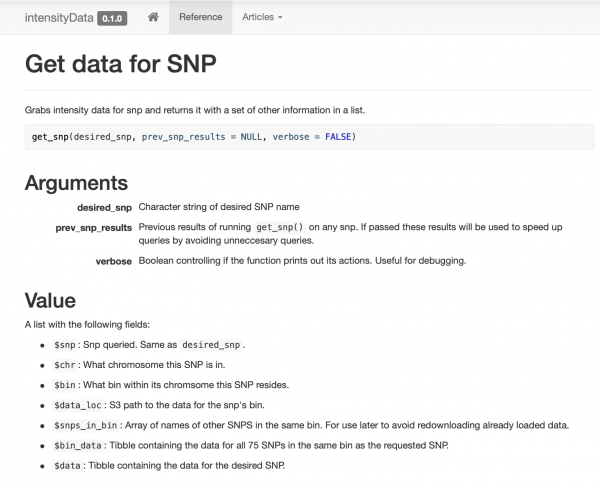
Compilei e documentei um pacote muito simples, contendo apenas algumas funções para acessar os dados, voltadas para a função get_snp. Também fiz um site para os colegas , para que eles possam facilmente ver exemplos e a documentação.
Cache inteligente
O que aprendi: se seus dados estiverem bem preparados, será fácil implementar o cache!
Como um dos principais fluxos de trabalho aplicava a mesma modelo de análise ao pacote SNP, eu decidi usar o agrupamento (binning) a meu favor. Ao passar dados através do SNP, todas as informações do grupo (bin) também são anexadas ao objeto retornado. Ou seja, consultas anteriores podem (em teoria) acelerar o processamento de novas consultas.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Ao compilar o pacote, executei muitos benchmarks para comparar a velocidade usando diferentes métodos. Recomendo não deixar isso de lado, pois os resultados podem ser inesperados. Por exemplo, dplyr::filter era muito mais rápido do que capturar linhas usando filtragem baseada em indexação, e obter uma coluna de um dataframe filtrado foi muito mais rápido do que usar a sintaxe de indexação.
Note que o objeto prev_snp_results contém a chave snps_in_bin. Este é um array de todos os SNP únicos no grupo (bin), permitindo verificar rapidamente se já existem dados da consulta anterior. Ele também simplifica a passagem cíclica por todos os SNP no grupo (bin) com este código:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Resultados
Agora podemos (e começamos seriamente) a executar modelos e cenários anteriormente inacessíveis para nós. O melhor de tudo é que meus colegas de laboratório não precisam se preocupar com essas complexidades. Eles têm apenas uma função funcional.
E embora o pacote os libere dos detalhes, eu tentei tornar o formato dos dados simples o suficiente para que eles pudessem entender, caso eu desaparecesse de repente amanhã...
A velocidade aumentou significativamente. Normalmente, escaneamos fragmentos funcionalmente significativos do genoma. Antes não podíamos fazer isso (era muito caro), mas agora, graças à estrutura de agrupamento (bin) e ao cache, leva menos de 0,1 segundo para consultar um SNP, e o uso de dados está tão baixo que os custos para obter S3 são irrisórios.
Recentemente, fui colocado responsável por gerenciar mais de 25 TB de dados de genotipagem bruta para meu laboratório. Quando comecei, usar o Spark levava 8 minutos e custava $20 para consultar um SNP. Após usar AWK + para processar, agora leva menos de um décimo de segundo e custa $0,00001. Minha vitória pessoal .
— Nick Strayer (@NicholasStrayer)
Conclusão
Este artigo não é um guia. A solução que encontrei foi individual e quase certamente não é otimizada. Ao invés disso, é uma história de uma jornada. Quero que outros entendam que essas soluções não surgem completamente formadas na cabeça; são resultado de tentativas e erros. Além disso, se você está procurando um especialista em análise de dados, considere que, para usar esses instrumentos de forma eficaz, é necessário ter experiência, e a experiência custa dinheiro. Estou feliz por ter tido recursos para pagar, mas muitos outros, que podem fazer o mesmo trabalho melhor do que eu, nunca terão essa oportunidade devido à falta de dinheiro sequer para uma tentativa.
Ferramentas para grandes dados são universais. Se você tiver tempo, quase certamente poderá escrever uma solução mais rápida aplicando uma "limpeza inteligente" de dados, armazenamento e metodologias de extração. No final, tudo se resume a uma análise de custos e benefícios.
O que aprendi:
- não existe uma maneira barata de processar 25 TB de uma vez;
- tenha cuidado com o tamanho e a organização dos seus arquivos Parquet;
- as partições no Spark devem ser equilibradas;
- nunca tente fazer 2,5 milhões de partições;
- classificar ainda é difícil, assim como ajustar o Spark;
- às vezes, dados específicos exigem soluções específicas;
- a união no Spark funciona rapidamente, mas a partição ainda é cara;
- não durma enquanto lhe ensinam o básico, provavelmente alguém já resolveu seu problema nos anos 1980;
gnu parallel— é uma coisa mágica, todos deveriam usá-la;- o Spark adora dados não compactados e não gosta de combinar partições;
- há muita sobrecarga no Spark ao resolver tarefas simples;
- arrays associativos em AWK são muito eficientes;
- pode-se acessar
stdinestdouta partir de scripts R, e portanto usá-lo em um pipeline; - graças à implementação inteligente de caminhos S3, pode-se processar muitos arquivos;
- a principal causa da perda de tempo é a otimização prematura do seu método de armazenamento;
- não tente otimizar tarefas manualmente, deixe que o computador faça isso;
- a API deve ser simples para facilitar o uso e a flexibilidade;
- se seus dados estiverem bem preparados, será fácil armazenar em cache!
Fonte: habr.com
