

O principal objetivo do Patroni é garantir alta disponibilidade para o PostgreSQL. Mas o Patroni é apenas um template, e não uma ferramenta pronta (o que está, de fato, explicado na documentação). À primeira vista, configurando o Patroni em um laboratório de testes, é possível ver quão maravilhosa é essa ferramenta e como ela lida facilmente com nossas tentativas de derrubar o cluster. No entanto, na prática, em um ambiente de produção, nem sempre tudo ocorre tão bonito e elegante quanto no laboratório de testes.
Vou contar um pouco sobre mim. Comecei como administrador de sistemas. Trabalhei em desenvolvimento web. Desde 2014, trabalho na Data Egret. A empresa é especializada em consultoria na área de Postgres. Nós focamos exclusivamente no Postgres e trabalhamos com ele todos os dias, portanto, temos uma variedade de expertises relacionadas à sua operação.
No final de 2018, começamos a utilizar o Patroni aos poucos. Assim, acumulamos uma certa experiência. Fizemos diagnósticos, ajustamos e chegamos às nossas melhores práticas. Neste relatório, contarei sobre elas.
Além do Postgres, eu gosto de Linux. Gosto de mexer no sistema e explorá-lo, adoro compilar kernels. Gosto de virtualização, containers, Docker e Kubernetes. Isso tudo me interessa, devido aos velhos hábitos de administrador. Gosto de lidar com monitoramentos. E também aprecio as questões relacionadas à administração do PostgreSQL, ou seja, replicação e backup. No meu tempo livre, escrevo em Go. Não sou engenheiro de software, apenas escrevo em Go para mim mesmo e isso me traz satisfação.
- Eu acho que muitos de vocês sabem que o Postgres não tem HA (Alta Disponibilidade) por padrão. Para obter HA, é necessário instalar, configurá-lo e se dedicar a isso.
- Existem várias ferramentas e o Patroni é uma delas, que resolve o HA de forma bastante eficiente e eficaz. Mas, ao configurar tudo em um laboratório de testes e iniciar, podemos observar que tudo funciona, conseguimos reproduzir alguns problemas e verificar como o Patroni os administra. E veremos que tudo funciona perfeitamente.
- Mas, na prática, encontramos diferentes problemas. E sobre esses problemas, falarei.
- Vou explicar como diagnosticamos isso, o que ajustamos – se isso nos ajudou ou não.
- Não vou explicar como instalar o Patroni, porque você pode encontrar isso facilmente na internet, pode verificar arquivos de configuração para entender como tudo isso funciona, como é configurado. Você pode entender os esquemas e arquiteturas, encontrando informações sobre isso na internet.
- Não vou falar sobre a experiência de outras pessoas. Vou falar apenas sobre os problemas que nós enfrentamos.
- E não vou discutir problemas fora do Patroni e do PostgreSQL. Se, por exemplo, forem problemas relacionados ao balanceamento, quando nosso cluster falhou, não vou comentar sobre isso.
E um pequeno disclaimer antes de começarmos nossa apresentação.
Todos esses problemas com os quais lidamos ocorreram nos primeiros 6-7-8 meses de operação. Com o tempo, chegamos às nossas melhores práticas internas. E os problemas desapareceram. Portanto, a apresentação foi proposta há cerca de seis meses, quando tudo isso ainda estava fresco em minha memória.
Durante a preparação da apresentação, já revisitei antigos postmortems, analisei logs. E algumas partes dos detalhes podem ter sido esquecidas, ou algumas informações podem não ter sido completamente investigadas durante a análise dos problemas, então em alguns momentos pode parecer que os problemas não foram completamente abordados, ou que há alguma falta de informação. Por isso, peço desculpas por isso.
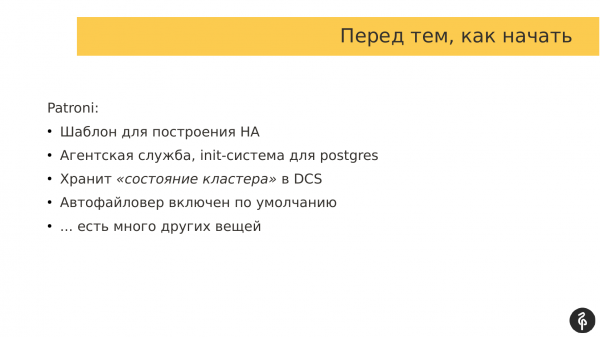
O que é o Patroni?
- É um padrão para construção de HA. Assim está escrito na documentação. E, na minha opinião, é uma esclarecimento muito correto. O Patroni não é uma solução milagrosa que resolverá todos os seus problemas, ou seja, é necessário fazer um esforço para que ele comece a funcionar e traga benefícios.
- É um serviço de agente que é instalado em cada serviço com banco de dados, e que é uma espécie de sistema init para o seu Postgres. Ele inicia, para e reinicia o Postgres, muda a configuração e altera a topologia do seu cluster.
- Portanto, para armazenar o estado do cluster, sua representação atual, como ele é visualizado, é necessário ter algum armazenamento. E, sob esse aspecto, o Patroni optou por armazenar o estado em um sistema externo. É um sistema de armazenamento distribuído de configuração. Podem ser Etcd, Consul, ZooKeeper, ou o Etcd do Kubernetes, isto é, alguma dessas opções.
- Uma das características do Patroni é que você obtém o auto failover pronto para uso, apenas configurando-o. Se compararmos com o Repmgr, o failover vem como um pacote. Com o Repmgr, recebemos o switchover, mas se quisermos auto failover, precisamos configurá-lo adicionalmente. O Patroni já possui o auto failover integrado.
- E há muitas outras coisas. Por exemplo, a manutenção de configurações, a adição de novas réplicas, backup, etc. Mas isso está além do escopo da apresentação, não falarei sobre isso.
Um pequeno resumo: a principal tarefa do Patroni é realizar o auto failover de forma eficaz e confiável, para que o cluster permaneça operacional e o aplicativo não perceba mudanças na topologia do cluster.
Mas quando começamos a usar o Patroni, nosso sistema se torna um pouco mais complexo. Se antes tínhamos o Postgres, ao usar o Patroni, obtemos o próprio Patroni, um DCS onde o estado é mantido. E tudo isso precisa funcionar de alguma forma. Portanto, o que pode dar errado?
Pode dar errado:
- O Postgres pode falhar. Pode ser o mestre ou a réplica, algo deles pode falhar.
- O próprio Patroni pode falhar.
- O DCS, onde o estado é mantido, pode falhar.
- E a rede pode falhar.
Todos esses pontos que abordarei na apresentação.
Analisarei os casos à medida que se tornam mais complexos, não do ponto de vista de que o caso envolve muitos componentes, mas da perspectiva de sentimentos subjetivos, em que esse caso foi complexo para mim e difícil de analisar… e, inversamente, algum caso foi fácil e fácil de analisar.
E o primeiro caso é o mais simples. É o caso em que pegamos um cluster de bancos de dados e nesse mesmo cluster montamos nosso armazenamento DCS. Este é o erro mais comum. É um erro na construção da arquitetura, ou seja, combinar diferentes componentes em um só lugar.
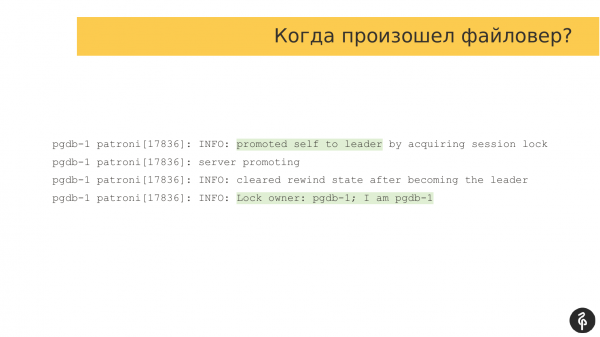
Então, ocorreu um failover, vamos investigar o que aconteceu.
E aqui nos interessa quando ocorreu o failover. Ou seja, nos interessa o momento exato em que houve uma mudança no estado do cluster.
Mas o failover nem sempre é instantâneo, ou seja, não ocupa um único instante de tempo, ele pode se prolongar. Pode durar um período.
Portanto, ele tem um horário de início e um horário de término, ou seja, é um evento prolongado. E dividimos todos os eventos em três intervalos: temos o tempo antes da falha, durante a falha e após a falha. Ou seja, consideramos todos os eventos nesta linha do tempo.
E a primeira coisa que fazemos quando ocorre a falha é procurar a causa, o que aconteceu, o que levou à falha.
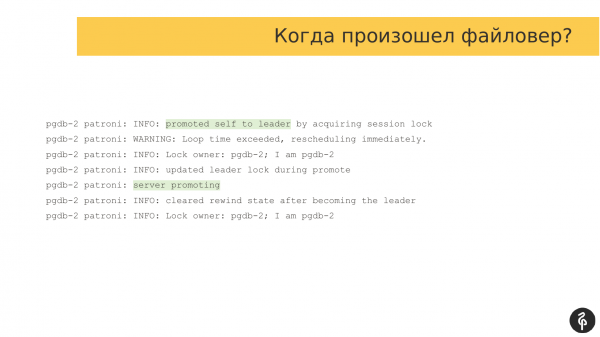
Se olharmos para os logs, veremos os logs clássicos do Patroni. Nele, ele nos informa que o servidor se tornou mestre, e o papel de mestre foi transferido para este nó. Aqui está destacado.
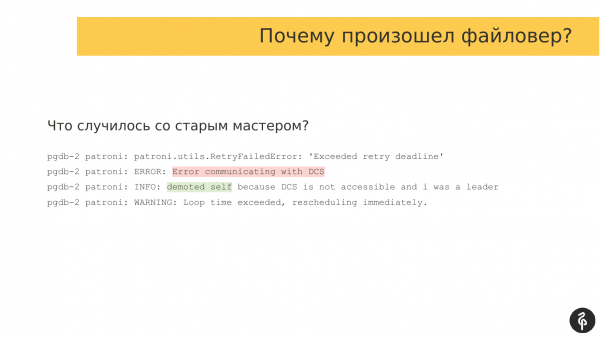
Em seguida, precisamos entender por que ocorreu a falha, ou seja, quais eventos ocorreram que causaram a migração do papel de mestre de um nó para outro. E neste caso, aqui tudo é simples. Temos um erro de interação com o sistema de armazenamento. O mestre percebeu que não poderia trabalhar com DCS, ou seja, surgiu algum problema de interação. E ele diz que não pode mais ser mestre e renuncia a suas funções. Esta linha 'demoted self' fala exatamente sobre isso.
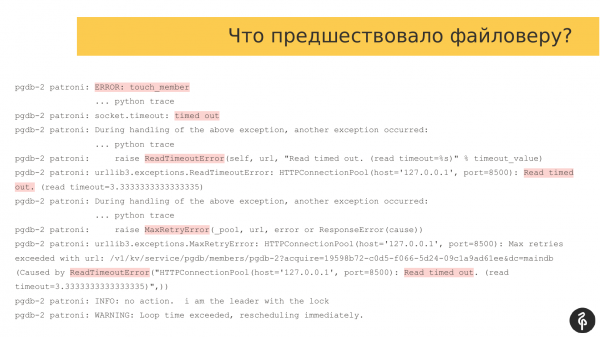
Se olharmos para os eventos que precederam a falha, podemos ver as mesmas causas que se tornaram um problema para a continuidade do funcionamento do mestre.
Se olharmos para os logs do Patroni, veremos que temos uma série de erros, timeouts, ou seja, o agente Patroni não consegue se comunicar com o DCS. Neste caso, é o agente Consul, com o qual a comunicação ocorre pela porta 8500.
E o problema aqui é que o Patroni e o banco de dados estão rodando no mesmo host. E nesse mesmo nó, os servidores Consul foram iniciados. Ao criar carga no servidor, criamos problemas também para servidores o Consul. Eles não conseguiram se comunicar corretamente.
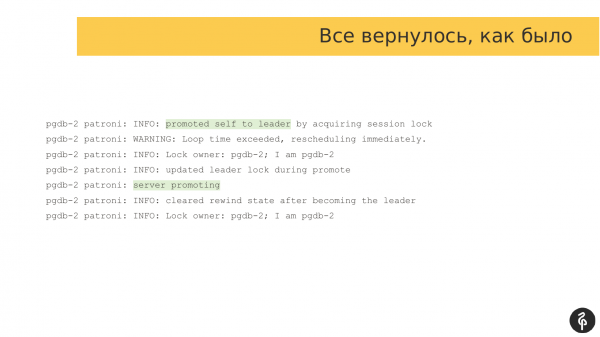
Depois de um tempo, quando a carga diminuiu, nosso Patroni conseguiu se comunicar novamente com os agentes. O funcionamento normal foi retomado. E o mesmo servidor Pgdb-2 se tornou mestre novamente. Ou seja, houve uma pequena mudança, pela qual o nó renunciou a seu papel de mestre e depois o reassumiu, ou seja, tudo voltou ao que era.
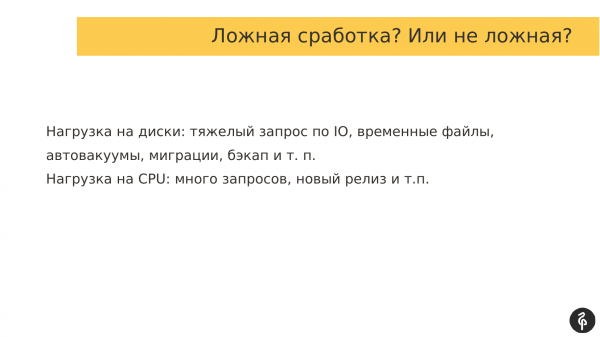
E isso pode ser visto como um falso alarme, ou pode ser que o Patroni tenha agido corretamente. Ou seja, ele percebeu que não podia manter a condição do cluster e renunciou a suas funções.
E aqui o problema surgiu porque os servidores Consul estão no mesmo hardware que os bancos de dados. Portanto, qualquer carga: seja na carga dos discos ou dos processadores, ela também afeta a interação com o cluster Consul.
E decidimos que isso não deveria coexistir, destacamos um cluster separado para o Consul. E o Patroni já estava funcionando com um Consul separado, ou seja, havia um cluster Postgres separado e um cluster Consul separado. Esta é uma instrução básica de como devemos distribuir todas essas coisas e mantê-las separadas, para que não coexistam.
Como alternativa, podemos ajustar os parâmetros ttl, loop_wait, retry_timeout, ou seja, tentar sobreviver a esses picos de carga temporários aumentando esses parâmetros. Mas esta não é a opção mais adequada, porque essa carga pode durar um longo período. E simplesmente podemos ultrapassar esses limites. E isso pode não ajudar muito.
O primeiro problema, como você entendeu, é simples. Juntamos o DCS com o banco de dados e tivemos um problema.
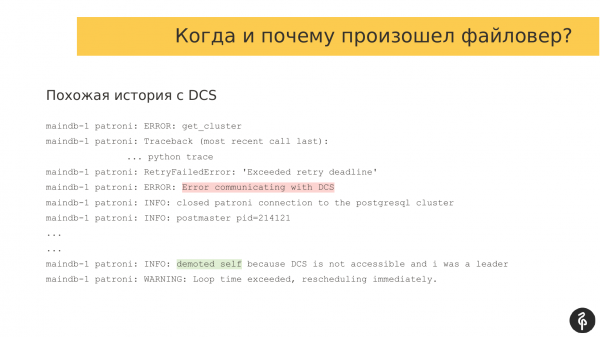
O segundo problema é semelhante ao primeiro. É parecido porque novamente temos problemas de interação com o sistema DCS.
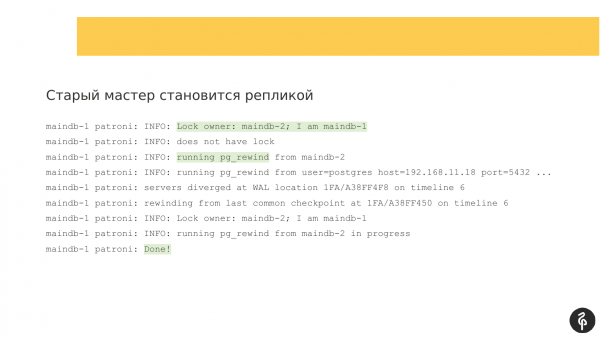
Se olharmos os logs, veremos que novamente temos um erro de comunicação. E o Patroni diz que não consegue interagir com o DCS, portanto, o mestre atual entra em modo de réplica.
O antigo mestre se torna réplica, aqui o Patroni atua como deveria. Ele inicia o pg_rewind para reverter o log de transações e depois se conectar ao novo mestre, buscando alcançar o novo mestre. Aqui o Patroni atua como deveria.
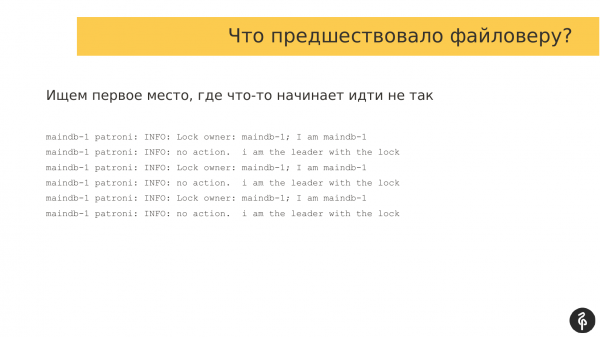
Aqui precisamos encontrar o ponto que precedeu o file watcher, ou seja, os erros que levaram ao file watcher ocorrer. Nesse sentido, trabalhar com os logs no Patroni é bastante conveniente. Ele escreve as mesmas mensagens em intervalos determinados. E se começarmos a rolar rapidamente pelos logs, veremos que as mensagens mudaram, o que indica que começaram alguns problemas. Voltamos rapidamente para esse ponto e verificamos o que está acontecendo.
Em uma situação normal, os logs se parecem mais ou menos assim. O proprietário do bloqueio é verificado. E se o proprietário, por exemplo, mudou, podem ocorrer certos eventos aos quais o Patroni deve reagir. Mas neste caso, está tudo bem. Estamos procurando o ponto em que os erros começaram.
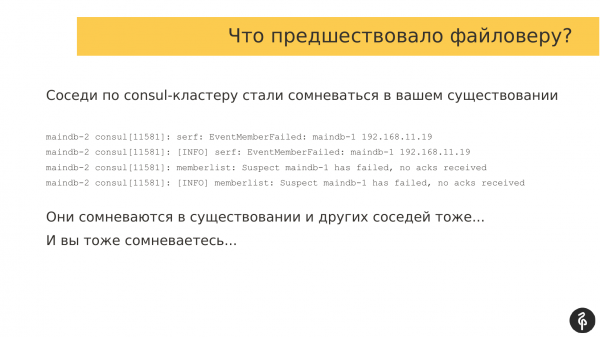
Ao rolar até o ponto em que os erros começaram a surgir, vemos que ocorreu um failover automático. E uma vez que os erros estavam relacionados à interação com o DCS e, no nosso caso, utilizamos o Consul, também analisamos os logs do Consul para entender o que estava acontecendo lá.
Aproximando o tempo do failover e o tempo nos logs do Consul, percebemos que nossos vizinhos no cluster do Consul começaram a duvidar da existência de outros participantes do cluster do Consul.
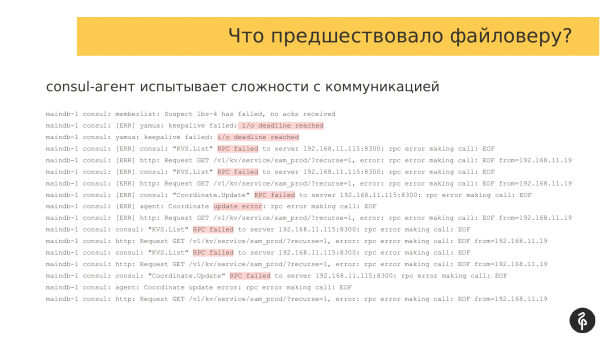
E se olharmos também os logs de outros agentes do Consul, podemos ver que está ocorrendo algum colapso de rede. Todos os participantes do cluster do Consul duvidam da existência uns dos outros. E isso serviu como um impulso para o failover.
Se observarmos o que aconteceu antes desses erros, podemos ver que há vários erros, como deadline, RPC failed, ou seja, claramente há algum problema na interação entre os participantes do cluster do Consul.
A resposta mais simples é consertar a rede. Mas para mim, em uma posição de destaque, é fácil afirmar isso. No entanto, as circunstâncias são tais que nem sempre o cliente pode se dar ao luxo de consertar a rede. Ele pode estar em um DC e pode não ter a capacidade de consertar a rede ou influenciar o equipamento. Portanto, precisamos de outras opções.
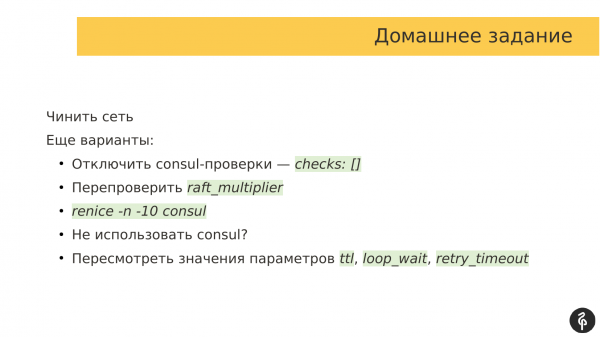
Existem opções:
- A opção mais simples, que acredito estar até mesmo na documentação, é desativar as verificações do Consul, ou seja, simplesmente passar um array vazio. E dizemos ao agente do Consul para não usar nenhuma verificação. Com essas verificações, podemos ignorar essas tempestades de rede e não iniciar o failover.
- Outra opção é revisar o raft_multiplier. Este é um parâmetro do próprio servidor Consul. Por padrão, ele está definido como 5. Este valor é recomendado pela documentação para ambientes de staging. Na prática, isso influencia a frequência de troca de mensagens entre os participantes da rede do Consul. Basicamente, esse parâmetro afeta a velocidade da comunicação entre os participantes do cluster do Consul. E para produção, já é recomendado reduzi-lo para que os nós troquem mensagens com mais frequência.
- Outra opção que começamos a usar é aumentar a prioridade dos processos do Consul em relação a outros processos para o escalonador de processos do sistema operacional. Existe um parâmetro chamado "nice", que define a prioridade dos processos que é considerada pelo escalonador do SO. Nós ajustamos o valor do nice dos agentes Consul, ou seja, aumentamos a prioridade, para que o sistema operacional desse mais tempo de execução e de execução de código para os processos do Consul. No nosso caso, isso resolveu nosso problema.
- Outra opção é não usar o Consul. Tenho um amigo que é um grande defensor do Etcd. E nós frequentemente debatemos sobre o que é melhor, Etcd ou Consul. Porém, em termos do que é melhor, geralmente chegamos à conclusão de que o Consul possui um agente que deve ser executado em cada nó com banco de dados. Ou seja, a interação do Patroni com o cluster do Consul se dá através desse agente. E esse agente se torna um ponto de estrangulamento. Se algo acontecer com o agente, o Patroni não consegue mais trabalhar com o cluster do Consul. E isso é um problema. No caso do Etcd, não há agente. O Patroni pode trabalhar diretamente com a lista de servidores Etcd e já se comunicar com eles. Nesse sentido, se você usar o Etcd na sua empresa, provavelmente o Etcd será a melhor escolha do que o Consul. Mas estamos sempre limitados pelo que o cliente escolheu e está usando. E na maior parte, o Consul está presente com todos os clientes.
- E o último ponto é revisar os valores dos parâmetros. Podemos aumentar esses parâmetros na esperança de que nossos problemas de rede temporários sejam curtos e não excedam o intervalo desses parâmetros. Dessa forma, podemos diminuir a agressividade do Patroni na execução da auto-falha, se surgirem problemas de rede.
Acredito que muitos que usam o Patroni estão familiarizados com este comando.
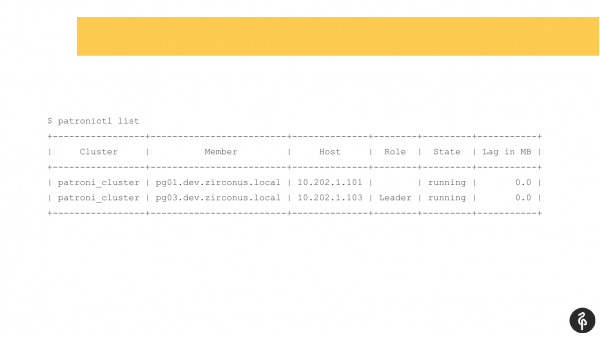
Este comando mostra o estado atual do cluster. E à primeira vista, essa imagem pode parecer normal. Temos um mestre, temos uma réplica, e não há atraso na replicação. Mas essa situação é normal apenas até sabemos que neste cluster deveriam haver três nós, e não dois.
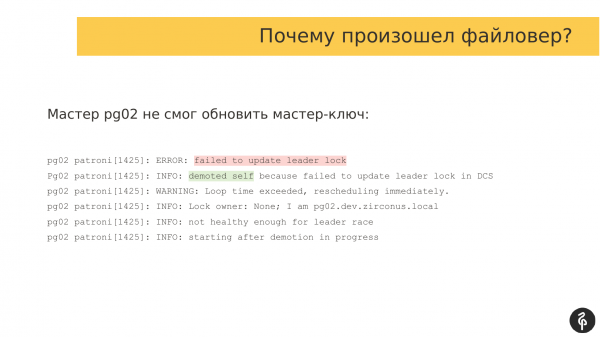
Consequentemente, ocorreu um auto-failover. E depois desse auto-failover, nossa réplica desapareceu. Precisamos descobrir por que ela desapareceu e restaurá-la. E vamos revisar os logs novamente para ver por que aconteceu o auto-failover.
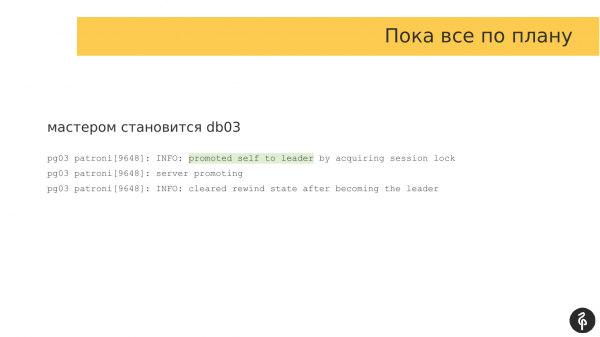
Neste caso, a segunda réplica tornou-se o mestre. Aqui tudo está certo.
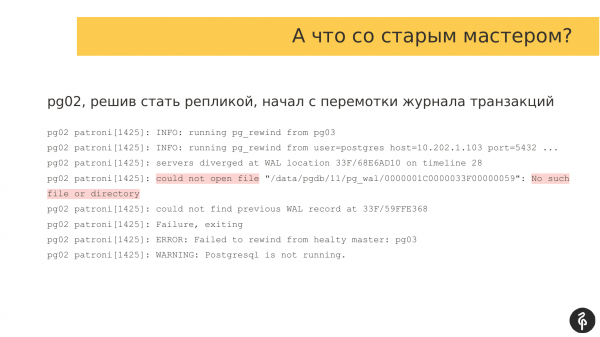
Precisamos observar a réplica que falhou e que não está no cluster. Abrimos os logs do Patroni e verificamos que houve um problema durante o processo de conexão ao cluster na fase pg_rewind. Para se conectar ao cluster, é necessário retroceder o log de transações, solicitar o log de transações necessário do mestre e alcançar o mestre por meio dele.
Neste caso, não temos o log de transações e a réplica não pode inicializar. Consequentemente, estamos parando o Postgres com erro. E por isso, ela não está no cluster.
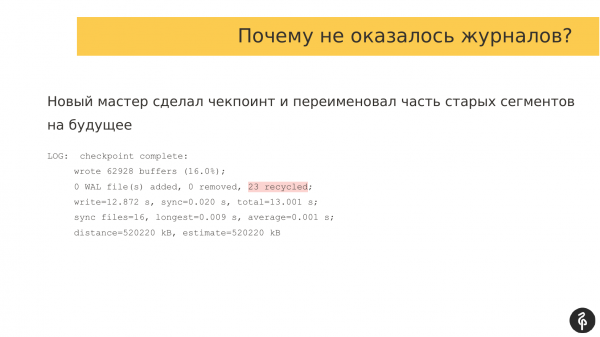
É necessário entender por que ela não está no cluster e por que não houve logs. Vamos ao novo mestre e verificamos o que ele tem nos logs. Acontece que, quando foi feito o pg_rewind, ocorreu um checkpoint. E parte dos antigos logs de transações simplesmente foi renomeada. Quando o antigo mestre tentou se conectar ao novo mestre e solicitar esses logs, eles já estavam renomeados e simplesmente não existiam.
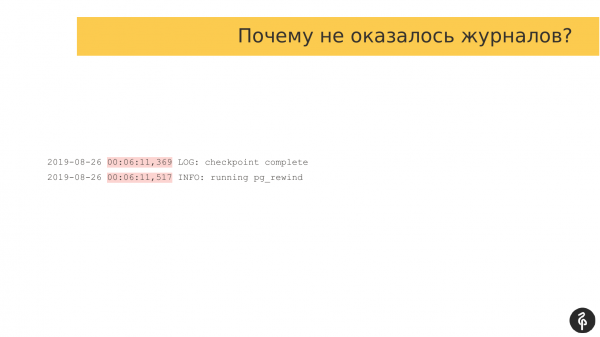
Comparei os timestamps quando esses eventos ocorreram. E a diferença é de apenas 150 milissegundos, ou seja, o checkpoint foi concluído em 369 milissegundos, e os segmentos WAL foram renomeados. E apenas 517 milissegundos depois, rapidamente em 150 milissegundos, o rewind foi iniciado na antiga réplica. Ou seja, apenas 150 milissegundos foram suficientes para que a réplica não conseguisse se conectar e funcionar.
Quais são as opções?
No início, utilizamos slots de replicação. Achávamos que isso era uma boa ideia. Embora, na primeira fase da operação, tenhamos desligado os slots. Pensávamos que, se os slots acumulassem muitos segmentos WAL, poderíamos derrubar o mestre. Ele cairia. Sofremos um tempo sem os slots. E percebemos que precisamos deles, então reativamos os slots.
Mas aqui há um problema: quando o mestre se torna uma réplica, ele apaga os slots e, junto com os slots, exclui os segmentos WAL. Para evitar que esse problema ocorra, decidimos aumentar o parâmetro wal_keep_segments. Por padrão são 8 segmentos. Aumentamos para 1.000 e verificamos quanto espaço livre temos. E nós liberamos 16 gigabytes para o wal_keep_segments. Ou seja, ao alternar, sempre temos um reserva de 16 gigabytes de logs de transações em todos os nós.
E além disso – isso também é relevante para tarefas de manutenção prolongadas. Suponha que precisamos atualizar uma das réplicas. E queremos desligá-la. Precisamos atualizar o software, talvez o sistema operacional, algo mais. E quando desligamos a réplica, o slot também é excluído. E se usarmos um wal_keep_segments pequeno, durante a ausência prolongada da réplica, os logs de transações serão perdidos. Reiniciaremos a réplica, ela solicitará os logs de transações de onde parou, mas pode não haver esses logs no mestre. E a réplica também não conseguirá se conectar. Portanto, mantemos uma grande reserva de logs.
Temos um banco de dados em produção. Já existem projetos em funcionamento lá.
Houve uma falha de sistema de arquivos. Entramos e verificamos - tudo em ordem, as réplicas estão no lugar, não há atraso na replicação. Também não há erros nos logs, tudo em ordem.
A equipe de produtos comenta que deveria haver alguns dados, mas os vemos em uma fonte, enquanto na base não os encontramos. Precisamos entender o que aconteceu com eles.
É evidente que o pg_rewind os apagou. Descobrimos isso imediatamente, mas fomos verificar o que aconteceu.
Nos logs, sempre podemos encontrar quando ocorreu a falha no sistema de arquivos, quem se tornou o mestre e podemos determinar quem era o antigo mestre e quando ele quis se tornar uma réplica, ou seja, precisamos desses logs para identificar a quantidade de logs de transações que foram perdidos.
Nosso antigo mestre reiniciou. E no início automático, estava configurado o Patroni. O Patroni foi iniciado. Em seguida, ele iniciou o Postgres. Mais especificamente, antes de iniciar o Postgres e antes de torná-lo uma réplica, o Patroni executou o processo pg_rewind. Portanto, ele apagou parte dos logs de transações, baixou novos e se conectou. Aqui o Patroni funcionou de forma excepcional, ou seja, exatamente como deveria. Nosso cluster foi restaurado. Tínhamos 3 nós e, após a falha do sistema de arquivos, ainda temos 3 nós – tudo ótimo.
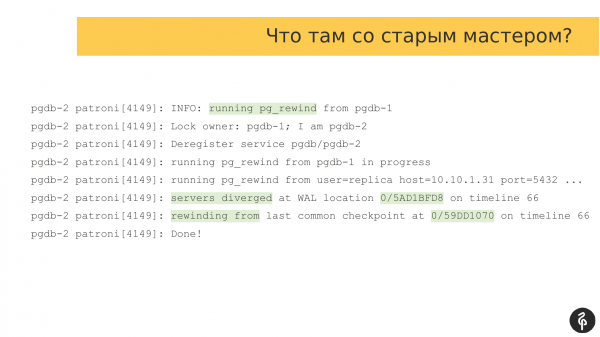
Perdemos uma parte dos dados. E precisamos entender quanto perdemos. Estamos procurando exatamente o momento em que ocorreu o rewind. Podemos encontrar isso por meio de registros no log. O rewind foi iniciado, algo foi feito e finalizado.
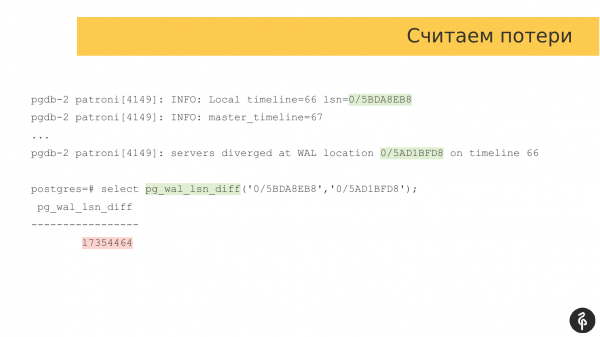
Precisamos encontrar a posição no log de transações onde o antigo mestre parou. Neste caso, é esse ponto aqui. E precisamos de um segundo ponto, ou seja, a distância em que o antigo mestre difere do novo.
Estamos pegando a diferença comum do pg_wal_lsn_diff e comparando esses dois pontos. E, neste caso, obtemos 17 megabytes. Se isso é muito ou pouco, cada um decide por si só. Porque para alguns 17 megabytes é pouco, para outros é muito e inaceitável. Aqui, cada um define individualmente de acordo com as necessidades do negócio.
Mas o que descobrimos para nós mesmos?
Em primeiro lugar, precisamos decidir se sempre precisamos que o Patroni seja iniciado automaticamente após a reinicialização do sistema. Muitas vezes, precisamos acessar o antigo mestre para ver quão longe ele foi. Talvez inspecionar os segmentos do log de transações, ver o que tem lá. E entender se podemos perder esses dados ou se precisamos iniciar o antigo mestre em modo standalone para recuperar essas informações.
E apenas depois disso devemos tomar decisões sobre se podemos descartar esses dados ou se podemos restaurá-los, conectando este nó como uma réplica em nosso cluster.
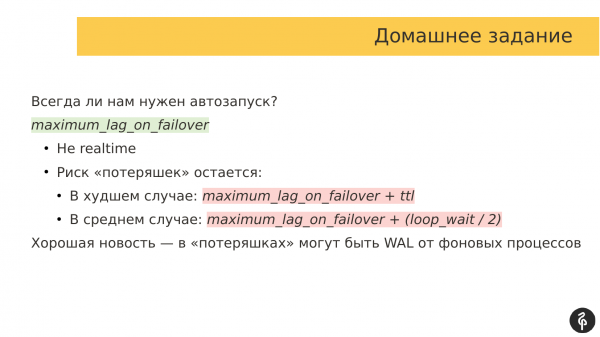
Além disso, há o parâmetro "maximum_lag_on_failover". Por padrão, se não me engano, esse parâmetro tem um valor de 1 megabyte.
Como ele funciona? Se nossa réplica está com uma defasagem de 1 megabyte de dados no lag de replicação, essa réplica não participa das eleições. E se, por acaso, ocorre um failover, o Patroni verifica quais réplicas estão atrasadas. Se elas estão atrasadas por uma grande quantidade de logs de transações, não podem se tornar mestres. Isso é uma função de proteção muito boa, que evita a perda de muitos dados.
Mas há um problema no fato de que o lag de replicação no cluster Patroni e DCS é atualizado em um intervalo específico. Se não estou enganado, 30 segundos é o valor padrão do ttl.
Assim, pode ocorrer uma situação em que o atraso de replicação para as réplicas em DCS seja um, mas na realidade pode haver um atraso completamente diferente ou pode não haver atraso algum, ou seja, isso não é em tempo real. E não reflete sempre a realidade. Portanto, não vale a pena construir uma lógica complicada sobre isso.
E o risco de perda sempre permanece. No pior caso, uma fórmula, e no caso médio, outra fórmula. Isso é, ao planejar a implementação do Patroni e avaliar quanto dados podemos perder, devemos nos basear nessas fórmulas e ter uma ideia de quanta informação podemos perder.
E há uma boa notícia. Quando o antigo mestre avançou, ele pode ter avançado devido a alguns processos em segundo plano. Ou seja, havia um autovacuum que registrou os dados e os salvou no log de transações. E esses dados podemos facilmente ignorar e perder. Não há problema nisso.
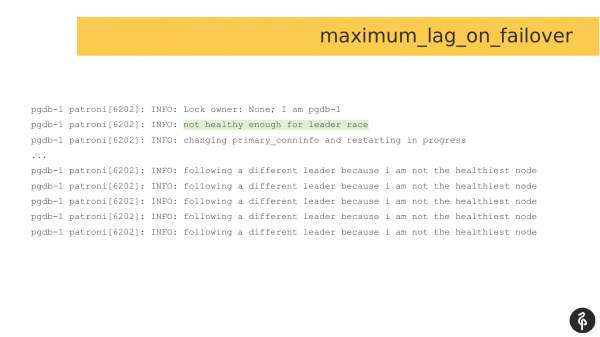
E assim é como aparecem os logs se o maximum_lag_on_failover estiver definido e ocorrer um failover, e é necessário escolher um novo mestre. A réplica se avalia como incapaz de participar das eleições. E ela recusa a participação na corrida pela liderança. E ela espera até que um novo mestre seja escolhido para se conectar a ele posteriormente. Essa é uma medida adicional contra a perda de dados.
Aqui nossa equipe de produto informou que seu produto está enfrentando problemas ao trabalhar com Postgres. Entretanto, não é possível acessar o próprio mestre, pois ele não está disponível via SSH. Além disso, o auto-failover também não está acontecendo.
Este host foi forçado a reiniciar. Devido à reinicialização, ocorreu um auto-failover, embora pudesse ter sido realizado um failover manual, como entendo agora. E após a reinicialização, já vamos verificar o que aconteceu com o mestre atual.
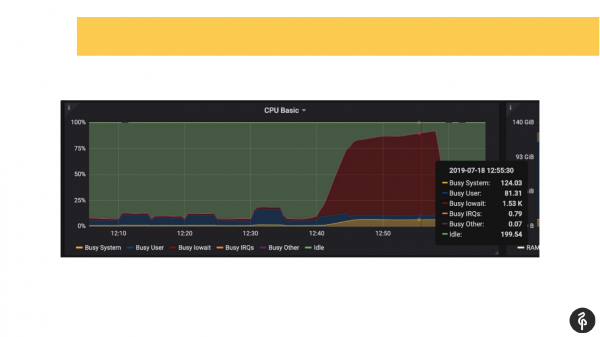
Nesse intervalo, já sabíamos que tínhamos problemas com os discos, ou seja, já estávamos cientes, por meio de monitoramento, de onde procurar e o que buscar.
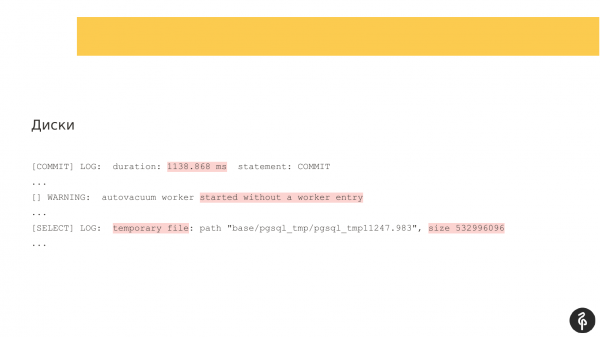
Entramos no log do postgres e começamos a ver o que acontecia. Observamos commits que duram de um a três segundos, o que não é normal. Vimos que o autovacuum estava demorando muito e de maneira estranha para ser acionado. E notamos arquivos temporários no disco. Ou seja, todos esses são indicadores de problemas com os discos.
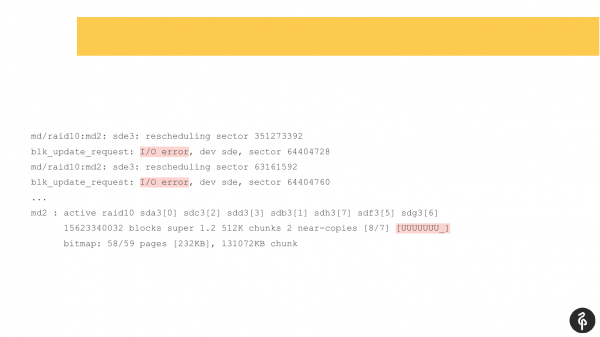
Demos os logs do sistema dmesg (no log de mensagens do kernel). E vimos que temos problemas com um dos discos. O subsistema de disco era um software RAID. Nós olhamos o /proc/mdstat e percebemos que um dos discos estava faltando. Ou seja, temos um RAID de 8 discos e estamos sem um. Se olharmos atentamente para o slide, podemos ver que o sde está ausente. Em termos simples, um disco falhou. Isso desencadeou problemas de disco, e os aplicativos também enfrentaram dificuldades ao trabalhar com o cluster Postgres.
E nesse caso, o Patroni não nos ajudaria, porque o Patroni não tem a função de monitorar o estado do servidor, nem o estado do disco. Precisamos monitorar essas situações externamente. Adicionamos o monitoramento de discos ao monitoramento externo rapidamente.
E houve essa ideia - será que o fencing ou um watchdog de software poderia nos ajudar? Pensamos que provavelmente não nos ajudaria nesse caso, porque durante os problemas, o Patroni continuava a interagir com o cluster DCS e não detectava nenhuma falha. Ou seja, do ponto de vista do DCS e do Patroni, tudo estava bem no cluster, embora houvesse problemas de disco e de disponibilidade do banco de dados.
Na minha opinião, esse é um dos problemas mais estranhos que pesquisei, passei muito tempo lendo logs, revirando tudo e o chamei de simulador de cluster.
O problema era que o antigo mestre não conseguia se tornar uma réplica normal, ou seja, o Patroni o iniciava, e o Patroni mostrava que esse nó estava presente como réplica, mas na verdade não era uma réplica normal. Agora você verá por quê. Isso ficou registrado na análise daquele problema.
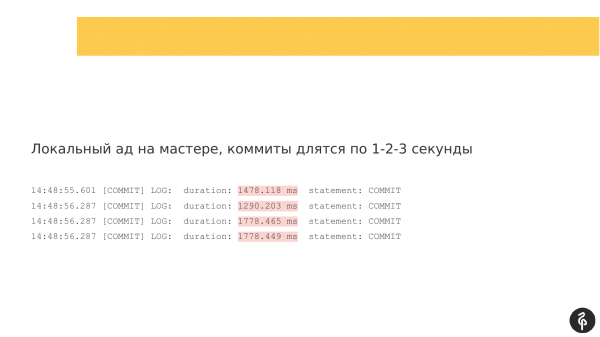
E como tudo começou? Começou, assim como no problema anterior, com travamentos nos discos. Tivemos commits a cada segundo, ou dois.
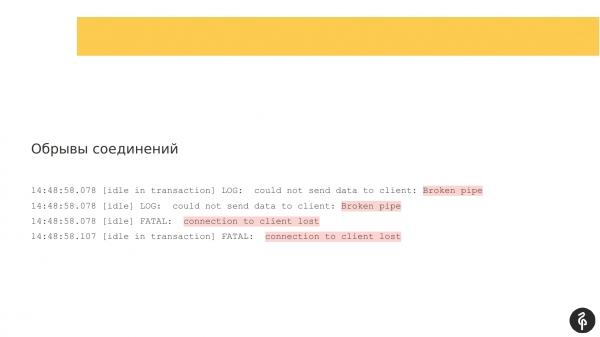
Houve interrupções nas conexões, ou seja, os clientes estavam sendo desconectados.
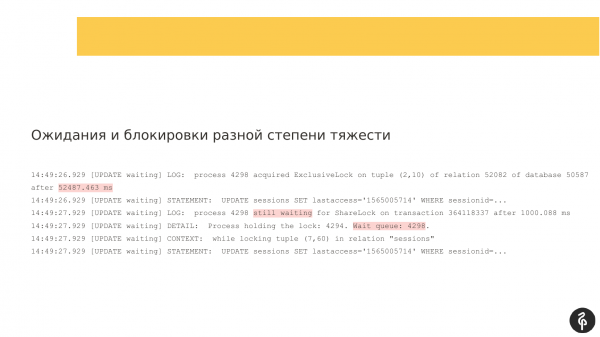
Houve bloqueios de diferentes gravidades.
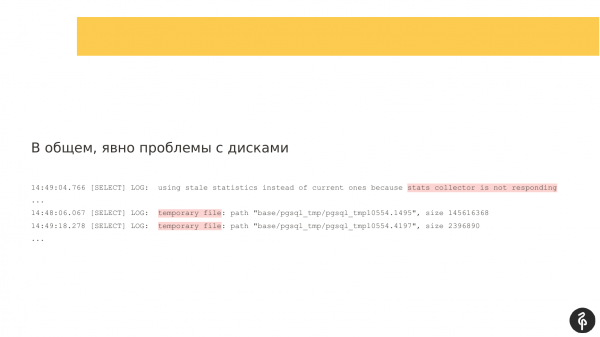
E, consequentemente, o subsistema de disco não era muito responsivo.
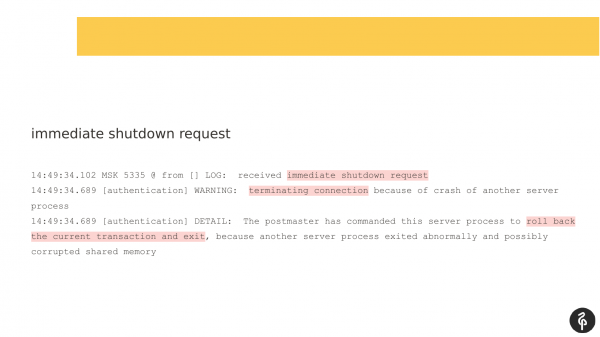
E o mais enigmático para mim foi o pedido de desligamento imediato que chegou. O Postgres tem três modos de desligamento:
- O modo gracioso, quando esperamos que todos os clientes se desconectem sozinhos.
- Há o modo rápido, quando forçamos os clientes a se desconectarem, porque estamos indo para o desligamento.
- E immediate. Neste caso, o immediate nem mesmo avisa os clientes que precisa ser desligado, ele simplesmente se desliga sem aviso. E para todos os clientes, o sistema operacional já envia uma mensagem RST (mensagem TCP informando que a conexão foi interrompida e que não há mais nada para o cliente fazer).
Quem enviou esse sinal? Processos em segundo plano do Postgres não enviam esse tipo de sinal um ao outro, ou seja, isso é um kill-9. Eles não enviam isso um para o outro, eles apenas reagem a isso, ou seja, é um reinício de emergência do Postgres. Quem o enviou, eu não sei.
Eu olhei pelo comando 'last' e vi uma pessoa que também fez login neste servidor junto conosco, mas me acovardei de fazer a pergunta. Talvez tenha sido um kill -9. Eu teria visto isso nos logs, pois o Postgres registra que recebeu um kill -9, mas não vi isso nos logs.
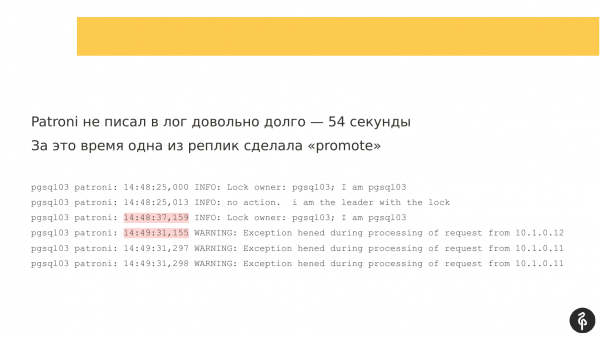
Aprofundando-me mais, vi que o Patroni não escreveu no log por um bom tempo – 54 segundos. E se compararmos dois timestamps, durante cerca de 54 segundos não houve mensagens.
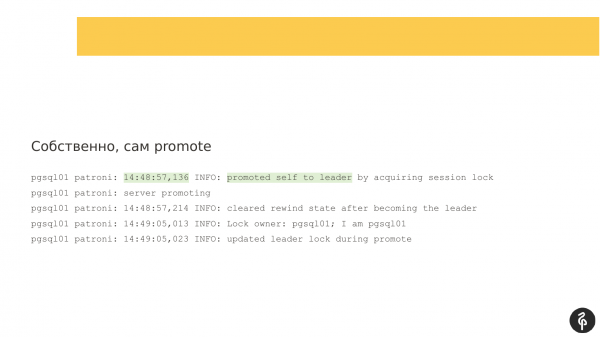
E nesse tempo ocorreu um failover automático. O Patroni funcionou novamente perfeitamente. Nosso antigo mestre estava indisponível, algo estava acontecendo com ele. E começaram as eleições para um novo mestre. Aqui tudo funcionou bem. O nosso pgsql01 se tornou o novo líder.
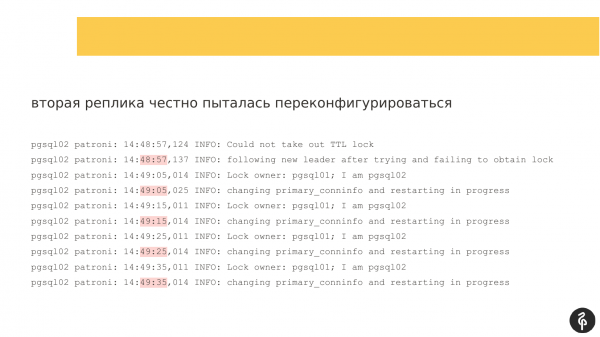
Temos uma réplica que se tornou mestre. E há uma segunda réplica. E com a segunda réplica houve problemas. Ela estava tentando se reconfigurar. Pelo que entendi, ela tentava mudar o recovery.conf, reiniciar o Postgres e se conectar ao novo mestre. A cada 10 segundos, ela envia mensagens de que está tentando, mas não consegue.
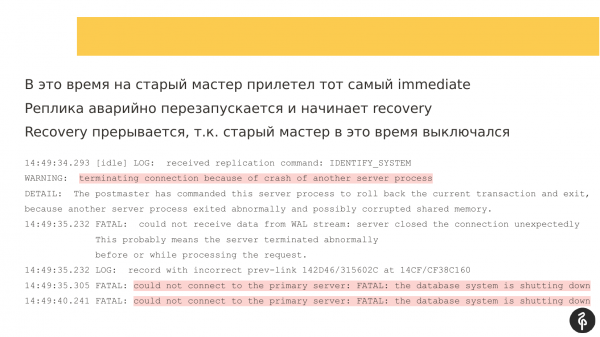
E durante essas tentativas, um sinal de immediate-shutdown chegou ao antigo mestre. O mestre reiniciou. E também a recuperação foi interrompida, porque o antigo mestre estava reiniciando. Ou seja, a réplica não pode se conectar a ele, pois ele está em modo desligado.
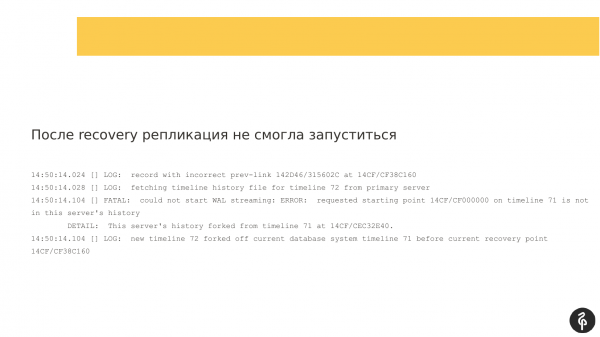
Em algum momento ela funcionou, mas a replicação não foi iniciada.
Eu tenho apenas uma hipótese de que no recovery.conf havia o endereço do antigo mestre. E quando o novo mestre apareceu, a segunda réplica ainda estava tentando se conectar ao antigo mestre.
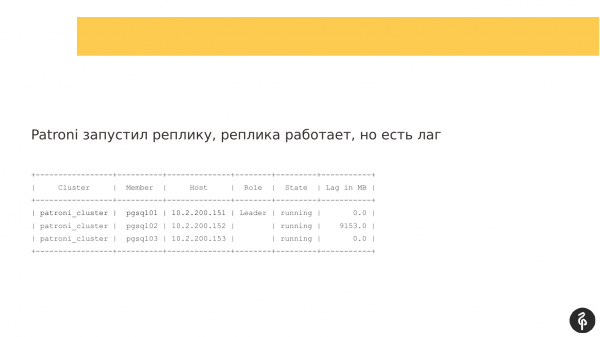
Quando o Patroni foi iniciado na segunda réplica, o nó foi iniciado, mas não conseguiu se conectar pela replicação. E houve um atraso na replicação, que parecia mais ou menos assim. Ou seja, todos os três nós estavam no lugar, mas o segundo nó estava atrasado.
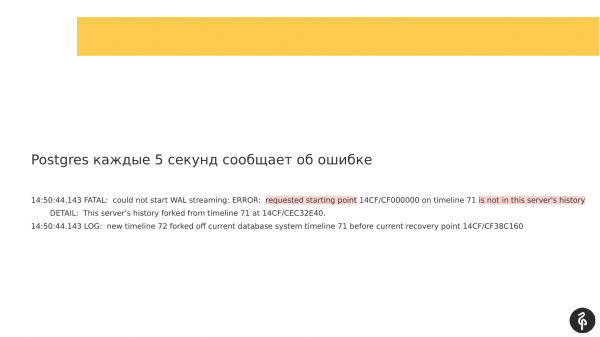
Entretanto, ao olhar os logs que foram gerados, pude ver que a replicação não conseguia iniciar porque os logs de transações estavam diferentes. E os logs de transações que o master oferece, que estão especificados no recovery.conf, simplesmente não se adequavam ao nosso nó atual.
E aqui eu cometi um erro. Eu deveria ter ido verificar o que estava no recovery.conf para checar a minha hipótese de que estávamos nos conectando ao mestre errado. Mas eu estava apenas começando a entender isso e isso não me ocorreu, ou eu vi que a replicação estava atrasada e que teríamos que reinicializá-la, ou seja, eu acabei fazendo isso de qualquer jeito. Esse foi meu erro.
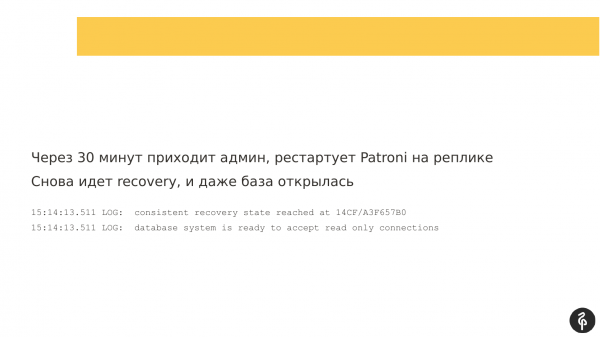
Depois de 30 minutos, o administrador chegou, ou seja, eu reiniciei o Patroni na réplica. Eu já tinha dado como perdida, achava que teríamos que reinicializá-la. E pensei – vou reiniciar o Patroni, talvez resulte em algo bom. A recuperação iniciou. E o banco de dados até abriu, estava pronto para aceitar conexões.
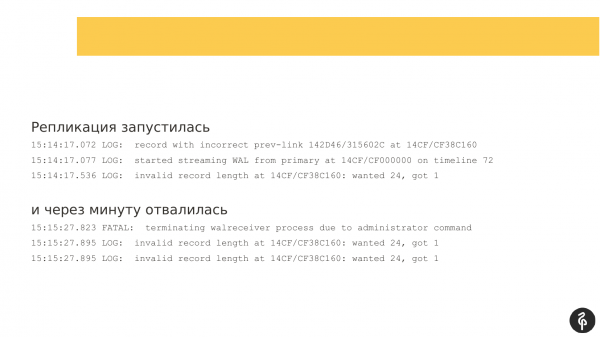
A replicação foi iniciada. Mas após um minuto, ela apresentou erro, dizendo que os logs de transações não eram compatíveis.
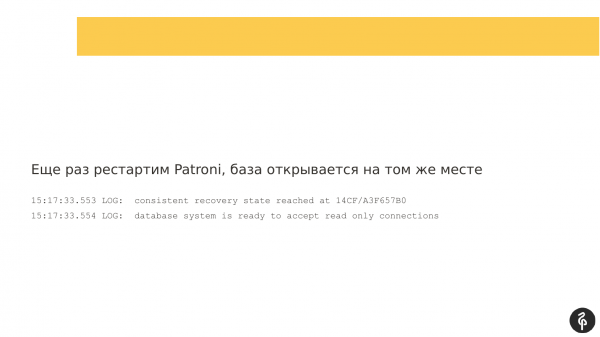
Pensei que reiniciaria mais uma vez. Reiniciei o Patroni novamente, sendo que não reiniciei o Postgres, apenas reiniciei o Patroni na esperança de que ele magicamente fizesse o banco de dados iniciar.
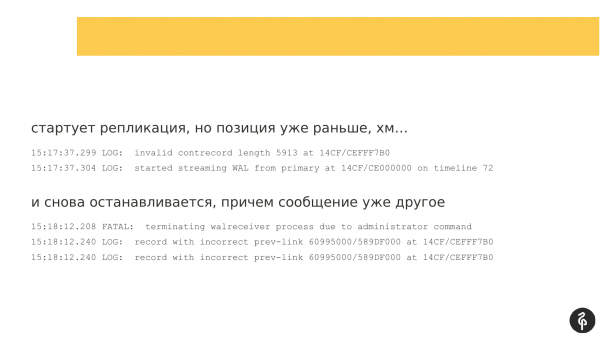
A replicação começou novamente, mas os marcadores nos logs de transações estavam diferentes, não eram os mesmos da tentativa anterior de inicialização. A replicação parou novamente. E a mensagem já era um pouco diferente. E ela não era muito informativa para mim.
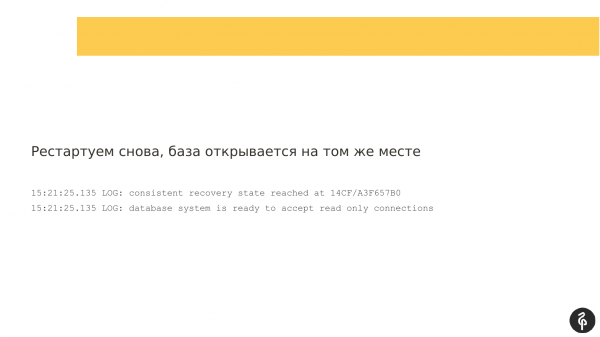
E então me ocorreu – e se eu reiniciar o Postgres, ao mesmo tempo em que faço um checkpoint no mestre, para mover o ponto no log de transações um pouco mais adiante, para que a recuperação inicie de um momento diferente? Além disso, tínhamos reservas de WAL.
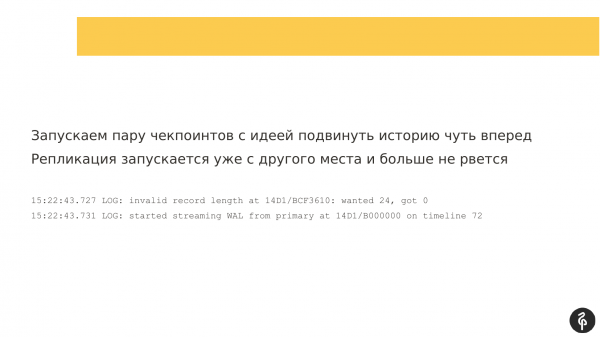
Reiniciei o Patroni, fiz alguns checkpoints no mestre, alguns pontos de reinício na réplica, quando ela abriu. E isso ajudou. Eu pensei muito sobre por que isso ajudou e como funcionou. E a réplica iniciou. E a replicação não caiu mais.
Essa é uma das questões mais enigmáticas para mim, sobre a qual ainda me pergunto o que realmente estava acontecendo.
Quais são as conclusões aqui? O Patroni pode funcionar como planejado e sem erros. Mas isso não garante 100% que tudo está bem. A réplica pode iniciar, mas pode estar em um estado semi-funcional, e o aplicativo não deve operar com tal réplica, pois conterá dados antigos.
E após cada failover, é sempre necessário verificar se tudo está em ordem com o cluster, ou seja, se há o número necessário de réplicas e se não há latência na replicação.
Enquanto abordo esses problemas, vou formular recomendações. Tentei agrupá-las em dois slides. Na verdade, todas as histórias poderiam ser reunidas em dois slides e apenas contadas.
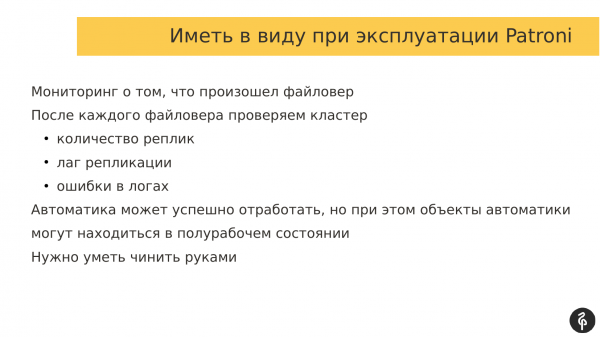
Quando você usa o Patroni, deve haver monitoramento. Você sempre precisa saber quando ocorreu um failover automático, porque se você não souber que houve um failover, não estará controlando o cluster. E isso é ruim.
Após cada failover, devemos sempre verificar manualmente o cluster. Precisamos garantir que temos sempre o número atual de réplicas, que não há latência na replicação e que não há erros nos logs relacionados à replicação em fluxo, ao Patroni ou ao sistema DCS.
A automação pode funcionar com sucesso, o Patroni é uma ferramenta muito boa. Ela pode funcionar, mas isso não leva o cluster ao estado desejado. E se não soubermos disso, teremos problemas.
E o Patroni não é uma solução mágica. Ainda precisamos entender como o Postgres funciona, como a replicação funciona e como o Patroni interage com o Postgres e como a comunicação entre os nós é garantida. Isso é necessário para poder resolver manualmente os problemas que surgem.
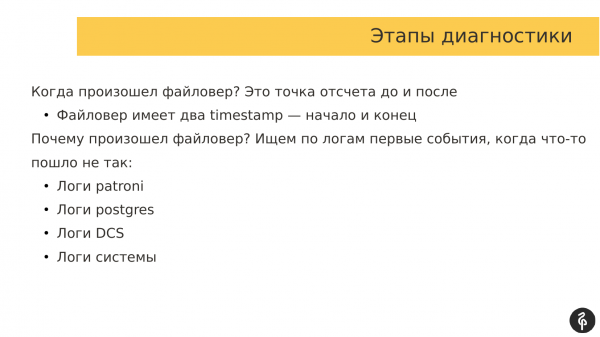
Como eu abordo a questão do diagnóstico? Chegou ao ponto em que trabalhamos com diferentes clientes e ninguém tem uma pilha ELK, então temos que entender os logs abrindo 6 consoles e 2 abas. Em uma aba, estão os logs do Patroni para cada nó, e na outra aba, estão os logs do Consul ou do Postgres, se necessário. Diagnosticar isso é muito difícil.
Quais abordagens eu desenvolvi? Primeiro, eu sempre olho para quando o failover ocorreu. E para mim, isso é uma divisão importante. Eu analiso o que aconteceu antes, durante e depois do failover. O failover tem duas marcações: o horário de início e o de término.
Em seguida, eu olho nos logs os eventos antes do failover, o que precedeu o failover, ou seja, procuro as razões pelas quais o failover ocorreu.
E isso fornece uma compreensão do que aconteceu e o que pode ser feito no futuro para que tais circunstâncias não ocorram (e, como consequência, o failover não aconteça).
E para onde geralmente olhamos? Eu olho para:
- Primeiro, nos logs do Patroni.
- Em seguida, olho os logs do Postgres ou os logs do DCS, dependendo do que encontrei nos logs do Patroni.
- E os logs do sistema também às vezes fornecem entendimento sobre o que causou o failover.
Como eu vejo o Patroni? Eu vejo o Patroni muito bem. Na minha opinião, é o melhor que existe hoje. Eu conheço muitos outros produtos, como Stolon, Repmgr, Pg_auto_failover, PAF. Quatro ferramentas. Eu tentei todas. O Patroni foi o que mais gostei.
Se me perguntarem: "Recomendaria o Patroni?" Eu direi que sim, porque eu gosto do Patroni. E, parece-me que aprendi a configurá-lo.
Se você estiver interessado em ver quais outros problemas existem com o Patroni, além dos problemas que mencionei, você sempre pode visitar a página no GitHub. Há muitas histórias diferentes lá e muitas questões interessantes são discutidas. E, no final, alguns bugs foram detectados e resolvidos, ou seja, é uma leitura interessante.
Lá existem histórias interessantes sobre como as pessoas fazem escolhas erradas. Muito informativo. Você lê e entende que não deve agir daquela maneira. Marquei essa lição.
E gostaria de agradecer muito à empresa Zalando por desenvolver este projeto, especialmente a Alexander Kukushkin e Alexey Klyukin. Alexey Klyukin é um dos co-autores, ele já não trabalha mais na Zalando, mas são duas pessoas que começaram a trabalhar com este produto.
E eu considero que o Patroni é uma ferramenta incrível. Estou satisfeito por existirem, é interessante trabalhar com ela. E um grande obrigado a todos os contribuidores que escrevem patches para o Patroni. Espero que o Patroni se torne mais maduro, melhor e mais eficiente com o tempo. Já é funcional, mas espero que se torne ainda melhor. Portanto, se você planeja usar o Patroni, não tenha medo. É uma boa solução, pode ser implementada e utilizada.
Isso é tudo. Se você tiver perguntas, sinta-se à vontade para perguntar.
Perguntas
Obrigado pela apresentação! Se, após o failover, ainda precisarmos olhar muito de perto, então por que precisamos de um failover automático?
Porque é uma nova ferramenta. Trabalhamos com ela há apenas um ano. É melhor ser cauteloso. Queremos entrar e ver se tudo funcionou como deveria. É um nível de desconfiança maduro – é melhor verificar e observar.
Por exemplo, entramos pela manhã e verificamos, certo?
Não pela manhã, normalmente sabemos sobre o failover automático quase que imediatamente. Recebemos notificações, vemos que ocorreu um failover automático. Entramos e verificamos praticamente de imediato. Mas todas essas verificações devem ser realocadas para o nível de monitoramento. Se você acessar o Patroni via API REST, há um histórico. No histórico, pode-se observar as marcas temporais em que ocorreu o failover. Com base nisso, é possível fazer o monitoramento. Podemos verificar o histórico e ver quantos eventos ocorreram. Se tivermos mais eventos, significa que ocorreu um failover automático. Podemos entrar e verificar. Ou nossa automação no monitoramento verificou que todas as réplicas estão no lugar, sem atrasos e tudo está bem.
Obrigado!
Muito obrigado pela excelente explicação! Se deslocamos o cluster DCS para longe do cluster Postgres, é necessário manutenção periódica deste cluster também? Quais são as melhores práticas em relação a partes do cluster DCS que precisam ser desligadas, o que fazer com elas, etc.? Como essa estrutura continua funcionando? E como devemos proceder?
Para uma empresa, foi necessário criar uma matriz de problemas, que descreve o que acontece se algum dos componentes ou vários componentes falharem. Com base nessa matriz, analisamos sequencialmente todos os componentes e construímos cenários para a falha desses componentes. Consequentemente, para cada cenário de falha, pode-se ter um plano de ação para recuperação. E no caso do DCS, isso é parte da infraestrutura padrão. O administrador a gerencia, e já contamos com os administradores para isso e suas habilidades de consertar em caso de falhas. Se não houver DCS, nós o implantamos, mas sem monitorá-lo de perto, pois não somos responsáveis pela infraestrutura, apenas fornecemos recomendações sobre como e o que monitorar.
Ou seja, estou correto em entender que é necessário desligar o Patroni, desativar o failover, desligar tudo antes de fazer algo com os hosts?
Isso depende de quantos nós temos no cluster DCS. Se houver muitos nós e se derrubarmos apenas um nó (réplica), o quórum é mantido no cluster. E o Patroni permanece funcional. E nada é acionado. Se tivermos operações complexas que afetam mais nós, cuja ausência pode romper o quórum, então – sim, talvez faça sentido pausar o Patroni. Ele tem um comando apropriado – patronictl pause, patronictl resume. Nós simplesmente pausamos, e o failover automático não é acionado nesse momento. Fazemos a manutenção no cluster DCS, depois retiramos a pausa e continuamos a operar.
Muito obrigado!
Muito obrigado pela apresentação! Como a equipe de produto se sente em relação à possível perda de dados?
A equipe de produto não se preocupa, mas os líderes de equipe estão apreensivos.
Quais garantias existem nesse caso?
Com garantias é muito complicado. Há uma apresentação de Alexander Kukushkin sobre "Como calcular RPO e RTO", ou seja, o tempo de recuperação e quanto podemos perder de dados. Eu acho que precisamos encontrar esses slides e estudá-los. Pelo que me lembro, há passos específicos sobre como calcular essas coisas. Quantas transações podemos perder, quantos dados podemos perder. Como uma opção, podemos usar replicação síncrona no nível do Patroni, mas isso é uma faca de dois gumes: ou temos confiabilidade dos dados, ou perdemos em velocidade. Existe replicação síncrona, mas ela também não garante 100% de proteção contra perda de dados.
Alexei, obrigado pela excelente apresentação! Você tem experiência no uso do Patroni para proteção de nível zero? Ou seja, em conjunto com um standby síncrono? Essa é a primeira pergunta. E a segunda pergunta. Você utilizou diferentes soluções. Nós utilizamos Repmgr, mas sem failover automático e agora estamos planejando conectar o failover automático. Estamos considerando o Patroni como uma solução alternativa. O que você pode dizer sobre as vantagens em comparação com o Repmgr?
A primeira pergunta foi sobre réplicas síncronas. Ninguém usa replicação síncrona, porque todos têm medo (Já estamos usando com alguns clientes, e não notamos problemas de desempenho — Nota do apresentador). Mas nós estabelecemos uma regra de que deve haver pelo menos três nós em um cluster de replicação síncrona, porque se tivermos dois nós e se o mestre ou a réplica falharem, o Patroni coloca esse nó em modo autônomo para que o aplicativo continue funcionando. Nesse caso, existem riscos de perda de dados.
Quanto à segunda pergunta, usamos o Repmgr e ainda o utilizamos com alguns clientes por motivos históricos. O que posso dizer? No Patroni, o failover automático vem de forma nativa, enquanto no Repmgr o failover automático é uma função adicional que precisa ser ativada. É necessário iniciar o daemon do Repmgr em cada nó e então podemos configurar o failover automático.
O Repmgr verifica se os nós do Postgres estão vivos. Os processos do Repmgr verificam a existência uns dos outros, esse não é um método muito eficiente, pois podem ocorrer casos complexos de isolamento de rede em que um grande cluster do Repmgr pode se dividir em vários menores e continuar a funcionar. Não tenho acompanhado o Repmgr há algum tempo, pode ser que isso tenha sido corrigido... ou talvez não. Mas a transferência de informações sobre o estado do cluster para o DCS, como faz o Stolon, o Patroni, é a opção mais viável.
Alexey, tenho uma pergunta que talvez seja meio ingênua. Em um dos primeiros exemplos, você transferiu do computador local para um nó remoto. Entendemos que a rede tem suas particularidades e que vive por si só. E o que acontece se, por algum motivo, o cluster DCS se tornar inacessível? Não vou entrar nos motivos, pois eles podem ser muitos: desde erros da equipe de rede até problemas reais.
Não mencionei isso em voz alta, mas o cluster DCS também deve ser tolerante a falhas, ou seja, deve ter um número ímpar de nós para que um quórum possa ser alcançado. O que acontece se o cluster DCS se tornar inacessível ou se não conseguir formar um quórum, ou seja, um split de rede ou falha de nós? Nesse caso, o cluster do Patroni passa para o modo somente leitura. O cluster do Patroni não consegue determinar o estado do cluster e o que fazer. Ele não consegue se conectar ao DCS e salvar o novo estado do cluster, por isso todo o cluster passa para o modo somente leitura. E aguarda a intervenção manual do operador ou a recuperação do DCS.
De certa forma, o DCS se torna um serviço tão importante para nós quanto o próprio banco de dados?
Sim, sim. Em muitas empresas modernas, a Descoberta de Serviços é uma parte essencial da infraestrutura. Ela é implementada até antes mesmo de existir uma base de dados na infraestrutura. Para simplificar, a infraestrutura foi iniciada, montada no DC, e já temos a Descoberta de Serviços. Se for o Consul, o DNS pode ser construído sobre ele. Se for o Etcd, pode ser uma parte do cluster Kubernetes, onde todo o resto será implementado. Parece-me que a Descoberta de Serviços já é parte intrínseca das infraestruturas modernas. E as empresas pensam nela muito antes de pensarem nas bases de dados.
Obrigado!
Fonte: habr.com
