

Olá, Habr!
Lembramos que publicamos mais um conteúdo extremamente interessante e útil sobre os padrões do Kubernetes. Tudo começou com "" de Brendan Burns, e, de fato, o trabalho nesta área está . Hoje, nós oferecemos a você a leitura de um artigo do blog MinIO, que resume as tendências e a especificidade dos padrões de armazenamento de dados no Kubernetes.
O Kubernetes transformou fundamentalmente os padrões tradicionais de desenvolvimento e implantação de aplicações. Agora, uma equipe pode levar apenas alguns dias para desenvolver, testar e implantar uma aplicação em diferentes ambientes, tudo dentro de clusters Kubernetes. Esse tipo de trabalho com tecnologias anteriores geralmente levava semanas, se não meses.
Essa aceleração foi possível graças à abstração proporcionada pelo Kubernetes — ou seja, pelo fato de que o Kubernetes lida com os detalhes de baixo nível das máquinas físicas ou virtuais, permitindo que os usuários especifiquem, entre outros parâmetros, o processador necessário, o volume de memória necessário e o número de instâncias de contêineres. Como o suporte ao Kubernetes é mantido por uma vasta comunidade e a aplicação do Kubernetes continua a se expandir, ele lidera de longe entre todas as plataformas de orquestração de contêineres.
À medida que o uso do Kubernetes se expande, também cresce a confusão sobre os padrões de armazenamento de dados utilizados.
Com a intensa concorrência pela fatia do mercado do Kubernetes (ou seja, pelo armazenamento de dados), quando se fala de armazenamento de dados, os sinais se perdem em um ruído alto.
O Kubernetes incorpora um modelo moderno de desenvolvimento e implantação de aplicações, bem como sua gestão. Esse modelo moderno desacopla o armazenamento de dados dos cálculos. Para compreender totalmente esse desacoplamento no contexto do Kubernetes, também é necessário entender o que são aplicativos que mantêm estado e aqueles que não mantêm estado, e como isso se relaciona com o armazenamento de dados. É aqui que a abordagem da API REST, aplicada ao S3, apresenta vantagens claras em comparação com a abordagem POSIX/CSI, característica de outras soluções.
Neste artigo, vamos falar sobre padrões de armazenamento de dados no Kubernetes e abordar a questão das aplicações que operam sem estado e com estado, para entender a diferença entre elas e sua importância. No texto, serão discutidas as aplicações e os padrões de armazenamento de dados utilizados à luz das melhores práticas em containers e Kubernetes.
Containers sem estado
Containers são, por natureza, leves e efêmeros. Eles podem ser facilmente parados, removidos ou implantados em outro nó – tudo isso leva apenas alguns segundos. Em um sistema de orquestração de containers grande, essas operações acontecem constantemente, e os usuários mal percebem essas mudanças. No entanto, as movimentações são possíveis apenas se o container não tiver dependências do nó em que está localizado. Containers assim são ditos como funcionando sem estado.
Containers com estado
Se um container armazena dados em dispositivos localmente conectados (ou em um dispositivo de bloco), o armazenamento de dados em que ele reside precisará ser movido para um novo nó junto com o próprio container – em caso de falha. Isso é importante, pois caso contrário, a aplicação em execução no container não conseguirá funcionar corretamente, pois precisa acessar os dados armazenados em mídias locais. Containers assim são ditos como funcionando com estado.
Sob uma perspectiva técnica, containers com estado também podem ser movidos para outros nós. Geralmente, isso é garantido através de sistemas de arquivos distribuídos ou armazenamento em bloco de rede anexados a todos os nós onde os containers estão em execução. Assim, os containers têm acesso a volumes para armazenamento persistente, e as informações são mantidas em discos distribuídos pela rede. Eu chamarei esse método de "abordagem de containers com estado", e na parte restante do artigo o chamarei assim por uma questão de uniformidade.
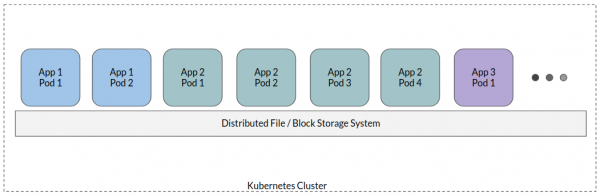
Na abordagem típica de contêiner com estado, todos os pods de aplicativos estão conectados a um único sistema de arquivos distribuído – formando uma espécie de armazenamento compartilhado, onde todos os dados dos aplicativos residem. Embora algumas variações sejam possíveis, essa é uma abordagem de alto nível.
Agora, vamos analisar por que a abordagem de contêiner com estado no mundo orientado para a nuvem é um antipadrão.
Projeto de aplicativos orientado para a nuvem
Tradicionalmente, os aplicativos usavam bancos de dados para armazenamento estruturado de informações e discos locais ou sistemas de arquivos distribuídos, onde todos os dados não estruturados ou até mesmo semi-estruturados eram armazenados. À medida que o volume de dados não estruturados crescia, os desenvolvedores perceberam que o POSIX era excessivamente 'falante', implicava custos significativos e, no final das contas, dificultava o funcionamento do aplicativo ao escalar para realmente grandes dimensões.
Isso basicamente contribuiu para o surgimento de um novo padrão de armazenamento de dados, ou seja, armazenamento orientado para a nuvem, que opera principalmente com base em REST API e isenta o aplicativo da manutenção onerosa de um armazenamento local de dados. Nesse caso, o aplicativo efetivamente entra em um modo de operação sem estado (uma vez que o estado está em um armazenamento remoto). Aplicativos modernos são construídos desde o início levando esse fator em consideração. Geralmente, qualquer aplicativo moderno que processa dados de algum tipo (logs, metadados, blobs, etc.) é construído dentro da paradigma orientada para a nuvem, onde o estado é transferido para um sistema de software especialmente designado para seu armazenamento.
A abordagem de contêiner com estado faz com que toda essa paradigma retorne exatamente ao ponto de partida!
Ao usar interfaces POSIX para o armazenamento de dados, os aplicativos operam de maneira semelhante a como se estivessem salvando estados, afastando-se assim dos postulados mais importantes do design orientado à nuvem, ou seja, da capacidade de variar o tamanho das cargas de trabalho dos aplicativos de acordo com a carga de entrada, mudar para um novo nó assim que o atual falhar, e assim por diante.
Ao analisarmos essa situação mais de perto, percebemos que, ao escolher um armazenamento de dados, enfrentamos repetidamente o dilema "POSIX versus REST API", MAS com a agravante dos problemas do POSIX, devido à natureza distribuída dos ambientes Kubernetes. Em particular,
- O POSIX é prolixo: a semântica POSIX exige a associação de metadados e descritores de arquivos a cada operação, que ajudam a manter o estado da operação. Isso resulta em custos significativos, que não têm valor real. A API de armazenamento de objetos, em particular, a API S3, eliminou esses requisitos, permitindo que o aplicativo fosse executado e, em seguida, "esquecesse" a chamada. A resposta do sistema de armazenamento informa se a ação foi realizada com sucesso ou não. No caso de falha, o aplicativo pode tentar novamente.
- Restrições de rede: Em um sistema distribuído, presume-se que possa haver múltiplos aplicativos tentando gravar dados em um mesmo dispositivo acoplado. Portanto, não só os aplicativos competirão entre si pela largura de banda (para enviar dados ao dispositivo), mas o próprio sistema de armazenamento competirá por essa largura de banda, distribuindo dados entre os discos físicos. Devido à verbosidade do POSIX, o número de chamadas de rede aumenta significativamente. Por outro lado, a API S3 fornece uma clara distinção entre as chamadas de rede que vêm do cliente para o servidor e aquelas que ocorrem dentro do servidor.
- Segurança: O Modelo de Segurança POSIX é projetado para a participação ativa dos usuários: os administradores configuram níveis de acesso específicos para cada usuário ou grupo. Essa abordagem é complicada para se adaptar ao mundo orientado à nuvem. Aplicações modernas dependem de modelos de segurança vinculados à API, onde os direitos de acesso são definidos como um conjunto de políticas, com contas de serviço e credenciais temporárias, entre outras.
- Gerenciabilidade: Contêineres com estado persistente trazem certos custos relacionados à gestão. Isso inclui a sincronização de acessos paralelos a dados e a garantia da consistência dos dados, exigindo uma análise cuidadosa sobre quais padrões de acesso usar. É necessário instalar, monitorar e configurar programas adicionais, sem mencionar os esforços extra exigidos no desenvolvimento.
Interface de Armazenamento de Contêineres
Embora a Interface de Armazenamento de Contêineres (CSI) tenha facilitado a disseminação do nível de volumes no Kubernetes, transferindo parte do controle para fornecedores terceiros de armazenamento, também, inadvertidamente, contribuiu para a crença de que a abordagem de contêineres com estado persistente é o método recomendado de armazenamento de dados no Kubernetes.
O CSI foi desenvolvido como um padrão para fornecer sistemas de armazenamento de bloco e arquivo a aplicações legadas em interação com Kubernetes. Como mostrado neste artigo, a única situação em que a abordagem de contêineres com estado persistente (e o CSI em sua forma atual) é viável é quando a própria aplicação é um sistema legado, no qual não é possível adicionar suporte para API de armazenamento de objetos.
É importante entender que, ao usar o CSI em sua forma atual, ou seja, montando volumes ao trabalhar com aplicações modernas, enfrentaremos problemas similares aos que surgiram em sistemas onde o armazenamento de dados é organizado no estilo POSIX.
Uma abordagem de maior qualidade
Neste caso, é importante compreender que a maioria dos aplicativos não é projetada, essencialmente, para funcionar com armazenamento de estado ou sem armazenamento de estado. Esse comportamento depende da arquitetura geral do sistema e das escolhas específicas feitas durante o design. Vamos falar um pouco sobre aplicativos que mantêm o estado.
Em linhas gerais, todos os dados dos aplicativos podem ser classificados em vários tipos amplos:
- Dados de logs
- Dados de timestamps
- Dados de transações
- Metadados
- Imagens de contêineres
- Dados de blobs (objetos binários grandes)
Todos esses tipos de dados são muito bem suportados nas modernas plataformas de armazenamento de dados, e existem várias plataformas baseadas em nuvem adaptadas para fornecer dados em cada um desses formatos específicos. Por exemplo, os dados de transações e metadados podem estar em um banco de dados moderno baseado em nuvem, como CockroachDB, YugaByte, etc. As imagens de contêineres ou os dados de blobs podem ser armazenados em um registro Docker baseado em MinIO. Os dados de timestamps podem ser armazenados em um banco de dados de séries temporais, como InfluxDB, etc. Não entraremos aqui nos detalhes de cada tipo de dado e das respectivas aplicações, mas a ideia geral é evitar o armazenamento persistente de dados baseado em montagem local de discos.
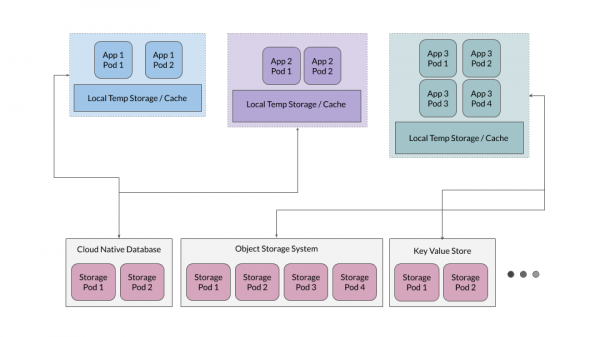
Além disso, muitas vezes, é eficaz fornecer um nível de cache temporário, servindo como um armazém de arquivos temporários para os aplicativos, mas os aplicativos não devem depender desse nível como fonte da verdade.
Armazenamento para aplicativos com estado
Embora, na maioria dos casos, seja útil manter os aplicativos sem estado, aqueles projetados para armazenar dados – como bancos de dados, armazenamento de objetos, armazenamento de chaves-valor – devem manter o estado. Vamos analisar por que esses aplicativos são implantados no Kubernetes. Como exemplo, tomaremos o MinIO, mas princípios semelhantes se aplicam a qualquer outro grande sistema de armazenamento de dados baseado em nuvem.
Aplicativos orientados para a nuvem são projetados para aproveitar ao máximo a flexibilidade característica dos contêineres. Isso significa que não se fazem suposições sobre o ambiente em que serão implantados. Por exemplo, o MinIO utiliza um mecanismo interno de codificação de exclusão, garantindo à sistema robustez suficiente para permanecer funcional mesmo diante da falha de metade dos discos. Além disso, o MinIO gerencia a integridade e segurança dos dados, utilizando sua própria técnica de hash e criptografia do lado do servidor.
Para tais aplicativos orientados para a nuvem, os volumes persistentes locais (PV) são a opção mais conveniente para armazenamento de backup. O PV local permite o armazenamento de dados brutos, enquanto os aplicativos que operam sobre esses PV coletam as informações necessárias para escalar os dados e gerenciar as crescentes demandas de dados.
Essa abordagem é muito mais simples e escala significativamente melhor em comparação com PVs baseados em CSI, que introduzem seus próprios níveis de gerenciamento de dados e redundância; o problema é que esses níveis geralmente entram em conflito com aplicativos projetados sob o princípio de manter o estado.
Um avanço firme para destacar dados de cálculos
Neste artigo, discutimos como os aplicativos estão se reorientando para operar sem manter estado, ou seja, o armazenamento de dados é separado dos cálculos sobre eles. Para concluir, veremos alguns exemplos reais dessa tendência.
, uma plataforma famosa de análise de dados, historicamente utilizada com manutenção de estado e implantação em um sistema de arquivos HDFS. Contudo, à medida que o Spark transita para um mundo orientado para a nuvem, essa plataforma está sendo cada vez mais utilizada sem manter estado, empregando o `s3a`. O Spark aplica o s3a para transmitir estado a outros sistemas, enquanto os próprios contêineres do Spark funcionam integralmente sem manter estado. Outros grandes players empresariais no campo da análise de grandes dados, em particular, , , também estão migrando para operar com a separação entre armazenamento de dados e cálculos.
Padrões semelhantes também podem ser observados em outras grandes plataformas de análise, como Presto, Tensorflow para R, Jupyter. Ao exportar o estado para sistemas de armazenamento em nuvem, a gestão do seu aplicativo e sua escalabilidade tornam-se muito mais simples. Além disso, isso aumenta a portabilidade do aplicativo em diversos ambientes.
Fonte: habr.com
