

Três anos atrás, Victor Tarnavsky e Alexey Milovidov da Yandex estavam no palco HighLoad++ , falando sobre como o ClickHouse é bom e como ele não é lento. E no palco ao lado estava Alexander Zaitsev com falando sobre a migração para ClickHouse de outro SGBD analítico e com a conclusão de que ClickHouse, claro, é bom, mas não muito conveniente. Quando, em 2016, a empresa LifeStreet, onde Alexander trabalhava na época, estava migrando um sistema analítico de múltiplos petabytes para ClickHouse, essa foi uma emocionante "estrada de tijolos amarelos", cheia de perigos desconhecidos — ClickHouse naquela época, parecia um campo minado.
Três anos depois ClickHouse , melhorou bastante — nesse tempo, Alexander fundou a Altinity, que não apenas ajuda a migrar para ClickHouse dezenas de projetos, mas também aprimora o próprio produto junto com os colegas da Yandex. Agora ClickHouse ainda não é um passeio despreocupado, mas já não é um campo minado.
Alexander trabalha com sistemas distribuídos desde 2003, desenvolvendo grandes projetos em MySQL, Oracle e Vertica. Na passada HighLoad++ 2019 , Alexander, um dos pioneiros do uso do ClickHouse, falou sobre o que essa SGBD representa hoje. Vamos conhecer as principais características ClickHouse: como ela se diferencia de outros sistemas e em quais casos é mais eficaz utilizá-la. Vamos discutir práticas recentes e comprovadas na construção de sistemas em ClickHouse.
Retrospectiva: o que aconteceu há 3 anos
Três anos atrás, estávamos migrando a empresa LifeStreet para ClickHouse de outro banco de dados analítico, e a migração da análise da rede de anúncios parecia assim:
- Junho de 2016. No OpenSource apareceu ClickHouse e iniciou nosso projeto;
- Agosto. Prova de Conceito: uma grande rede de anúncios, infraestrutura e 200-300 terabytes de dados;
- Outubro. Primeiros dados de produção;
- Dezembro. Carga total do produto — 10-50 bilhões de eventos por dia.
- Junho de 2017. Migração bem-sucedida dos usuários para ClickHouse, 2,5 petabytes de dados em um cluster de 60 servidores.
Durante o processo de migração, cresceu a compreensão de que ClickHouse é um bom sistema, com o qual é bom trabalhar, mas é um projeto interno da Yandex. Portanto, há nuances: primeiro a Yandex se concentrará em seus próprios clientes internos e só depois na comunidade e nas necessidades de usuários externos, e o ClickHouse não atendia na época ao nível enterprise em muitas áreas funcionais. Por isso, em março de 2017, fundamos a empresa Altinity, para fazer ClickHouse ainda mais rápido e conveniente, não apenas para o Yandex, mas também para outros usuários. E agora nós:
- Treinamos e ajudamos a construir soluções em ClickHouse para que os clientes não tenham problemas, e para que a solução no final funcione;
- Oferecemos suporte 24/7 ClickHouse-instalações;
- Desenvolvemos nossos próprios projetos de ecossistema;
- Ativamente contribuímos para o ClickHouse, respondendo aos pedidos dos usuários que desejam ver certas funcionalidades.
E claro, ajudamos na migração para ClickHouse com MySQL, Vertica, Oracle, Greenplum, Redshift e outros sistemas. Participamos de diversas migrações, e todas foram bem-sucedidas.
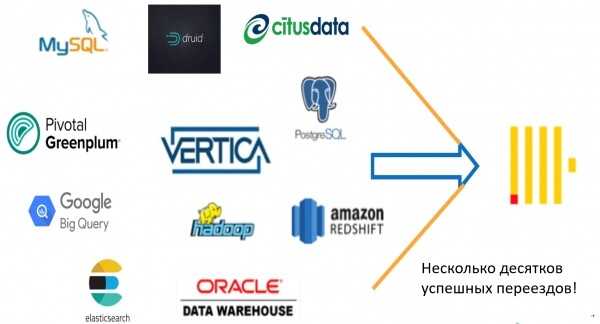
Por que migrar para ClickHouse
Não desacelera! Esta é a principal razão. ClickHouse — um banco de dados muito rápido para diferentes cenários:
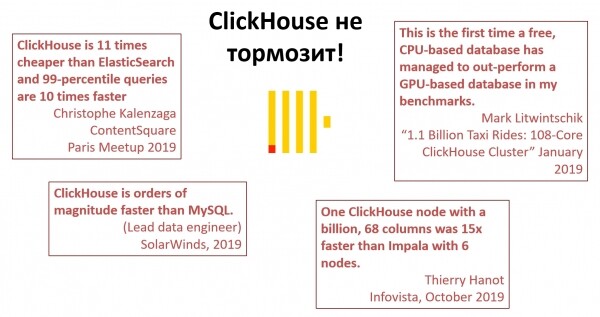
Citações aleatórias de pessoas que trabalham há muito tempo com ClickHouse.
Escalabilidade. Em algum outro DB, é possível alcançar um desempenho decente em um único hardware, mas ClickHouse pode ser escalado não apenas verticalmente, mas também horizontalmente, simplesmente adicionando servidores. Tudo funciona não tão suave quanto gostaríamos, mas funciona. É possível escalar o sistema junto com o crescimento do negócio. Isso é importante, pois não estamos limitados à solução atual e sempre há potencial para crescimento.
Portabilidade. Sem amarração a algo específico. Por exemplo, com Amazon Redshift é difícil migrar para outro lugar. Mas ClickHouse pode ser instalado em um laptop, servidor, implantar na nuvem, ir para Kubernetes — sem restrições no uso da infraestrutura. Isso é conveniente para todos, e é uma grande vantagem que muitas outras bases de dados semelhantes não podem ostentar.
Flexibilidade. ClickHouse não se fixa em algo específico, como o Yandex.Metrica, mas evolui e é utilizado em um número cada vez maior de projetos e indústrias. Pode ser expandido, adicionando novas funcionalidades para resolver novas tarefas. Por exemplo, é considerado ultrapassado armazenar logs em um DB, então para isso foi criado Elasticsearch. Mas, graças à flexibilidade ClickHouse, logs também podem ser armazenados nele, e muitas vezes isso é até melhor do que em Elasticsearch — em ClickHouse isso requer 10 vezes menos hardware.
Gratuito Open Source. Não é necessário pagar por nada. Não é necessário negociar permissão para instalar o sistema em seu laptop ou servidor. Não há taxas ocultas. Além disso, nenhuma outra tecnologia de banco de dados Open Source pode competir em velocidade com ClickHouse. MySQL, MariaDB, Greenplum — todos eles são muito mais lentos.
Comunidade, impulso e função. No ClickHouse uma excelente comunidade: meetups, chats e Alexey Milovidov, que nos contagia com sua energia e otimismo.
Mudança para ClickHouse
Para migrar para ClickHouse a partir de algo, você precisa de apenas três coisas:
- Compreender as limitações ClickHouse e para que ele não é adequado.
- Usar os benefícios da tecnologia e seus pontos fortes.
- Experimentar. Mesmo entendendo como funciona ClickHouse, nem sempre é possível prever quando será mais rápido, quando mais devagar, quando melhor e quando pior. Portanto, experimente.
O problema da migração
Há apenas um 'mas': se você está migrando de ClickHouse algo diferente, geralmente algo dá errado. Estamos acostumados a algumas práticas e coisas que funcionam em nosso banco de dados favorito. Por exemplo, qualquer pessoa que trabalhe com bancos de dados SQLconsidera essencial um conjunto de funções:
- transações;
- restrições;
- consistência;
- índices;
- UPDATE/DELETE;;
- NULLs;;
- milissegundos;
- conversões automáticas de tipo;
- junções múltiplas;
- partições arbitrárias;
- ferramentas de gerenciamento de cluster.
O conjunto é obrigatório, mas há três anos em ClickHouse não havia nenhuma dessas funções! Agora, menos da metade do que não foi implementado ainda permanece: transações, restrições, consistência, milissegundos e conversões de tipo.
E o mais importante — algumas práticas e abordagens padrão em ClickHouse não funcionam ou funcionam de maneira diferente do que estamos acostumados. Tudo o que aparece em ClickHouse, segue a 'maneira ClickHouse', ou seja, as funções diferem de outros bancos de dados. Por exemplo:
- Os índices não selecionam, mas pulam.
- UPDATE/DELETE; não são síncronos, mas assíncronos.
- Existem junções múltiplas, mas não há planejador de consultas. Como elas são executadas, não é muito claro para as pessoas do mundo dos bancos de dados.
Cenários ClickHouse
Em 1960, o matemático americano de origem húngara Wigner E. P. escreveu um artigo 'A eficácia incompreensível da matemática nas ciências naturais' sobre como o mundo ao nosso redor é bem descrito por leis matemáticas. A matemática é uma ciência abstrata, e as leis físicas expressas em forma matemática não são triviais, e Wigner E. P. ressaltou que isso é muito estranho.
Na minha opinião, ClickHouse é uma estranheza semelhante. Parafraseando Wigner, pode-se dizer assim: é surpreendente a eficácia incompreensível ClickHouse em uma variedade de aplicações analíticas!
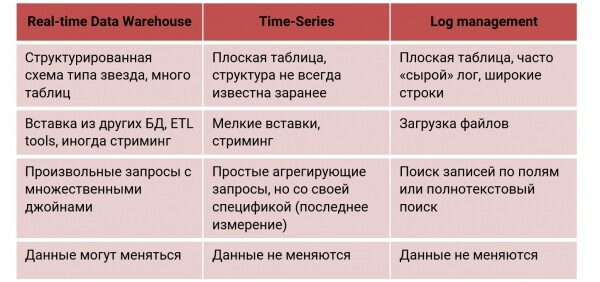
Por exemplo, vamos pegar um Armazém de Dados em Tempo Real, onde os dados são carregados praticamente de forma contínua. Queremos receber solicitações com um atraso de um segundo. Por favor — usamos ClickHouse, pois foi para este cenário que ele foi desenvolvido. ClickHouse exatamente assim utilizado não apenas na web, mas também na análise de marketing e financeira, AdTech, assim como em Detecção de Fraudes. No Data Warehouse em Tempo Real é utilizada uma complexa estrutura do tipo 'estrela' ou 'floco de neve', com muitas tabelas contendo JOIN (às vezes múltiplas), e os dados geralmente são armazenados e modificados em alguns sistemas.
Vamos considerar outro cenário — Série Temporal: monitoramento de dispositivos, redes, estatísticas de uso, Internet das Coisas. Aqui encontramos eventos bastante simples ordenados por tempo. ClickHouse não foi inicialmente desenvolvido para isso, mas apresentou um bom desempenho, então grandes empresas o utilizam ClickHouse como um repositório para informações de monitoramento. Para investigar se ClickHouse para séries temporais, fizemos um benchmark com base na abordagem e nos resultados InfluxDB e TimescaleDB — bancos de dados especializados em séries temporais. , que , mesmo sem otimização para essas tarefas, tem sucesso em outra área: ClickHousegeralmente é utilizada uma tabela estreita — algumas colunas pequenas. Do monitoramento podem vir muitos dados — milhões de registros por segundo — e geralmente são inseridos em pequenas partes (
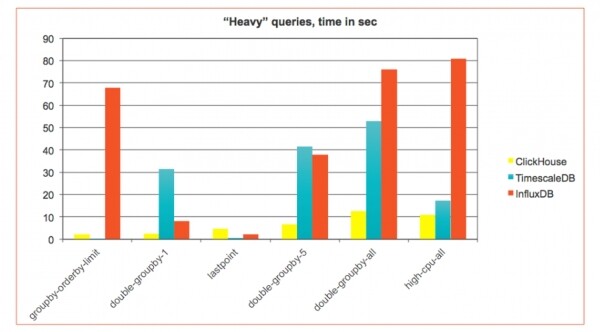
Em em séries temporais. em tempo realstreaming). Portanto, é necessário um cenário de inserção diferente, e as próprias consultas têm suas particularidades. Gerenciamento de Logs
. Coletar logs em um banco de dados geralmente é ruim, mas emisso pode ser feito com alguns comentários, como descrito acima. Muitas empresas utilizam ClickHouse exatamente para isso. Nesse caso, uma tabela larga e plana é usada, onde armazenamos os logs inteiros (por exemplo, na forma de ClickHouse ), ou cortamos em partes. Os dados são normalmente carregados em grandes lotes (arquivos), e buscamos por algum campo. JSONPara cada uma dessas funções, geralmente são utilizados bancos de dados especializados.
um pode realizar tudo isso tão bem que supera os outros em desempenho. Vamos agora examinar detalhadamente ClickHouse o cenário e como preparar corretamente em séries temporais. para este cenário. ClickHouse Série Temporal
No momento, este é o principal cenário para o qual
é considerado uma solução padrão. ClickHouse Séries temporais Série temporal — é um conjunto de eventos organizados cronologicamente que representam as mudanças de algum processo ao longo do tempo. Por exemplo, isso pode ser a frequência cardíaca ao longo do dia ou a quantidade de processos em um sistema. Tudo que fornece tique-taques temporais com algumas medições é em séries temporais.:
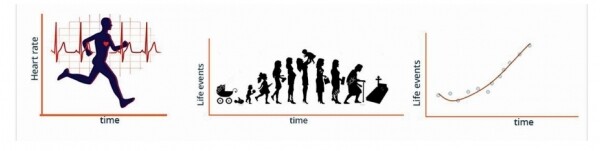
A maior parte desse tipo de eventos vem da monitorização. Isso pode incluir não apenas a monitoração da web, mas também de dispositivos reais: automóveis, sistemas industriais, IoT, fábricas ou táxis autônomos, nos quais a Yandex já está colocando ClickHouse-servidor.
Por exemplo, existem empresas que coletam dados de navios. A cada poucos segundos, sensores de um porta-contêiner enviam centenas de medições diferentes. Engenheiros estudam esses dados, constroem modelos e tentam entender o quão eficazmente um navio está sendo utilizado, pois o porta-contêiner não deve ficar parado nem por um segundo. Qualquer parada resulta em perda de dinheiro, então é importante prever a rota de modo que as paradas sejam mínimas.
Atualmente, observa-se um aumento no número de bancos de dados especializados que medem em séries temporais.. No site DB-Engines são de alguma forma classificados diferentes bancos de dados, e podem ser visualizados por tipos:
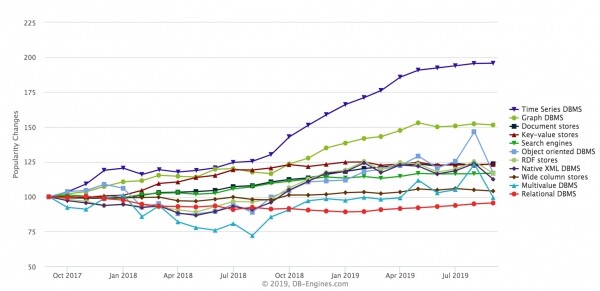
O tipo que mais cresce é o time-seriess. Os bancos de dados de grafos também estão crescendo, mas time-seriess crescem mais rapidamente nos últimos anos. Representantes típicos desse tipo de banco de dados são InfluxDB, Prometheus, KDB, TimescaleDB (construído sobre PostgreSQL), soluções da Amazon. ClickHouse também podem ser utilizados aqui, e são usados. Vou citar alguns exemplos públicos.
Um dos pioneiros é a empresa CloudFlare (provedor de CDN). Eles monitoram seu-requisições, provedor de CDN). Eles monitoram seu via ClickHouse (DNS-requisições) com uma carga enorme — 6 milhões de eventos por segundo. Tudo passa por HTTP, é enviado para Kafka, que proporciona a capacidade de ver dashboards de eventos no sistema em tempo real. ClickHouseComcast
— um dos líderes em telecomunicações nos EUA: internet, TV digital, telefonia. Eles criaram um sistema de gerenciamento semelhante no âmbito do provedor de CDN). Eles monitoram seu projeto Open Source Apache Traffic Control para trabalhar com seus enormes dados. é utilizado como backend para analítica. ClickHouse Percona
incorporou dentro de seu ClickHouse PMM , para armazenar a monitoração de diferentesExistem requisitos específicos MySQL.
Os bancos de dados time-series têm suas exigências específicas.
Inserção rápida de muitos agentes
- . Precisamos inserir rapidamente dados de muitos fluxos.faz isso bem, porque todas as suas inserções não bloqueiam. Qualquer ClickHouse faz isso bem, porque todas as suas inserções não bloqueiam. Qualquer inserir — é um novo arquivo no disco, e pequenas inserções podem ser bufferizadas de uma forma ou de outra. No ClickHouse é melhor inserir dados em grandes pacotes, em vez de uma linha de cada vez.
- Esquema flexível. No em séries temporais. geralmente não sabemos a estrutura dos dados por completo. Pode-se construir um sistema de monitoramento para um aplicativo específico, mas então é difícil utilizá-lo para outro aplicativo. Para isso, é preciso um esquema mais flexível. ClickHouse, permite fazer isso, mesmo que seja um banco de dados estritamente tipado.
- Armazenamento eficiente e 'esquecimento' de dados. Normalmente, em em séries temporais. um volume gigante de dados, por isso é preciso armazená-los da forma mais eficiente possível. Por exemplo, um InfluxDB boa compressão — essa é sua principal característica. Mas além do armazenamento, também é necessário saber 'esquecer' dados antigos e fazer algum tipo de downsampling — contagem automática de agregados.
- Consultas rápidas de dados agregados. Às vezes, é interessante ver os últimos 5 minutos com precisão de milissegundos, mas em dados mensais a granularidade de minutos ou segundos pode não ser necessária — basta a estatística geral. O suporte a esse tipo é necessário, caso contrário, uma consulta de 3 meses será executada muito lentamente mesmo em ClickHouse.
- Consultas do tipo 'último ponto, até». Estas são típicas para em séries temporais. consultas: observamos a última medição ou o estado do sistema em um momento t. Para bancos de dados, essas não são consultas muito agradáveis, mas também precisam ser executadas.
- 'Colagem' de séries temporais. Série temporal — é uma série temporal. Se houver duas séries temporais, muitas vezes é necessário conectá-las e correlacioná-las. Nem todos os bancos de dados permitem fazer isso de forma conveniente, especialmente com séries temporais desalinhadas: aqui — um conjunto de marcas de tempo, lá — outro. Pode-se calcular médias, mas e se mesmo assim houver uma lacuna, então não está claro.
Vamos ver como esses requisitos são atendidos em ClickHouse.
Esquema
Em ClickHouse um esquema para em séries temporais. pode ser feito de diversas maneiras, dependendo do grau de regularidade dos dados. Pode-se construir um sistema com dados regulares, quando sabemos todas as métricas antecipadamente. Por exemplo, assim fez CloudFlare com monitoramento provedor de CDN). Eles monitoram seu — é um sistema bem otimizado. Pode-se construir um sistema mais geral, que monitore toda a infraestrutura, diferentes serviços. No caso de dados irregulares, não sabemos antecipadamente o que estamos monitorando — e, provavelmente, este é o caso mais geral.
Dados regulares. Colunas. O esquema é simples – colunas com os tipos necessários:
CRIE A TABELA cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* junção com dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Esta é uma tabela comum que monitora alguma atividade de carga do sistema (user, system, ocioso, nice). Simples e conveniente, mas não flexível. Se quisermos um esquema mais flexível, podemos usar arrays.
Dados irregulares. Arrays:
CRIE A TABELA cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECIONE max(metrics.value[indexOf(metrics.name,'usage_user')]) DE ...
Estrutura Aninhado — são dois arrays: metrics.name e metrics.value. Aqui podemos armazenar dados de monitoramento arbitrários, como um array de nomes e um array de medições a cada evento. Para uma otimização adicional, em vez de uma estrutura assim, podemos fazer várias. Por exemplo, uma — para float-valor, outra — para int-valor, porque int queremos armazenar de forma mais eficiente.
Mas com essa estrutura é mais difícil acessar. Teremos que usar uma construção especial, usando funções específicas para extrair os valores primeiro do índice e depois do array:
SELECIONE max(metrics.value[indexOf(metrics.name,'usage_user')]) DE ...Mas isso ainda funciona bastante rápido. Outra forma de armazenamento de dados irregulares – por linhas.
Dados irregulares. Linhas. Neste método tradicional, sem arrays, os nomes e valores são armazenados juntos. Se um dispositivo envia 5.000 medições de uma vez — 5.000 linhas são geradas no BD:
CRIE A TABELA cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECIONE
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
DE cpu_r
ONDE metric_name IN ('usage_user', ...)
ClickHouse isso é resolvido — ele tem extensões especiais ClickHouse SQL. Por exemplo, maxIf — é uma função especial que calcula o máximo de uma métrica quando alguma condição é atendida. É possível escrever várias dessas expressões em uma única consulta e calcular automaticamente o valor para várias métricas.
Compararemos três abordagens:
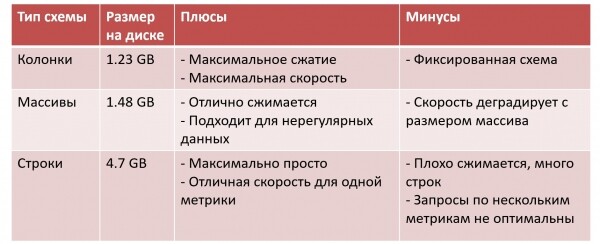
Aqui adicionei "Tamanho dos dados no disco" para um determinado conjunto de dados de teste. No caso das colunas, temos o menor tamanho de dados: compactação máxima, velocidade máxima das consultas, mas pagamos por isso, pois devemos fixar tudo de uma vez.
No caso dos arrays, a situação é um pouco pior. Os dados ainda são bem compactáveis e é possível armazenar um esquema irregular. Mas ClickHouse — um banco de dados de colunas, e quando começamos a armazenar tudo em um array, ele se torna uma string, e pagamos pela flexibilidade com eficiência. Para cada operação, será necessário ler todo o array na memória, e após isso encontrar o elemento necessário — e se o array cresce, a velocidade degrada.
Em uma das empresas que usa essa abordagem (por exemplo, ), os arrays são cortados em pedaços de 128 elementos. Os dados de milhares de métricas com um volume de 200 TB de dados/dia não são armazenados em um único array, mas em 10 ou 30 arrays com uma lógica especial de armazenamento.
A abordagem mais simples é com strings. Mas os dados não são bem compactáveis, o tamanho da tabela fica grande, e quando as consultas ocorrem em várias métricas, o ClickHouse não opera de forma otimizada.
Esquema híbrido
Suponha que escolhemos um esquema com array. Mas se sabemos que a maioria dos nossos dashboards mostra apenas as métricas user e system, podemos materializar essas métricas em colunas a nível de tabela da seguinte forma:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Ao inserir ClickHouse ele irá automaticamente calcular. Assim, podemos combinar o útil ao agradável: o esquema é flexível e geral, mas as colunas que são mais frequentemente usadas foram extraídas. Vale notar que isso não exigiu mudar a inserção e ETL, que continua a inserir arrays na tabela. Nós simplesmente fizemos ALTER TABLE, adicionamos algumas colunas e resultou em um esquema híbrido e mais rápido, que pode ser utilizado imediatamente.
Codecs e compressão
Para em séries temporais. é importante quão bem você compacta os dados, pois o volume de informação pode ser muito grande. No ClickHouse existe um conjunto de ferramentas para alcançar um efeito de compressão de 1:10, 1:20, e às vezes mais. Isso significa que dados não compactados com um volume de 1 TB no disco ocupam de 50 a 100 GB. Um tamanho menor é bom, os dados podem ser lidos e processados mais rapidamente.
Para alcançar um alto nível de compressão, ClickHouse suporta os seguintes codecs:
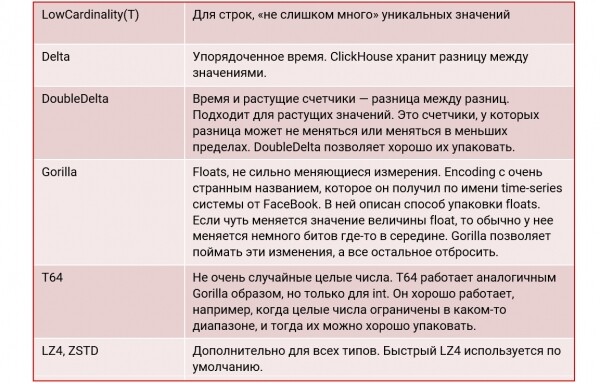
Exemplo de tabela:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Aqui definimos o codec DoubleDelta em um caso, e no outro — Gorilla, e adicionamos obrigatoriamente mais LZ4 compressão. Como resultado, o tamanho dos dados no disco é significativamente reduzido:
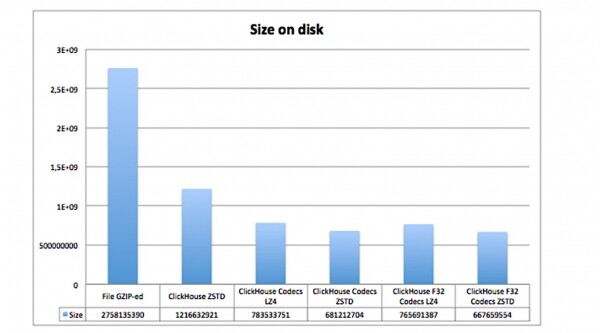
Aqui está mostrado quanto espaço ocupam os mesmos dados, mas usando diferentes codecs e compressões:
- em um arquivo compactado com GZIP no disco;
- no ClickHouse sem codecs, mas com compressão ZSTD;
- no ClickHouse com codecs e compressão LZ4 e ZSTD.
É evidente que as tabelas com codecs ocupam muito menos espaço.
Tamanho importa
Não menos importante é o tipo de dado correto:
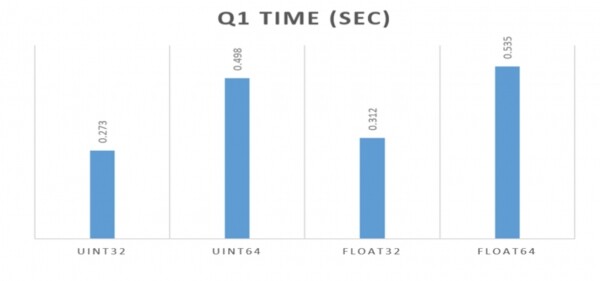
Em todos os exemplos acima, eu usei Float64. Mas se tivéssemos escolhido Float32, isso seria até melhor. Isso foi bem demonstrado pelo pessoal da Percona no artigo do link acima. É importante usar o tipo mais compacto possível, adequado à tarefa: isso é ainda mais relevante para a velocidade das consultas do que para o tamanho no disco. ClickHouse é muito sensível a isso.
Se você puder usar int32 em vez de int64, então espere um aumento quase dobrado no desempenho. Os dados ocupam menos memória, e toda a "aritmética" funciona muito mais rápido. ClickHouse dentro de si — é um sistema altamente tipificado, que aproveita ao máximo todas as capacidades que os sistemas modernos oferecem.
Agregação e Visões Materializadas
A agregação e as visões materializadas permitem a criação de agregados para diferentes situações:
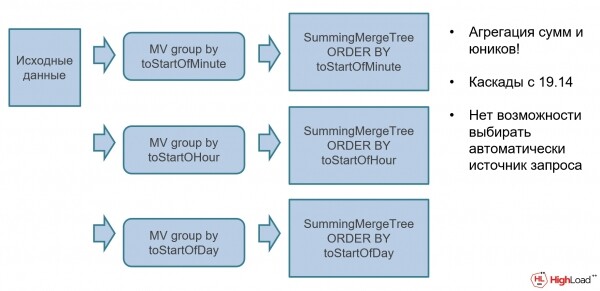
Por exemplo, você pode ter dados brutos não agregados, e a eles podem ser associadas diferentes visões materializadas com somas automáticas através de um mecanismo especial SummingMergeTree (SMT). SMT — é uma estrutura de dados agregadora especial que calcula automaticamente os agregados. Dados brutos são inseridos no banco de dados, são agregados automaticamente e os dashboards podem ser usados imediatamente.
TTL — «esquecemos» dados antigos
Como «esquecer» dados que não são mais necessários? ClickHouse consegue isso. Ao criar tabelas, pode-se especificar TTL expressões: por exemplo, que dados a cada minuto são armazenados por um dia, diários por 30 dias, enquanto dados semanais ou mensais nunca são tocados:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* no TTL */
Multi-tier — dividimos dados entre os discos
Desenvolvendo essa ideia, dados podem ser armazenados em ClickHouse lugares diferentes. Suponha que queremos armazenar dados quentes da última semana em um local muito rápido SSD, enquanto dados históricos são armazenados em outro lugar. Atualmente em ClickHouse isso é possível:
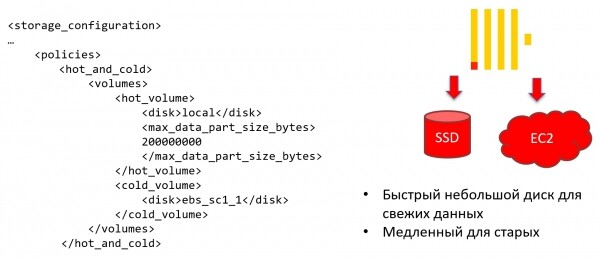
É possível configurar a política de armazenamento (storage policy) de forma que ClickHouse automaticamente transfira dados para outro armazenamento ao atingir certas condições.
Mas isso não é tudo. No nível de uma tabela específica, pode-se definir regras para saber quando exatamente, em termos de tempo, os dados passam para o armazenamento frio. Por exemplo, dados ficam em um disco muito rápido por 7 dias, enquanto tudo que é mais antigo é transferido para um disco lento. Isso é bom porque mantém o sistema com desempenho máximo, controlando gastos e evitando despesas com dados frios:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Oportunidades únicas ClickHouse
Quase tudo em ClickHouse possui essas «peculiaridades», mas elas são compensadas pela exclusividade — aquilo que não há em outros bancos de dados. Por exemplo, aqui estão algumas das funções únicas ClickHouse:
- Arrays. No ClickHouse que possuem um suporte muito bom para arrays, além da possibilidade de realizar cálculos complexos sobre eles.
- Estruturas de dados agregadas. Esta é uma das «killer features» ClickHouse. Apesar de que os pessoal do Yandex diga que não queremos agregar dados, todos agregam em ClickHouse, pois isso é rápido e conveniente.
- Visões materializadas. Juntamente com estruturas de dados agregadas, visões materializadas permitem uma conveniente streaming). Portanto, é necessário um cenário de inserção diferente, e as próprias consultas têm suas particularidades. agregação.
- ClickHouse SQL. Esta é uma extensão da linguagem SQL com algumas funcionalidades adicionais e exclusivas que estão disponíveis apenas em ClickHouse. Era anteriormente um tanto uma extensão, mas por outro lado — uma desvantagem. Agora praticamente todas as desvantagens em comparação com SQL 92 fomos eliminadas, agora é apenas uma extensão.
- Lambda– expressões. Elas ainda existem em algum outro banco de dados?
- ML- suporte. Isso existe em vários bancos de dados, em alguns é melhor, em outros é pior.
- Código aberto. Podemos expandir ClickHouse juntos. Atualmente, há cerca de 500 colaboradores, e esse número continua a crescer. ClickHouse Consultas complexas
existem muitas maneiras diferentes de fazer a mesma coisa. Por exemplo, existem três maneiras diferentes de retornar o último valor de uma tabela para
Em ClickHouse (há também uma quarta, mas é ainda mais exótica). CPU A primeira mostra como é conveniente fazer em
consultas, quando você deseja verificar se ClickHouse tupla está contida em uma subconsulta. Isso é algo que pessoalmente senti muito falta em outros bancos de dados. Se eu quiser comparar algo com uma subconsulta, em outros bancos de dados só posso comparar um escalar, e para várias colunas é necessário escrever pode-se usar tupla: JOIN. No ClickHouse SELECT * FROM cpu WHERE (tags_id, created_at) IN (SELECT tags_id, max(created_at) FROM cpu GROUP BY tags_id)
A segunda maneira faz a mesma coisa, mas usa a função agregadaargMax SELECT argMax(usage_user), created_at), argMax(usage_system), created_at), ... FROM cpu:
existem várias dezenas de funções agregadas, e se você usar combinadores, de acordo com as leis da combinatória, haverá cerca de mil. Em ClickHouse ArgMax — uma das funções que calcula o valor máximo: a consulta retorna o valor usage_user , no qual atinge o valor máximocreated_at SELECT now() as created_at, cpu.* FROM (SELECT DISTINCT tags_id from cpu) base ASOF LEFT JOIN cpu USING (tags_id, created_at):
ASOF JOIN
— ‘junção’ de linhas com diferentes tempos. Essa é uma função única para bancos de dados, que só existe também em kdb+ . Se houver duas séries temporais com horários diferentes,permite deslocá-las e colá-las em uma única consulta. Para cada valor em uma série temporal, encontra-se o valor mais próximo em outra, e eles são retornados em uma única linha: — ‘junção’ de linhas com diferentes tempos. Funções analíticas
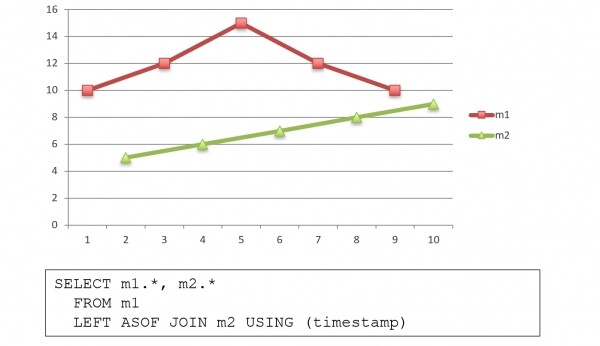
No padrão
SQL-2003 pode-se escrever assim: SELECT origin, timestamp, timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration, timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration, ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence, COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb FROM mytable ORDER BY origin, timestamp;
não é possível — ele não suporta o padrão
Em ClickHouse e, provavelmente, nunca fará isso. Em vez disso, no pode-se escrever assim: e, provavelmente, nunca fará isso. Em vez disso, ClickHouse é comum escrever assim:
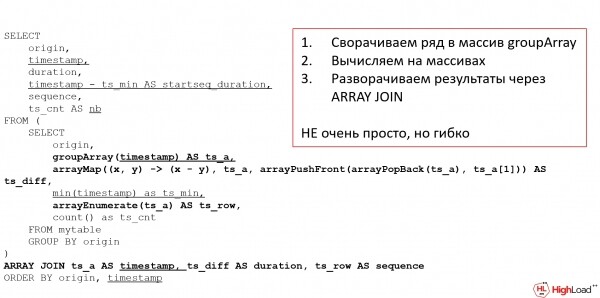
Eu prometi lambdas – aqui estão elas!
Isso é análogo a uma consulta analítica no padrão pode-se escrever assim:: ele calcula a diferença entre dois timestamp, duração, número de sequência – tudo o que geralmente consideramos funções analíticas. Em ClickHouse nós as consideramos através de arrays: primeiro agregamos os dados em um array, depois fazemos o que queremos no array, e então desagregamos. Isso não é muito conveniente, requer uma certa afeição à programação funcional, no mínimo, mas é muito flexível.
Funções especiais
Além disso, em ClickHouse há muitas funções especializadas. Por exemplo, como determinar quantas sessões ocorrem simultaneamente? Uma tarefa típica de monitoramento – determinar a carga máxima com uma única consulta. Em ClickHouse existe uma função especial para esse fim:
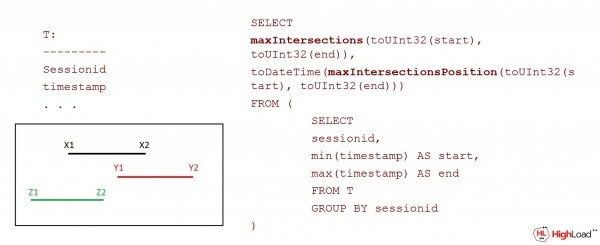
De modo geral, para muitas finalidades, o ClickHouse possui funções especiais:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Esta não é uma lista completa de funções, existem entre 500 e 600 ao todo. Dica: todas as funções em ClickHouse estão na tabela de sistema (nem todas são documentadas, mas todas são interessantes):
select * from system.functions order by nameClickHouse o próprio contém muitas informações sobre si mesmo, incluindo tabelas de log, query_log, log de rastreamento, log de operações com blocos de dados (part_log), log de métricas, e um log de sistema, que normalmente ele escreve no disco. O log de métricas – é em séries temporais. em ClickHouse na verdade, ClickHouse: O DB pode servir para si mesmo como em séries temporais. bancos de dados, “devorando” a si próprio.
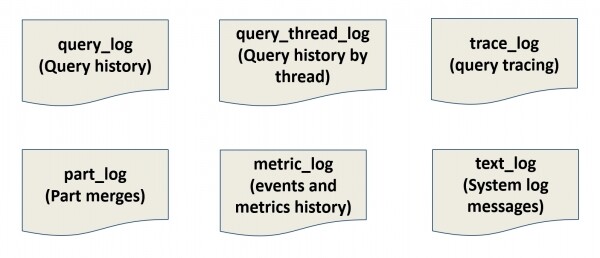
Isso também é uma coisa única – já que fazemos bem o trabalho para em séries temporais., por que não podemos armazenar tudo o que precisamos dentro de nós mesmos? Não precisamos de Prometheus, armazenamos tudo em nós. Conectamos Grafana e monitoramos a nós mesmos. No entanto, se ClickHouse falhar, não saberemos por quê – por isso geralmente não se faz assim.
Um grande cluster ou muitos pequenos ClickHouse
O que é melhor – um grande cluster ou muitos pequenos ClickHouse? A abordagem tradicional para DWH é um grande cluster, onde esquemas são dedicados a cada aplicação. Chegamos ao administrador de banco de dados – nos dê um esquema, e ele nos forneceu:
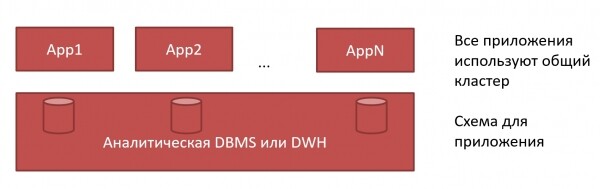
Em ClickHouse pode-se fazer isso de outra forma. Podemos dar a cada aplicação seu próprio ClickHouse:
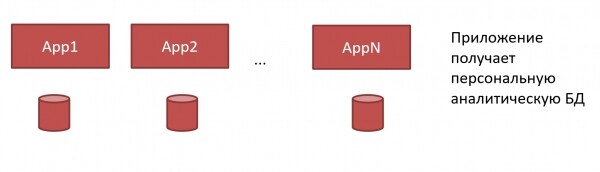
Não precisamos mais de um grande monstro DWH e administradores inflexíveis. Podemos fornecer a cada aplicação seu próprio ClickHouse, e o desenvolvedor pode fazer isso sozinho, já que ClickHouse é muito fácil de instalar e não requer administração complexa:
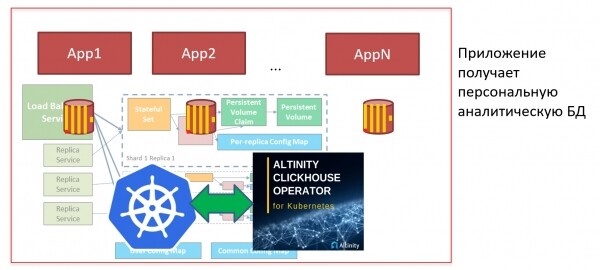
Mas se tivermos muitos ClickHouse, e é necessário instalá-lo com frequência, gostaríamos de automatizar esse processo. Para isso, podemos, por exemplo, usar Kubernetes e clickhouse-operador. No Kubernetes ClickHouse pode ser instalado "com um clique": posso pressionar o botão, iniciar o manifesto e o banco de dados está pronto. Posso imediatamente criar o esquema, começar a carregar as métricas e, em 5 minutos, já terei meu dashboard pronto Grafana. É tão simples!
Qual é o resultado?
Então, ClickHouse – é:
- Rápido. Todos já sabem disso.
- Simples. Um pouco controverso, mas eu acredito que é difícil no aprendizado, fácil na luta. Se você entender como ClickHouse funciona, então tudo é muito fácil.
- Universal. Ele é adequado para diferentes cenários: DWH, Time Series, Log Storage. Mas isso não é um banco de dados OLTP, então não tente fazer inserções e leituras curtas lá. Interessante
- . Provavelmente, quem trabalha com, teve muitos momentos interessantes, tanto bons quanto ruins. Por exemplo, uma nova versão foi lançada e tudo parou de funcionar. Ou quando você ficou dois dias lidando com um problema, mas, após uma pergunta no chat do Telegram, o problema foi resolvido em dois minutos. Ou como na conferência, na apresentação de Alexey Milovidov, um screenshot de ClickHousequebrou a transmissão ClickHouse . Esse tipo de coisa acontece constantemente e torna nossa vida com HighLoad++viva e interessante! ClickHouse A apresentação pode ser assistida
A tão esperada reunião de desenvolvedores de sistemas de alta carga em .
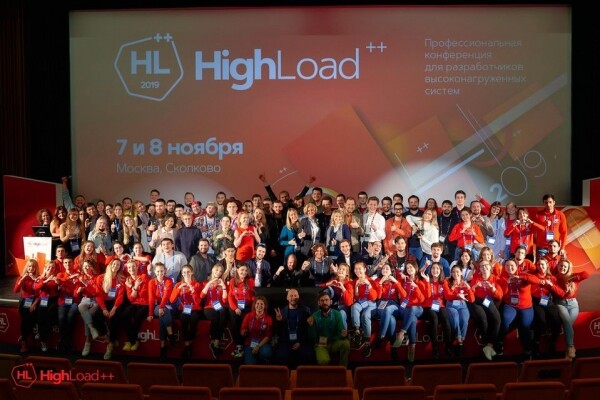
acontecerá nos dias 9 e 10 de novembro em Skolkovo. Finalmente teremos uma conferência presencial (mesmo com o cumprimento de todas as medidas de precaução), uma vez que a energia do HighLoad++ não pode ser embalada online. Para a conferência, encontramos e mostramos casos sobre as possibilidades máximas das tecnologias: HighLoad++ foi, é e será o único lugar onde em dois dias você pode descobrir como funcionam Facebook, Yandex, Vkontakte, Google e Amazon.
Realizando nossas reuniões ininterruptas desde 2007, este ano nos encontraremos pela 14ª vez. Durante esse tempo, a conferência cresceu 10 vezes, no ano passado o evento principal do setor reuniu 3339 participantes, 165 palestrantes e meetups, e 16 trilhas estavam ocorrendo simultaneamente.
No ano passado, tivemos 20 ônibus, 5280 litros de chá e café, 1650 litros de sucos e 10200 garrafinhas de água. Além disso, 2640 quilos de comida, 16.000 pratos e 25.000 copos. A propósito, com o dinheiro arrecadado da papel reciclado, plantamos 100 mudas de carvalho 🙂
Os ingressos podem ser comprados, e para receber notícias sobre a conferência — , receber novidades sobre a conferência — , e para conversar — em todas as redes sociais: , , e .
Fonte: habr.com
