

Neste artigo, vou falar sobre como o projeto em que trabalho se transformou de um grande monolito em um conjunto de microsserviços.
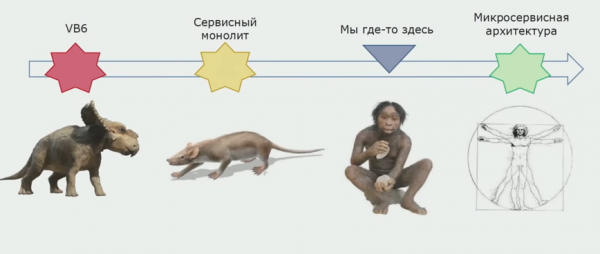
O projeto começou sua história há bastante tempo, no início dos anos 2000. As primeiras versões foram escritas em Visual Basic 6. Com o passar do tempo, ficou claro que desenvolver nesse idioma seria difícil de manter, pois a IDE e a própria linguagem evoluíam lentamente. No final dos anos 2000, decidimos migrar para o C# mais promissor. A nova versão foi desenvolvida paralelamente à melhoria da antiga, e gradualmente, mais código foi escrito em .NET. O backend em C# inicialmente tinha foco em uma arquitetura de serviços, no entanto, usávamos bibliotecas comuns com lógica e os serviços eram executados em um único processo. O resultado foi um aplicativo que chamamos de 'monolito de serviços'.
Uma das poucas vantagens dessa combinação era a capacidade de os serviços chamarem uns aos outros através de uma API externa. Havia claras premissas para a transição para uma arquitetura de serviços mais adequada e, no futuro, para uma arquitetura de microsserviços.
Começamos nosso trabalho de decomposição por volta de 2015. Embora ainda não tenhamos alcançado o estado ideal — ainda existem partes do grande projeto que já são difíceis de chamar de monolitos, mas também não se parecem com microsserviços. No entanto, o progresso é significativo.
Sobre isso, falarei no artigo.
Conteúdo
Arquitetura e Problemas da Solução Existente
Originalmente, a arquitetura parecia a seguinte: UI — aplicação separada, a parte monolítica escrita em Visual Basic 6, e a aplicação em .NET era um conjunto de serviços relacionados, trabalhando com um banco de dados bastante grande.
Desvantagens da Solução Anterior
Ponto Único de Falha
Tínhamos um único ponto de falha: o aplicativo .NET era executado em um único processo. Se algum dos módulos falhasse, todo o aplicativo parava e precisava ser reiniciado. Como automatizamos um grande número de processos para diferentes usuários, devido a uma falha em um deles, todos ficavam impossibilitados de trabalhar por algum tempo. E em caso de erro de programação, a redundância não ajudava.
Fila de melhorias
Essa deficiência é mais organizacional. Nosso aplicativo possui muitos clientes, todos querendo implementar melhorias o mais rápido possível. Anteriormente, isso era impossível de ser feito em paralelo, e todos os clientes ficavam na fila. Esse processo gerava insatisfação nos negócios, que precisavam provar que sua demanda tinha valor. E a equipe de desenvolvimento perdia tempo para organizar essa fila. Isso consumia muito tempo e esforço, e o produto, no final, não conseguia se adaptar tão rapidamente quanto esperado.
Uso não otimizado de recursos
Ao hospedar serviços em um único processo, sempre copiávamos completamente a configuração de servidor para servidor. Queríamos alocar os serviços mais sobrecarregados separadamente, para não desperdiçar recursos, e obter uma gestão mais flexível do nosso esquema de implantação.
Dificuldade em implementar tecnologias modernas
Um problema conhecido por todos os desenvolvedores: há o desejo de implementar tecnologias modernas no projeto, mas não há possibilidade. Com uma solução monolítica grande, qualquer atualização da biblioteca atual, para não dizer a transição para uma nova, se torna uma tarefa bastante complexa. É necessário convencer o líder da equipe por um bom tempo de que isso trará mais benefícios do que nervos gastos.
Complexidade na entrega de alterações
Esse foi o problema mais sério — fazíamos lançamentos a cada dois meses.
Cada lançamento se tornava uma verdadeira catástrofe para o banco, apesar dos testes e esforços dos desenvolvedores. A equipe de negócios entendia que parte da funcionalidade não estaria disponível no início da semana. E os desenvolvedores sabiam que enfrentariam uma semana de sérios incidentes.
Todos desejavam mudar a situação.
Expectativas com Microsserviços
Entrega de componentes à medida que ficam prontos. Entrega de componentes conforme sua prontidão, graças à decomposição da solução e separação de diferentes processos.
Pequenas equipes de produtos. Isso é importante, pois era difícil gerenciar uma grande equipe trabalhando em um antigo monólito. Essa equipe era obrigada a seguir um processo rigoroso, enquanto havia uma necessidade de mais criatividade e independência. Apenas pequenas equipes conseguiam isso.
Isolamento de serviços em processos separados. Idealmente, gostaríamos de isolar em containers, mas muitos serviços escritos no .NET Framework só podem ser executados no Windows. Agora estão surgindo serviços no .NET Core, mas ainda há poucos.
Flexibilidade de implantação. Gostaríamos de combinar serviços da maneira que nos é necessária, e não da forma que o código exige.
Uso de novas tecnologias. Isso é interessante para qualquer programador.
Problemas da Transição
Claro, se a divisão de um monólito em microserviços fosse fácil, não precisaríamos falar sobre isso em conferências ou escrever artigos. Este processo tem muitos desafios; descreverei os principais que nos atrapalharam.
O primeiro problema típica da maioria dos monólitos: a interconexão da lógica de negócios. Quando escrevemos um monólito, queremos reutilizar nossas classes para não escrever código desnecessário. E ao mudar para microserviços, isso se torna um problema: todo o código está bastante rigidamente ligado, tornando difícil a separação de serviços.
No início do trabalho havia mais de 500 projetos no repositório e mais de 700 mil linhas de código. Esta é uma solução bastante grande e o segundo problema. Simplesmente dividir isso em microserviços não era viável.
O terceiro problema — a falta de infraestrutura necessária. De fato, estávamos fazendo cópias manuais do código-fonte nos servidores.
Como Migrar de Monolitos para Microsserviços
Extração de microserviços
Em primeiro lugar, definimos para nós mesmos que a separação de microserviços é um processo iterativo. Sempre fomos exigidos a desenvolver paralelamente tarefas de negócios. Como vamos realizar isso tecnicamente — esse é o nosso problema. Portanto, estávamos nos preparando para um processo iterativo. Não há outra maneira se você tiver um grande aplicativo, e ele não estiver inicialmente preparado para ser reescrito.
Quais métodos usamos para extrair microserviços?
A primeira maneira — implementar módulos existentes como serviços. Temos sorte neste aspecto: já haviam serviços formatados que funcionavam com o protocolo WCF. Eles foram separados em assemblies distintos. Nós os transferimos separadamente, adicionando a cada assembly um pequeno módulo de inicialização. Este foi criado com a incrível biblioteca Topshelf, que permite executar o aplicativo tanto como serviço quanto como console. Isso é conveniente para depuração, pois não exige projetos adicionais na solução.
Os serviços estavam ligados pela lógica de negócios, pois usavam assemblies comuns e trabalhavam com um banco de dados compartilhado. Era difícil chamá-los de microsserviços no sentido puro. Entretanto, podíamos expor esses serviços separadamente, em diferentes processos. Isso já permitia reduzir a influência que tinham entre si, minimizando problemas com desenvolvimento paralelo e pontos únicos de falha.
O assembly com o host é apenas uma linha de código na classe Program. Ocultamos o trabalho com Topshelf em uma classe auxiliar.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
A segunda abordagem para destacar microsserviços: criar serviços para resolver novas tarefas. Se o monólito não crescer durante esse processo, isso já é excelente, o que significa que estamos indo na direção certa. Para resolver novas tarefas, tentamos criar serviços separados. Quando havia essa possibilidade, criávamos serviços mais "canônicos", que gerenciam completamente seu próprio modelo de dados e possuem um banco de dados separado.
Nós, assim como muitos, começamos com serviços de autenticação e autorização. Eles são ideais para isso. São independentes, geralmente possuem um modelo de dados separado. Eles não interagem com o monólito, apenas ele os consulta para resolver certas tarefas. Esses serviços podem ser o ponto de partida para a transição para uma nova arquitetura, onde se pode ajustar a infraestrutura, experimentar diversas abordagens relacionadas a bibliotecas de rede, etc. Em nossa organização, não existem equipes que não consigam implementar um serviço de autenticação.
A terceira abordagem para destacar microsserviços, que utilizamos, é um pouco específico para nós. Isso se refere à extração da lógica de negócios da camada de interface do usuário. Nosso principal aplicativo de interface do usuário é desktop, assim como o backend, ele é escrito em C#. Os desenvolvedores ocasionalmente cometiam erros e colocavam na interface do usuário partes da lógica que deveriam existir no backend e serem reutilizadas.
Se olharmos para um exemplo real do código da parte da interface do usuário, veremos que grande parte dessa solução contém lógica de negócios real, que é útil em outros processos, não apenas para a construção da forma da interface do usuário.
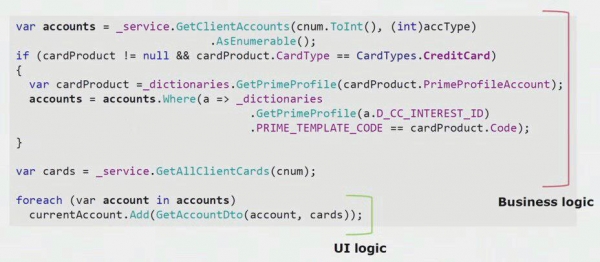
A lógica real da interface do usuário está apenas nas últimas linhas. Nós a movimentamos para o servidor para que pudesse ser reutilizada, diminuindo assim a interface do usuário e alcançando a arquitetura correta.
A quarta, e mais importante, forma de destacar microsserviços, que permite reduzir o monólito, é a extração de serviços existentes com reformulação. Quando extraímos módulos existentes tal como estão, o resultado nem sempre agrada aos desenvolvedores, e o processo de negócios desde a criação da funcionalidade pode ter se tornado obsoleto. Através da refatoração, conseguimos apoiar novos processos de negócios, pois as exigências do negócios estão sempre mudando. Podemos melhorar o código-fonte, eliminar defeitos conhecidos e criar um modelo de dados mais qualificado. Muitas vantagens são acumuladas.
A separação de serviços com reformulação está intrinsecamente ligada ao conceito de contexto limitado. Este conceito é da designação orientada a objetos. Significa uma área do modelo de domínio, onde todos os termos de uma linguagem comum estão claramente definidos. Vamos considerar o exemplo do contexto de seguros e contas. Temos um aplicativo monolítico e precisamos trabalhar com a conta nos seguros. Esperamos que o desenvolvedor encontre na outra montagem a classe existente 'Conta', faça uma referência a ela a partir da classe 'Seguro', e teremos um código funcional. O princípio DRY será respeitado, e a tarefa será mais rápida devido ao uso de código existente.
No final, percebe-se que os contextos de contas e seguros estão interligados. Quando surgirem novas demandas, essa conexão dificultará o desenvolvimento, aumentando a complexidade da lógica de negócios já complicada. Para resolver esse problema, é necessário identificar os limites entre os contextos no código e eliminar suas violações. Por exemplo, o contexto de seguros talvez precise apenas de um número de conta do BC de 20 dígitos e da data de abertura da conta.
Para separar esses contextos limitados e iniciar o processo de extração de microserviços de uma solução monolítica, adotamos uma abordagem como a criação de APIs externas dentro do aplicativo. Se soubéssemos que algum módulo deveria se tornar um microserviço, ou se modificar de alguma forma durante o processo, fazíamos chamadas à lógica pertencente a outro contexto limitado através de chamadas externas. Por exemplo, via REST ou WCF.
Decidimos firmemente que não evitaríamos código que exigisse a realização de transações distribuídas. No nosso caso, acabou sendo relativamente fácil seguir essa regra. Até agora, não tivemos situações em que transações distribuídas rígidas foram realmente necessárias — a consistência final entre os módulos tem sido suficiente.
Vamos considerar um exemplo concreto. Temos o conceito de orquestrador — um pipeline que processa a entidade ‘pedido’. Ele cria, sequencialmente, o cliente, a conta e o cartão bancário. Se o cliente e a conta forem criados com sucesso, mas a criação do cartão falhar, o pedido não mudará para o status 'sucesso' e permanecerá com o status 'cartão não criado'. No futuro, uma atividade em segundo plano poderá capturá-lo e finalizá-lo. O sistema ficará em um estado de inconsistência por algum tempo, mas isso, em geral, nos satisfaz.
Caso surja uma situação em que seja necessário salvar parte dos dados de forma consistente, provavelmente optaremos por agregar o serviço, para processá-lo em um único fluxo.
Vamos considerar um exemplo de extração de microserviço. Como podemos, de maneira relativamente segura, levá-lo à produção? Neste exemplo, temos uma parte separada do sistema — um módulo de gerenciamento de salários, um dos trechos de código que gostaríamos de transformar em um microserviço.
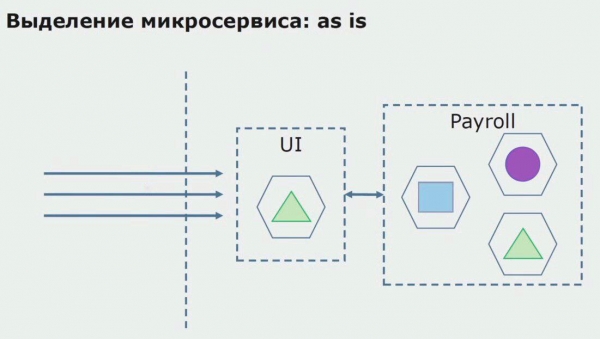
A primeira coisa a fazer é criar um microsserviço reescrevendo o código. Melhoramos alguns pontos que não nos agradavam. Implementamos novos requisitos de negócios do cliente. Adicionamos um API Gateway à integração entre a UI e o backend, que garantirá a passagem das chamadas.
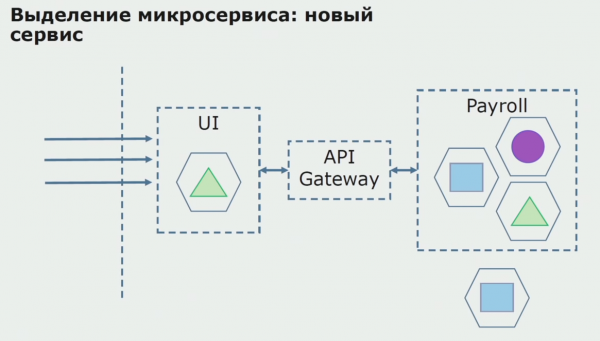
Em seguida, lançamos essa configuração em operação, mas em estado de piloto. A maioria dos nossos usuários ainda trabalha com os antigos processos de negócios. Para novos usuários, estamos desenvolvendo uma nova versão da aplicação monolítica, que não contém mais esse processo. Na verdade, temos em modo piloto uma integração entre o monólito e o microsserviço.
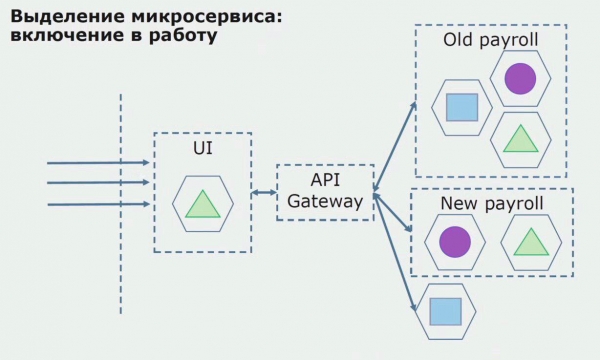
Com o piloto bem-sucedido, entendemos que a nova configuração realmente funciona, podemos remover o antigo monólito e deixar a nova configuração no lugar da solução antiga.
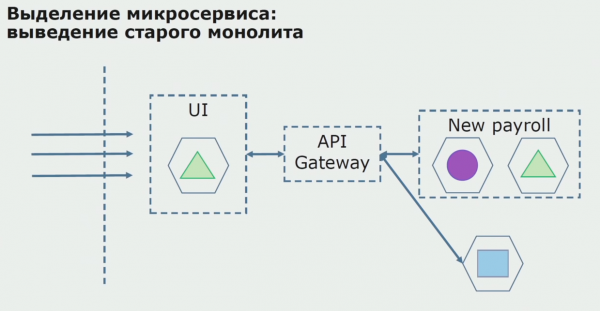
Em resumo, utilizamos praticamente todos os métodos existentes de separação do código-fonte do monólito. Todos eles nos permitem reduzir o tamanho das partes do aplicativo e transferi-las para novas bibliotecas, criando um código-fonte de maior qualidade.
Trabalho com BD
O banco de dados se separa pior do que o código-fonte, pois contém não apenas o esquema atual, mas também os dados históricos acumulados.
O nosso banco de dados, assim como muitos outros, tinha outro problema importante — o tamanho enorme. Este banco de dados foi projetado com base na lógica de negócios confusa do monólito, e entre as tabelas de diferentes contextos limitados, acumularam-se relações.
No nosso caso, para piorar a situação (banco de dados grande, muitas relações, fronteiras às vezes confusas entre as tabelas), surgiu um problema comum em muitos grandes projetos: o uso do padrão de banco de dados compartilhado. Os dados eram retirados de tabelas através de views, através de replicação e enviados para outros sistemas onde essa replicação era necessária. Como resultado, não conseguíamos mover tabelas para um esquema separado, pois eram amplamente utilizadas.
A separação é ajudada pela divisão em contextos limitados no código. Isso, geralmente, nos dá uma boa noção de como dividimos os dados no nível do banco de dados. Entendemos quais tabelas pertencem a um contexto limitado e quais pertencem a outro.
Aplicamos duas abordagens globais para a separação do banco de dados: a separação de tabelas existentes e a separação com reaprimoramento.
A separação das tabelas existentes é um método que deve ser utilizado quando a estrutura de dados é de qualidade, atende aos requisitos de negócios e satisfaz a todos os envolvidos. Nesse caso, podemos destacar as tabelas existentes em um esquema separado.
A separação com reaprimoramento é necessária quando o modelo de negócios mudou significativamente e as tabelas não nos satisfazem mais.
Separação de tabelas existentes. Precisamos definir o que vamos separar. Sem esse conhecimento, nada funcionará, e aqui a separação de contextos limitados no código nos ajudará. Geralmente, se conseguimos compreender as fronteiras dos contextos no código-fonte, fica claro quais tabelas devem ser incluídas na lista para separação.
Suponha que temos uma solução onde dois módulos de um monólito interagem com um único banco de dados. Precisamos garantir que a parte das tabelas que estamos separando interaja apenas com um módulo, enquanto o outro comece a interagir com ele através de uma API. Para começar, é suficiente que apenas gravações sejam feitas através da API. Esta é uma condição necessária para que possamos falar sobre a independência dos microsserviços. As conexões de leitura podem continuar, desde que isso não represente um grande problema.
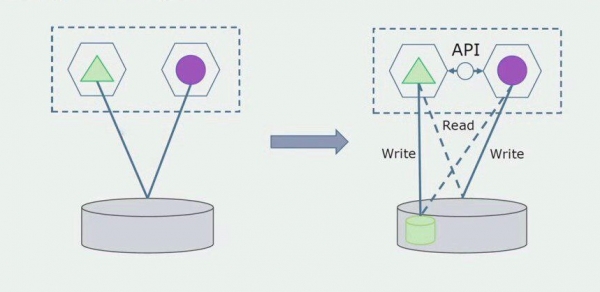
O próximo passo é destacar a parte do código que trabalha com as tabelas a serem separadas, seja com reaprimoramento ou sem, em um microsserviço distinto que será executado em um processo ou contêiner separado. Esse será um serviço separado com conexão ao banco de dados do monólito e às tabelas que não estão diretamente relacionadas a ele. O monólito ainda interage em leitura com a parte separada.
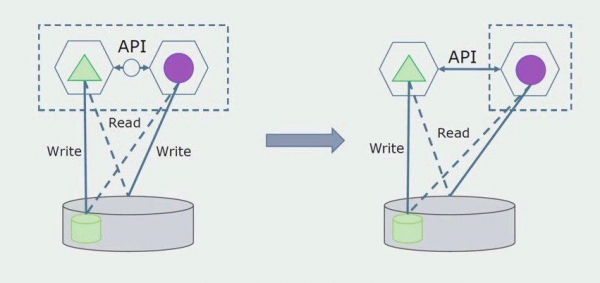
Posteriormente, removeremos essa conexão, ou seja, a leitura de dados do aplicativo monolítico a partir das tabelas separadas também será transferida para a API.
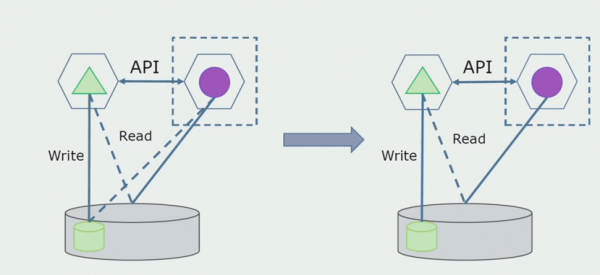
Em seguida, destacaremos da base de dados geral as tabelas com as quais apenas o novo microsserviço trabalha. Podemos mover as tabelas para um esquema separado ou até mesmo para um banco de dados físico separado. A conexão de leitura entre o microsserviço e o banco de dados do monólito permanece, mas isso não é um problema, pois essa configuração pode existir por um tempo considerável.
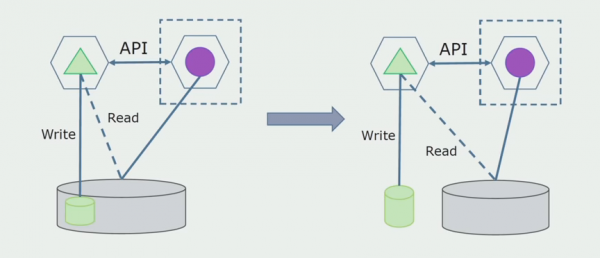
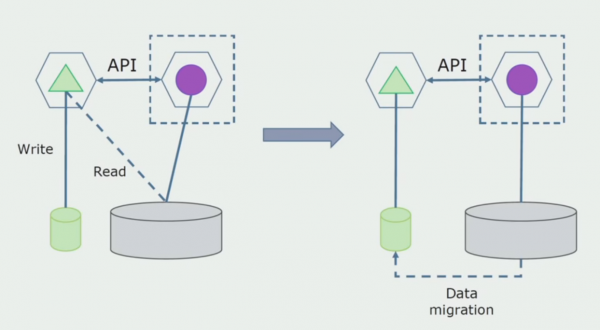
O último passo é remover todas as conexões completamente. Neste caso, pode ser necessária a migração de dados da base de dados principal. Às vezes, vamos querer reutilizar alguns dados ou diretórios replicados de sistemas externos em várias bases. Isso ocorre periodicamente conosco.
Divisão com reprocessamento. Este método é muito semelhante ao primeiro, apenas na ordem inversa. Criamos imediatamente uma nova base de dados e um novo microserviço que interage com o monólito através da API. Porém, permanece um conjunto de tabelas de BD que pretendemos remover no futuro. Elas não serão mais necessárias; na nova modelagem, foram substituídas.
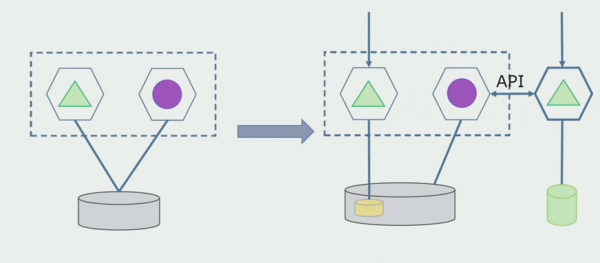
Para que esse esquema funcione, provavelmente precisaremos de um período de transição.
Aqui existem duas abordagens possíveis.
Primeiro: duplicamos todos os dados nas novas e antigas bases. Nesse caso, há redundância de dados e podem surgir problemas de sincronização. Porém, podemos atender a dois clientes diferentes. Um usará a nova versão, outro a antiga.
Segundo: dividimos os dados com base em algum critério de negócio. Por exemplo, em nosso sistema havia 5 produtos armazenados na antiga base de dados. O sexto, dentro de uma nova demanda de negócio, será colocado na nova BD. Porém, precisaremos de um API Gateway para sincronizar esses dados e mostrar ao cliente de onde e o que pegar.
Ambas as abordagens são viáveis; escolha conforme a situação.
Após confirmarmos que tudo está funcionando, a parte do monólito que opera com as antigas estruturas de BD pode ser desligada.
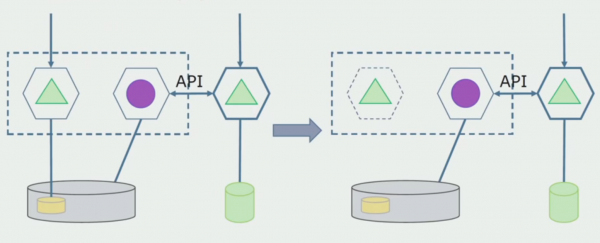
O último passo será a remoção das antigas estruturas de dados.
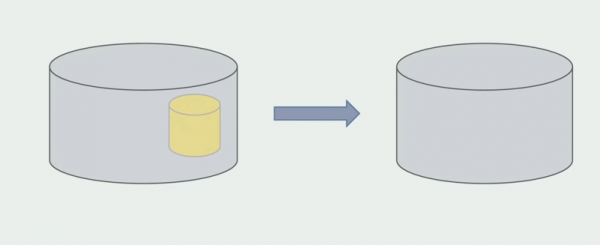
Em resumo, podemos afirmar que temos problemas com a BD: é difícil trabalhar com ela em comparação ao código-fonte, a separação é mais complicada, mas é algo que podemos e devemos fazer. Encontramos algumas maneiras que tornam isso bastante seguro, afinal, é mais fácil cometer um erro com dados do que com o código-fonte.
Trabalho com Código-Fonte
Assim era o esquema do código-fonte quando começamos a analisar o projeto monolítico.
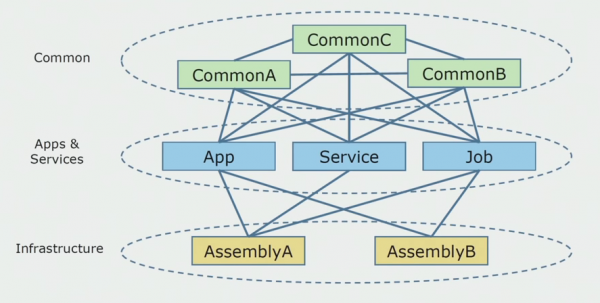
Ela pode ser dividida, em termos condicionais, em três camadas. Esta é a camada de módulos executáveis, plugins, serviços e atividades individuais. Na verdade, esses eram os pontos de entrada dentro de uma solução monolítica. Todos eles estavam solidamente ligados por uma camada comum. Nela estava a lógica de negócios que era utilizada em conjunto pelos serviços, e várias interconexões. Cada serviço e plugin utilizava até 10 ou mais assemblies comuns, dependendo de seu tamanho e da integridade dos desenvolvedores.
Tivemos sorte, tínhamos bibliotecas de infraestrutura que podiam ser utilizadas separadamente.
Às vezes surgiam situações em que alguns objetos comuns na verdade não pertenciam a essa camada, mas eram bibliotecas de infraestrutura. Isso era resolvido com renomeações.
Os contextos limitados eram os que mais preocupavam. Às vezes, 3-4 contextos se misturavam em um único assembly comum e usavam um ao outro dentro de funções de negócios. Era necessário entender onde isso poderia ser dividido e quais seriam os limites, e o que fazer em seguida com o mapeamento dessa divisão para os assemblies do código fonte.
Formulamos algumas regras para o processo de divisão de código.
Primeiro: não queríamos mais compartilhar a lógica de negócios entre serviços, atividades e plugins. Queríamos tornar a lógica de negócios independente dentro dos microserviços. Por outro lado, microserviços, idealmente, são vistos como serviços que existem completamente de forma independente. Acredito que essa abordagem é um pouco desperdício, além de ser difícil de alcançar, pois, por exemplo, serviços em C# estarão de qualquer forma conectados por uma biblioteca padrão. Nosso sistema é escrito em C#, outras tecnologias não foram utilizadas até agora. Portanto, decidimos que poderíamos nos permitir usar assemblies técnicos comuns. O principal é que não deve haver fragmentos da lógica de negócios neles. Se você tem um wrapper conveniente sobre o ORM que está utilizando, então copiá-lo de serviço para serviço é muito custoso.
A nossa equipe é fã do design orientado a domínio, por isso a "arquitetura cebola" se encaixou perfeitamente para nós. A base dos nossos serviços não é uma camada de acesso a dados, mas uma construção com lógica de domínio, que contém apenas a lógica de negócios e é isenta de vínculos com a infraestrutura. Assim, podemos aprimorar independentemente a construção de domínio para resolver problemas relacionados aos frameworks.
Nesse estágio, encontramos o primeiro grande problema. O serviço deveria referenciar uma única construção de domínio, queríamos que a lógica fosse independente, e o princípio DRY estava nos atrapalhando. Os desenvolvedores queriam reutilizar classes de construções vizinhas para evitar duplicações, e, como resultado, os domínios começaram a se conectar novamente. Analisamos os resultados e decidimos que, talvez, o problema também estivesse na forma como o armazenamento do código-fonte estava estruturado. Tínhamos um grande repositório, onde todo o código-fonte era armazenado. Era muito difícil montar a solução do projeto em uma máquina local. Portanto, para partes do projeto, eram criadas soluções separadas, e ninguém impedia que uma construção comum ou de domínio fosse adicionada e reutilizada. O único instrumento que não nos permitia fazer isso era a revisão de código. Mas às vezes até isso falhava.
Então começamos a transição para um modelo com repositórios separados. A lógica de negócios deixou de vazar de um serviço para outro, e os domínios realmente se tornaram independentes. Os contextos delimitados são mantidos de forma mais clara. Como reutilizamos as bibliotecas de infraestrutura? Separaram-se em um repositório distinto e, em seguida, colocamos em pacotes Nuget, que foram armazenados no Artifactory. Qualquer alteração resulta em uma construção e publicação automáticas.
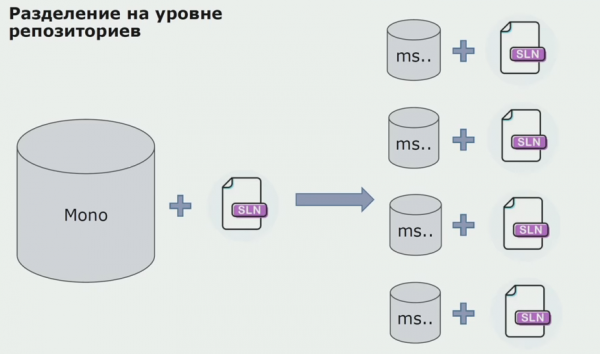
Nossos serviços passaram a referenciar pacotes de infraestrutura interna exatamente da mesma forma que as bibliotecas externas. As bibliotecas externas são baixadas do Nuget. Para trabalhar com o Artifactory, onde armazenamos esses pacotes, utilizamos dois gerenciadores de pacotes. Em repositórios pequenos, também usamos o Nuget. Em repositórios com vários serviços, utilizamos o Paket, que oferece maior consistência de versões entre os módulos.
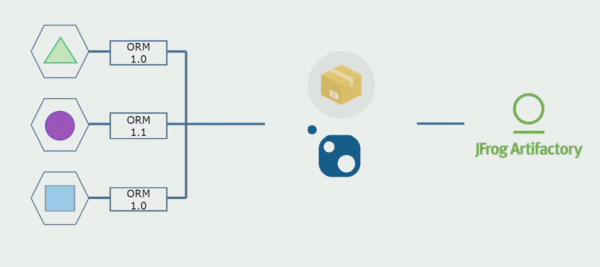
Assim, ao trabalhar no código-fonte, alterando um pouco a arquitetura e separando os repositórios, tornamos nossos serviços mais independentes.
Problemas de Infraestrutura
A maioria das desvantagens ao migrar para microserviços está relacionada à infraestrutura. Você precisará de uma implantação automatizada e de novas bibliotecas para a operação da infraestrutura.
Instalação Manual em Ambientes
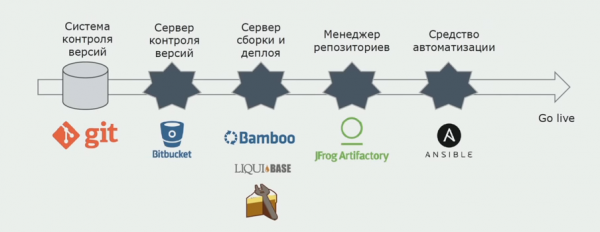
Inicialmente, nós instalávamos as soluções em ambientes manualmente. Para automatizar esse processo, criamos um pipeline de CI/CD. Optamos pelo processo de entrega contínua, pois a implantação contínua ainda não é viável do ponto de vista dos processos empresariais. Assim, a implementação é feita por botão, enquanto os testes são automáticos.
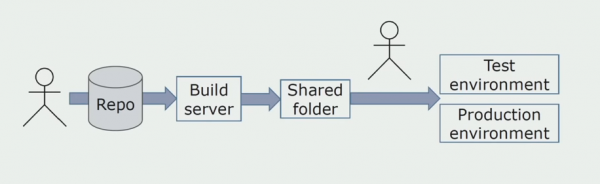
Usamos Atlassian, Bitbucket para armazenar códigos-fonte e Bamboo para a compilação. Gostamos de escrever scripts de compilação em Cake, porque é o mesmo que C#. Pacotes prontos chegam ao Artifactory, e o Ansible automaticamente é enviado para os servidores de teste, onde podem ser testados imediatamente.
Registro de Logs Separado
Na época, uma das ideias do monolito era garantir o registro conjunto. Também precisávamos entender o que fazer com os logs separados armazenados nos discos. Os logs são gravados em arquivos de texto. Decidimos usar a pilha ELK padrão. Não gravamos diretamente no ELK através de provedores, mas decidimos aprimorar os logs de texto e registrar neles o ID de rastreamento como um identificador, adicionando o nome do serviço, para que esses logs pudessem ser analisados posteriormente.
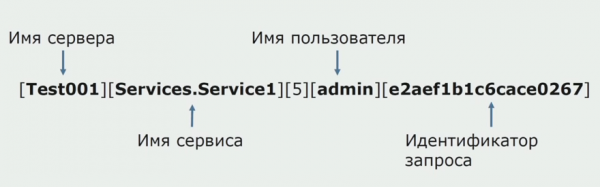
Com o Filebeat, conseguimos coletar nossos logs de servidores, transformá-los, construir consultas na interface do usuário usando o Kibana e visualizar como as chamadas foram feitas entre os serviços. O ID de rastreamento é de grande ajuda nesse processo.
Teste e Depuração de Serviços Relacionados
No início, não entendíamos completamente como debugar os serviços que estávamos desenvolvendo. Com o monólito, tudo era simples; nós o executávamos na máquina local. Tentamos fazer o mesmo com os microsserviços, mas, às vezes, para iniciar um microsserviço, é necessário iniciar vários outros, o que é inconveniente. Percebemos que precisávamos mudar para um modelo em que deixamos na máquina local apenas o serviço ou serviços que desejamos depurar. Os outros serviços são utilizados a partir de servidores que têm a mesma configuração do ambiente de produção. Após a depuração, durante os testes, apenas os serviços modificados são implantados no servidor de teste para cada tarefa. Assim, testamos a solução da forma como ela será no ambiente de produção.
Existem servidores que possuem apenas versões de produção dos serviços. Esses servidores são necessários para lidar com incidentes, para verificar a entrega antes da implantação e para treinamentos internos.
Adicionamos um processo de testes automatizados usando a popular biblioteca Specflow. Os testes são executados automaticamente com o NUnit logo após a implantação através do Ansible. Se a cobertura da tarefa é totalmente automática, não há necessidade de testes manuais. Embora, às vezes, testes manuais adicionais ainda sejam necessários. Para determinar quais testes executar para uma tarefa específica, utilizamos tags no Jira.
Além disso, a demanda por testes de carga aumentou, sendo que antes isso ocorria apenas em casos raros. Para executar os testes, usamos o JMeter, para armazená-los usamos o InfluxDB, e para criar gráficos do processo, utilizamos o Grafana.
O que conseguimos?
Em primeiro lugar, eliminamos o conceito de 'release'. Desapareceram as monstruosas releases de dois meses, quando essa máquina era implantada no ambiente de produção, interrompendo temporariamente os processos de negócios. Agora, implantamos serviços em média a cada 1,5 dias, agrupando-os, pois entram em operação após aprovação.
Em nosso sistema, não há falhas fatais. Se lançamos um microsserviço com um erro, a funcionalidade relacionada a ele será afetada, mas toda a outra funcionalidade não será prejudicada. Isso melhora significativamente a experiência do usuário.
Podemos gerenciar o esquema de implantação. É possível destacar grupos de serviços separadamente do restante da solução, se necessário.
Além disso, conseguimos reduzir significativamente o problema das longas filas de solicitações. Formamos equipes de produto separadas que trabalham com partes dos serviços de forma independente. Aqui, o processo Scrum já se encaixa bem. Uma equipe específica pode ter um proprietário de produto separado que define as tarefas para ela.
Resumo
- Microsserviços são adequados para a decomposição de sistemas complexos. No processo, começamos a entender o que existe em nosso sistema, quais são os contextos limitados e onde estão suas fronteiras. Isso permite distribuir corretamente as solicitações entre os módulos e evitar confusão no código.
- Microsserviços oferecem vantagens organizacionais. Muitas vezes, falamos sobre eles apenas como arquitetura, mas toda arquitetura serve para resolver necessidades de negócios, e não por si só. Portanto, podemos afirmar que microsserviços são adequados para resolver problemas em pequenas equipes, considerando que o Scrum é muito popular atualmente.
- A separação é um processo iterativo. Não se pode simplesmente pegar um aplicativo e dividi-lo em microsserviços. O produto resultante provavelmente não funcionará. Ao destacar microsserviços, é vantajoso reescrever o legado existente, ou seja, transformá-lo em um código que gostamos e que melhor atende às necessidades do negócio em termos de funcionalidade e velocidade.
Um pequeno aviso: os custos de transição para microsserviços são bastante significativos. Somente para resolver o problema de infraestrutura, gastou-se muito tempo. Portanto, se você tem um pequeno aplicativo que não requer escalabilidade específica, e não há um grande número de clientes disputando a atenção e o tempo da sua equipe, então, talvez, microsserviços não sejam o que você precisa hoje. Isso é bastante caro. Se você iniciar o processo com microsserviços, os custos iniciais serão maiores do que se o mesmo projeto fosse iniciado com o desenvolvimento de um monolito.
P.S. Uma narrativa mais emocional (como se fosse pessoalmente para você) – em .
Aqui está a versão completa da apresentação.
Fonte: habr.com
